
Arten des maschinellen Lernens

1. Überwachtes LernenÜberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem ein Modell mit einem Satz von beschrifteten Daten trainiert wird. Jede Eingabe im Dataset ist mit einer bekannten Ausgabe verknüpft, So kann das Modell lernen, Ergebnisse für neue Eingaben vorherzusagen. Diese Methode wird häufig in Anwendungen wie der Bildklassifizierung eingesetzt., Spracherkennung und Trendvorhersage, und unterstreicht seine Bedeutung in...: In einem überwachten Lernmodell, Der Algorithmus lernt anhand eines gekennzeichneten Datensatzes, um erwartete Vorhersagen für die Lösung neuer Daten zu generieren.
P.ej; Für Hauspreisprognosen, Zuerst brauchen wir Daten über Wohnungen wie; Quadratfuß, Nein. der Zimmer, das Haus hat einen Garten oder nicht, usw. Also müssen wir die Preise dieser Häuser kennen, Mit anderen Worten; Klassenetiketten. Jetzt, wo die Daten von Hunderten von Häusern stammen, seine Eigenschaften und Preise, Wir können jetzt ein überwachtes maschinelles Lernmodell trainieren, um den Preis eines neuen Eigenheims basierend auf früheren Erfahrungen mit dem Modell vorherzusagen.
Es gibt zwei Arten von überwachtem Lernen:
ein) Einstufung: In Klassifizierung, Ein Computerprogramm wird auf einem Datensatz von AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... Ja, nach Ausbildung, kategorisieren Sie Daten in verschiedene Klassenlabels. Dieser Algorithmus wird verwendet, um die diskreten Werte als männlich vorherzusagen | Frau, Stimmt | gefälscht, Spam | kein Spam, etc.
P.ej; Spam-Erkennung, Sprachakkreditierung, Identifizierung von Krebszellen, etc.
Arten von Klassifikationsalgorithmen:
- Naive Bayes-Klassifikator
- Entscheidungsbäume
- Logistische Regression
- K-Nächste Nachbarn
- Support-Vektor-Maschinen
- Zufällige Waldklassifizierung
B) Rückschritt: Die Aufgabe des Regressionsalgorithmus besteht darin, die Abbildungsfunktion zu finden, um die Eingangsvariablen abzubilden (x) zu VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Kontinuierlicher Ausgang (Ja). Regressionsalgorithmen werden verwendet, um kontinuierliche Werte wie den Preis vorherzusagen, Gehalt, Alter, Noten, etc.
P.ej; Zeitvorhersage, Hauspreisvorhersage, Fake-News-Erkennung, etc.
Typen von Regressionsalgorithmen:
- Einfache lineare Regression
- Multiple lineare Regression
- polynomielle Regression
- Entscheidungsbaumregression
- Zufällige Waldregression
- Methode einstellen
2. Unbeaufsichtigtes LernenUnüberwachtes Lernen ist eine Technik des maschinellen Lernens, die es Modellen ermöglicht, Muster und Strukturen in Daten ohne vordefinierte Beschriftungen zu identifizieren. Durch Algorithmen wie k-means und Hauptkomponentenanalyse, Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, wie z. B. Kundensegmentierung, Anomalieerkennung und Datenkomprimierung. Seine Fähigkeit, verborgene Informationen preiszugeben, macht es zu einem wertvollen Werkzeug in der...: In einem unüberwachten Lernmodell, Der Algorithmus lernt mit einem nicht gekennzeichneten Datensatz und versucht, Sinn zu machen, indem er Merkmale extrahiert, gemeinsames Auftreten und zugrunde liegende Muster allein.
P.ej; Anomalieerkennung, einschließlich Betrugserkennung. Ein weiteres Beispiel ist die Öffnung von Notkrankenhäusern zu Gebieten mit dem höchsten Unfallrisiko.. Das GruppierungDas "Gruppierung" Es handelt sich um ein Konzept, das sich auf die Organisation von Elementen oder Individuen in Gruppen mit gemeinsamen Merkmalen oder Zielen bezieht. Dieses Verfahren wird in verschiedenen Disziplinen eingesetzt, einschließlich Psychologie, Pädagogik und Biologie, um die Analyse und das Verständnis von Verhaltensweisen oder Phänomenen zu erleichtern. Im Bildungsbereich, zum Beispiel, Gruppenbildung kann die Interaktion und das Lernen unter den Schülern verbessern, indem sie die Arbeit fördert.. von K-media gruppiert diese Orte mit maximal gefährdeten Bereichen in Gruppen und definiert ein Gruppenzentrum (Mit anderen Worten, Krankenhaus) für jede Gruppe (Mit anderen Worten, unfallgefährdete Bereiche).
Arten des unüberwachten Lernens:
- Gruppierung
- Anomalieerkennung
- Verband
- Autocoder
- Latent-variable Modelle
- Neuronale Netze
3. VerstärkungslernenReinforcement Learning ist eine Technik der künstlichen Intelligenz, die es einem Agenten ermöglicht, durch Interaktion mit einer Umgebung zu lernen, Entscheidungen zu treffen. Durch Feedback in Form von Belohnungen oder Bestrafungen, Der Agent optimiert sein Verhalten, um die kumulierten Belohnungen zu maximieren. Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, Von Videospielen über Robotik bis hin zu Empfehlungssystemen, Er zeichnet sich durch seine Fähigkeit aus, komplexe Strategien zu erlernen....: Reinforcement Learning ist eine Art des maschinellen Lernens, bei dem das Modell lernt, sich in einer Umgebung zu verhalten, indem es einige Aktionen durchführt und die Reaktionen analysiert. RL ergreift die geeigneten Maßnahmen, um die positive Lösung in der jeweiligen Situation zu maximieren. Das Bewehrungsmodell entscheidet, welche Maßnahmen ergriffen werden müssen, um eine bestimmte Aufgabe auszuführen, deshalb ist er verpflichtet, aus der Erfahrung selbst zu lernen.
P.ej; Nehmen wir ein Beispiel für ein Baby, das laufen lernt. Im ersten Fall, wenn das Baby zu laufen beginnt und die Schokolade erreicht, da Schokolade das Endziel des Babys ist und die Lösung eines Babys positiv ist, da es glücklich ist. Im zweiten Fall, wenn das Baby zu laufen beginnt und beim Gehen vom Stuhl getroffen wird und die Schokolade nicht bekommen kann, fang an zu weinen, das ist eine negative antwort. Mit anderen Worten, wie Menschen aus Spuren und Fehlern lernen. Hier, das baby ist das „Agent“, Schokolade ist die „belohnen“ und viele Hindernisse dazwischen. Jetzt versucht es der Agent auf verschiedene Weise und findet den besten machbaren Weg, um die Belohnung zu erzielen.
Lebenszyklus des maschinellen Lernens
Maschinelles Lernen hilft, die Aufgabenleistung und Produktivität zu steigern. Beinhaltet Lernen und Selbstkorrektur, wenn neue Daten präsentiert werden.
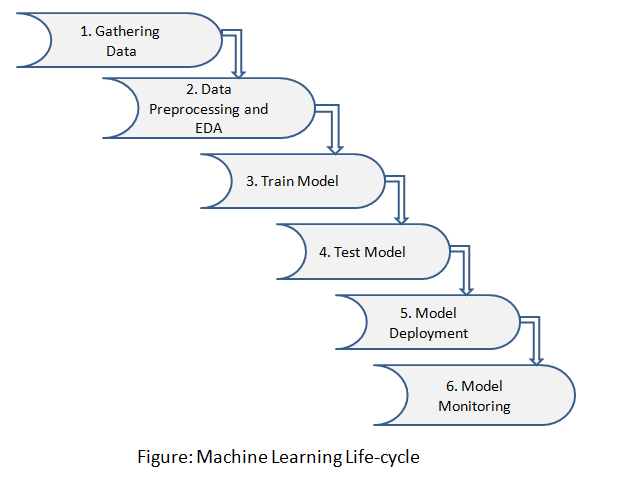
Der Lebenszyklus des maschinellen Lernens umfasst sechs Hauptschritte:
Paso 1: Datensammlung
Identifizieren Sie mehrere Datenquellen wie Kaggle und sammeln Sie den erforderlichen Datensatz
Paso 2: Datenvorverarbeitung und EDA
In diesem Schritt, Wir analysieren die Daten auf der Suche nach fehlenden Werten, doppelte Daten, ungültige Daten mit verschiedenen Analysetechniken. Und die Daten auch für Merkmalsextraktionen vorverarbeiten, Merkmalsanalyse und Datenvisualisierung.
Paso 3: Modelleisenbahn
Wir verwenden einen Datensatz, um das Modell mit verschiedenen maschinellen Lernalgorithmen zu trainieren. Ein Modell zu trainieren ist wichtig, damit es die verschiedenen Muster verstehen kann, Regeln und Eigenschaften.
Paso 4: Testmodell
In diesem Schritt, Wir überprüfen die Genauigkeit unseres Modells, indem wir dem trainierten Modell einen Testdatensatz zur Verfügung stellen.
Paso 5: Modellimplementierung
Modellimplementierung bedeutet die Integration eines Machine-Learning-Modells in eine vorhandene Produktionsumgebung, die Eingaben und Ergebnisse zurückgibt, um datengesteuerte Geschäftsentscheidungen zu treffen. Es werden mehrere Technologien aufgeführt, mit denen Sie Ihre Machine Learning-Modelle in die Praxis umsetzen können.:
- Stauraum
- Gouverneure
- AWS SageMaker
- MLFlow
- Azure Machine Learning-Dienst
Paso 6: Modellüberwachung
Nach der Modellimplementierung, Hier kommt die Modellüberwachung, die Ihre Machine-Learning-Modelle auf Faktoren wie Fehler überwacht, Ausfälle und Latenz und, das wichtigste, um sicherzustellen, dass Ihr Modell die gewünschte Leistung beibehält. Die Modellüberwachung ist sehr wichtig, da sich Ihre Modelle aufgrund verschiedener Faktoren im Laufe der Zeit verschlechtern, als unsichtbare Daten, Veränderungen in der Umgebung und Beziehungen zwischen Variablen.
Einige Anwendungen des maschinellen Lernens in der realen Welt
- Automatische Sprachübersetzung in Google Translate
- Schnellere Routenauswahl in der Google Map-Suchmaschine
- Fahrerloses Auto / autonom
- Smartphone mit Gesichtsakkreditierung
- Sprachakkreditierung
- Anzeigenempfehlungssystem
- Netflix-Empfehlungssystem
- Vorschlag zur automatischen Markierung von Freunden auf Facebook
- Börsenverhandlungen
- Entdeckung eines Betruges
- Zeitvorhersage
- Medizinische Diagnostik
- Chatbot
- Maschinelles Lernen in der Landwirtschaft
Vorteile des maschinellen Lernens
- Arbeitsautomatisierung
- Leistungsstarke Vorhersagefähigkeit
- Umsatzsteigerung im E-Commerce-Markt.
- Vorteile von AA im medizinischen Bereich zur Förderung der medizinischen Diagnose und Arzneimittelentwicklung
- Maschinelles Lernen wird in der medizinischen Roboterchirurgie eingesetzt
- ML im Finanzbereich steigert die Produktivität, verbessert den Umsatz und bietet sichere Transaktionen
- Modellieren Sie die Daten, um nützliche Entscheidungen zu treffen
Zusammenfassung
Maschinelles Lernen kann in fast jedem Bereich des menschlichen Lebens eingesetzt werden, um unsere Arbeit zu erledigen effizient, robust, Ja Ohne Komplikationen. Wie wir wissen, alles hat seine vor- und nachteile, Machine Learning hat auch Nachteile, als Beispiel, mit dem Aufkommen des maschinellen Lernens, viele Leute könnten ihren aktuellen Bühnenjob verlieren. Aber mehr in bombastischem Ton ist vorteilhaft auf lange Sicht für Menschheit.
Die in diesem Beitrag gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





