
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Interesse an Predictive Analytics? Später, Künstliche Intelligenz erforschen, maschinelles Lernen und tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit.... .
Wenn Sie auf dem Weg sind, Data Science zu lernen, definitiv verstehen, was maschinelles Lernen ist. In der digitalen Welt von heute, Jeder weiß, was maschinelles Lernen ist, weil es auf der ganzen Welt eine modische digitale Technologie war.
Jeder Schritt zur Anpassung an die Welt der Zukunft wird von dieser aktuellen Technologie geleitet, und diese aktuelle Technologie wird von Datenwissenschaftlern wie dir und mir geleitet😌.
Hier sprechen wir nur über maschinelles Lernen, wenn du nicht weißt was es ist, Wir geben Ihnen eine kurze Einführung:
Maschinelles Lernen ist das Studium von Computeralgorithmen, die sich durch Erfahrung und durch die Nutzung von Daten automatisch verbessern. Ihr Algorithmus erstellt ein Modell basierend auf den Daten, die wir während der Modellerstellung bereitstellen. Dies ist die einfache Definition von maschinellem Lernen, und wenn wir tief gehen, Wir haben festgestellt, dass es viele Algorithmen gibt, die bei der Modellerstellung verwendet werden. Allgemein, Die am häufigsten verwendeten Algorithmen für maschinelles Lernen basieren auf der Art des Problems, die Jungs sind im Grunde Rückschritt, Einstufung, etc ... Aber hier werden wir nur über Regressionsalgorithmen sprechen.
Lassen Sie uns eine kurze Einführung darüber geben, was Regression ist. Rückschritt ist die statistische Methode bei Investitionen, Finanz- und andere Disziplinen, die versuchen, die Stärke und Beziehung zwischen unabhängigen und abhängigen Variablen zu bestimmen. Allgemein, die unabhängigen Variablen sind diejenigen Variablen, bei denen ihre Werte verwendet werden, um die Ausgabe zu erhalten, und die abhängigen Variablen sind diejenigen, deren Wert von unabhängigen Werten abhängt. Wenn es um Regressionsalgorithmen geht, einige häufig verwendete Regressionsalgorithmen werden verwendet, um das Modell des maschinellen Lernens zu trainieren, als einfache lineare Regression, Schleife, Kamm, etc.
Deswegen, Lassen Sie uns über die multiple lineare Regression sprechen und im Detail verstehen, wie sich die einfache lineare von der multiplen linearen Regression unterscheidet.
- Einfache lineare Regression vs. multiple lineare Regression
- Datensatz
- Datensatz lesen
- Unabhängige und abhängige Variablen
- Verwaltung kategorialer Variablen
- Datenteilung
- Modell anwenden
Einfache lineare Regression versus multiple lineare Regression
Jetzt, bevor du weitermachst, Lassen Sie uns die Interaktion hinter der einfachen linearen Regression analysieren, dann versuchen wir, einfache und multiple lineare Regression basierend auf dieser Intuition, die wir tatsächlich machen, mit unserem maschinellen Lernproblem zu vergleichen.
Einfache lineare Regression
Wir betrachten eine einfache lineare Regression in einem beliebigen maschinellen Lernalgorithmus anhand des Beispiels,
Jetzt, Angenommen, wir nehmen ein Hauspreisszenario, bei dem unsere x-Achse die Größe des Hauses und die y-Achse im Wesentlichen der Preis des Hauses ist. In diesem im Grunde, wir haben zwei eigenschaften, das erste ist f1 und das zweite ist f2, wo,
f1 bezieht sich auf die Größe des Hauses und,
f2 bezieht sich auf den preis des hauses
also ja f1 wird zum eigenständigen Feature und f2 wird zum abhängigen Merkmal, Wir wissen im Allgemeinen, dass jedes Mal, wenn die Größe des Hauses zunimmt, der preis steigt auch, Angenommen, wir ziehen zufällige Streupunkte, Durch diesen Streuungspunkt versuchen wir im Grunde, die Linie der besten Anpassung zu finden, und diese Linie der besten Anpassung ist durch die Gleichung :
Gleichung: y = A + Bx
Vermuten, Ja sei der Preis des Hauses und x die Größe des Hauses sein, Also sieht diese Gleichung so aus:
Gleichung: Preis = A + B (Größe)
wo,
A ist ein Achsenabschnitt und B ist eine Steigung an diesem Achsenabschnitt
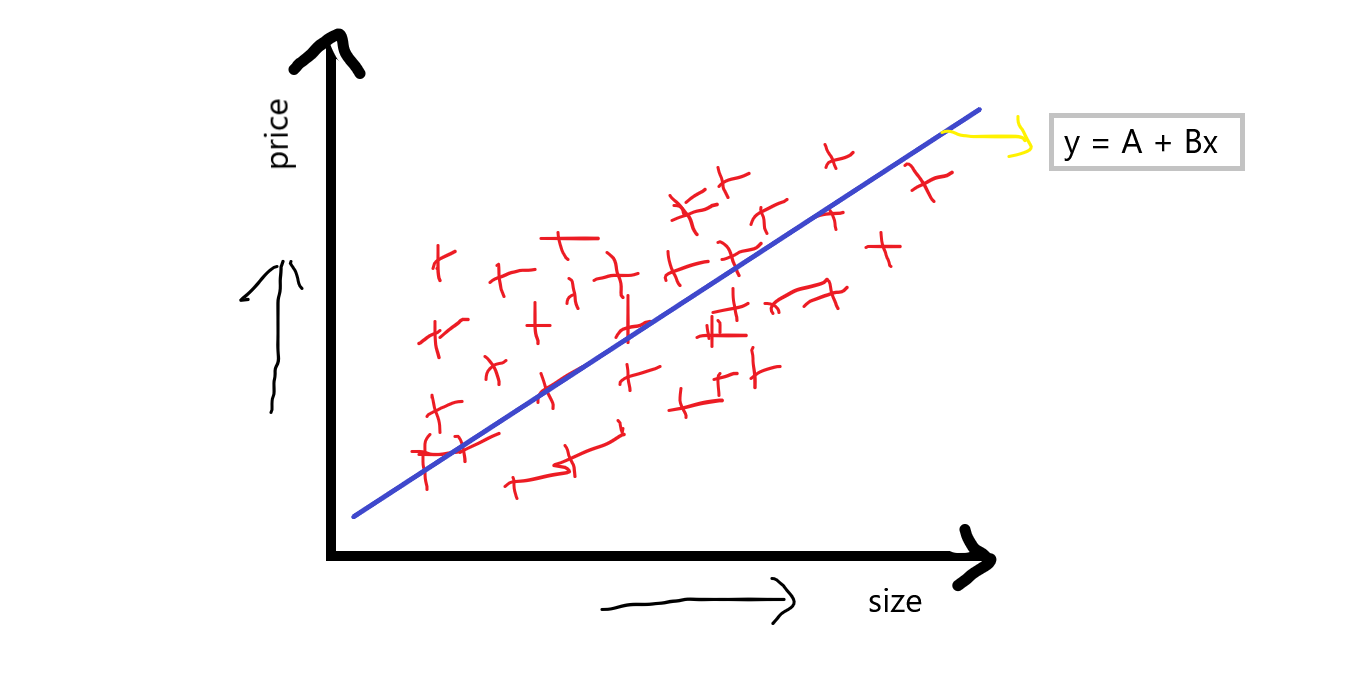
Wenn wir diese Gleichung diskutieren, wobei der Schnittpunkt im Wesentlichen anzeigt, wann der Preis des Hauses 0 Was wird dann der Grundpreis des Hauses sein?, und die Steigung oder der Koeffizient zeigt an, dass er mit der Einheit größer wird, Was wird dann die Einheit sein, die Steigung erhöht?.
jedoch, Wie unterscheidet sie sich von der multiplen linearen Regression??
Multiple lineare Regression
Die multiple lineare Regression zeigt im Grunde an, dass wir viele Merkmale haben werden, wie z f1, f2, f3, f4, und unsere Ausgabefunktion f5. Wenn wir das gleiche Beispiel nehmen, das wir zuvor besprochen haben, vermuten:
f1 ist die größe des hauses.
f2 Das sind schlechte Zimmer im Haus.
f3 ist die Stadt des Hauses.
f4 ist der Zustand des Hauses und,
f5 es ist unser Ausstiegsmerkmal, das der Preis des Hauses ist.
Jetzt, Sie können sehen, dass auch mehrere eigenständige Funktionen einen großen Einfluss auf den Preis des Hauses haben, Preis kann von Funktion zu Funktion variieren. Wenn wir von multipler linearer Regression sprechen, dann die einfache lineare Regressionsgleichung y = A + Bx verwandelt sich in so etwas wie:
Gleichung: y = A + B1x1+ B2x2+ B3x3+ B4x4
„Wenn wir eine abhängige Funktion und mehrere unabhängige Funktionen haben, wir nennen es im Grunde multiple lineare Regression. „
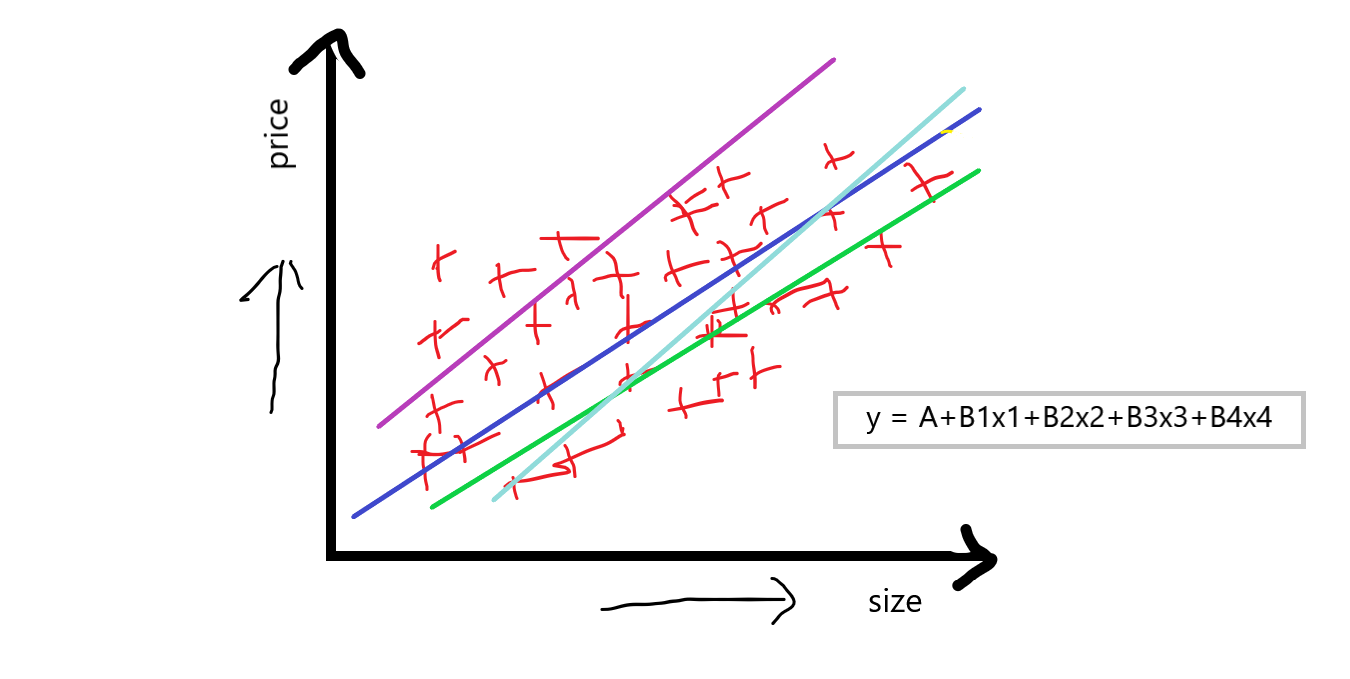
Jetzt, Unser Ziel bei der Verwendung der multiplen linearen Regression ist, dass wir berechnen müssen EIN was ist eine kreuzung, Ja B1 B2 B3 B4 Welche Steigungen oder Koeffizienten beziehen sich auf diese unabhängige Charakteristik?, was im Grunde darauf hindeutet, dass wenn wir den Wert von erhöhen x1 von 1 dann fahre B1 sagt, wie viel Wert sich auf den Preis des Hauses auswirkt, und das war in Bezug auf andere ähnlich B2 B3 B4
Dann, Dies ist eine kurze theoretische Beschreibung der multiplen linearen Regression. Jetzt werden wir die lineare Regressionsbibliothek scikit verwenden, um das Problem der multiplen linearen Regression zu lösen.
Datensatz
Jetzt, Wir wenden multiple lineare Regression auf die 50_Startups Datensatz, du kannst klicken hier um den Datensatz herunterzuladen.
Datensatz lesen
Der Großteil des Datensatzes befindet sich in einer CSV-Datei, Um diese Datei zu lesen, verwenden wir die Pandas-Bibliothek:
df = pd.read_csv('50_Startups.csv')
df
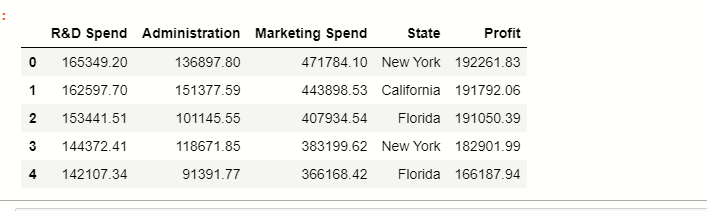
Hier seht ihr was es gibt 5 Spalten im Datensatz, in denen die Zustand speichert kategoriale Datenpunkte und der Rest sind numerische Merkmale.
Jetzt, wir müssen unabhängige und abhängige Merkmale klassifizieren:
Unabhängige und abhängige Variablen
Es gibt insgesamt 5 Merkmale im Datensatz, bei denen im Grunde Profite unser abhängiges Merkmal sind, und der Rest sind unsere unabhängigen Funktionen:
#Trennen Sie die anderen Attribute vom Vorhersageattribut
x = df.drop('Gewinn',Achse=1)
#separte the predicting attribute into Y for model training
y = ['Profit']
Verwaltung kategorialer Variablen
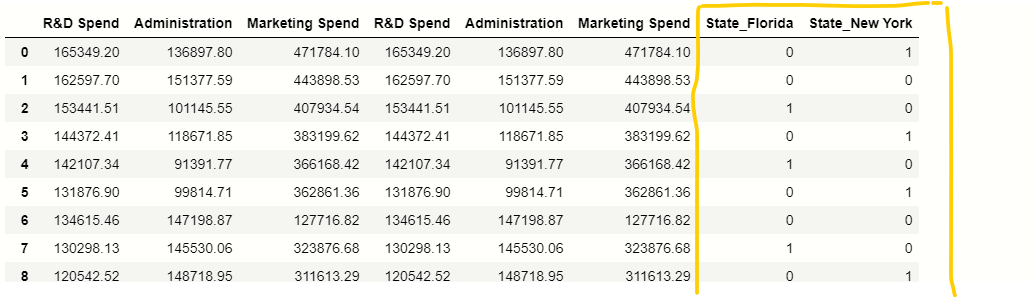
In unserem Datensatz, es gibt eine kategoriale Spalte Zustand, Wir müssen diese kategorialen Werte in dieser Spalte verarbeiten, damit wir Pandas verwenden get_dummys () Funktion:
# handhaben VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Kategorisch
estados = pd.get_dummies (x, drop_first = Wahr)
# zusätzliche Spalte entfernen
x = x.drop (‚Zustand‘, Achse = 1)
# Verkettung unabhängiger Variablen und neuer kateorischer Variable.
x = pd.konkat ([x,Zustände], Achse = 1)
x
Datenteilung
Jetzt, Tenemos que dividir los datos en partes de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... y prueba para las que usamos scikit-learn train_test_split () Funktion.
# train_test_split aus sklearn importieren
aus sklearn.model_selection import train_test_split
# Aufteilen der Daten
x_train, x_test, y_train, y_test = train_test_split(x, Ja, test_size = 0.2, random_state = 42)
Modell anwenden
Jetzt, wir wenden das lineare Regressionsmodell auf unsere Trainingsdaten an, erste, Wir müssen die lineare Regression aus der scikit-learn-Bibliothek importieren, es gibt keine andere Bibliothek, um multiple lineare Regression zu implementieren, wir machen es nur mit linearer Regression.
# Importmodul
aus sklearn.linear_model import LinearRegression
# Erstellen eines Objekts der LinearRegression-Klasse
LR = LinearRegression()
# Anpassung der Trainingsdaten
LR.fit(x_train,y_train)
Schließlich, wenn wir das laufen lassen, dann ist unser Modell fertig, jetzt haben wir Daten von x_test, Wir verwenden diese Daten für die Vorhersage von profitieren.
y_prediction = LR.predict(x_test)
y_vorhersage
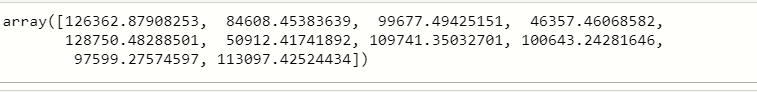
Jetzt, wir müssen die y_prediction-Werte mit den Originalwerten vergleichen, da wir die Genauigkeit unseres Modells berechnen müssen, die durch ein Konzept namens . umgesetzt wurde r2_score. lass uns kurz über r2_score sprechen:
r2_score: –
Es ist eine Funktion innerhalb von sklearn. Metrikmodul, wobei der Wert von r2_score variiert zwischen 0 Ja 100 Prozent, wir können sagen, dass es eng mit MSE verwandt ist.
r2 wird grundsätzlich nach der unten angegebenen Formel berechnet:
Formel: r2 = 1 – (SSres / SSmeinen )
jetzt, wenn ich sage SSres nämlich, ist die Summe der Residuen und SSmeinen bezieht sich auf die Summe der Mittel.
wo,
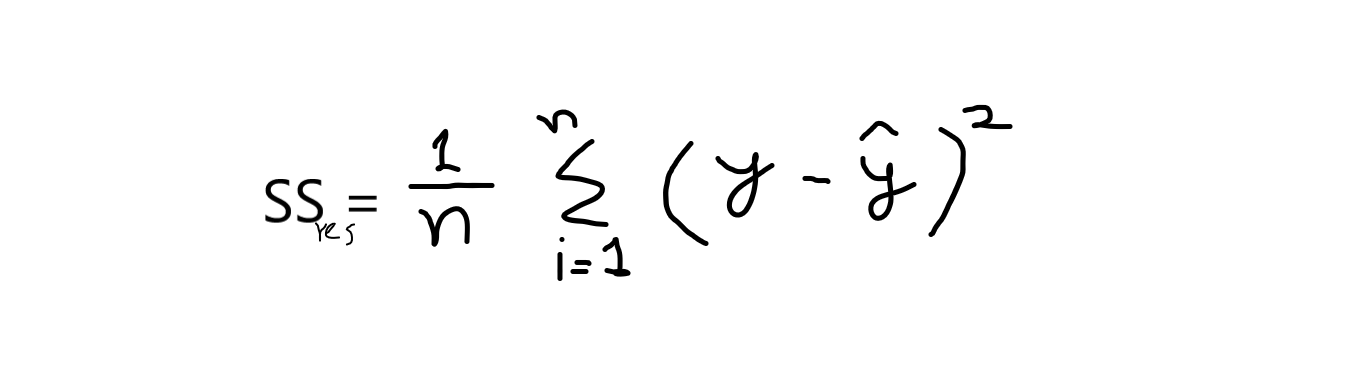
Ja = ursprüngliche Werte
und ^ = vorhergesagte Werte. Ja,
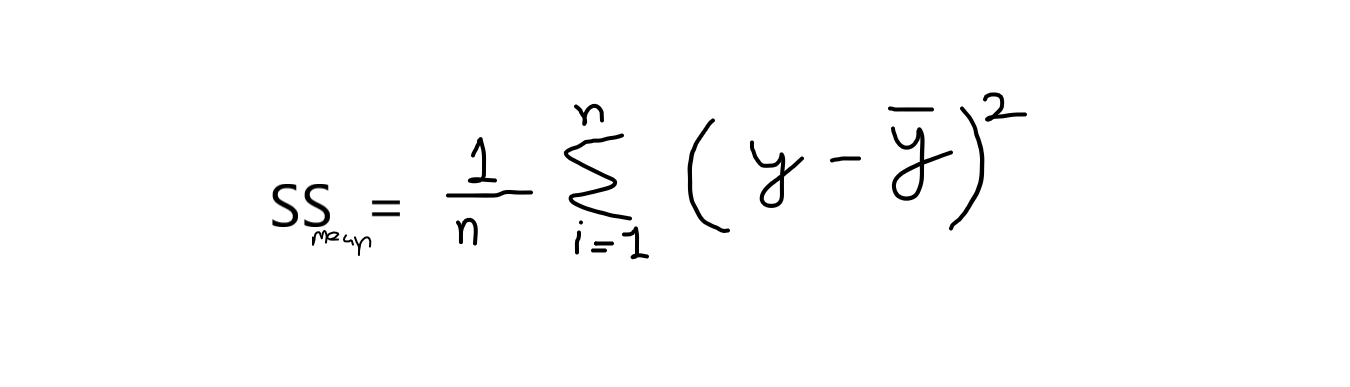
Nehmen wir die Berechnung dieser Gleichung, dann müssen wir wissen, dass der Wert der Summe der Mittelwerte immer größer ist als die Summe der Residuen. Wenn diese Bedingung erfüllt ist, unser Modell ist also gut für Vorhersagen. Seine Werte reichen von 0,0 Ja 1.
„Der Anteil der Varianz in der abhängigen Variablen, der aus dem vorhersagbar ist (S) Variable (S) Unabhängig“.
Die bestmögliche Punktzahl ist 1.0 und es kann negativ sein, weil das Modell beliebig schlechter sein kann. Ein konstantes Modell, das immer den Erwartungswert von y . vorhersagt, unabhängig von Eingangseigenschaften, würde eine R2-Punktzahl von erhalten 0.0.
# Importieren des r2_score-Moduls
de sklearn.metrics importar r2_score
de sklearn.metrics importar mean_squared_error
# Genauigkeitsbewertung vorhersagen
Punktzahl = r2_Punktzahl (y_test, y_vorhersage)
drucken (‚R2 socre is‘, Interpunktion)
drucken (‚mean_sqrd_error ist ==‘, mittlere quadratische Fehler (y_test, y_vorhersage))
drucken (‚root_mean_squared Fehler von ist ==‘, np.sqrt (mittlere quadratische Fehler (y_test, y_vorhersage)))
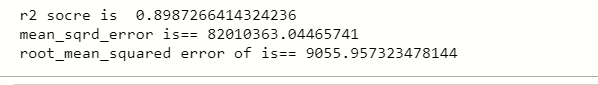
Sie können sehen, dass der Präzisionswert höher ist als 0,8, was bedeutet, dass wir dieses Modell verwenden können, um mehrere lineare Regressionen zu lösen, und auch die quadratische Fehlerrate ist niedrig.
Abschließende Anmerkungen
Hallo, Data Scientists 😎 oben haben wir eine detaillierte Diskussion über die multiple lineare Regression geführt, und das von uns verwendete Beispiel ist das perfekte multiple lineare Regressionsbeispiel. Ich hoffe, Sie verstehen jetzt die multiple lineare Regression besser.
Ich hoffe es hat dir gefallen!
Sie können mich auf LinkedIn verbinden: www.linkedin.com/in/mayur-badole-189221199
Was ist mehr, Lies meine anderen Artikel: https://www.analyticsvidhya.com/blog/author/mayurbadole2407/
Vielen Dank.





