
Einführung
La mayoría de ustedes habría escuchado cosas emocionantes que suceden usando el tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit.... Ich hätte auch gehört, dass Deep Learning viel Hardware braucht. Ich habe Leute gesehen, die tagelang ein einfaches Deep-Learning-Modell auf ihren Laptops trainiert haben. (in der Regel ohne GPU), was den Eindruck erweckt, dass Deep Learning große Systeme benötigt, um zu laufen.
Trotz dieses, Dies ist nur teilweise wahr und schafft einen Mythos rund um Deep Learning, der ein Hindernis für Anfänger darstellt.. Zahlreiche Leute haben mich gefragt, welche Art von Hardware für Deep Learning besser wäre.. Mit diesem Beitrag hoffe ich, Ihnen eine Antwort zu geben.
Notiz: Ich nehme an, Sie haben ein grundlegendes Wissen über Deep-Learning-Konzepte. Wenn dies nicht der Fall ist, Sie sollten diesen Beitrag lesen.
Inhaltsverzeichnis
- Erledigt # 101: DL-Anforderungen
vielHardware- - Training eines Deep-Learning-Modells
- So trainieren Sie Ihr Modell schneller?
- CPU vs GPU
- Kurze Geschichte der GPUs: Wie sind wir hierher gekommen??
- Welche GPU heute zu verwenden ist?
- Die Zukunft sieht spannend aus
Erledigt # 101: Deep Learning-Anforderungen viel Hardware-
Als ich zum ersten Mal in Deep Learning eingeführt wurde, Ich dachte, Deep Learning braucht unbedingt ein großes Rechenzentrum, um zu laufen, und das „Deep-Learning-Experten“ Sie saßen in ihren Kontrollräumen, um diese Systeme zu bedienen..
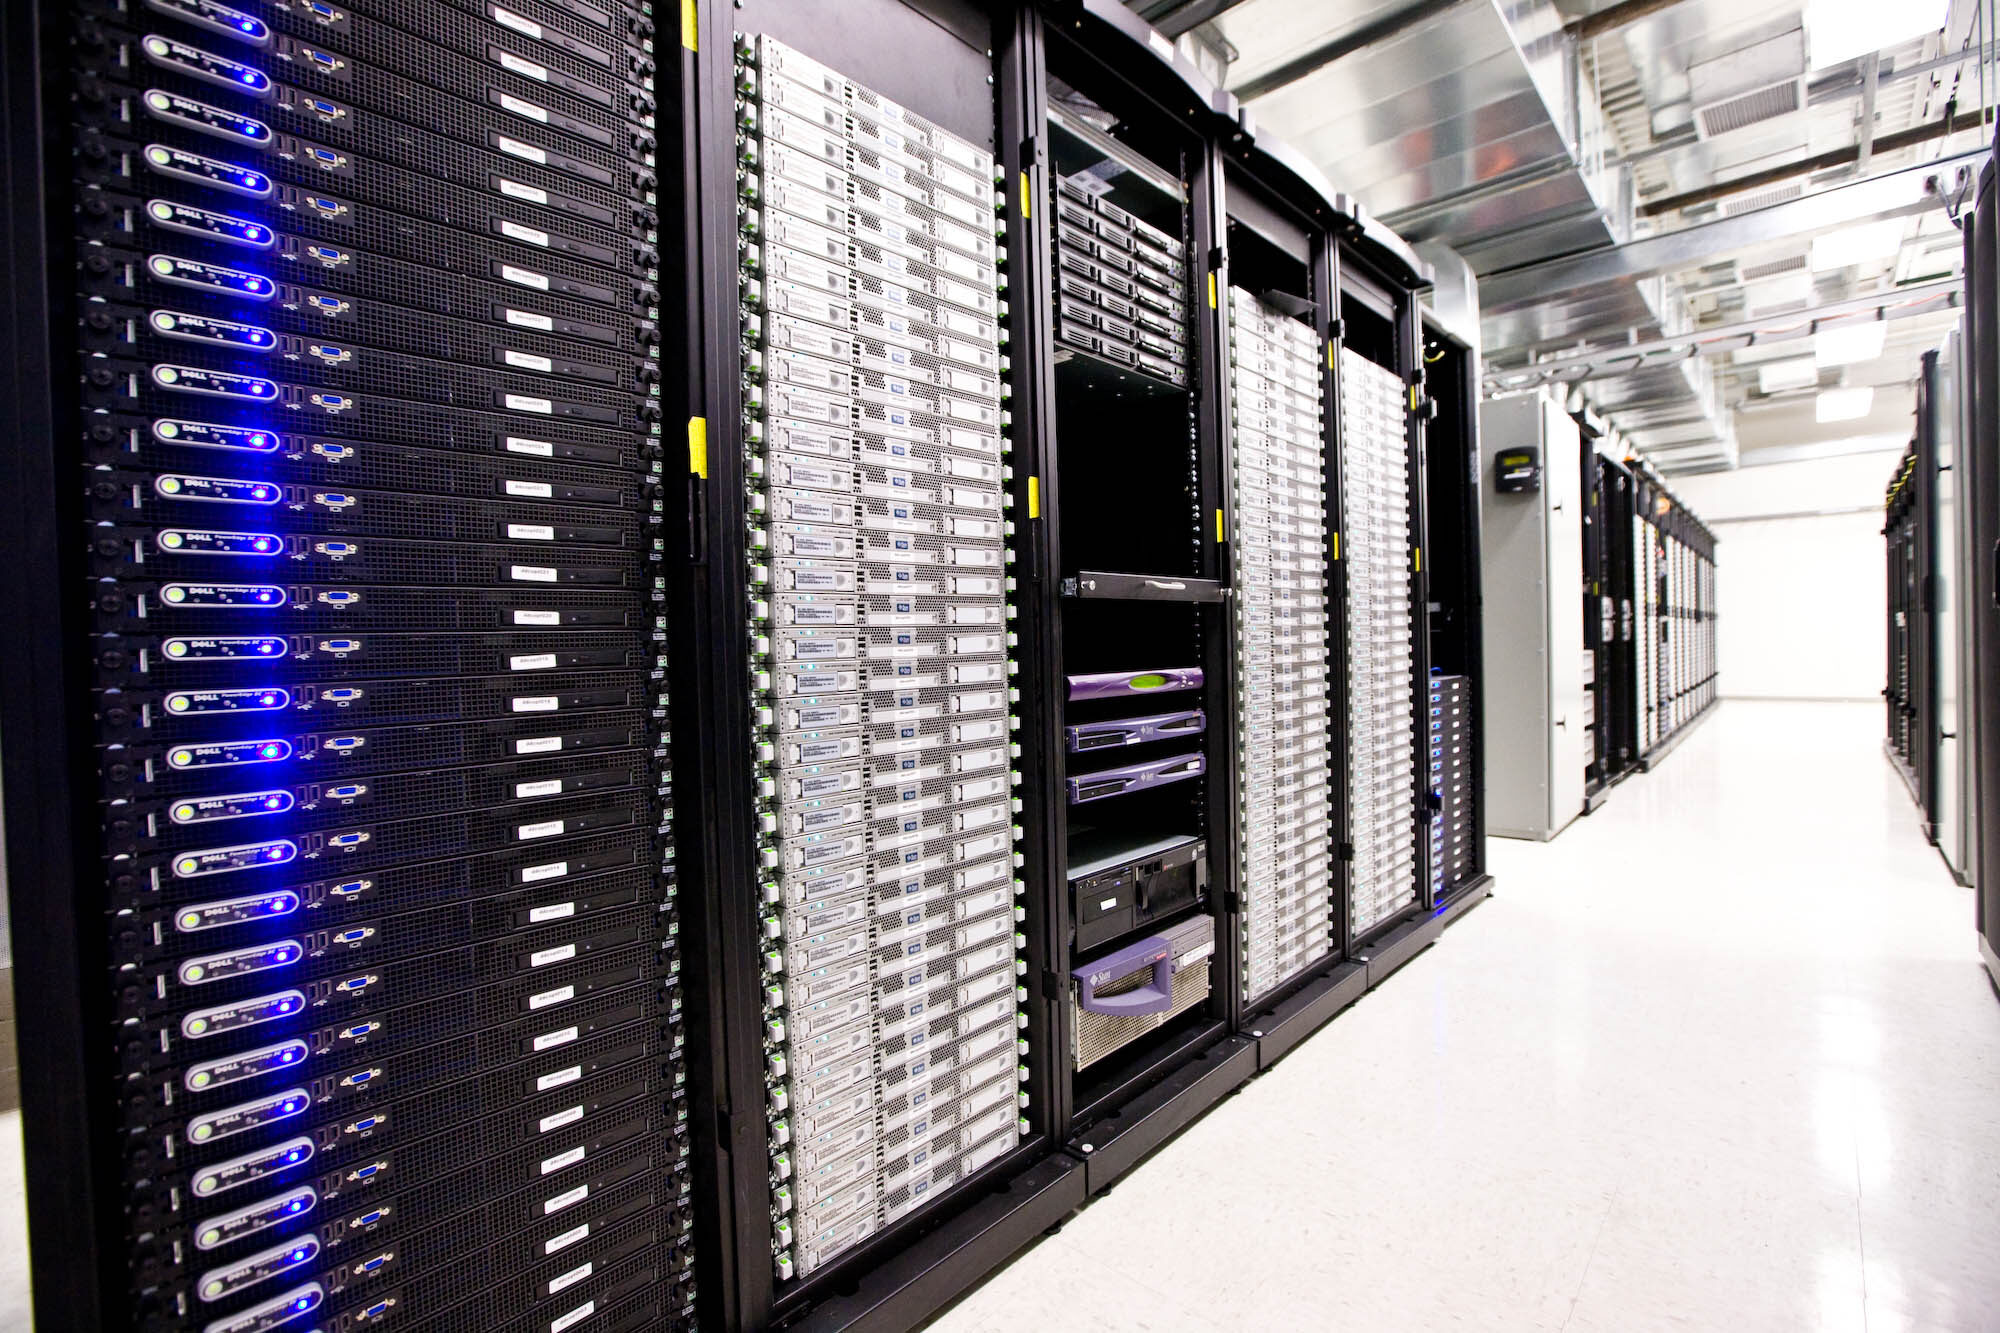
Das liegt daran, dass in jedem Buch, das ich erwähnt habe, oder in jedem Vortrag, den ich gehört habe., Der Autor oder Redner kommentiert immer, dass Deep Learning viel Rechenleistung benötigt, um ausgeführt zu werden. Aber als ich mein erstes Deep-Learning-Modell auf meiner kleinen Maschine baute., Ich war erleichtert!! Ich muss nicht die Kontrolle von Google übernehmen, um ein Deep-Learning-Experte 😀 zu sein
Dies ist ein häufiger Fehler, mit dem alle Anfänger konfrontiert sind, wenn sie in das Deep Learning eintauchen.. Es stimmt zwar, dass Deep Learning erhebliche Hardware benötigt, um effizient zu laufen, Sie brauchen es nicht, um unendlich zu sein, um Ihre Aufgabe zu erfüllen. Sie können sogar Deep-Learning-Modelle auf Ihrem Laptop ausführen!!
Nur ein kleiner Haftungsausschluss; Je kleiner Ihr System ist, Sie benötigen mehr Zeit, um ein trainiertes Modell zu erhalten, das gut genug funktioniert. Einfach, kann so aussehen:
Stellen wir uns eine einfache Frage; Warum wir mehr Hardware für Deep Learning brauchen?
Die Lösung ist einfach, Deep Learning ist ein Algorithmus – ein Software-Build. Definimos una rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen.. artificial en nuestro lenguaje de programación favorito que posteriormente se convertiría en un conjunto de comandos que se ejecutan en la computadora.
Wenn Sie erraten müssten, welche Komponenten des neuronalen Netzwerks Ihrer Meinung nach intensive Hardwareressourcen erfordern würden, Was würden Sie antworten??
Einige der Kandidaten, die ich im Sinn habe, sind:
- Vorverarbeitung der Eingabedaten
- Training des Deep-Learning-Modells
- Speicherung des trainierten Deep-Learning-Modells
- Modellbereitstellung
Unter all diesen, Das Training des Deep-Learning-Modells ist die intensivste Aufgabe. Lassen Sie uns im Detail sehen, warum das so ist..
Training eines Deep-Learning-Modells
Wenn Sie ein Deep-Learning-Modell trainieren, Zwei Hauptoperationen werden durchgeführt:
- Vorverkauf
- Rückwärts gehen
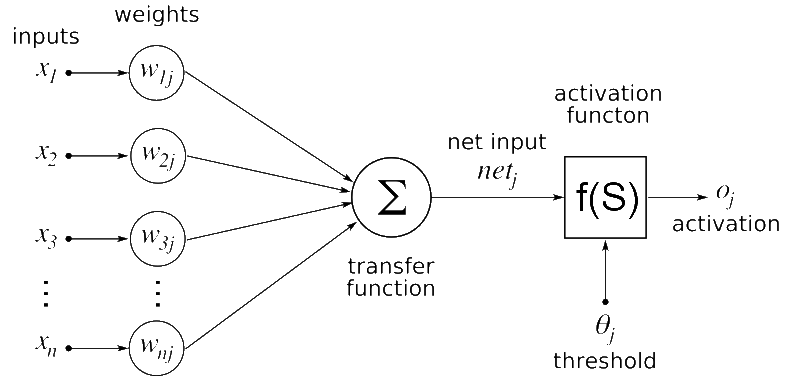
Auf dem Weg nach vorn, die Eingabe wird durch das neuronale Netz geleitet und, nach der Verarbeitung der Eingabe, Eine Ausgabe wird generiert. Während des Rückwärtspasses, Wir aktualisieren die Gewichtungen des neuronalen Netzes basierend auf dem Fehler, den wir im Vorwärtsdurchlauf erhalten.
Beide Operationen sind im Wesentlichen Matrixmultiplikationen. Eine einfache Matrixmultiplikation kann mit dem nächsten Bild dargestellt werden
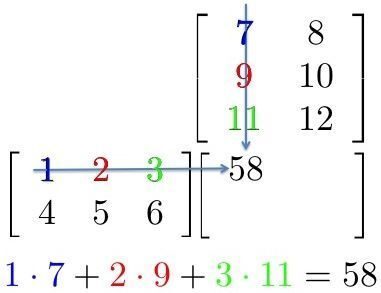
Hier, Wir können sehen, dass jedes Element in einer Zeile der ersten Matrix mit einer Spalte der zweiten Matrix multipliziert wird. Dann, in einem neuronalen Netzwerk, Wir können die erste Matrix als Eingabe in das neuronale Netzwerk betrachten, und die zweite Matrix kann als Netzwerkgewichte betrachtet werden.
Dies scheint eine einfache Aufgabe zu sein. Jetzt, nur um Ihnen eine Vorstellung davon zu geben, welche Art von Deep Learning skaliert: VGG16 (ein rote neuronale FaltungFaltungsneurale Netze (CNN) sind eine Art von neuronaler Netzwerkarchitektur, die speziell für die Datenverarbeitung mit einer Gitterstruktur entwickelt wurde, als Bilder. Sie verwenden Faltungsschichten, um hierarchische Merkmale zu extrahieren, Dies macht sie besonders effektiv bei Mustererkennungs- und Klassifizierungsaufgaben. Dank seiner Fähigkeit, aus großen Datenmengen zu lernen, CNNs haben Bereiche wie Computer Vision revolutioniert.. von 16 Verborgene Ebenen, die häufig in Deep-Learning-Anwendungen verwendet werden) hat ~ 140 Million ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten....; auch bekannt als Gewichtungen und Verzerrungen. Denken Sie nun an all die Matrixmultiplikationen, die Sie tun müssten, um nur einen Eintrag in dieses Netzwerk zu übergeben!! Es würde Jahre dauern, diese Art von Systemen zu trainieren, wenn wir traditionelle Ansätze anwenden..
So trainieren Sie Ihr neuronales Netzwerk schneller?
Wir haben gesehen, dass der rechenintensive Teil des neuronalen Netzwerks aus mehreren Matrixmultiplikationen besteht.. Dann, Wie können wir es schneller machen??
Wir können dies einfach tun, indem wir alle Trades gleichzeitig ausführen, anstatt es nacheinander zu tun.. Knapp, Aus diesem Grund verwenden wir GPUs (Grafikprozessoren) statt CPU (Zentraleinheit) So trainieren Sie ein neuronales Netzwerk.
Um Ihnen ein wenig Intuition zu geben, Wir gehen zurück in die Geschichte, als wir bewiesen haben, dass GPUs für die Aufgabe besser waren als CPUs.
Vor dem Deep-Learning-Boom, Google hatte ein extrem leistungsfähiges System, um seine Verarbeitung durchzuführen, dass sie speziell gebaut hatten, um riesige Netze zu trainieren. Dieses System war monströs und hatte Gesamtkosten von $ 5 Milliarde, mit mehreren CPU-Gruppen.
Jetzt, los investigadores de Stanford construyeron el mismo sistema en términos de computación para entrenar sus Tiefe NetzwerkeTiefe Netzwerke, Auch bekannt als tiefe neuronale Netze, sind Rechenstrukturen, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Diese Netzwerke bestehen aus mehreren Schichten miteinander verbundener Knoten, die es ermöglichen, komplexe Darstellungen von Daten zu erlernen. Sie sind grundlegend im Bereich der künstlichen Intelligenz, insbesondere bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und autonomes Fahren, die Fähigkeit der Maschinen, zu verstehen, zu verbessern und... usando GPU. Und wissen Sie was; reduzierte Kosten für Solo $ 33K! Dieses System wurde mit GPUs gebaut und bot die gleiche Rechenleistung wie das System von Google.. Ziemlich beeindruckend, Wahrheit?
| Stanford | ||
| Anzahl der Kerne | 1K CPU = 16K Kerne | 3GPU = 18K Kerne |
| Kosten | $ 5 Milliarde | $ 33 tausend |
| Tiempo de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... | Woche | Woche |
Wir können sehen, was GPUs regieren. Aber, Was genau ist der Unterschied zwischen einer CPU und einer GPU??
Unterschied zwischen CPU und GPU
Den Unterschied verstehen, Wir nehmen eine klassische Analogie, die den Unterschied intuitiv erklärt.
Angenommen, Sie müssen Waren von einem Ort zum anderen transportieren. Sie haben die Möglichkeit, zwischen einem Ferrari und einem Lastwagen zu wählen.
Ferrari wäre extrem schnell und würde Ihnen helfen, eine Charge von Waren in kürzester Zeit zu transportieren. Aber die Menge an Gütern, die es transportieren kann, ist klein und der Kraftstoffverbrauch wäre sehr hoch..
Ein Lastkraftwagen wäre langsam und würde lange brauchen, um Waren zu transportieren.. Aber die Menge an Waren, die es tragen kann, ist größer im Vergleich zu Ferrari. Zur selben Zeit, ist kraftstoffeffizienter, so ist der Nutzen geringer.
Dann, Welchen würden Sie für Ihren Job wählen??
Offensichtlich, Zuerst sehen Sie, was die Aufgabe ist; Wenn Sie Ihre Freundin dringend abholen müssen, Ich würde auf jeden Fall einen Ferrari einem Lastwagen vorziehen. Aber wenn Sie Ihr Haus bewegen werden, würde einen Lastwagen verwenden, um die Möbel zu transportieren.
So würden Sie die beiden technisch unterscheiden:
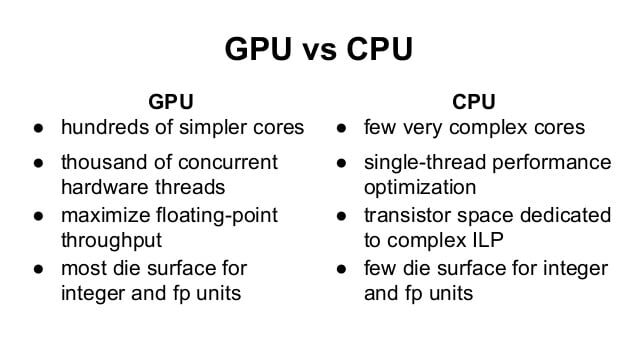
Hier ist ein weiteres Video, das Ihr Konzept weiter verdeutlichen würde.
Notiz: Die GPU wird hauptsächlich für komplexe Spiele und Simulationen verwendet. Diese Aufgaben und hauptsächlich grafische Berechnungen, GPU ist also eine Grafikverarbeitungseinheit. Wenn die GPU für die Nicht-Grafikverarbeitung verwendet wird, werden GPGPU genannt: Allzweck-Grafikprozessor
Kurze Geschichte der GPUs: Wie sind wir hierher gekommen??
Jetzt, Sie fragen sich vielleicht, warum GPUs gerade jetzt so trendy sind. Lassen Sie uns durch eine kurze Geschichte der GPU-Entwicklung reisen.
Einfach, Eine GPGPU ist eine parallele Programmierkonfiguration, die GPUs und CPUs umfasst, die Daten auf eine Weise verarbeiten und analysieren können, die einem Bild oder einer anderen grafischen Weise entspricht.. GPGPUs wurden für eine bessere und allgemeinere Grafikverarbeitung entwickelt, Später stellte sich jedoch heraus, dass sie sich gut für wissenschaftliche Berechnungen eigneten.. Dies liegt daran, dass die meiste Grafikverarbeitung die Anwendung von Operationen auf großen Arrays beinhaltet..
Die Verwendung von GPGPU für wissenschaftliches Rechnen begann in 2001 mit der Implementierung der Matrixmultiplikation. Einer der ersten gängigen Algorithmen, die schneller in GPUs implementiert wurden, war die LU-Berücksichtigung 2005. Aber, im Augenblick, Die Forscher mussten alle Algorithmen auf einer GPU programmieren und die Low-Level-Grafikverarbeitung verstehen..
In 2006, Nvidia führte eine hochrangige CUDA-Sprache ein, unterstützt Sie beim Schreiben von Programmen von Grafikprozessoren in einer Hochsprache. Dies war wahrscheinlich eine der wichtigsten Veränderungen in der Art und Weise, wie Forscher mit GPUs interagieren..
Welche GPU heute zu verwenden ist?
Hier werde ich Ihnen schnell etwas technisches Wissen vermitteln, bevor ich eine GPU für Deep Learning kaufe.
Bühne 1:
Das erste, was Sie bestimmen müssen, ist, welche Art von Ressource Ihre Aufgaben erfordern. Ob Ihre Aufgaben klein sein werden oder in eine komplexe sequenzielle Verarbeitung passen, Sie brauchen kein großes System, um zu funktionieren. Sie könnten sogar die Verwendung von GPus ganz überspringen. Deswegen, wenn Sie vorhaben, hauptsächlich in "anderen" Bereichen zu arbeiten / ML-Algorithmen, Sie benötigen nicht unbedingt eine GPU.
Bühne 2:
Wenn Ihre Aufgabe etwas intensiv ist und Sie über überschaubare Daten verfügen, eine vernünftige GPU wäre eine bessere Wahl für Sie. Ich benutze meinen Laptop im Allgemeinen, um an Spielzeugproblemen zu arbeiten, die eine etwas veraltete GPU hat (eine Nvidia GT 740M mit 2 GB). Ein Laptop mit GPU hilft mir, Dinge überall auszuführen.. Es gibt einige High-End-Laptops (und voraussichtlich schwer sein) mit Nvidia GTX 1080 (ein VRAM von 8 GB) die Sie am Ende überprüfen können.
Bühne 3:
Wenn Sie regelmäßig an komplexen Problemen arbeiten oder ein Unternehmen sind, das Deep Learning nutzt, probablemente sería mejor que creara un sistema de aprendizaje profundo o utilizara un Cloud-DienstDas "Cloud-Dienst" bezieht sich auf die Bereitstellung von Rechenressourcen über das Internet, Benutzern den Zugriff auf den Speicher ermöglichen, Verarbeitung und Anwendungen ohne physische Infrastruktur vor Ort. Dieses Modell bietet Flexibilität, Skalierbarkeit und Kosteneinsparungen, Da Unternehmen nur für das bezahlen, was sie nutzen. Was ist mehr, Erleichtert die Zusammenarbeit und den Datenzugriff von überall aus, Verbesserung der betrieblichen Effizienz in verschiedenen Branchen.. como AWS o FloydHub. Bei DataPeaker erstellen wir für uns ein Deep-Learning-System, für die wir unsere Spezifikationen teilen. Hier ist der Beitrag.
Bühne 4:
Wenn Sie Google sind, Sie benötigen wahrscheinlich ein anderes Rechenzentrum, um es zu warten. Witze beiseite, wenn Ihre Aufgabe größer als üblich ist und Sie genügend Taschengeld haben, um die Kosten zu decken; Sie können für a wählen ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen.... de GPU y hacer computación con múltiples GPU. Es gibt auch einige Optionen, die in naher Zukunft verfügbar sein könnten., als schnellere TPU und FPGAs, das würde dir das Leben leichter machen.
Die Zukunft sieht spannend aus
Wie zuvor genannt, Es gibt eine Menge Forschung und aktive Arbeit, um über Alternativen zur Beschleunigung der Datenverarbeitung nachzudenken. Google wird voraussichtlich Tensorflow Processing Units einführen (TPU) Später in diesem Jahr, was eine Beschleunigung über den aktuellen GPUs verspricht.
Äquivalent, Intel arbeitet an schnelleren FPGAs, die in den kommenden Tagen mehr Flexibilität bieten kann. Zur selben Zeit, Die Angebote von Cloud Service Providern (als Beispiel, AWS) sie nehmen auch zu. Wir werden sehen, wie jeder von ihnen in den kommenden Monaten auftaucht..
Abschließende Anmerkungen
In diesem Beitrag, Wir haben die Motivationen für die Verwendung einer GPU für Deep-Learning-Anwendungen behandelt und gesehen, wie Sie sie für Ihre Aufgabe auswählen können. Ich hoffe, dieser Beitrag war für Sie nützlich.. Wenn Sie spezielle Fragen zum Thema haben, Fühlen Sie sich frei, unten zu kommentieren oder fragen Sie unter Diskussionsportal.





