
Einführung
Anstatt mit der Definition von Statistik zu beginnen, Ich möchte mit dem Zitat aus Karl Pearsons Definition von Statistik beginnen, „Statistik ist die
Grammatik der Wissenschaft".
Vor kurzem, alle reden über daten. Nachdem ich das Wort gehört habe „Daten“ das Grundlegende Fragen, die sich in unseren Köpfen stellen, sind,
Was sind Daten??
Wie werden die Daten erhoben?
Wie können die Daten analysiert werden?
Wie werden die Daten interpretiert?
Um all diese Fragen zu beantworten, der Begriff „Statistiken“ Gebraucht. Statistik ist das grundlegende und wichtige Werkzeug zur Verarbeitung von Daten. Kommen wir nun zur Definition von Statistik, es geht um die Zusammenstellung, beschreibend, Datenanalyse und Schlussfolgerung.
Es gibt zwei Arten von Statistiken, Deskriptive und inferenzielle Statistik.
In Beschreibende Statistik, aus der gegebenen Beobachtung, die Daten sind zusammengefasst. Die Zusammenfassung erfolgt unter Berücksichtigung der Grundgesamtheitsstichprobe unter Verwendung des Mittelwerts oder der Standardabweichung.
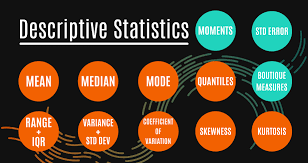
Es gibt vier verschiedene Kategorien in der Deskriptiven Statistik. Sohn,
- Frequenzmessung
- Dispersionsmessung
- Maß der zentralen Tendenz
- Positionsmessung.
Basierend auf der Häufigkeit, mit der ein bestimmtes Datenelement aufgetreten ist, die Frequenzmessung ist definiert. Das Ausbreitungsmaß kann anhand der Reichweite definiert werden, die abweichung, die Standardabweichung, etc. Durchschnitt, das MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird...., die Art und Schiefe der jeweiligen Daten gehen in das Maß der zentralen Tendenz ein. Schließlich, Basierend auf dem Perzentil und dem Quartil wird die Position gemessen.
Dann schau dir an Inferenzstatistik, sobald die Daten gesammelt wurden, tabellieren und analysieren, Zusammenfassung oder Inferenz wird mithilfe von Inferenzstatistiken abgeleitet. Schlussfolgerungen werden basierend auf Stichprobenvariation und Beobachtungsfehler gezogen.
Basierend auf den Informationen und den aus der Stichprobe abgeleiteten Schlussfolgerungen, Inferenzstatistiken helfen uns, Ergebnisse für die Bevölkerung vorherzusagen und abzuschätzen.
STATISTISCHE DATENANALYSE
Statistiken werden in verschiedenen Bereichen unseres täglichen Lebens verwendet, um die richtigen Daten zu analysieren. Basierend auf der Interpretation, Entwicklungsschritte werden sowohl im öffentlichen als auch im privaten Sektor unternommen.
Bevor Sie mit der Datenanalyse beginnen, Es gibt einige Dinge, an die man sich erinnern sollte.
Definiere deine Frage, die richtigen Daten sammeln, die Daten verstehen, saubere Daten, analysieren die Daten und interpretieren abschließend die Ergebnisse der Fragen.
Was definiert die Frage? Für eine Organisation, Verbesserungsschritte werden aus der vorherigen Datenanalyse übernommen. Für bessere Schritte, Es wird einige Ziele geben, die perfekt zu beantworten sind, um eine gute Interpretation zu geben. Die Frage sollte die mögliche Lösung des Problems geben. Für diesen Rahmen, eine relevante Frage ist wichtiger. Allein aufgrund der Fragen, die Daten werden erhoben. Dann, Die Fragestellung spielt eine wichtige Rolle.
Zum Beispiel, in einer Firma, wenn die Mitarbeiterfluktuation hoch ist. Die Lösung zur Reduzierung der Versetzung des Mitarbeiters des Unternehmens muss so verfolgt werden, dass die grundlegenden Variablen wie die Erfahrung des Mitarbeiters, Ihr zufriedenstellendes Niveau, deine förderung, Dauer des Arbeitstages, etc., werden so festgelegt, dass das Problem gelöst werden kann, um eine mögliche Lösung zu geben.
So sammeln Sie die richtigen Daten? Die Datensammlung hat zwei Klassifikationen. Einer sind Primärdaten und einer sind Sekundärdaten. In Primärdaten, Daten werden durch Fragebögen erhoben, indem Sie E-Mails senden oder sich an jede Person wenden. Zum Beispiel Volkszählung. Während, in Sekundärdaten, es sind die Daten, die bereits in der sekundären Quelle wie einer Agentur verfügbar sind, und DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten.....
Jetzt, bevor Sie die neuen Daten sammeln, vorhandene Daten identifizieren, die in der Datenbank verfügbar sind. Abgesehen davon, sammelt die relevanten Daten, um das Ziel zu erreichen. Später, Organisieren Sie vorhandene Daten mit neuen Daten, um die Analyse fortzusetzen. Zum Beispiel: Den gleichen Fall der Kündigung des Arbeitnehmers annehmen, die zu sammelnden Daten sind Erfahrungen im Unternehmen, Arbeitszeit, Schulische Qualifikation, Entfernung von zu Hause, Reisezeit, Aufstieg, Alter des Mitarbeiters, inkrementieren oder gehen, etc., diese Es ist wichtig, Daten zu sammeln, um den Grund für die Kündigung von Mitarbeitern zu finden. Möglicherweise sind bereits wenige Variablen in der Datenbank vorhanden und neue Variablen können nach Bedarf hinzugefügt werden.
Warum müssen wir die Daten verstehen?? Sobald die Daten gesammelt wurden, kann es viele Variablen geben, die direkt oder indirekt mit dem Ziel in Zusammenhang stehen. Dafür, Zuerst müssen wir alle Variablen untersuchen, ya meer nominal u ordinal. Die Vorbereitung der Daten für die Analyse erfolgt nach dem Verständnis der Daten. Während wir verstehen, wir lernen die Datentypen kennen, Reihen und Spalten, fehlt in den Daten, finde die unabhängigen und abhängigen Variablen, etc.
Es kann einige Variablen geben, die nicht mit der Frage der Organisation zusammenhängen, und diese Variablen können in Zukunft für zukünftige Analysen verwendet werden.. Um solche Variablen zu finden, es ist wichtiger, die Daten zu verstehen. Nehmen wir das gleiche Beispiel der Mitarbeiterabwanderung, es können Daten zur Familie vorhanden sein, als Familienmitglieder, mehrjährige Erfahrung in einem früheren Unternehmen, sozialer Status, etc., jede VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... muss so verstanden werden, dass die Daten auf diese Weise aufgeteilt werden, um die Frage zu beantworten.
Wie erfolgt die Datenbereinigung?? Datenbereinigung ist der Prozess der Änderung von Daten, Entfernen Sie doppelte Variablen und erstellen Sie bei Bedarf Dummy-Variablen. Entfernen Sie unerwünschte Spalten, die sich nicht auf die Frage beziehen. Wenn die Datenbereinigung nicht ausreicht, kann zu einer geringeren Modellgenauigkeit und zu irreführenden Schlussfolgerungen führen.
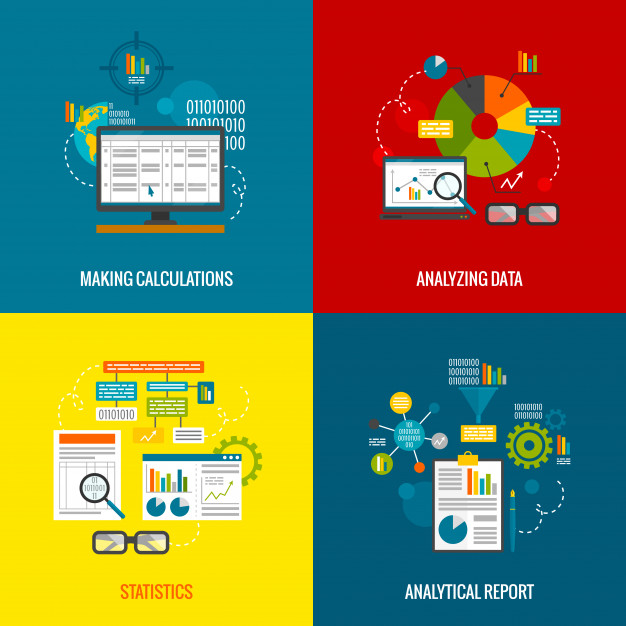
Sobald die Datenbereinigung abgeschlossen ist, die richtigen Daten zur Beantwortung der Frage sind fertig. Datenmanipulation erfolgt auf viele Arten, wie man die Daten plottet, Pivot-Tabellen für Variablen erstellen, Korrelation, Regression und Erkennung von Ausreißern. Der Prozess kann stattfinden. Während der Bearbeitungsphase, es kann notwendig sein, mit einem bestehenden Datensatz fortzufahren oder einen Datensatz zu löschen oder weitere Daten hinzuzufügen, um die Frage zu beantworten. Nach all diesen Phasen, die erforderlichen Daten stehen zur Analyse bereit.
So analysieren Sie die Daten? Wenn es um Analyse geht, kommt es vor allem auf die Auswahl der Modelle an. Die Auswahl des Modells spielt eine wichtige Rolle bei der Analyse der Daten und der Reaktion auf das Ziel. Die Definition der abhängigen und unabhängigen Variablen ist der wichtige Schritt bei der Analyse der Daten.. Heutzutage, Techniken des maschinellen Lernens werden für die Datenanalyse verwendet, damit Vorhersagen und Interpretationen leicht gemacht werden können. Aber dennoch, Einige Ziele können direkt beantwortet werden, während die Datenvisualisierung und grundlegende statistische Analyse durchgeführt werden. Die Werkzeuge zur Analyse der Daten sind, Python, Excel, Programmierung R, SPSS, WAR, etc.,
Korrelation wird verwendet, um die Beziehung oder Assoziation zwischen zwei oder mehr Variablen zu finden. Der Zusammenhang besteht zwischen den Werten -1 ein +1. Die Interpretation ist, dass, wenn die Korrelation ist +1 dann ist es stark positiv korreliert, -1 dann ist es stark negativ korreliert und 0 impliziert, dass es keinen Zusammenhang gibt. Korrelation funktioniert sowohl für quantitative als auch für qualitative Daten.
Ankunft in Rückschritt, Diese Analyse wird verwendet, wenn wir die Abhängigkeiten einer Variablen von der anderen finden müssen. Der Regressionswert liegt zwischen 0 Ja 1. Wenn der Regressionswert 1, es passt also perfekt und 0, passt also nicht gut. Das Vorhersagemodell kann mithilfe der Regressionsanalyse durchgeführt werden. Dabei werden auch quantitative und qualitative Daten verwendet. Es gibt zwei Arten von Regressionsanalysen. Lineare Regression und multiple lineare Regression.
In Lineare Regression, hat eine abhängige Variable und eine unabhängige Variable. Zum Beispiel, wenn der preis niedrig ist, Der Umsatz wird hoch. Im Falle des multiple lineare Regression Modell, hat eine unabhängige Variable und mehrere abhängige Variablen. Zum Beispiel, Der Preis des Hauses hängt von der Anzahl der Zimmer im Haus ab, Fläche jedes Zimmers, Anzahl Parkplätze, Anlagen, Ort, etc.
Im Falle des Überlebensanalyse, wenn sich die Daten auf den Zeitpunkt des Eintretens eines Ereignisses beziehen, dann kann die Überlebensanalyse angewendet werden. Die Veranstaltung hat das Ergebnis als 0 Ö 1. Zum Beispiel, das Überleben des Patienten nach einem Herzinfarkt kann gekennzeichnet werden durch 0 Ö 1. 0 bezeichnet die Person, die nicht überlebt hat und 1 bedeutet, dass er überlebt hat. Dies kann vorhergesagt werden, indem man die Variablen als Alter nimmt, Raucher oder Nichtraucher, Person, die in städtischen oder ländlichen Gebieten lebt, Blutdruck haben oder nicht. Basierend auf allen Faktoren, die berücksichtigt werden, der Überlebensstatus der Person kann abgeschätzt werden. Heutzutage, Überlebensanalyse kann bei COVID-Patienten angewendet werden.
Endlich zum Teil von Techniken des maschinellen Lernens, wie Random Forest, Entscheidungsbaum, KNN, etc., kann bei der Vorhersage- und Klassifikationstechnik angewendet werden. Am Beispiel der Mitarbeiterfluktuation, die gezielte Ausrichtung des Mitarbeiters, der das Unternehmen verlassen kann, kann mit der Klassifikationstechnik ermittelt werden. Verschiedene Modelle können entwickelt werden und, basierend auf der Genauigkeit der Modelle, Sie können bestimmen, welches Modell die zukünftige Mitarbeiterabwanderung vorhersagen kann. Wenn die Genauigkeit größer ist, Dieses spezielle Modell kann verwendet werden, um zukünftige Daten vorherzusagen.
Interpretation das Ergebnis: Nach der Analyse der Daten, Es ist Zeit, das Ergebnis zu interpretieren. Überprüfen Sie bei der Interpretation des Ergebnisses, ob die Analyse alle gestellten Fragen beantwortet hat, die gesammelten Daten halfen bei der Analyse, und aus der Interpretation ergibt sich ein positives Ergebnis für die Verbesserung der Zielsetzung. Betrachten wir unser Beispiel der Mitarbeiterabwanderung, Der Analyseteil sollte einige bessere Schritte oder Verbesserungen vorschlagen, um die Abwanderung von Mitarbeitern aus dem Unternehmen zu reduzieren.
Dies sind die wichtigsten Grundlagen, die bei der statistischen Datenanalyse zu tun und zu beachten sind.
Schließlich, Ich möchte die Worte von Seth Godin zitieren: „Daten sind erst dann nützlich, wenn sie in Informationen umgewandelt werden „
Ich hoffe, jeder hat einige grundlegende Einblicke in Statistiken und Datenanalyse mithilfe von Statistiken gewonnen.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





