
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Eine Anomalie ist eine Beobachtung, die deutlich von allen anderen Beobachtungen abweicht. Ein Anomalieerkennungssystem ist ein System, das Anomalien in Daten erkennt. Eine Anomalie wird auch als Ausreißer bezeichnet.
Beispiel: Nehmen wir an, eine Datenspalte besteht aus dem monatlichen Einkommen der Bürger und diese Spalte enthält auch das Gehalt von Bill Gates. Dann, Das Gehalt von Bill Gates ist ein Ausreißer in diesen Daten.
Algorithmen zur Anomalieerkennung
In diesem Blog, Schauen wir uns die folgenden Algorithmen zur Anomalieerkennung an.
Dies sind einige der vielen verfügbaren Algorithmen und unterlassen Sie es nie, weitere andere Algorithmen als diese zu erkunden.
Importieren Sie die erforderlichen Bibliotheken und schreiben Sie die Dienstprogrammfunktionen
# Python-Ausreißererkennung
!pip installieren pyod
Importwarnungen
numpy als np importieren
Pandas als pd importieren
von pyod.models.mad import MAD
von pyod.models.knn KNN importieren
von pyod.models.lof importieren LOF
import matplotlib.pyplot als plt
von sklearn.ensemble importieren IsolationForest
# Daten zur Anomalieerkennung
data_values = [['2021-05-1', 45000.0],
['2021-05-2', 70000.0],
['2021-05-3', 250000.0],
['2021-05-4', 70000.0],
['2021-05-5', 45000.0],
['2021-05-6', 55000.0],
['2021-05-7', 35000.0],
['2021-05-8', 60000.0],
['2021-05-9', 45000.0],
['2021-05-10', 25000.0],
['2021-05-11', 142936.0],
['2021-05-12', 138026.0],
['2021-05-13', 28347.0],
['2021-05-14', 40962.66],
['2021-05-15', 34543.0],
['2021-05-16', 40962.66],
['2021-05-17', 25207.0],
['2021-05-18', 37502.0],
['2021-05-19', 29589.0],
['2021-05-20', 78404.0],
['2021-05-21', 26593.0],
['2021-05-22', 123267.0],
['2021-05-23', 46880.0],
['2021-05-24', 65361.0],
['2021-05-25', 46042.0],
['2021-05-26', 48209.0],
['2021-05-27', 44461.0],
['2021-05-28', 90866.0],
['2021-05-29', 46886.0],
['2021-05-30', 33456.0],
[' 2021-05-31', 46251.0],
['2021-06-1', 29370.0],
['2021-06-2', 165620.0],
['2021-06-3', 20317.0]]
data = pd.DataFrame(Datenwerte , Spalten=['date', 'Amount'])
def fit_model(Modell, Daten, column='amount'):
# Passen Sie das Modell an und sagen Sie es voraus
df = data.copy()
data_to_predict = Daten[Säule].to_numpy().umformen(-1, 1)
Vorhersagen = model.fit_predict(data_to_predict)
df['Predictions'] = Vorhersagen
zurück df
def plot_anomalien(df, x='date', y='amount'):
# Kategorien haben Werte von 0 zu n
# für jeden Wert in 0 bis n wird es in Colormap abgebildet
Kategorien = df['Predictions'].to_numpy()
colormap = np.array(['g', 'r'])
f = plt.figur(Feigengröße=(12, 4))
f = Plt.Streuung(df[x], df[Ja], c=Farbkarte[Kategorien])
f = plt.xlabel(x)
f = plt.ylabel(Ja)
f = plt.xticks(Drehung=90)
plt.zeigen()
Die obigen Daten bestehen aus zwei Spalten, nämlich, Datum und Betrag, wir können davon ausgehen, dass die Daten den Umsatz eines Bäckerei-Display-Unternehmens enthalten.
Was macht die Funktion fit_model??
- Die Funktion fit_model verwendet das Modell und die Daten als Eingabe, hier finden wir Anomalien in der Mengenspalte.
- Danach, ändert die Form der Daten in eindimensionale Daten und passt das bereitgestellte Modell an und sagt Anomalien in den Daten vorher und speichert sie in der Vorhersagespalte des bereitgestellten Datenrahmens, und gibt es zurück.
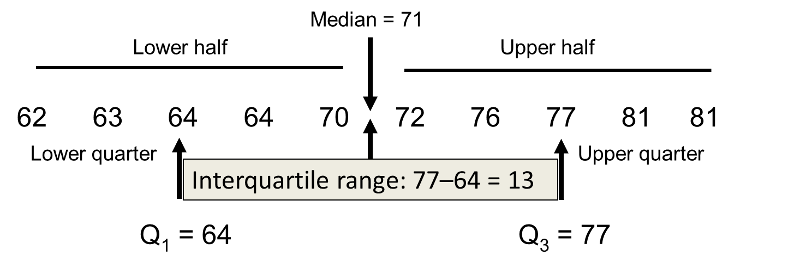
Interquartilsabstand
Perzentile:
Quartile:
-
11. Quartil = Perzentil 25
-
2c Quartil = Perzentil 50
-
3.1. Quartil = Perzentil 75
Interquartilsabstand (IQR):
IQR = 3. Quartil – 1ähm cuartil
Anomalien = [1Quartil – (1.5 * IQR)] Ö [3rd Quartil + (1.5 * IQR)]
Die Anomalien sind unten [1Quartil – (1.5 * IQR)] und darüber [3rd Quartil + (1.5 * IQR)] diese Werte.
def find_anomalien(Wert, Untere Schwelle, obere_schwelle):

    wenn Wert < Lower_threshold oder Wert > obere_schwelle:
        Rückkehr 1
    anders: Rückkehr 0

def iqr_anomaly_detector(Daten, column='amount', Schwelle=1,1):

    df = data.copy()
    Quartile = dict(Daten[Säule].Quantil([.25, .50, .75]))
    Quartil_3, Quartil_1 = Quartile[0.75], Quartile[0.25]
    iqr = Quartil_3 - Quartil_1

    Lower_threshold = Quartil_1 - (Schwelle * iqr)
    oberer_schwellenwert = quartil_3 + (Schwelle * iqr)

    drucken(F"Untere Schwelle: {Untere Schwelle}, nObere Schwelle: {obere_schwelle}n")

    df['Predictions'] = Daten[Säule].anwenden(find_anomalien, args=(Untere Schwelle, obere_schwelle))
    zurück df

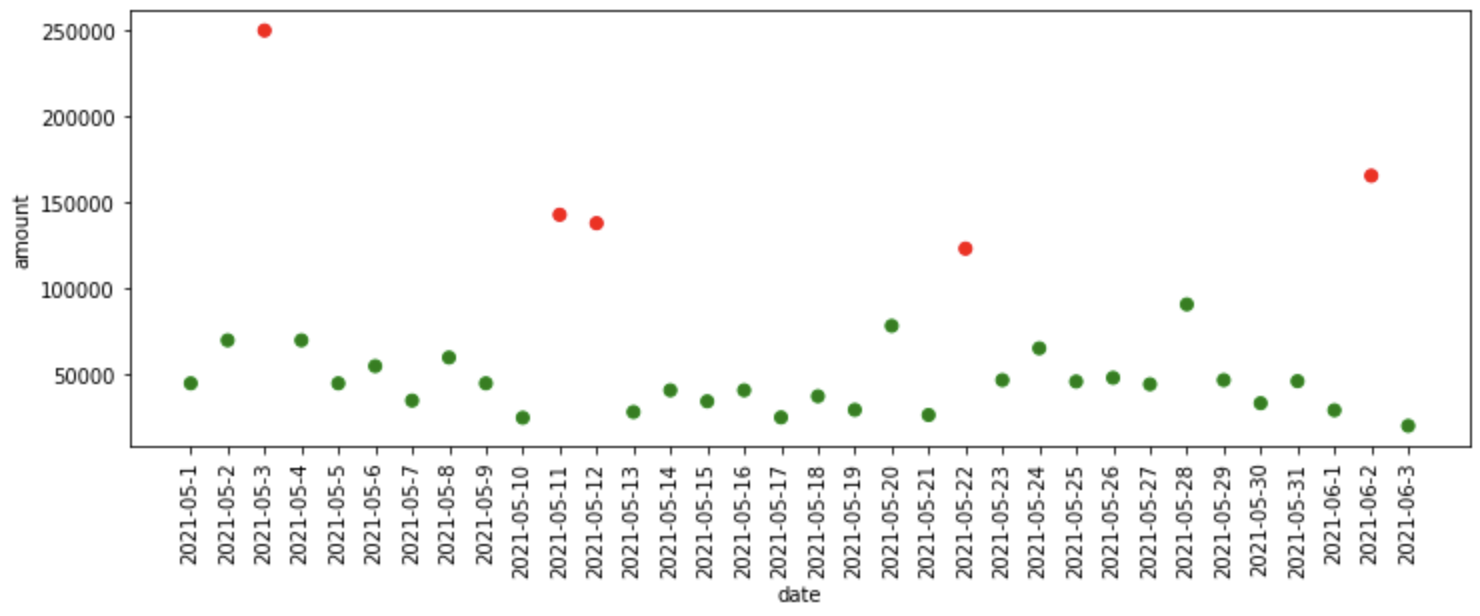
iqr_df = iqr_anomaly_detector(Daten)
plot_anomalien(iqr_df)
# Ausgang
# Untere Schwelle: -2944.050000000003,
# Obere Schwelle: 106441.55
Was ist im obigen Code passiert??
- Zuerst, finde das Perzentil heraus 25 Ja 75, nämlich, das 1. und 3. Quartil wurden gefunden.
- Und später, der Interquartilsabstand wird gefunden, das ist die Differenz zwischen dem dritten und dem ersten Quartil.
- Danach, wir finden die obere und untere Schwelle, oberhalb und unterhalb derer die Anomalien liegen, beziehungsweise.
- Die obige Funktion find_anomalies findet die Anomalien in den Daten gemäß den angegebenen Schwellenwerten.
- Schließlich, wir verfolgen die gefundenen Anomalien.
Isolationswald
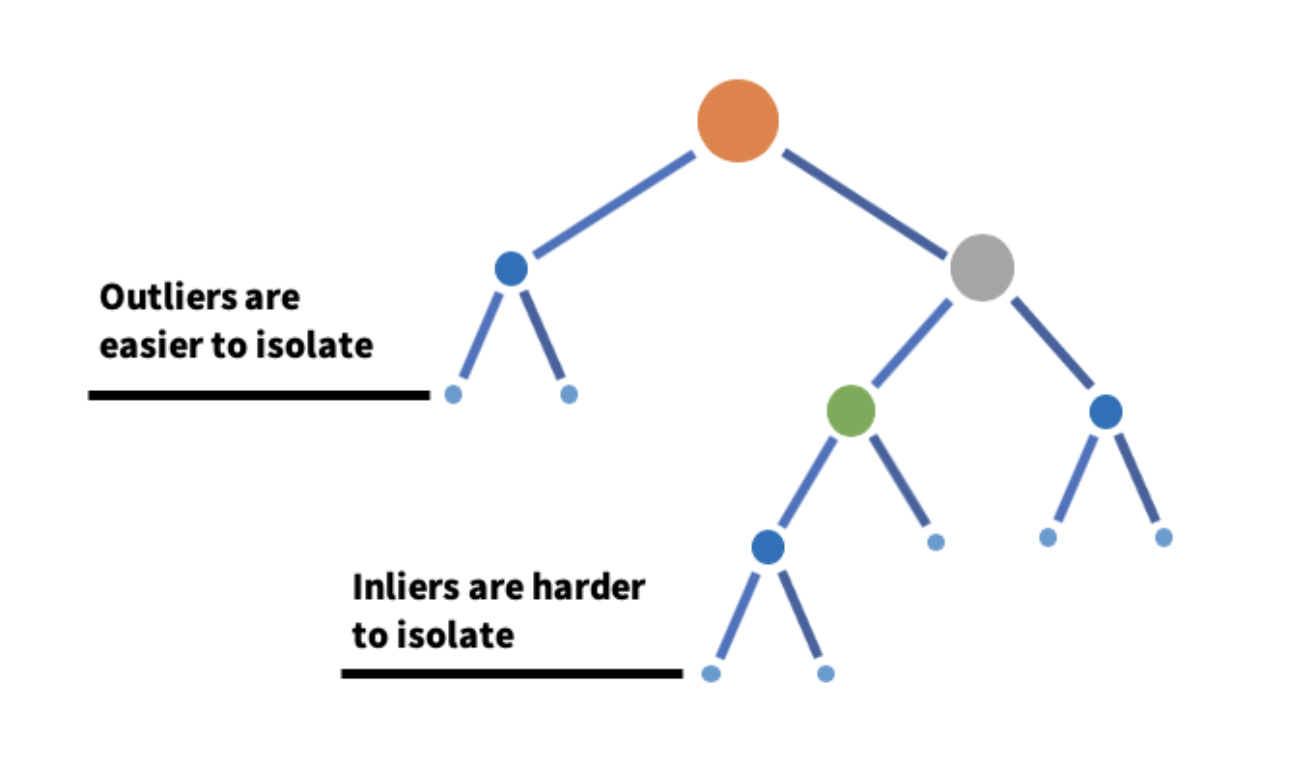
Isolation Forest ist ein Algorithmus, der Anomalien erkennt, indem er eine Teilmenge von Daten nimmt und daraus viele Isolationsbäume erstellt..
-
Die Kernidee ist, dass Anomalien viel einfacher zu isolieren sind als normale Beobachtungen und Anomalien in viel geringeren Tiefen eines Isolationsbaums existieren.. Ein Isolationsbaum wird erstellt, indem ein Merkmal zufällig ausgewählt und ein Wert dieses Merkmals zufällig ausgewählt wird. Ein Wald wird gebaut, indem alle Isolationsbäume hinzugefügt werden.
iso_forest = IsolationWald(n_Schätzer = 125)
iso_df = fit_model(iso_forest, Daten)
iso_df['Predictions'] = iso_df['Predictions'].Karte(Lambda x: 1 wenn x==-1 sonst 0)
plot_anomalien(iso_df)
Was ist im obigen Code passiert??
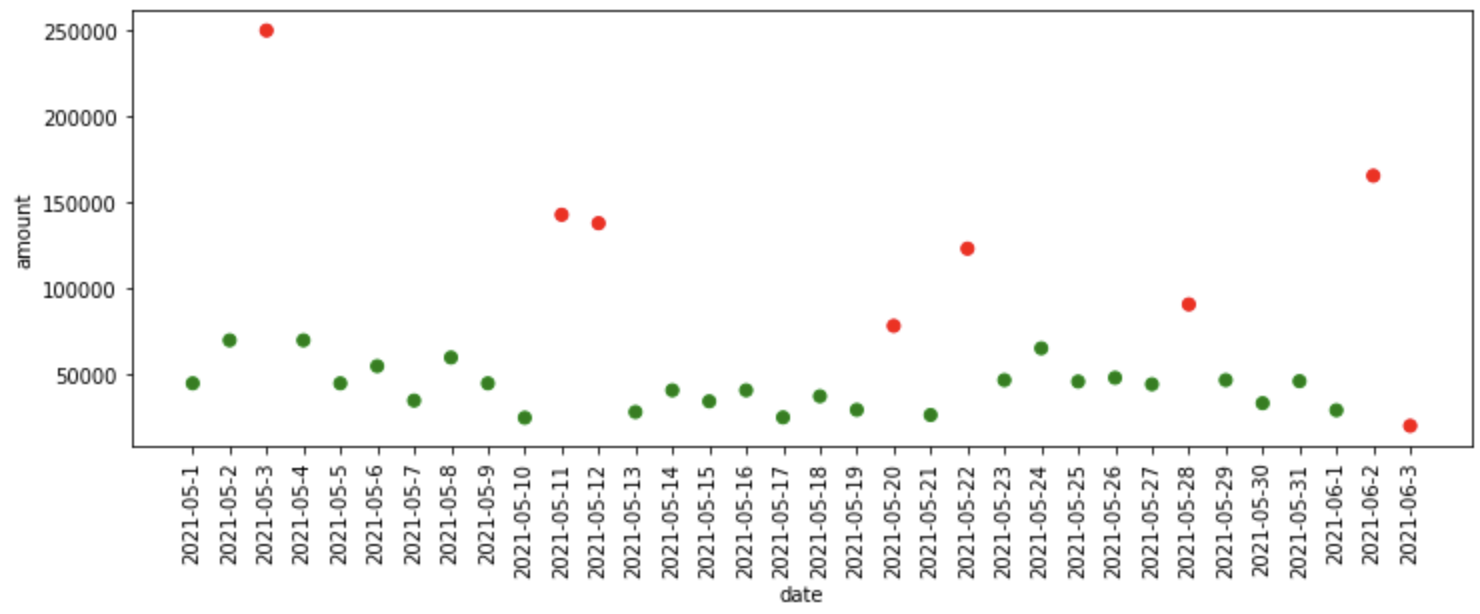
- Zuerst, wir definieren das Isolation Forest-Modell mit 125 Isolationsbäume, dann übergeben wir das modell, die Daten als Eingaben für die Funktion fit_model, wo es das Modell an die Daten anpasst und uns Vorhersagen liefert.
- Der Isolationswald weist -1 auf anomale Daten und 1 zu normalen Daten, um es zu vereinfachen, wir konvertieren die Vorhersage von normalen Daten (1) ein 0 und die Vorhersage von anomalen Daten (-1) ein 1.
- Schließlich, wir zeichnen die von Isolation Forest vorhergesagten Anomalien.
Mittlere absolute Abweichung
La desviación absoluta media es la diferencia entre cada observación y la MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird.... de esas observaciones. Eine Beobachtung, die stärker vom Rest der Beobachtung abweicht, wird als Anomalie betrachtet..
Warum Median statt Mittelwert?
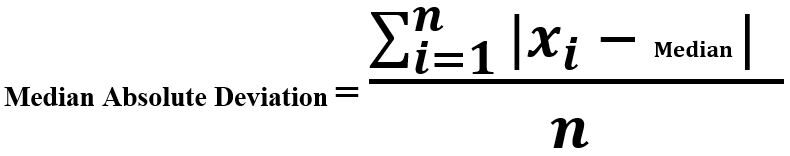
"""Mittlere absolute Abweichung"""
mad_model = MAD()
mad_df = fit_model(mad_model, Daten)
plot_anomalien(mad_df)
Was ist im obigen Code passiert??
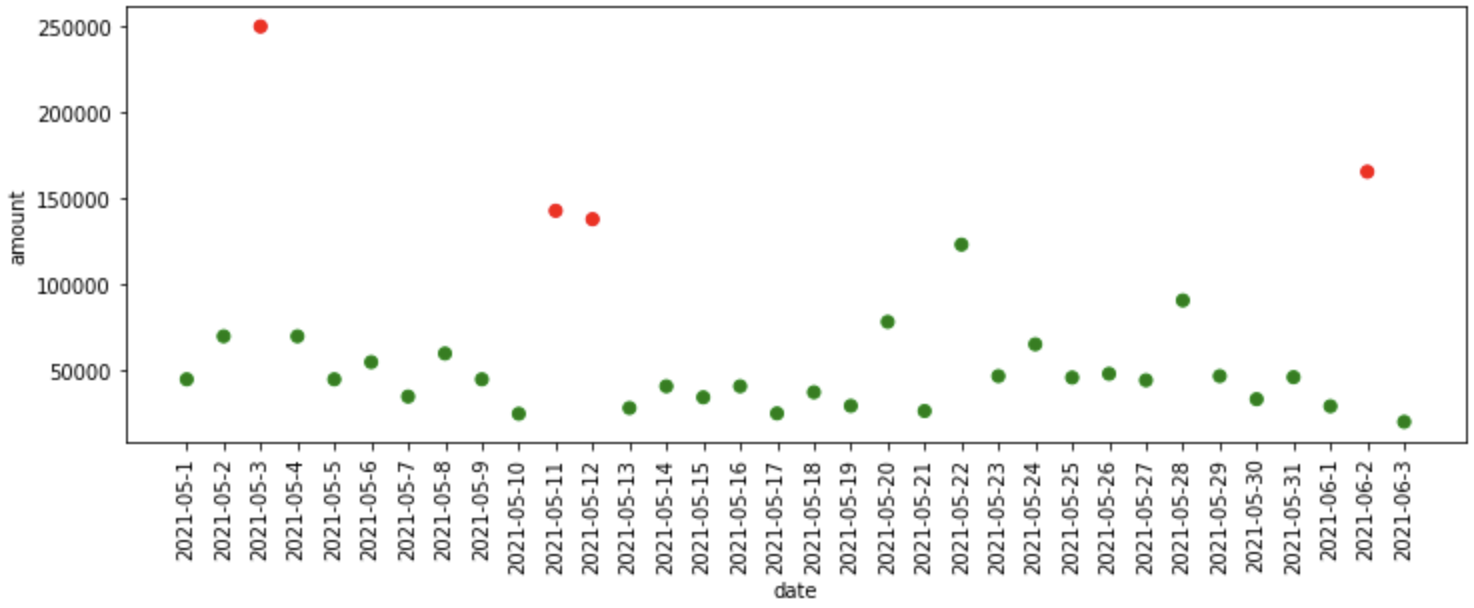
- Zuerst, Wir definieren das Median Absolute Deviation-Modell, das in der pyod-Bibliothek verfügbar ist, dann übergeben wir das modell, die Daten als Eingaben für die Funktion fit_model, wo es das Modell an die Daten anpasst und uns Vorhersagen liefert.
- Schließlich, wir zeichnen die vom MAD-Modell vorhergesagten Anomalien.
Algorithmus der nächsten Nachbarn K
Der K-Nearest Neighbor-Algorithmus erkennt Anomalien unter Verwendung der K-Nächstnachbar-Abstände als Anomalie-Scores. Die Idee ist, dass, wenn eine Beobachtung sehr weit von den anderen Beobachtungen entfernt ist, dann wird diese Beobachtung als Anomalie angesehen.
"""KNN-basierte Ausreißererkennung"""
knn_model = KNN()
knn_df = fit_model(knn_model, Daten)
plot_anomalien(knn_df)
Was ist im obigen Code passiert??
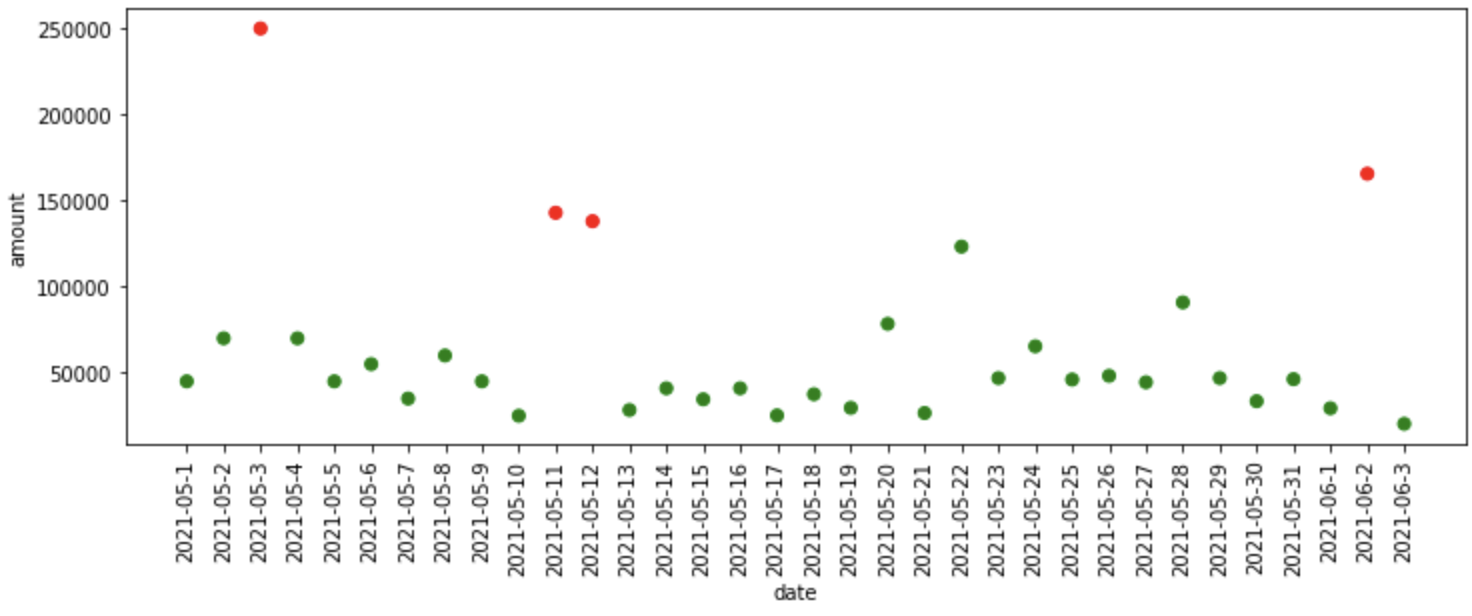
- Zuerst, wir definieren das nächste Nachbarmodell K, das in der pyod-Bibliothek verfügbar ist, dann übergeben wir das modell, die Daten als Eingaben für die Funktion fit_model, wo es das Modell an die Daten anpasst und uns Vorhersagen liefert.
- Schließlich, wir zeichnen die vom KNN-Modell vorhergesagten Anomalien.
In der PyOD-Bibliothek stehen viele Modelle zur Verfügung, wie zum Beispiel,
- CBLOF (Clusterbasierter lokaler Ausreißerfaktor)
- LOF (lokaler Ausreißerfaktor)
- HBOS (histogrammbasierte Ausreißererkennung)
- OCSVM (SVM einer Klasse)
Unterlassen Sie es nie, mit weiteren Algorithmen zu experimentieren, die in PyOD verfügbar sind.
Die praktischen Implementierungen der obigen Algorithmen sind im folgenden Notebook implementiert
Verweise
[1] PyOD, Python-Bibliothek zur Erkennung atypischer Werte
Vielen Dank!
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





