
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
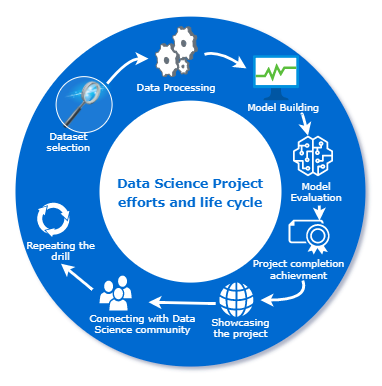
Schritte für Ihr erstes Data-Science-Projekt
In diesem Artikel, Sehen wir uns einige Tipps an, die Sie für den Einstieg in Ihre persönlichen Data Science-Projekte verwenden können..
1. Wählen Sie einen Datensatz
Wenn Sie das Data-Science-Projekt zum ersten Mal übernehmen, Wählen Sie einen Datensatz aus, der Sie interessiert. Kann mit Sport zusammenhängen, Filme oder Musik, alles was dich interessiert. Die am häufigsten verwendeten Websites, um die Daten zu erhalten, sind:
Für diejenigen, die bereits ein oder zwei Projekte gemacht haben, Ende zu Ende auf eigene Faust, Befolgen Sie die obigen Richtlinien, kann auf die Analyse eines komplexen Datensatzes aus einer bestimmten Domäne wie dem Einzelhandel abzielen, Finanzen oder Gesundheitswesen, um sich in Echtzeit ein Bild von Projekten zu machen.
um anzufangen, hatte eine Reihe von Krankenversicherungsdaten ausgewählt, um Predictive Analytics zu praktizieren. Ich habe den Datensatz von der Kaggle-Website gezogen
! pip install -q kaggle
#aus google.colab-Importdateien
#files.upload()
! mkdir ~/.kaggle
! cp kaggle.json ~/.kaggle/
! chmod 600 ~/.kaggle/kaggle.json
#! Kaggle-Datensätze herunterladen -d mirichoi0218/insurance
#! unzip Versicherung.zip -d Krankenversicherung
! Kaggle-Datensätze herunterladen -d mirichoi0218/insurance
! unzip Versicherung.zip -d Krankenversicherung
2. Wählen Sie eine IDE
Wählen Sie eine IDE aus, mit der Sie sich am wohlsten fühlen. Wenn Sie Python als Sprache verwenden, Hier sind einige Beispiele
- – Es ist eine IDE zum Schreiben von Python-Codes. Bietet verschiedene produktive Funktionen wie Routinepflege, Smart-Code-Vervollständigung, Fehlerprüfung und Codekorrektur. Vereinfacht die Projektpflege durch die Integration mit Versionskontrollfunktionen, unterstützt Webentwicklung und Data Science.
- Jupyter-Notizbuch – Es ist eine Open-Source-Webanwendung, mit der Sie Dokumente mit Live-Code erstellen und freigeben können, Gleichungen und Visualisierung. Hilft, die Arbeit zu rationalisieren und die Zusammenarbeit zu erleichtern
- Google Colab – Ermöglicht Benutzern das Schreiben und Ausführen von Python-Code. Es eignet sich sehr gut für Data Science- und Machine Learning-Projekte, da es Rechenressourcen kostenlos anbietet. Sie können hier problemlos umfangreiche Machine-Learning-Algorithmen ausführen, ohne sich um Infrastruktur oder Kosten kümmern zu müssen.
- Einfache Textdatei mit der Erweiterung .py: obwohl die oben genannten Optionen verfügbar und einfach zu verwenden sind, wenn Sie sich mit Notepad wohler fühlen, um Ihren Code zu schreiben, Sie können es verwenden und Ihre Datei mit der Erweiterung .py . speichern. Dann können Sie dasselbe mit einer Befehlszeile mit Syntax wie "python <> .py. Dadurch wird Ihr Programm ausgeführt, aber für Data-Science-Jobs, Das ist vielleicht nicht die beste Option, da Sie die Codeausgabe oder Visualisierungen nicht im laufenden Betrieb sehen können.
Ich habe Google Colab als Arbeitsumgebung ausgewählt.
3. Aktivitäten klar auflisten
Erstellen Sie eine Liste der Aktivitäten, die Sie im Datensatz ausführen möchten, damit Sie einen klaren Weg haben, bevor Sie beginnen. Häufige Aktivitäten, die wir in Data Science-Projekten durchführen, sind die Datenaufnahme, Datenreinigung, Datentransformation, explorative Datenanalyse, Modellbau, Modellbewertung und Modellimplementierung. Hier ist ein kurzer Überblick über all diese Schritte.
- Datenaufnahme – Es ist ein Prozess des Lesens der Daten in einem Datenrahmen.
###Panda-Paket erleichtert das Einlesen einer Datei in einen Datenrahmen

#Importieren der Bibliotheken
Pandas als pd importieren
import matplotlib.pyplot als plt
import seaborn als sns
aus matplotlib.cbook import boxplot_stats
importiere statsmodels.api als sm
aus sklearn.model_selection import train_test_split,GridSearchCV, cross_val_score, cross_val_predict
von statsmodels.stats.outliers_influence import variance_inflation_factor
aus sklearn.tree import DecisionTreeRegressor
von sklearn import ensemble
numpy als np importieren
Essiggurke importieren

#Daten lesen und zusammenfassen
health_ins_df = pd.read_csv("krankenversicherung/versicherung.csv")
health_ins_df.columns
health_ins_df.shape
health_ins_df.describe()
- Datenbereinigung – Es ist der Prozess der Identifizierung und Beseitigung von Anomalien im Datensatz.
- Datentransformation – Es beinhaltet das Ändern des Datentyps der Spalten, Erstellen Sie abgeleitete Spalten oder entfernen Sie doppelte Daten, um ein paar zu nennen.
- Explorative Datenanalyse – Führen Sie univariate und multivariate Analysen an Datensätzen durch, um darin verborgene Informationen und Muster zu finden.
Ich widmete mich an verschiedenen Tagen der Datenbereinigung und explorativen Datenanalyse numerischer und kategorialer Variablen, um mich auf die Details zu konzentrieren..
#Visualisierung der Altersspalte mit einem Histogramm
Feige,Achsen=plt.subplots(1,2,Feigengröße=(10,5))
sns.histplot( health_ins_df['age'] , Farbe="Himmelblau",Axt=Achsen[0])
sns.histplot( health_ins_df['bmi'] , Farbe="Olive",Axt=Achsen[1])
plt.zeigen()
#Alterskolonne mit einem Boxplot visualisieren
Feige,Achsen=plt.subplots(1,2,Feigengröße=(10,5))
sns.boxplot(x = 'age', data = health_ins_df, Axt=Achsen[0])
sns.boxplot(x = 'bmi', data = health_ins_df, Axt=Achsen[1])
plt.zeigen()
#Ermitteln der Ausreißerwerte in der bmi-Spalte
outlier_list = boxplot_stats(health_ins_df.bmi).Pop(0)['fliers'].auflisten()
drucken(ausreißerliste)
#Ermitteln der Anzahl der Zeilen mit Ausreißern
outlier_bmi_rows = health_ins_df[health_ins_df.bmi.isin(ausreißerliste)].Form[0]
drucken("Anzahl der Zeilen mit Ausreißern in bmi : ", outlier_bmi_rows)
#Prozentsatz der Zeilen, die Ausreißer sind
Prozent_bmi_outlier = (outlier_bmi_rows/health_ins_df.shape[0])*100
drucken("Prozentsatz der Ausreißer in bmi-Spalten : ", Prozent_bmi_outlier)
#Umrechnung des Alters in Altersklassen
drucken("Mindestwert für das Alter : ", health_ins_df['age'].Mindest(),"nMaximalwert für das Alter : ", health_ins_df['age'].max())
#Alter zwischen 18 zu 40 Jahre werden unter jung fallen
#Alter zwischen 41 zu 58 Jahre werden unter das mittlere Alter fallen
#Alter oben 58 Jahre werden unter das Alter fallen
health_ins_df.loc[(health_ins_df['age'] >=18) & (health_ins_df['age'] <= 40), 'age_group'] = 'young'
health_ins_df.loc[(health_ins_df['age'] >= 41) & (health_ins_df['age'] <= 58), 'age_group'] = 'mid-age'
health_ins_df.loc[health_ins_df['age'] > 58, 'age_group'] = 'old'

fig,Achsen=plt.subplots(1,5,Feigengröße=(20,8))
sns.countplot(x = 'sex', data = health_ins_df_clean, Palette="Magma",Axt=Achsen[0])
sns.countplot(x = 'children', data = health_ins_df_clean, Palette="Magma",Axt=Achsen[1])
sns.countplot(x = 'smoker', data = health_ins_df_clean, Palette="Magma",Axt=Achsen[2])
sns.countplot(x = 'region', data = health_ins_df_clean, Palette="Magma",Axt=Achsen[3])
sns.countplot(x = 'age_group', data = health_ins_df_clean, Palette="Magma",Axt=Achsen[4])
Heatmap = sns.heatmap(health_ins_df_clean.corr(), vmin=-1, vmax=1, annot=Wahr)
sns.relplot(x="bmi", y ="Gebühren",Farbton="Sex", Stil = "Sex", data=health_ins_df_clean);
sns.boxplot(x="Raucher", y ="Gebühren", data=health_ins_df_clean)
- Bau des Modells – Testen und testen Sie alle möglichen Modelle im Datensatz, bevor Sie das richtige Modell basierend auf geschäftlichen Einschränkungen auswählen / Techniken. Während dieser Phase, Sie können auch einige Einsack- oder Verstärkungstechniken ausprobieren.
Ich habe zuerst ein Basismodell entwickelt, bevor Sie erweiterte Modelle für den Datensatz testen
#Datenvorverarbeitung
#Umwandeln von kategorialen Werten in Dummies mit der One-Hot-Codierungstechnik
health_ins_df_processed = pd.get_dummies(health_ins_df_clean, Spalten=['Geschlecht','Kinder','Raucher','Region','age_group'], Präfix=['Geschlecht','Kinder','Raucher','Region','age_group'])
health_ins_df_processed.drop(['age'],Achse = 1,inplace=True)
#Erstellen eines linearen Regressionsmodells
X = health_ins_df_processed.loc[:, health_ins_df_processed.columns != 'charges']
y = health_ins_df_processed['charges']
X_Zug, X_test, y_train, y_test = train_test_split(x, Ja, test_size=0.33)
X = sm.add_constant(x) # eine Konstante hinzufügen
Modell = sm.OLS(Ja, x).fit()
Vorhersagen = model.predict(x)
print_model = model.summary()
drucken(print_model)
#Endgültiges Modell nach Eliminierung der Variablen mit geringster Signifikanz und hoher vif
X = health_ins_df_processed[['bmi','children_0', 'smoker_yes',  'region_southeast', 'region_southwest', 'age_group_old', 'age_group_young']]
y = health_ins_df_processed['charges']
X_Zug, X_test, y_train, y_test = train_test_split(x, Ja, test_size=0.33)
X = sm.add_constant(x) # eine Konstante hinzufügen
Modell = sm.OLS(Ja, x).fit()
Vorhersagen = model.predict(x)
print_model = model.summary()
drucken(print_model)
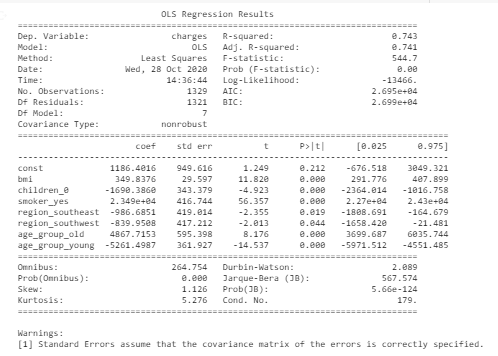
- Modellbewertung – In dieser Phase, Wir testen, ob unser Modell gut genug ist, um ein erwartetes Ergebnis zu erhalten. Wir messen Präzision, Spezifität, Empfindlichkeit oder angepasstes R-Quadrat gemäß dem von uns verwendeten Modell
Dies ist die endgültige Bewertungsmetrik des Basismodells, die a . zeigt 74% Präzision und 7 signifikante Variablen (p-Wert <Signifikanzwert)
4. Erledige Aufgaben einzeln
In diesem Stadium, Sie sollten eine Vorstellung davon haben, welche Aktivitäten Sie in Ihrem Projekt durchführen können. Du kannst sie einzeln nehmen. Nicht unbedingt, Du musst alles an einem Tag erledigen. Es kann bis zu dauern 1 Tag Zeit, um zu entscheiden, an welchem Datensatz Sie arbeiten möchten und in welcher Umgebung Sie sich wohl fühlen.
Kann den Tag widmen 2 Daten verstehen und Datenbereinigungsaktivitäten durchführen. Auf die gleiche Weise, Sie können Ihr Projekt in einer Zeitspanne von 7-8 Tage.
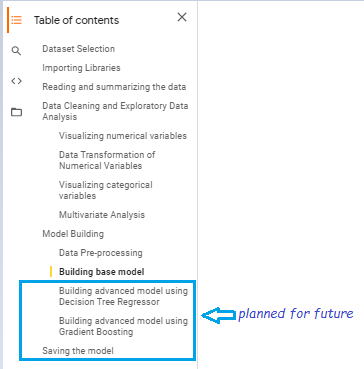
Ich habe dieses Projekt in einer Zeitspanne von abgeschlossen 4 Tage. Ich habe geplant, einige fortschrittlichere Modelle zu testen, um die Vorhersageleistung zu verbessern
5. Bereiten Sie eine Zusammenfassung vor
Ich werde eine kurze Zusammenfassung erstellen, nachdem dieses Projekt abgeschlossen ist.
6. Teilen Sie es auf Open-Source-Plattformen
Wählen Sie eine Open-Source-Plattform, auf der Sie die Projektbeschreibung oder die Codes veröffentlichen möchten, damit Sie in der Data-Science-Community sichtbar werden und sich mit anderen Enthusiasten vernetzen können. GitHub wird heutzutage häufiger verwendet. Es gibt nur wenige Websites wie Kaggle, Google Colab Inline-Kernel anbieten, damit Sie Code schreiben und ausführen können, ohne sich um die Infrastruktur kümmern zu müssen. Sie können diese Plattformen auch nutzen.
Der Quellcode ist in meinem . verfügbar GitHub Rechnung
Die Vorteile der schrittweisen Übernahme von Projekten
1. Es besteht kein Druck, das Projekt an einem Tag abzuschließen.
2. Sie können sich an einem Tag nur auf eine bestimmte Aufgabe konzentrieren und diese effizient erledigen.
3. Es wird Sie an Aufgaben festhalten, bis Sie fertig sind
4. Die Projektzusammenfassung kann in Zukunft bei der Vorbereitung auf Vorstellungsgespräche oder bei ähnlichen Projekten herangezogen werden..
5. Sie können dieses Projekt nutzen, um sich mit anderen Data Science-Enthusiasten zu vernetzen und kreative Ideen auszutauschen..
Ich habe gelernt, dass wir beim Lernen einen disziplinierten Ansatz verfolgen und unsere Zeit in Projekte investieren müssen. Wir alle erfahren mehr, Dinge praktisch machen. Als letztes, Es ist harte Arbeit und Ausdauer, die Sie auf den Weg führen wird, von dem Sie immer geträumt haben.





