
Überblick
- Comprender la arquitectura de Apache BienenstockHive ist eine dezentrale Social-Media-Plattform, die es ihren Nutzern ermöglicht, Inhalte zu teilen und sich mit anderen zu verbinden, ohne dass eine zentrale Behörde eingreifen muss. Verwendet die Blockchain-Technologie, um die Datensicherheit und das Eigentum zu gewährleisten. Im Gegensatz zu anderen sozialen Netzwerken, Hive ermöglicht es Nutzern, ihre Inhalte durch Krypto-Belohnungen zu monetarisieren, die die Schaffung und den aktiven Austausch von Informationen fördert.... y su funcionamiento.
- Wir werden lernen, einige grundlegende Operationen in Apache Hive auszuführen.
Einführung
Die meisten Data Scientists verwenden SQL-Abfragen, um die Daten zu untersuchen und Erkenntnisse daraus zu gewinnen.. Jetzt, da das Datenvolumen so schnell wächst, wir brauchen neue dedizierte Tools, um große Datenmengen zu verarbeiten.
Anfänglich, Hadoop entstand und wurde zu einem der beliebtesten Tools für die Verarbeitung und Speicherung von Big Data. Aber Entwickler mussten komplexen Code zur Kartenreduktion schreiben, um mit Hadoop zu arbeiten. Dies ist Facebooks Apache Hive, zu dessen Rettung er gekommen ist. Es ist ein weiteres Tool, das für die Arbeit mit Hadoop entwickelt wurde. Wir können SQL-ähnliche Abfragen im Hive schreiben und im Backend wandelt es sie in Map-Reduction-Jobs um.
In diesem Artikel, Wir werden die Architektur des Bienenstocks und seinen Betrieb sehen. También aprenderemos cómo realizar operaciones simples como crear una DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten.... y una tabla, lade Daten, die Tabelle ändern.
Inhaltsverzeichnis
- Was ist Apache Hive??
- Arquitectura Apache Hive
- Apache Hive-Job
- Datentypen in Apache Hive
- Datenbank erstellen und löschen
- Tabelle erstellen und löschen
- Daten in Tabelle laden
- Tabelle ändern
- Vorteil / Nachteile von Hive
Was ist Apache Hive??
Apache Hive ist ein von Facebook entwickeltes Datenspeichersystem zur Verarbeitung einer großen Menge an Strukturdaten in Hadoop. Wir wissen, dass die Verarbeitung der Daten mit Hadoop, wir müssen komplexe Kartenreduktionsfunktionen reparieren, was für die meisten Entwickler keine leichte Aufgabe ist. Hive macht uns diese Arbeit sehr leicht.
Es verwendet eine Skriptsprache namens HiveQL, die SQL fast ähnlich ist. Dann, wir müssen nur SQL-ähnliche Befehle schreiben und im Hive-Backend werden sie automatisch in Map-Reduction-Jobs umgewandelt.
Arquitectura Apache Hive
Schauen wir uns das folgende Diagramm an, das die Architektur zeigt.
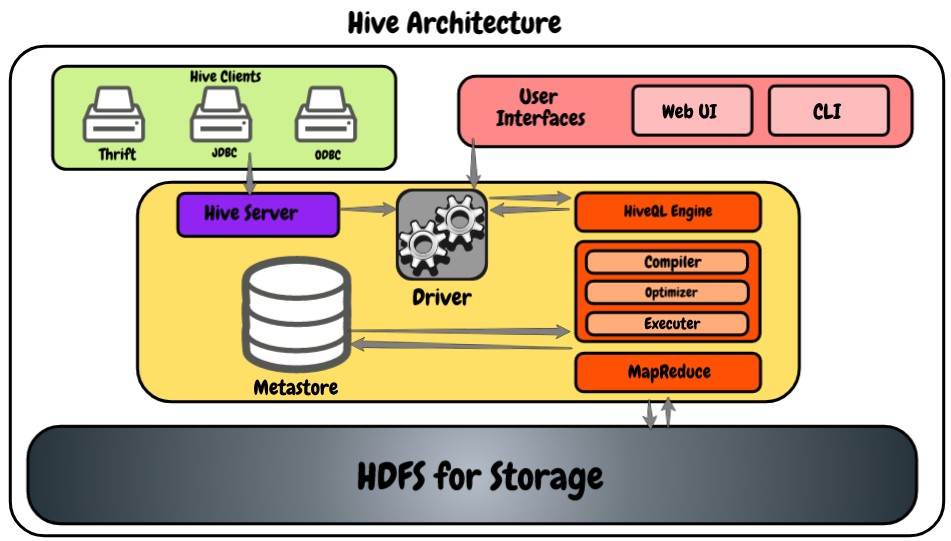
- Hive-Kunden: Es ermöglicht uns, Hive-Anwendungen mit verschiedenen Arten von Clients zu schreiben, als rettender Server, der JDBC-Treiber für Java- und Hive-Anwendungen, und es ist auch mit Anwendungen kompatibel, die das ODBC-Protokoll verwenden.
- Bienenstockdienste: Als ein Entwickler, wenn wir Daten verarbeiten wollen, wir müssen hive-Dienste wie hive CLI . verwenden (Befehlszeilenschnittstelle). Abgesehen von diesem Bienenstock, bietet auch eine webbasierte Schnittstelle zum Ausführen der Hive-Anwendungen.
- Bienenstockfahrer: Es ist in der Lage, Anfragen von mehreren Ressourcen wie thrift . zu empfangen, JDBC und ODBS mit Hive-Server und direkt über die Hive-CLI und die webbasierte Benutzeroberfläche. Nach Erhalt von Anfragen, überträgt sie an den Compiler.
- HiveQL-Engine: Empfängt die Abfrage vom Compiler und konvertiert die SQL-ähnliche Abfrage in Map-Reduction-Jobs.
- Meta-Shop: Hier speichert Hive die Metainformationen zu den Datenbanken als Tabellenschema, die Datentypen der Spalten, la ubicación en el HDFSHDFS, o Verteiltes Hadoop-Dateisystem, Es ist eine Schlüsselinfrastruktur für die Speicherung großer Datenmengen. Entwickelt für die Ausführung auf gängiger Hardware, HDFS ermöglicht die Datenverteilung über mehrere Knoten, Sicherstellung einer hohen Verfügbarkeit und Fehlertoleranz. Seine Architektur basiert auf einem Master-Slave-Modell, wobei ein Master-Knoten das System verwaltet und Slave-Knoten die Daten speichern, Erleichterung der effizienten Verarbeitung von Informationen.., etc.
- HDFS: Es simplemente el Verteiltes DateisystemEin verteiltes Dateisystem (DFS) Ermöglicht die Speicherung und den Zugriff auf Daten auf mehreren Servern, Erleichterung der Verwaltung großer Informationsmengen. Diese Art von System verbessert die Verfügbarkeit und Redundanz, da Dateien an verschiedene Speicherorte repliziert werden, Reduzierung des Risikos von Datenverlusten. Was ist mehr, Ermöglicht Benutzern den Zugriff auf Dateien von verschiedenen Plattformen und Geräten aus, die Zusammenarbeit zu fördern und... de Hadoop que se utiliza para almacenar los datos. Ich empfehle Ihnen dringend, diesen Artikel zu lesen, um mehr über HDFS zu erfahren: Einführung in das Hadoop-Ökosystem
Apache Hive-Job
Jetzt, Sehen wir uns an, wie Hive im Hadoop-Framework funktioniert.
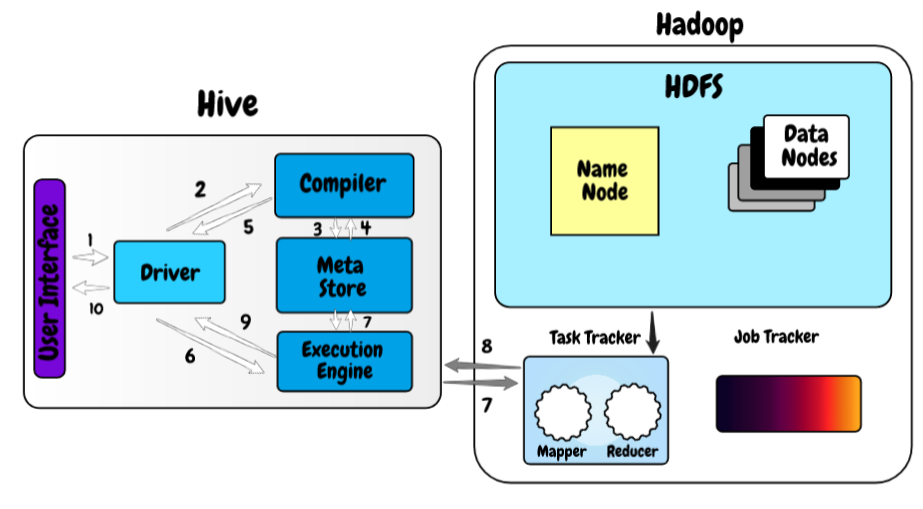
- Im ersten Schritt, Wir schreiben die Abfrage über das Webinterface oder die Kommandozeilenschnittstelle des Bienenstocks. Sendet es an den Controller, um die Abfrage auszuführen.
- Im nächsten Schritt, der Controller sendet die empfangene Anfrage an den Compiler, wo der Compiler die Syntax überprüft.
- Und wenn die Syntaxprüfung abgeschlossen ist, Metadaten vom Meta-Store anfordern.
- Jetzt, Metadaten liefern Informationen wie die Datenbank, Bretter, Spaltendatentypen als Antwort auf eine Compiler-Abfrage.
- Der Compiler prüft erneut alle vom Metaspeicher empfangenen Anforderungen und sendet den Ausführungsplan an die Steuerung.
- Jetzt, der Controller sendet den Ausführungsplan an die HiveQL-Prozess-Engine, wobei die Engine die Abfrage in den Map-Reduction-Job umwandelt.
- Sobald die Abfrage zum Kartenreduktionsjob wird, sendet die Aufgabeninformationen an Hadoop, wo die Abfrageverarbeitung beginnt und, zur selben Zeit, aktualisiert Metadaten zum Kartenreduktionsjob im Metaspeicher.
- Sobald die Verarbeitung abgeschlossen ist, die Laufzeit empfängt die Abfrageergebnisse.
- Die Runtime überträgt die Ergebnisse an die Steuerung und, Schließlich, sendet sie an die Hive-Benutzeroberfläche, von der aus wir die Ergebnisse sehen können.
Datentypen in Apache Hive
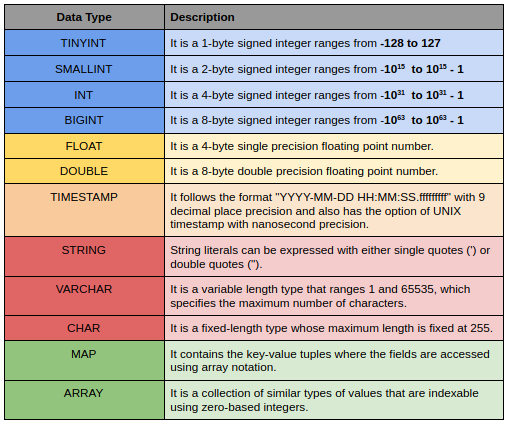
Hive-Datentypen sind in folgende unterteilt: 5 verschiedene Kategorien:
- numerischer Typ: TINYINT, SMALLINT, INT, BIGINT
- Datumstypen / Zeit: STUNDE, DATUM, BRECHEN
- Arten von Saiten: STRING, VARCHAR, VERKOHLEN
- Komplexe Typen: STRUKTUR, KARTE, UNION, ARRAY
- Verschiedene Typen: BOOLEO, SPUREN
Hier ist eine kleine Beschreibung von einigen von ihnen.
Datenbank erstellen und löschen
Das Erstellen und Löschen einer Datenbank ist sehr einfach und ähnelt SQL. Wir müssen jeder der Hive-Datenbanken einen eindeutigen Namen zuweisen. Wenn die Datenbank bereits existiert, wird eine Warnung anzeigen und um diese Warnung zu unterdrücken, können Sie die Schlüsselwörter hinzufügen WENN ES NICHT EXISTIERT nach dem Datenbank-Schlüsselwort.
DATENBANK ERSTELLEN <<Name der Datenbank>> ;
Auch das Löschen einer Datenbank ist ganz einfach, du musst nur a schreiben Datenbank und Datenbankname löschen verlassen sein. Wenn Sie versuchen, die nicht vorhandene Datenbank zu löschen, gibt Ihnen den SemanticException-Fehler.
DATENBANK VERLIEREN <<Name der Datenbank>> ;
Tabelle erstellen
Wir verwenden die create table-Anweisung, um eine Tabelle zu erstellen, und die vollständige Syntax lautet wie folgt.
TABELLE ERSTELLEN, WENN NICHT EXISTIERT <<Name der Datenbank.>><<Tabellenname>>
                           (column_name_1 data_type_1,
                            Spaltenname_2 Datentyp_2,
                            .
                            .
                            column_name_n data_type_n)
                            ROW FORMAT DELIMITED FIELDS
                            TERMINATED BY 't'
                            LINES TERMINATED BY 'n'
                            STORED AS TEXTFILE;
Wenn Sie die Datenbank bereits verwenden, du musst nicht schreiben database_name.table_name. Dann, Sie können nur den Tabellennamen eingeben. Im Fall von Big Data, Meistens importieren wir die Daten aus externen Dateien, damit wir hier das in der Datei verwendete Trennzeichen vordefinieren können, Zeilenabschluss und wir können auch definieren, wie wir die Tabelle speichern wollen.
Es gibt 2 verschiedene Arten von Bienenstockbrettern Interne und externe Bretter. In diesem Artikel erfahren Sie mehr über das Konzept: Tabellentypen in Apache Hive: ein schneller Überblick
Daten in Tabelle laden
Jetzt, die Tabellen sind erstellt. Zeit, die Daten hineinzuladen. Wir können die Daten aus jeder lokalen Datei auf unserem System mit der folgenden Syntax laden.
DATEN LADEN LOKALER EINGANG <<Pfad der Datei auf Ihrem lokalen System>>
                       IN TABELLEN
                       <<Name der Datenbank.>><<Tabellenname>> ;
Wenn wir mit großen Datenmengen arbeiten, Es besteht die Möglichkeit, dass in einigen Zeilen nicht übereinstimmende Datentypen vorhanden sind. Dann, der Bienenstock wirft keine Fehler aus, stattdessen werden stattdessen Nullwerte ausgefüllt. Dies ist eine sehr nützliche Funktion, da das Hochladen von Big-Data-Dateien in den Bienenstock ein teurer Prozess ist und wir nicht den gesamten Datensatz hochladen möchten, nur weil wir nur wenige Dateien haben.
Tabelle ändern
Im Bienenstock, Wir können verschiedene Änderungen an bestehenden Tabellen vornehmen, wie man Tabellen umbenennt, füge der Tabelle weitere Spalten hinzu. Die Befehle zum Ändern der Tabelle sind den SQL-Befehlen sehr ähnlich.
Hier ist die Syntax zum Umbenennen der Tabelle:
ALTER TABLE <<Tabellenname>> UMBENENNEN IN <<neuer Name>> ;
Syntax zum Hinzufügen weiterer Tabellenspalten:
## um weitere Spalten hinzuzufügen
ALTER TABLE <<Tabellenname>> SÄULEN HINZUFÜGEN
                           (new_column_name_1 data_type_1,
                            new_column_name_2 data_type_2,
                            .
                            .
                            new_column_name_n data_type_n) ;
Vorteil / Nachteile von Apache Hive
- Verwendet SQL als Abfragesprache, die den meisten Entwicklern bereits vertraut ist, so ist es einfach zu bedienen.
- Es ist hoch skalierbar, Sie können damit jede Datengröße verarbeiten.
- Unterstützt mehrere Datenbanken wie MySQL, Derby, Postgres und Oracle für Ihren Metadatenspeicher.
- Unterstützt mehrere Datenformate und ermöglicht auch die Indizierung, Partition und Gruppe zur Optimierung von Abfragen.
- Es kann nur kalte Daten verarbeiten und ist nutzlos, wenn es um Echtzeit-Datenverarbeitung geht.
- Es ist vergleichsweise langsamer als einige seiner Konkurrenten. Wenn es in Ihrem Anwendungsfall hauptsächlich um die Stapelverarbeitung geht, Bienenstock ist in Ordnung.
Abschließende Anmerkungen
In diesem Artikel, Wir haben die Apache Hive-Architektur und ihre Funktionsweise sowie einige der grundlegenden Operationen gesehen, um loszulegen. Im nächsten Artikel dieser Serie, veremos algunos de los conceptos más complejos e importantes de partición y GruppierungDas "Gruppierung" Es handelt sich um ein Konzept, das sich auf die Organisation von Elementen oder Individuen in Gruppen mit gemeinsamen Merkmalen oder Zielen bezieht. Dieses Verfahren wird in verschiedenen Disziplinen eingesetzt, einschließlich Psychologie, Pädagogik und Biologie, um die Analyse und das Verständnis von Verhaltensweisen oder Phänomenen zu erleichtern. Im Bildungsbereich, zum Beispiel, Gruppenbildung kann die Interaktion und das Lernen unter den Schülern verbessern, indem sie die Arbeit fördert.. en una colmena.
Bei Fragen zu diesem Artikel, lass es mich im Kommentarbereich unten wissen.





