
Einführung
Ordnungsstatistik ist ein sehr nützliches Konzept in der Statistikwissenschaft. Sie haben ein breites Anwendungsspektrum, einschließlich Auktionsmodellierung, Autorennen und Versicherungen, Optimierung der Produktionsprozesse, Schätzung von ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... von Verteilungen, et al. Durch diesen Artikel, wir werden die Idee der Bestellstatistik verstehen. Wir werden zuerst seine Bedeutung verstehen und nach und nach mit seiner Verbreitung fortfahren., schließlich fortgeschrittene Konzepte abdecken.
Angenommen, wir haben eine Menge von Zufallsvariablen X1, x2, …, xNorden, die unabhängig und gleich verteilt sind (iid). Für Unabhängigkeit, wir meinen, dass der Wert, den eine VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... zufällige Variable annimmt, nicht von den Werten anderer Zufallsvariablen beeinflusst wird. Durch identische Verteilung, wir meinen, dass die Wahrscheinlichkeitsdichtefunktion (PDF) (oder gleichwertig, die kumulative Verteilungsfunktion, CDF) für Zufallsvariablen ist es dasselbe. Das KNS Die Ordnungsstatistik für diesen Satz von Zufallsvariablen ist definiert als kNS kleinster Abtastwert.
Um dieses Konzept besser zu verstehen, wir werden nehmen 5 Zufallsvariablen X1, x2, x3, x4, x5. Wir werden eine Erkenntnis beobachten / Zufallsergebnis der Verteilung jeder dieser Zufallsvariablen. Angenommen, wir erhalten die folgenden Werte:
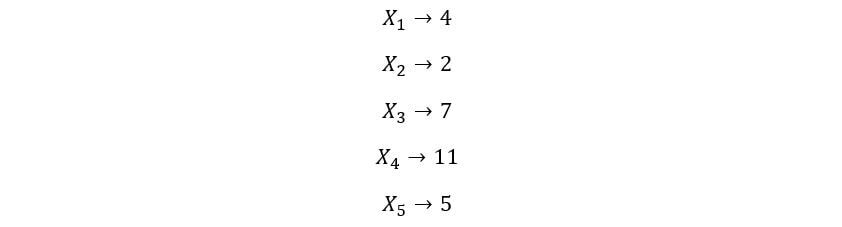
Das KNS die Ordnungsstatistik für dieses Experiment ist kNS kleinster Wert der Menge {4, 2, 7, 11, 5}. Dann, das 1NS die Bestellstatistik ist 2 (kleinster Wert), das 2Norddakota die Bestellstatistik ist 4 (die nächstkleinere), usw. Das 5NS die Ordnungsstatistik ist der fünftkleinste Wert (der größte Wert), Was ist es 11. Wir wiederholen diesen Vorgang viele Male, nämlich, wir extrahieren Stichproben aus der Verteilung jeder dieser iid-Zufallsvariablen und finden die kNS kleinster Wert für jeden Satz von Beobachtungen. Die Wahrscheinlichkeitsverteilung dieser Werte ergibt die Verteilung von kNS Bestellstatistik.
Allgemein, wenn wir Zufallsvariablen X . ordnen1, x2, …, xNorden in aufsteigender Reihenfolge, dann die kNS die Bestellstatistik wird angezeigt als:
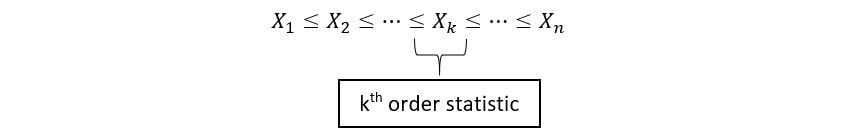
Die allgemeine Schreibweise des kNS die Bestellstatistik ist X(k). Hinweis X(k) ist verschieden von Xk. xk ist der kNS Zufallsvariable unserer Menge, während X(k) ist der kNS statistische Ordnung unseres Sets. x(k) nimmt den Wert von X . ank ja Xk ist der kNS Zufallsvariable bei aufsteigender Sortierung der Realisierungen.
Das 1NS Statistik der Ordnung X(1) ist die Menge der Minimalwerte der Realisierung der Menge von ‚n‘ zufällige Variablen. SpäterNS Statistik der Ordnung X(Norden) ist die Menge der Maximalwerte (n-te Mindestwerte) der Realisierung der Menge von ‚n‘ zufällige Variablen. Sie können ausgedrückt werden als:
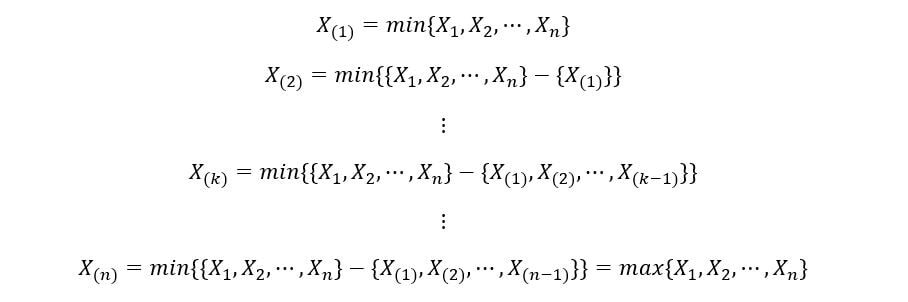
Verteilung der Bestellstatistiken
Jetzt werden wir versuchen die Verteilung der Bestellstatistiken herauszufinden. Wir beschreiben zunächst die Verteilung von nNS Bestellstatistik, dann er 1NS statistische Ordnung und schließlich die kNS allgemeine Bestellstatistik.
EIN) Verteilung von nNS Bestellstatistik:
Sei die Wahrscheinlichkeitsdichtefunktion (PDF) und die kumulative Verteilungsfunktion (CDF) unsere Zufallsvariablen lassen fx(x) y Fx(x) beziehungsweise. Nach Definition von CDF,
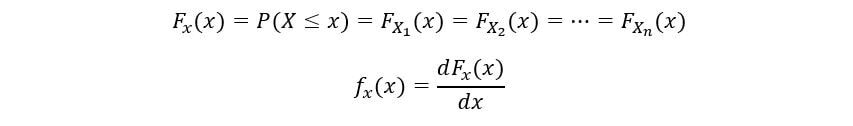
Da unsere Zufallsvariablen identisch verteilt sind, habe das gleiche PDF fx(x) y CDF Fx(x). Nun berechnen wir die CDF von nNS Bestellstatistik (FNorden(x)) wie folgt:
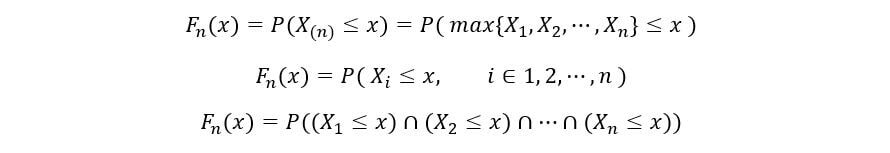
Zufallsvariablen X1, x2, …, xNorden sie sind auch unabhängig. Deswegen, nach Eigentum der Unabhängigkeit,
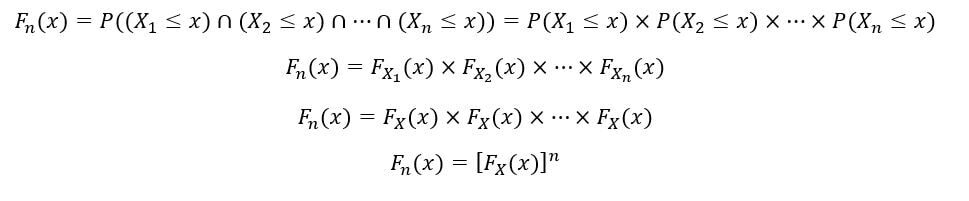
Das PDF der nNS statistische Ordnung (FNorden(x)) berechnet sich wie folgt:
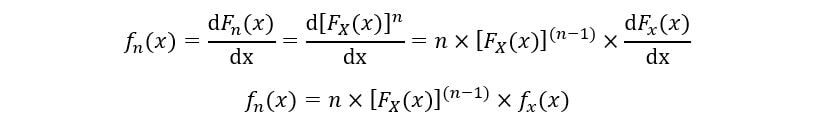
Deswegen, der Ausdruck für PDF und CDF von nNS Die Bestellstatistik wurde abgerufen.
B) Verteilung von 1NS Bestellstatistik:
Der CDF einer Zufallsvariablen kann auch als Eins minus der Wahrscheinlichkeit berechnet werden, dass die Zufallsvariable X einen Wert größer oder gleich x . annimmt. Mathematisch,
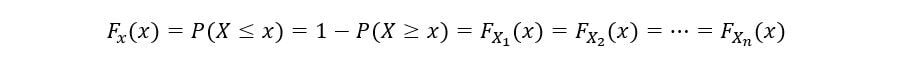
Wir bestimmen den CDF von 1NS Bestellstatistik (F1(x)) wie folgt:
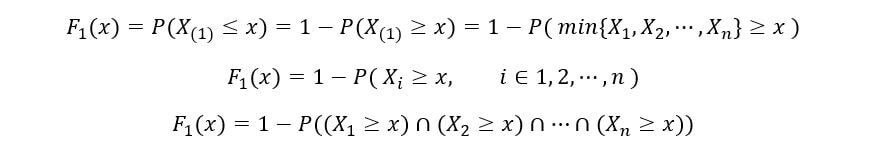
Ein Mal noch, unter Verwendung der Unabhängigkeitseigenschaft von Zufallsvariablen,
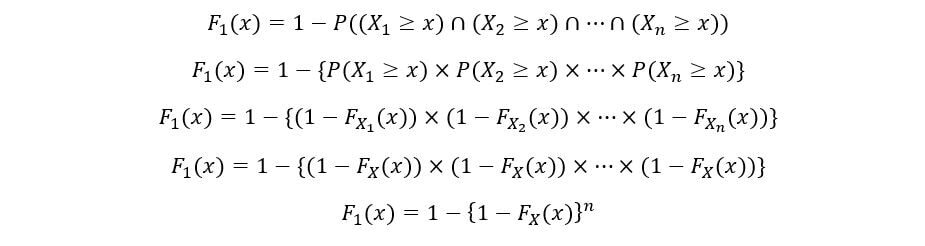
Das PDF der 1NS statistische Ordnung (F1(x)) berechnet sich wie folgt:
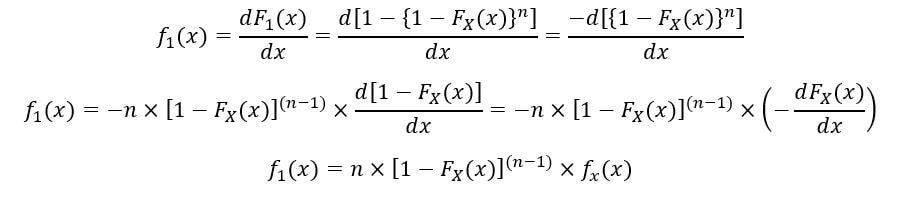
Deswegen, der Ausdruck für PDF und CDF von 1NS Die Bestellstatistik wurde abgerufen.
C) Verteilung des kNS Bestellstatistik:
GabelNS Bestellstatistik, allgemein, die folgende Gleichung beschreibt Ihre CDF (Fk(x)):
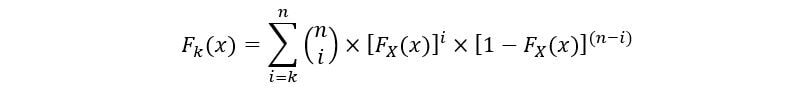
Das PDF von kNS statistische Ordnung (Fk(x)) wird ausgedrückt als:
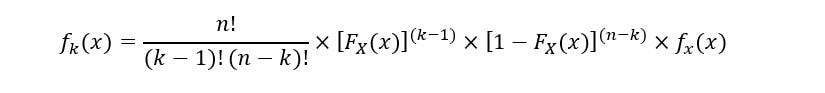
Um Verwechslungen vorzubeugen, Wir werden geometrische Beweise verwenden, um die Gleichung zu verstehen. Wie oben besprochen, der Satz der Zufallsvariablen hat das gleiche PDF (Fx(x)). Die folgende Grafik zeigt ein Beispiel-PDF mit dem kNS Bestellstatistik aus Zufallsstichproben:
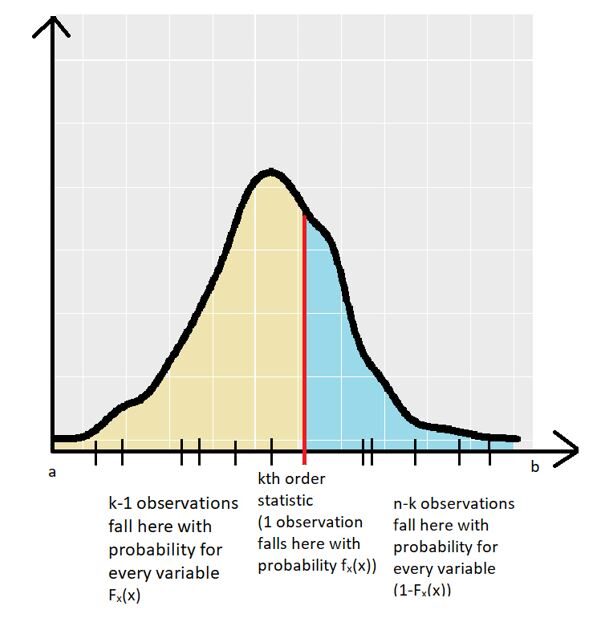
Dann, das PDF der Zufallsvariablen fx(x) ist definiert zwischen dem Intervall [ein,B]. Die Statistik k-ter Ordnung für eine Zufallsstichprobe wird mit der roten Linie dargestellt. Die anderen variablen Realisierungen (für die Zufallsstichprobe) dargestellt durch die kleinen schwarzen Linien auf der x-Achse.
Es gibt genau (k – 1) Beobachtungen von Zufallsvariablen, die in den gelben Bereich des Graphen fallen (die Region dazwischen & kNS Bestellstatistik). Die Wahrscheinlichkeit, dass eine bestimmte Beobachtung in diesen Bereich fällt, ergibt sich aus der CDF der Zufallsvariablen (Fx(x)). Aber das ist uns bewusst (k – 1) Beobachtungen fielen in der Region, was gibt uns den Begriff (für die Unabhängigkeit) (Fx(x))(k – 1).
Es gibt genau (n – k) Beobachtungen von Zufallsvariablen, die in den blauen Bereich des Diagramms fallen (die Region zwischen kNS statistische Ordnung & B). Die Wahrscheinlichkeit, dass eine bestimmte Beobachtung in diesen Bereich fällt, ist gegeben durch 1 – CDF der Zufallsvariablen (1- Fx(x)). Aber das ist uns bewusst (n – k) Beobachtungen fielen in der Region, was gibt uns den Begriff (für die Unabhängigkeit) (1-Fx(x))(n – k).
Schließlich, Exakt 1 Beobachtung fällt genau auf die Statistik k-ter Ordnung mit Wahrscheinlichkeit fx(x). Deswegen, das Produkt von 3 Begriffe gibt uns eine Vorstellung von der geometrischen Bedeutung der Gleichung für PDF der Statistik k-ter Ordnung. Aber, Woher kommt der Fakultätsterm? Das obige Szenario zeigte nur eine der vielen Bestellungen. Es kann viele dieser Kombinationen geben. Die Gesamtzahl dieser Kombinationen ist unten aufgeführt:
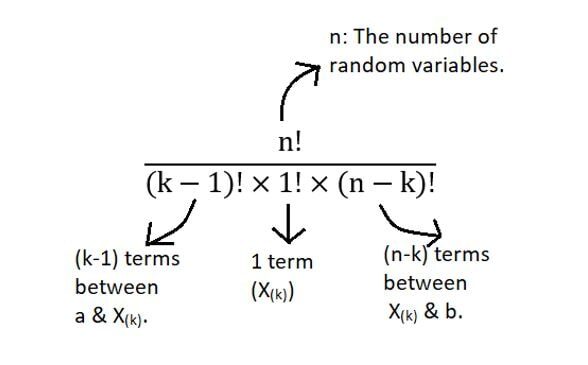
Deswegen, das Produkt all dieser Terme gibt uns die allgemeine Verteilung von kNS Bestellstatistik.
Nützliche Funktionen der Bestellstatistik
Auftragsstatistiken führen zu mehreren nützlichen Funktionen. Unter ihnen, zu den bemerkenswerten gehören die Spannweite der Stichprobe und die MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird.... der Stichprobe.
1) Probenbereich: Es ist definiert als die Differenz zwischen dem größten und kleinsten Wert. Es wird wie folgt ausgedrückt:
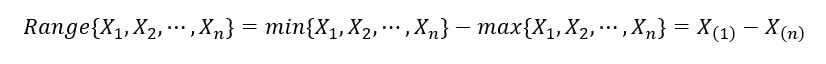
2) Probenmedian: Der Stichprobenmedian teilt die Zufallsstichprobe (Realisierungen der Menge der Zufallsvariablen) in zwei Hälften, einer mit den niedrigstwertigen Samples und der andere mit den höchstwertigen Samples. Es ist wie die Statistik mittlerer Ordnung / zentral. Es ist mathematisch definiert als:
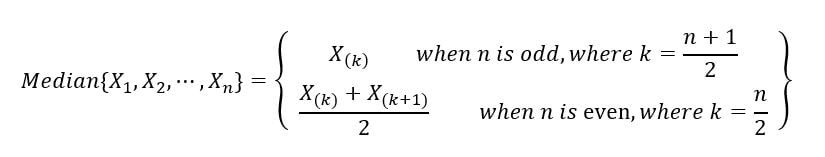
Bestellstatistik-Set PDF
Eine gemeinsame Wahrscheinlichkeitsdichtefunktion kann uns helfen, die Beziehung zwischen zwei Zufallsvariablen besser zu verstehen (Statistik zweier Ordnung
in unserem Fall). Das eingestellte PDF für alle Statistiken von 2 X Bestellungen(ein) & x(B), so dass 1 ≤ a ≤ b ≤ n ergibt sich aus der folgenden Gleichung:
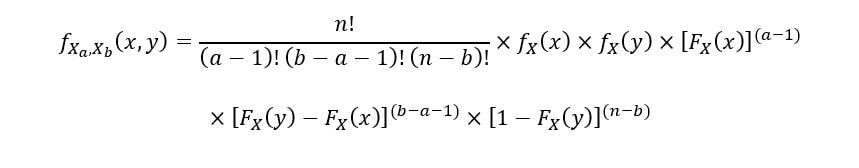
Beispiel
Anhand eines ganz einfachen Beispiels wollen wir die Verteilung der Bestellstatistik verdeutlichen: die Standard-Gleichverteilung (U[0, 1] Verteilung). Wir werden nehmen 5 Zufallsvariablen X1, x2, x3, x4, x5, jeder hat das U[0, 1] Verteilung. Für diesen Satz von Zufallsvariablen, wir berechnen und zeichnen die 1NS, 3rd (der Stichprobenmedian) Ja 5NS (NordenNS) Bestellstatistik. La siguiente Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... zeigt die U[0, 1] Verteilung:
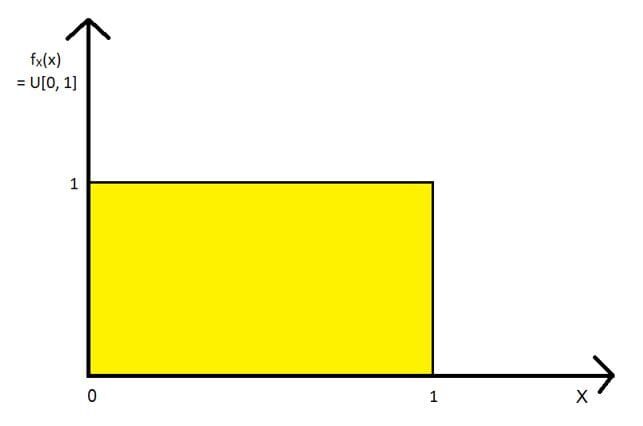
Wir ziehen wie folgt Stichproben und finden die 1NS, 3rd & 5NS Bestellstatistik für jede Probe. Unten sind zwei der Beispiele:
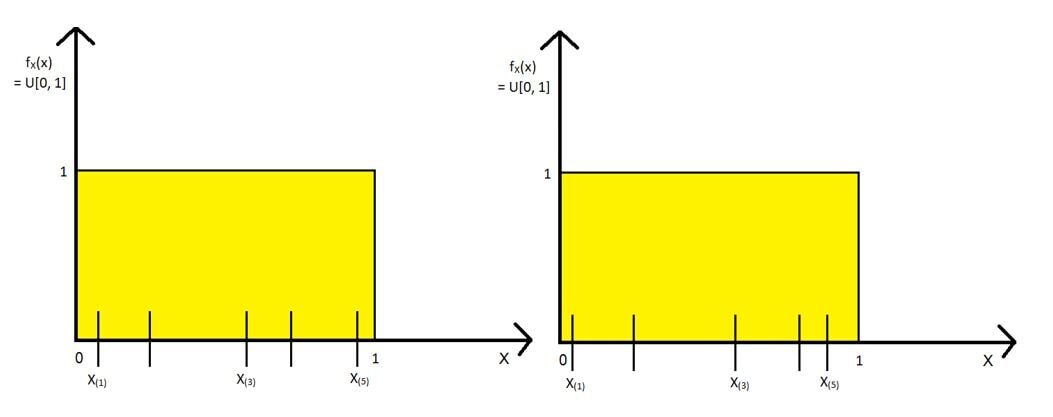
Die Standard-Uniform Distribution PDF und CDF werden als:
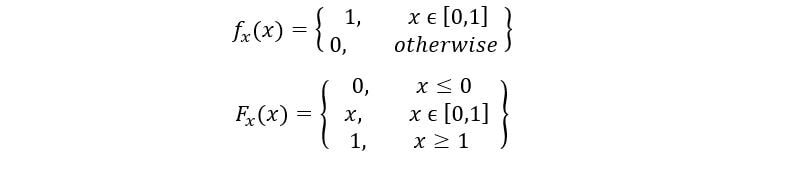
Wir verwenden diese Informationen und berechnen X(1), x(3) & x(5) mit den von uns abgeleiteten Formeln. Wir nehmen den Fall nur, wenn x zwischen liegt 0 Ja 1 (für andere Fälle, die Bestellstatistik ist null, da PDF null ist).
EIN) Zu 1NS Bestellstatistik:
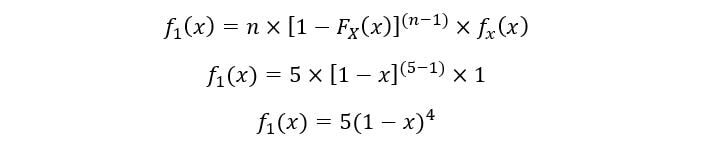
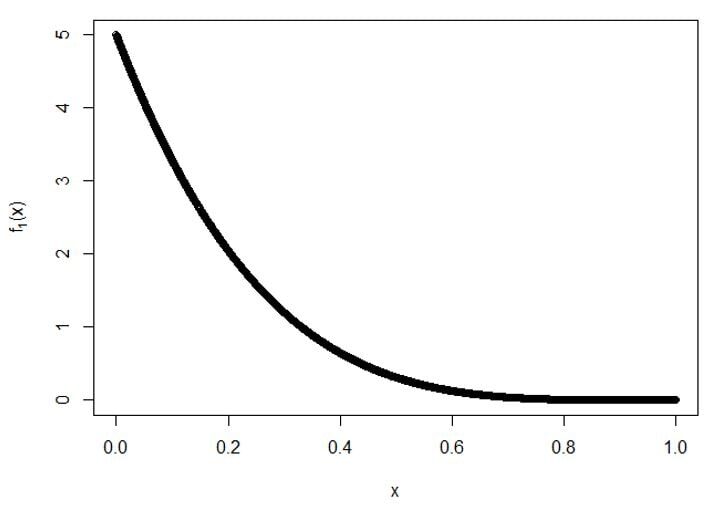
Grundstück für f1(x):
B) Zu 3rd Bestellstatistik:
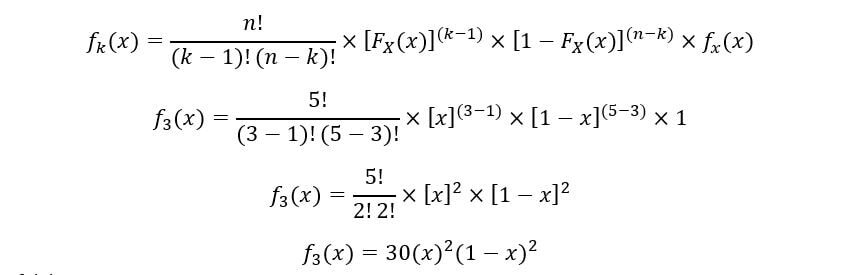
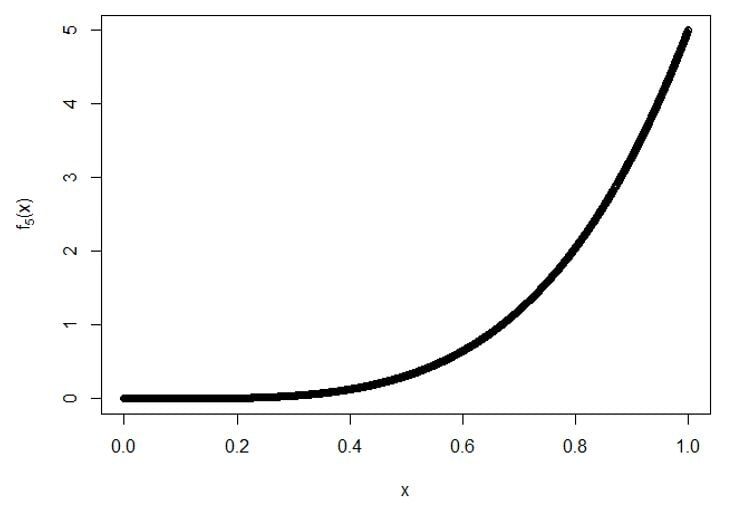
Grundstück für f5(x):
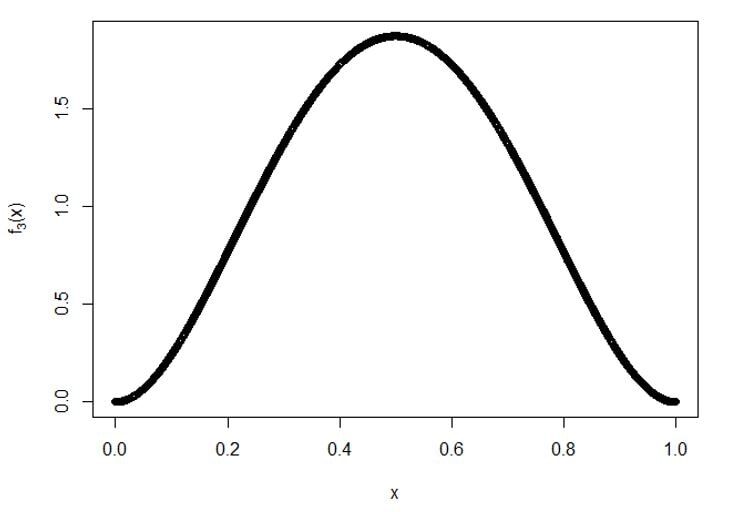
C) Zu 5NS Bestellstatistik:
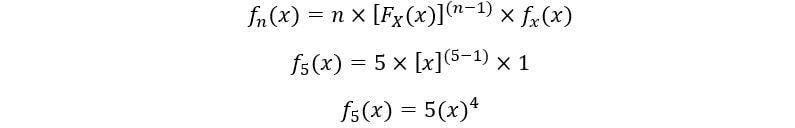
Grundstück für f5(x):
Fazit
Deswegen, Wir haben uns eingehend mit den Konzepten der Auftragsstatistik befasst. Durch Ordnungsstatistiken können verschiedenste physikalische Prozesse modelliert werden, seine Eigenschaften ausnutzen, insbesondere deren Verteilungen.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





