
Kleine Karte ist ein Programmiermodell große Datensätze parallel verarbeiten, verteilt Algorithmus in einem Cluster (Quelle: Wikipedia). Map Reduce kann in Kombination mit HDFS zur Verarbeitung von Big Data verwendet werden. Die Grundprinzipien dieses HDFS-MapReduce-Systems, was allgemein als Hadoop bekannt ist, wurden in unserem vorherigen Beitrag besprochen.
Die grundlegende Informationseinheit, die verwendet wird in Karte verkleinernMapReduce ist ein Programmiermodell, das entwickelt wurde, um große Datensätze effizient zu verarbeiten und zu generieren. Unterstützt von Google, Bei diesem Ansatz wird die Arbeit in kleinere Aufgaben aufgeteilt, die auf mehrere Knoten in einem Cluster verteilt sind. Jeder Knoten verarbeitet seinen Teil und dann werden die Ergebnisse kombiniert. Mit dieser Methode können Sie Anwendungen skalieren und große Informationsmengen verarbeiten, in der Welt von Big Data von grundlegender Bedeutung zu sein.... ist ein Paar (Schlüssel, Wert). Alle strukturierten und unstrukturierten Datentypen müssen in diese Grundeinheit übersetzt werden, bevor Sie die Daten in das MapReduce-Modell einspeisen. Wie der Name schon sagt, das MapReduce-Modell besteht aus zwei separaten Routinen, nämlich, Kartenfunktion und Verkleinerungsfunktion. Dieser Beitrag wird Ihnen helfen, die Schritt-für-Schritt-Funktionalität des Map-Reduce-Modells zu verstehen. Einen Eintrag berechnen (Mit anderen Worten, in einer Reihe von Paaren) im MapReduce-Modell tritt es in drei Stufen auf:
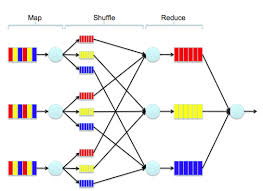
Paso 1: die Kartenbühne
Paso 2: die zufällige Spielphase
Paso 3: die Abstiegsphase.
Semantisch, die Map- und Shuffle-Phasen verteilen die Daten, und die Abnahmestufe führt die Berechnung durch. In diesem Beitrag werden wir jede dieser Phasen im Detail analysieren.
[stextbox id="Abschnitt"] Die Kartenbühne [/stextbox]
MapReduce-Logik, im Gegensatz zu anderen Datenrahmen, nicht auf strukturierte Datensätze beschränkt. Es hat auch eine große Kapazität, um unstrukturierte Daten zu verarbeiten. Die Kartenphase ist der kritische Schritt, der es machbar macht. KartographMapper ist ein Werkzeug, das die Visualisierung und Analyse geospatialer Daten erleichtert. Es ermöglicht den Benutzern, interaktive und anpassbare Karten zu erstellen, und dabei unterschiedliche Informationen wie Demografie, Infrastrukturen und natürliche Ressourcen zu integrieren. Seine Nutzung erstreckt sich auf Bereiche wie Stadtplanung, Umweltforschung und Ressourcenmanagement, und trägt zu fundierten Entscheidungen und nachhaltiger Entwicklung bei. Mapper ist zu einer unverzichtbaren Lösung geworden in.... verleiht den unstrukturierten Daten eine Struktur. Als Beispiel, wenn ich die Anzahl der Bilder auf meinem Laptop nach Standort zählen möchte (Stadt), wo wurde das foto gemacht, Ich muss unstrukturierte Daten analysieren. Der Allokator erstellt Paare (Schlüssel, Wert) aus diesem Datensatz. Für diesen Fall, der Schlüssel ist der Ort und der Wert ist das Foto. Sobald der Auftraggeber mit seinen Hausaufgaben fertig ist, wir haben eine Struktur für den gesamten Datensatz.
In der Kartenphase, der Allokator nimmt ein einzelnes Paar (Schlüssel, Wert) als Input und erzeugt beliebig viele Paare (Schlüssel, Wert) als Ausweg. Es ist wichtig, sich die Kartenoperation als zustandslos vorzustellen, Mit anderen Worten, Ihre Logik arbeitet nur auf einem Paar gleichzeitig (auch wenn in der Praxis mehrere Eingangspaare an denselben Allocator gesendet werden). Um zusammenzufassen, für Kartenbühne, der Benutzer entwirft einfach eine Kartenfunktion, die ein Eingabepaar zuweist (Schlüssel, Wert) zu einer beliebigen Zahl (einschließlich keiner) Ausgangspaare. Meistens, die Map-Bühne wird einfach verwendet, um die gewünschte Position des Eingabewerts durch Ändern seines Schlüssels anzugeben.
[stextbox id="Abschnitt"] Die Mischphase [/stextbox]
Die Shuffle-Phase wird automatisch vom MapReduce-Framework gehandhabt, Mit anderen Worten, Der Ingenieur hat zu diesem Zeitpunkt nichts zu tun. Das zugrunde liegende System, das MapReduce implementiert, leitet alle Werte, die einem einzelnen Schlüssel zugeordnet sind, an denselben Reduzierer.
[stextbox id="Abschnitt"] Die Reduzieren-Phase [/stextbox]
In der Abstiegsphase, Der Reducer nimmt alle Werte, die einem einzigen Schlüssel k zugeordnet sind, und generiert eine beliebige Anzahl von Paaren (Schlüssel, Wert). Dies unterstreicht einen der sequentiellen Aspekte der MapReduce-Berechnung: alle Karten müssen fertig gestellt sein, bevor die Niedergangsphase beginnen kann. Da der Reduzierer mit dem gleichen Schlüssel auf alle Werte zugreifen kann, kann mit diesen Werten sequentielle Berechnungen durchführen. Im abnehmenden Schritt, Parallelität wird ausgenutzt, indem man beobachtet, dass Reduzierer, die auf verschiedenen Schlüsseln arbeiten, gleichzeitig ausgeführt werden können. Um zusammenzufassen, für die Abstiegsphase, der Benutzer entwirft eine Funktion, die als Eingabe eine Liste von Werten verwendet, die einem einzelnen Schlüssel zugeordnet sind, und eine beliebige Anzahl von Paaren generiert. Häufig, die Exit-Tasten eines Reducers sind die gleichen wie die Enter-Taste (in Wirklichkeit, auf dem original MapReduce-Papier, die Exit-Taste sollte gleich der Eingabetaste, aber Hadoop hat diese Einschränkung gelockert).
Allgemein, ein Programm im MapReduce-Paradigma kann aus vielen Runden bestehen (ruft generell an funktioniert) verschiedener Karten- und Abnahmefunktionen, sequentiell nacheinander gemacht.
[stextbox id="Abschnitt"] Ein Beispiel [/stextbox]
Betrachten wir ein Beispiel, um Map-Reduce im Detail zu verstehen. Wir haben folgendes 3 Sätze:
1. Der flinke braune Fuchs
2. Der Fuchs hat die Maus gefressen
3. Wie jetzt braune Kuh
Unser Ziel ist es, die Häufigkeit jedes Wortes in allen Sätzen zu zählen. Stellen Sie sich vor, dass jeder dieser Sätze eine große Menge an Gedächtnis erwirbt und, deshalb, werden verschiedenen Datenknoten zugeordnet. Mapper kümmert sich um diese unstrukturierten Daten und erstellt Schlüssel-Wert-Paare. Für diesen Fall, der Schlüssel ist das Wort und der Wert ist die Anzahl dieses Wortes im verfügbaren Text in diesem KnotenNodo ist eine digitale Plattform, die die Verbindung zwischen Fachleuten und Unternehmen auf der Suche nach Talenten erleichtert. Durch ein intuitives System, Ermöglicht Benutzern das Erstellen von Profilen, Erfahrungen austauschen und Zugang zu Stellenangeboten erhalten. Der Fokus auf Zusammenarbeit und Networking macht Nodo zu einem wertvollen Werkzeug für diejenigen, die ihr berufliches Netzwerk erweitern und Projekte finden möchten, die mit ihren Fähigkeiten und Zielen übereinstimmen.... von Dateien. Als Beispiel, der 1. Map-Knoten generiert 4 Schlüssel-Wert-Paare: (das, 1), (Braun, 1), (Fuchs, 1), (schnell, 1). Der erste 3 Schlüssel-Wert-Paare gehen an den ersten Reducer und der letzte Schlüsselwert an den zweiten Reducer.
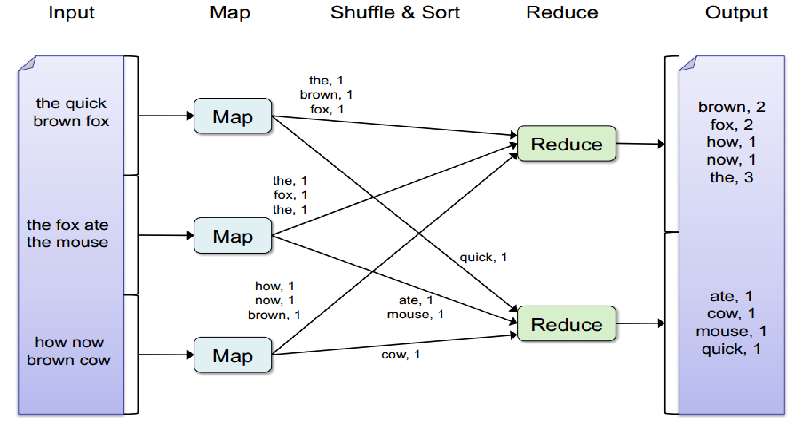
Ähnlich, Kartenfunktionen 2 Ja 3 mach die Karte der anderen beiden Sätze. Beim Mischen, alle ähnlichen Wörter haben das gleiche Ende. Sobald die Schlüssel-Wert-Paare sortiert sind, die Reduzierfunktion verarbeitet diese strukturierten Daten, um eine Zusammenfassung zu erstellen.
[stextbox id="Abschnitt"] Abschließende Anmerkungen: [/stextbox]
Nehmen wir ein Beispiel für den Einsatz der Map-Reduce-Funktion in der Industrie:
• In der Google-Suchmaschine:
– Erstellen von Indizes für die Google-Suche
– Gruppieren von Beiträgen für Google News
– Statistische maschinelle Übersetzung
• De Yahoo !:
– Erstellen von Indizes für Yahoo! Suche
– Spam-Erkennung für Yahoo! E-Mail
• Auf Facebook:
– Datenverarbeitung
– Anzeigenoptimierung
– Beispiel zur Spam-Erkennung
• Bei Amazon:
– Produktgruppierung
– Statistische maschinelle Übersetzung
Die Einschränkung bei der Verwendung der Map-Reduce-Funktion besteht darin, dass der Benutzer einem logischen Format folgen muss. Diese Logik besteht darin, Schlüssel-Wert-Paare mithilfe der Map-Funktion zu generieren und dann mithilfe der Reduce-Funktion zusammenzufassen.. Aber, Glücklicherweise, die meisten Datenmanipulationsvorgänge können in diesem Format getäuscht werden. Im nächsten Beitrag werden wir einige Beispiele nehmen, z. B. wie man eine Datensatzzusammenführung durchführt, Matrix-Multiplikation, Matrix transponieren, etc. usando Map-Reduce.
War der Beitrag hilfreich? Teilen Sie uns weitere praktische Beispiele der Map-Reduce-Funktion mit. Teilen Sie uns Ihre Meinung zu diesem Beitrag in der Box unten mit..





