
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung:
Wie wir alle wissen, Künstliche Intelligenz ist in unserer Umgebung weit verbreitet: vom Lesen der Nachrichten auf Ihrem Mobilgerät oder der Analyse komplexer Daten an Ihrem Arbeitsplatz, KI hat die Geschwindigkeit verbessert, Präzision und Effektivität menschlicher Bemühungen. Fortschritte in der KI haben uns geholfen, Dinge zu erreichen, von denen wir vorher dachten, dass sie nicht möglich wären. Sogar eine Pizza aus Ihrem Lieblingsrestaurant zu Hause ist nur einen Klick entfernt, dank AI.
In einer Nussschale, Künstliche Intelligenz bezeichnet einen Computer oder ein Computerprogramm, das die menschliche Intelligenz nachahmt. Es wird erreicht, indem man lernt, wie man denkt, lernen, entscheidet und bearbeitet das menschliche Gehirn, während es ein Problem löst. Die Ergebnisse dieser Studie dienen dann als Grundlage für die Entwicklung intelligenter Systeme und Software..
Es gibt 4 Arten des Lernens:
● Überwachtes LernenÜberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem ein Modell mit einem Satz von beschrifteten Daten trainiert wird. Jede Eingabe im Dataset ist mit einer bekannten Ausgabe verknüpft, So kann das Modell lernen, Ergebnisse für neue Eingaben vorherzusagen. Diese Methode wird häufig in Anwendungen wie der Bildklassifizierung eingesetzt., Spracherkennung und Trendvorhersage, und unterstreicht seine Bedeutung in....
● Unbeaufsichtigtes Lernen.
● Teilüberwachtes Lernen.
● Verstärktes Lernen.
| Beaufsichtigt | Unbeaufsichtigt | Teilüberwacht | Verstärkt |
| Beim überwachten Lernen wird das Modell mit einem gekennzeichneten Datensatz trainiert. | Das Unüberwachtes LernenUnüberwachtes Lernen ist eine Technik des maschinellen Lernens, die es Modellen ermöglicht, Muster und Strukturen in Daten ohne vordefinierte Beschriftungen zu identifizieren. Durch Algorithmen wie k-means und Hauptkomponentenanalyse, Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, wie z. B. Kundensegmentierung, Anomalieerkennung und Datenkomprimierung. Seine Fähigkeit, verborgene Informationen preiszugeben, macht es zu einem wertvollen Werkzeug in der... ist, wenn das Modell mit einem unbeschrifteten Dataset trainiert wird, Es liegt am Algorithmus, die zugrunde liegenden Muster in den Daten zu finden. | Es liegt zwischen überwachtem und unüberwachtem Lernen, in diesem, einige Lerndaten sind beschriftet und andere nicht. | Der Algorithmus bewertet seine Leistung anhand von Feedback-Antworten und reagiert entsprechend. |
Dieser Blog behandelt überwachtes und unüberwachtes KI-Lernen, Verwenden von Python- und Iris-Datensätzen.
Inhaltsverzeichnis:
- Einführung
- Iris-Datensatz
- Überwachtes Lernen
- Entscheidungsbaum
- Logistische Regression
- Unbeaufsichtigtes Lernen
- Gruppierung von K-Strümpfen
- Fazit und Referenzen
Iris-Datensatz:
Der Datensatz enthält 3 Klassen mit 50 Instanzen jeweils und 150 Gesamtinstanzen, wobei sich jede Klasse auf eine Art von Irispflanze bezieht.
Klasse: Seidige Iris, Iris Versicolour, Iris Virginica
Das Datenformat: (Kelchblattlänge, Kelchbreite, Blütenblattlänge, Blütenblattbreite)
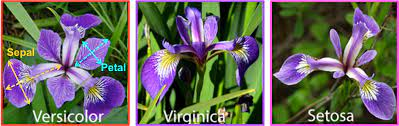
Basierend auf diesen werden wir unsere Modelle trainieren ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... Und wir werden sie verwenden, um die Arten von Blumen vorherzusagen.
Die Daten verstehen:
Laden Sie den Iris-Datensatz herunter von https://www.kaggle.com/uciml/iris
numpy als np importieren
Pandas als pd importieren
import matplotlib.pyplot als plt
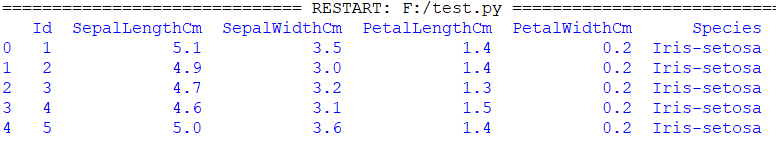
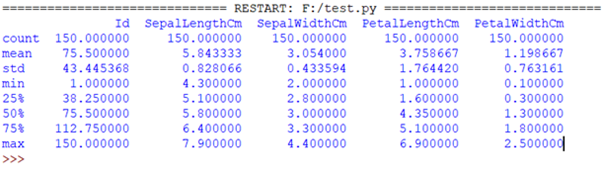
iris = pd.read_csv("Iris.csv") #Iris.csv ist jetzt ein Pandas-Datenrahmen
drucken(iris.kopf()) #druckt zuerst 5 Werte
drucken(iris.describe()) #druckt einige grundlegende statistische Details wie Perzentil,bedeuten, std usw. des Datenrahmens |
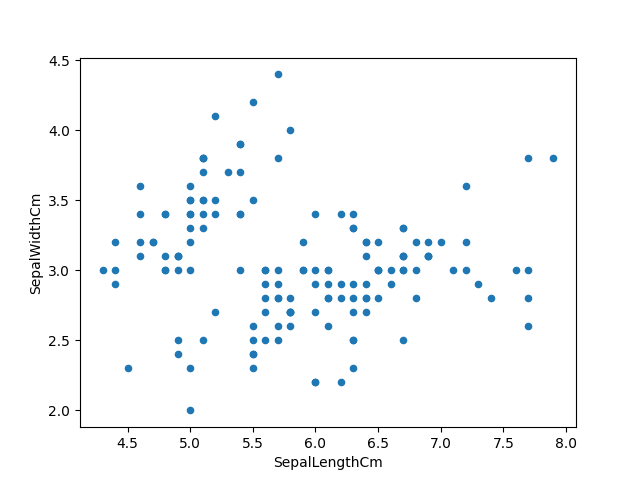
Visualisierung der Daten mit matplotlib:
iris.plot(Art="streuen", x="KelchlängeCm", y ="KelchblattBreiteCm") plt.zeigen() |
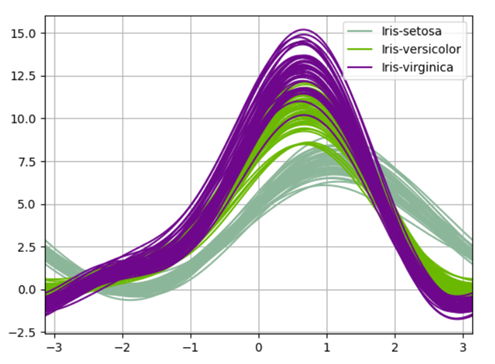
Datenvisualisierung mit Andrews Kurven von Pandas:
Andrews-Kurven haben die funktionale Form:
F
x_4 ohne (2T) + x_5 cos (2T) +…
Dabei entsprechen die Koeffizienten x den Werten jedes Abmessungen"Dimension" Es handelt sich um einen Begriff, der in verschiedenen Disziplinen verwendet wird, wie z.B. Physik, Mathematik und Philosophie. Er bezieht sich auf das Ausmaß, in dem ein Objekt oder Phänomen analysiert oder beschrieben werden kann. In der Physik, zum Beispiel, Es ist die Rede von räumlichen und zeitlichen Dimensionen, während es sich in der Mathematik auf die Anzahl der Koordinaten beziehen kann, die notwendig sind, um einen Raum darzustellen. Es zu verstehen, ist grundlegend für das Studium und... y t hat einen linearen Abstand zwischen -pi und + Pi. Jede Reihe des Rahmens entspricht einer einzelnen Kurve.
aus pandas.plotting import andrews_curves
andrews_curves(iris.tropfen("Ausweis", Achse=1), "Spezies")
plt.zeigen()
|
Datensatzvorverarbeitung:
Verwenden einer integrierten Bibliothek namens ‚train_test_split‘, das teilt unseren Datensatz in einen Anteil von 80:20. Das 80% wird verwendet, um AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen...., Bewertung und Auswahl zwischen unseren Modellen und den 20% wird als Validierungsdatensatz aufbewahrt.
aus sklearn.model_selection import train_test_split x = iris.iloc[:, :-1].Werte #letzte Spalte Werte ausgeschlossen y = iris.iloc[:, -1].Werte #letzter Spaltenwert aus sklearn.model_selection import train_test_split x_train,x_test,y_train,y_test = train_test_split(x,Ja,test_size=0.2,random_state=0) #Aufteilen des Datensatzes in den Trainingssatz und den Testsatz |
Überwachtes Lernen :
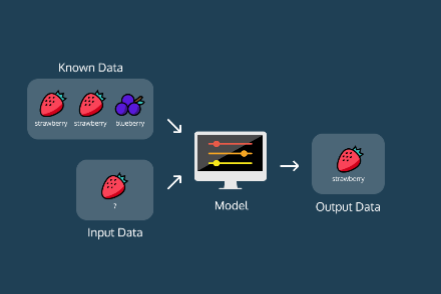
Überwachte maschinelle Lernalgorithmen werden trainiert, um Muster anhand eines Datensatzes zu finden. Der Vorgang ist einfach, nimmt das in der Vergangenheit Gelernte und wendet es dann auf neue Daten an. Beim überwachten Lernen werden beschriftete Beispiele verwendet, um zukünftige Muster und Ereignisse vorherzusagen.
Zum Beispiel, wenn wir einem Kind das beibringen 2 + 2 = 4 oder wir weisen auf das Bild eines Tieres hin, damit Sie seinen Namen kennen.
Das betreute Lernen ist wiederum unterteilt in:
● Einstufung: Klassifizierung sagt kategoriale Klassenbezeichnungen voraus, die sind diskret und chaotisch. Es ist ein zweistufiger Prozess, bestehend aus einem Lernschritt und einem Klassifikationsschritt. Es gibt verschiedene Klassifizierungsalgorithmen wie: „Entscheidungsbaum-Klassifikator“, „Zufälliger Wald“, „Naive Bayes-Klassifikator“, etc.
● Rückschritt: Regression wird im Allgemeinen als die Bestimmung einer Beziehung zwischen zwei oder mehr Variablen beschrieben, wie man die Arbeit einer Person basierend auf Eingabedaten vorhersagt X. Einige der Regressionsalgorithmen sind: „Logistische Regression“, „Schleifenregression“, „Ridge-Regression“, etc. .
Entscheidungsbaum-Klassifikator:
Der allgemeine Grund für die Verwendung eines Entscheidungsbaums besteht darin, ein Trainingsmodell zu erstellen, das verwendet werden kann, um die Klasse oder den Wert der Zielvariablen vorherzusagen, indem aus früheren Daten abgeleitete Entscheidungsregeln gelernt werden. (Trainingsdaten).
Versuchen Sie das Problem mithilfe der Baumdarstellung zu lösen. Jeden KnotenNodo ist eine digitale Plattform, die die Verbindung zwischen Fachleuten und Unternehmen auf der Suche nach Talenten erleichtert. Durch ein intuitives System, Ermöglicht Benutzern das Erstellen von Profilen, Erfahrungen austauschen und Zugang zu Stellenangeboten erhalten. Der Fokus auf Zusammenarbeit und Networking macht Nodo zu einem wertvollen Werkzeug für diejenigen, die ihr berufliches Netzwerk erweitern und Projekte finden möchten, die mit ihren Fähigkeiten und Zielen übereinstimmen.... Der innere Knoten des Baums entspricht einem Attribut, und jeder Blattknoten entspricht einer Klassenbezeichnung.
Verwenden des Entscheidungsbaums im Iris-Dataset:
aus sklearn.tree import DecisionTreeClassifier
von sklearn.metrics import precision_score
Klassifikator = DecisionTreeClassifier() Klassifikator.fit(x_train, y_train) #den Klassifikator trainieren y_pred = classifier.predict(x_test) #Vorhersagen treffen drucken(Klassifizierungsbericht(y_test, y_pred)) #Zusammenfassung der Vorhersagen des Klassifikators drucken(Verwirrung Matrix(y_test, y_pred)) #um die Qualität der Ausgabe zu bewerten drucken(Genauigkeit ist,Genauigkeit_Score(y_pred,y_test)) #Genauigkeitsbewertung |
Präzision: Genauigkeit positiver Vorhersagen.
Erholung: Anteil der Positiven, die richtig identifiziert wurden.
F1-Ergebnis: Wie viel Prozent der positiven Vorhersagen waren richtig??
Makrodurchschnitt – Durchschnittlicher ungewichteter Mittelwert pro Etikett
gewichteter Durchschnitt: Durchschnitt des gewichteten Durchschnitts der Unterstützung pro Etikett
Heatmapein "Heatmap" ist eine grafische Darstellung, die Farben verwendet, um die Dichte von Daten in einem bestimmten Bereich anzuzeigen. Häufig in der Datenanalyse verwendet, Marketing und Verhaltensstudien, Diese Art der Visualisierung ermöglicht es Ihnen, Muster und Trends schnell zu erkennen. Durch chromatische Variationen, Heatmaps erleichtern die Interpretation großer Informationsmengen, dabei helfen, fundierte Entscheidungen zu treffen.... für die Verwirrungsmatrix:
Seegeboren als sns importieren cm = Verwirrung_matrix(y_test, y_pred) #In df umwandeln cm_df = pd.DataFrame(cm,Index = [Setosa,Versicolor,Virginica], Spalten = [Setosa,Versicolor,Virginica]) plt.figur(Feigengröße=(5.5,4)) sns.heatmap(cm_df, annot=Wahr) plt.ylabel(Wahrer Wert) plt.xlabel(Vorhergesagtes Etikett) plt.zeigen() |
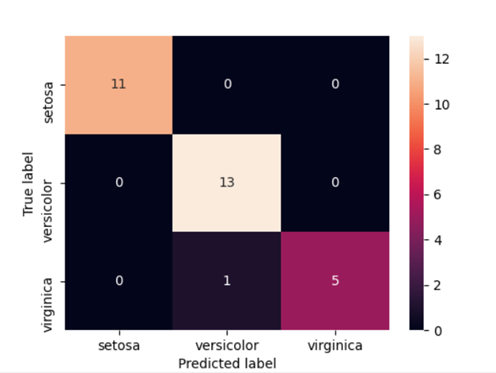
Eine Idee, die wir der Matrix entnehmen können, ist, dass das Modell bei der Klassifizierung von Setosa und Virginica sehr genau war (Richtig positiv / Alle = 1.0). Aber trotzdem, Die Genauigkeit von Versicolor war geringer (13/14 = 0,928).
Unbeaufsichtigtes Lernen:
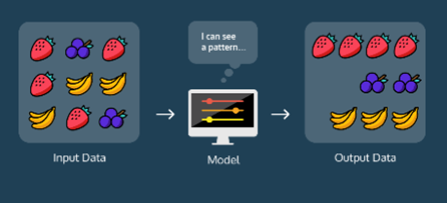
Unüberwachtes Lernen wird für Daten ohne historische Labels verwendet. Das System unterliegt keinem vorgegebenen Satz von Ausgängen, Korrelationen zwischen Inputs und Outputs oder a „richtige Antwort“. Der Algorithmus muss selbst herausfinden, was er sieht, da es keinen Wegpunktspeicher hat. Das Ziel ist es, die Daten zu untersuchen und eine Art von Mustern oder Strukturen zu finden.
Unüberwachtes Lernen kann unterteilt werden in:
● Gruppierung: Clustering ist die Aufgabe, die Population oder Datenpunkte in mehrere Gruppen aufzuteilen, so dass die Datenpunkte einer Gruppe untereinander homogen sind als die verschiedener Gruppen. Es gibt zahlreiche Gruppierungsalgorithmen, einige von ihnen sind: „K-Means-Clustering-Algorithmen“, „mittlere Änderung“, „hierarchische Gruppierung“, etc.
● Verband: Eine Assoziationsregel ist eine Methode des unüberwachten Lernens, die verwendet wird, um die Beziehungen zwischen Variablen in einem großen DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten..... Bestimmen Sie die Menge der Elemente, die zusammen im Datensatz vorkommen.
Gruppierung von K-Strümpfen:
Das Ziel des K-Means-Clustering-Algorithmus ist es, Cluster in den Daten zu finden, mit der Anzahl der Gruppen, die durch die VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... K. Der Algorithmus arbeitet iterativ, um jeden Datenpunkt basierend auf den bereitgestellten Eigenschaften einer der K Gruppen zuzuordnen.. .
Die Ergebnisse der Ausführung eines K-Means für einen Datensatz sind:
● Schwerpunkte K: Schwerpunkte für jede der im Datensatz identifizierten K-Gruppen.
● Labels für Trainingsdaten: Vollständiger Datensatz, der beschriftet ist, um sicherzustellen, dass jeder Datenpunkt einem der Cluster zugeordnet ist.
Verwenden von K-Means-Clustering auf dem Iris-Dataset:
aus sklearn.datasets import load_iris
aus sklearn.cluster importieren KMeans
iris_data=load_iris() #Laden des Iris-Datasets von sklearn.datasets iris_df = pd.DataFrame(iris_data.data, Spalten = iris_data.feature_names) #Datenrahmen erstellen kmeans = KMeans(n_cluster=3,init="k-bedeutet++", max_iter = 100, n_init = 10, random_state = 0) #Anwenden des Kmeans-Klassifikators y_kmeans = kmeans.fit_predict(x) drucken(kmeans.cluster_centers_) #Clusterzentren anzeigen plt.streuung(x[y_kmeans == 0, 0], x[y_kmeans == 0, 1],s = 100, c="rot", Etikett="Iris-seidig") plt.streuung(x[y_kmeans == 1, 0], x[y_kmeans == 1, 1],s = 100, c="Blau", Etikett="Iris-versicolour") plt.streuung(x[y_kmeans == 2, 0], x[y_kmeans == 2, 1],s = 100, c="Grün", Etikett="Iris-Virginica") #Visualisierung der Cluster - In den ersten beiden Spalten plt.streuung(kmeans.cluster_centers_[:, 0], kmeans.cluster_centers_[:,1],s = 100, c="Schwarz", Etikett="Schwerpunkte") #Plotten der Schwerpunkte der Cluster plt.legende() plt.zeigen() |
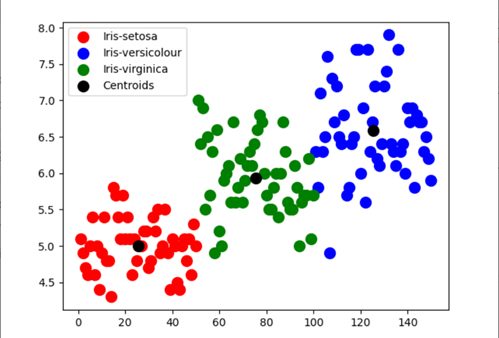
Eine Idee, die wir von der AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen.... ist, dass die Genauigkeit des Modells zur Bestimmung von Setosa und Virginica vergleichsweise höher ist als bei Versicolour.
Fazit:
Wir haben den Iris-Datensatz mit sklearn . untersucht und vorverarbeitet. Datensatz, sowie die Datei Iris.csv verwenden. Was ist mehr, Ich lernte etwas über überwachtes und unüberwachtes Lernen und implementierte den Entscheidungsbaum-Algorithmus und die GruppierungDas "Gruppierung" Es handelt sich um ein Konzept, das sich auf die Organisation von Elementen oder Individuen in Gruppen mit gemeinsamen Merkmalen oder Zielen bezieht. Dieses Verfahren wird in verschiedenen Disziplinen eingesetzt, einschließlich Psychologie, Pädagogik und Biologie, um die Analyse und das Verständnis von Verhaltensweisen oder Phänomenen zu erleichtern. Im Bildungsbereich, zum Beispiel, Gruppenbildung kann die Interaktion und das Lernen unter den Schülern verbessern, indem sie die Arbeit fördert.. mit K-Mitteln.
Verweise:
https://www.kaggle.com/sixteenpython/machine-learning-with-iris-dataset
https://scikit-learn.org/stable/
https://certes.co.uk/types-of-artificial-intelligence-a-detailed-guide/
Über den Autor:
Hallo Leser, ich bin yashi saxena, und arbeite derzeit bei TCS als System Engineer. ZUM, ML und NLP waren schon immer mein Interesse, Daher bemühe ich mich, mehr über dieses Gebiet zu erfahren. Sie können sich mit mir auf Linkedin verbinden: https://www.linkedin.com/in/yashi-saxena-7a9522194/
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





