
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
Hallo Leser!
Deep Learning wird in vielen Anwendungen eingesetzt, wie Objekterkennung, Gesichtserkennung, Aufgaben zur Verarbeitung natürlicher Sprache und vieles mehr. In diesem Blog werde ich ein Modell erstellen, mit dem ungelöste Sudoku aus einem Bild mit Deep Learning gelöst werden können, wir gehen zu Bibliotheken wie OpenCV und TensorFlow. Wenn Sie mehr über OpenCV erfahren möchten, Überprüfen Sie dies Verknüpfung. Dann legen wir los.
- Wenn Sie mehr über Python-Bibliotheken für die Bildverarbeitung wissen möchten, dann schau dir das an Verknüpfung.
- Für weitere Artikel, Klicke hier.
Bild Quelle
Der Blog ist in drei Teile gegliedert:
Teil 1: Ziffernklassifizierungsmodell
Wir werden zunächst ein neuronales Netz auf dem Char74k-Bilddatensatz für Ziffern aufbauen und trainieren. Dieses Modell hilft, die Ziffern der Bilder zu klassifizieren.
Teil 2: Sudoku aus einem Bild lesen und erkennen
Dieser Abschnitt enthält, Identifizieren des Puzzles aus einem Bild mit Hilfe von OpenCV, Sortieren Sie die Ziffern im erkannten Sudoku-Rätsel mit Teil 1, endlich die Werte der Sudoku-Zellen abrufen und in einem Array speichern.
Teil 3: Rätsel lösen
Wir werden die Matrix, die wir in Pat-2 erhalten haben, als Matrix speichern und schließlich eine Rekursionsschleife ausführen, um das Rätsel zu lösen.
IMPORTIEREN VON BIBLIOTHEKEN
Wir werden alle erforderlichen Bibliotheken mit den folgenden Befehlen importieren:
numpy als np importieren
Pandas als pd importieren
import seaborn als sns
import matplotlib.pyplot als plt
Importieren von OS, willkürlich
CV2 importieren
von glob importieren glob
sklearn importieren
aus sklearn.model_selection import train_test_split
Tensorflow als tf importieren
von tensorflow import keras
from tensorflow.keras.preprocessing.image import ImageDataGenerator
from keras.preprocessing.image import ImageDataGenerator, load_img
von keras.utils.np_utils import to_categorical
von tensorflow.keras.models importieren Sequential
von tensorflow.keras.layers importieren Aktivierung, Aussteigen, Dicht, Ebnen, BatchNormalisierung, Conv2D, MaxPooling2D
von tensorflow.keras.optimizers importieren RMSprop
aus tensorflow.keras Backend als K . importieren
aus tensorflow.keras.preprocessing import image
von sklearn.metrics import precision_score, Klassifizierungsbericht
aus pathlib-Importpfad
aus PIL-Import Bild
Teil 1: Ziffernklassifizierungsmodell
In diesem Abschnitt, Wir werden ein Ziffernklassifizierungsmodell verwenden.
LADE DATEN
Wir verwenden einen Bilddatensatz, um die Zahlen in einem Bild zu klassifizieren. Daten werden als Features wie Bilder und Labels als Labels angegeben.
#Laden der Daten
data = os.listdir("Ziffern/Ziffern" )
Daten_X = []
data_y = []
data_classes = len(Daten)
für mich in Reichweite (0,Datenklassen):
data_list = os.listdir("Ziffern/Ziffern" +"/"+str(ich))
    für j in data_list:
pic = cv2.imread("Ziffern/Ziffern" +"/"+str(ich)+"/"+J)
pic = cv2.resize(bild,(32,32))
data_X.append(bild)
data_y.append(ich)
wenn len(Daten_X) == len(data_y) :
drucken("Gesamtdatenpunkte = ",len(Daten_X))
# Etiketten und Bilder
data_X = np.array(Daten_X)
data_y = np.array(data_y)

GETEILTER DATENSATZ
Wir teilen den Datensatz in Zugsätze auf, Testen und Validieren, wie wir es bei jedem maschinellen Lernproblem tun.
#Aufteilen der Zugvalidierungs- und Test-Sets
train_X, test_X, train_y, test_y = train_test_split(Daten_X,data_y,test_size=0.05)
train_X, gültig_X, train_y, valid_y = train_test_split(train_X,train_y,test_size=0.2)
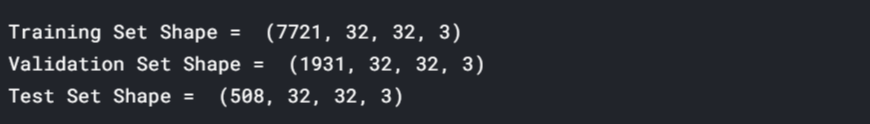
drucken("Form des Trainingssets = ",train_X.shape)
drucken("Form des Validierungssatzes = ",valid_X.shape)
drucken("Testsatzform = ",test_X.shape)
Vorverarbeitung der Bilder für die rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen..
In einem Vorverarbeitungsschritt, Wir verarbeiten die Merkmale vor (Bilder) Graustufen, Normalisierung und Verbesserung mit Histogramm-Entzerrung. Danach, Konvertieren Sie sie in NumPp-Arrays und ändern Sie sie dann und erhöhen Sie die Daten.
def Vorbereitung(img):
img = cv2.cvtColor(img,cv2.COLOR_BGR2GRAY) #Bild in Graustufen erstellen
img = cv2.equalizeHist(img) #Histogramm-Entzerrung zur Kontrastverbesserung
img = img/255 #normalisieren
    zurück img
train_X = np.array(aufführen(Karte(Vorbereitung, train_X)))
test_X = np.array(aufführen(Karte(Vorbereitung, test_X)))
valid_X= np.array(aufführen(Karte(Vorbereitung, gültig_X)))
#Umformung der Bilder
train_X = train_X.reshape(train_X.shape[0], train_X.shape[1], train_X.shape[2],1)
test_X = test_X.reshape(test_X.shape[0], test_X.shape[1], test_X.shape[2],1)
valid_X = valid_X.reshape(valid_X.shape[0], valid_X.shape[1], valid_X.shape[2],1)
#Augmentation
datagen = ImageDataGenerator(width_shift_range=0,1, height_shift_range=0,1, zoom_range=0.2, Scherbereich=0,1, rotation_range=10)
datagen.fit(train_X)
Eine heiße Codierung
In diesem Abschnitt, Wir werden One-Hot-Codierung verwenden, um die Klassen zu beschriften.
train_y = to_categorical(train_y, Datenklassen)
test_y = to_categorical(gereizt, Datenklassen)
valid_y = to_kategorial(valid_y, Datenklassen)
MODELLBAU
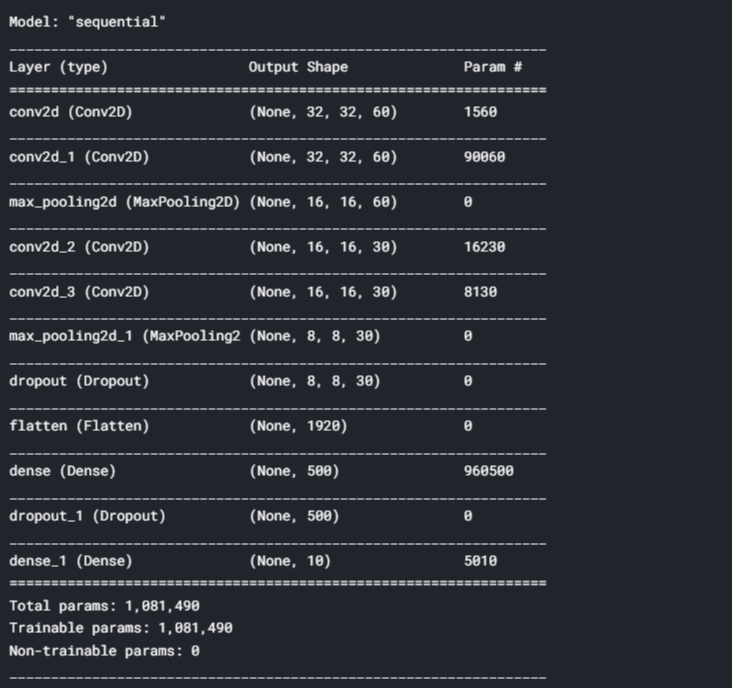
Wir verwenden eine rote neuronale FaltungFaltungsneurale Netze (CNN) sind eine Art von neuronaler Netzwerkarchitektur, die speziell für die Datenverarbeitung mit einer Gitterstruktur entwickelt wurde, als Bilder. Sie verwenden Faltungsschichten, um hierarchische Merkmale zu extrahieren, Dies macht sie besonders effektiv bei Mustererkennungs- und Klassifizierungsaufgaben. Dank seiner Fähigkeit, aus großen Datenmengen zu lernen, CNNs haben Bereiche wie Computer Vision revolutioniert.. für den Modellbau. Es besteht aus den folgenden Schritten:
#Erstellen eines neuronalen Netzwerks
Modell = Sequentiell()
model.add((Conv2D(60,(5,5),input_shape=(32, 32, 1) ,padding = 'Same' ,aktivierung='relu')))
model.add((Conv2D(60, (5,5),Polsterung="gleich",aktivierung='relu')))
model.add(MaxPooling2D(pool_size=(2,2)))
#model.add(Aussteigen(0.25))
model.add((Conv2D(30, (3,3),Polsterung="gleich", aktivierung='relu')))
model.add((Conv2D(30, (3,3), Polsterung="gleich", aktivierung='relu')))
model.add(MaxPooling2D(pool_size=(2,2), Schritte =(2,2)))
model.add(Aussteigen(0.5))
model.add(Ebnen())
model.add(Dicht(500,aktivierung='relu'))
model.add(Aussteigen(0.5))
model.add(Dicht(10, aktivierung='softmax'))
Modell.Zusammenfassung()
In diesem Schritt, Wir stellen das Modell zusammen und testen das Modell auf dem Testset wie unten gezeigt:
#Modell kompilieren
Optimierer = RMSprop(lr=0,001, rho=0,9, Epsilon = 1e-08, Zerfall=0.0)
model.compile(Optimierer=Optimierer,Verlust="kategoriale_Kreuzentropie",Metriken=[Genauigkeit])
#Passen Sie das Modell an
Geschichte = model.fit(datagen.flow(train_X, train_y, batch_size=32),
                              Epochen = 30, Validierung_Daten = (gültig_X, valid_y),
                              ausführlich = 2, steps_per_epoch= 200)

# Testen des Modells auf dem Testset
score = model.evaluate(test_X, gereizt, ausführlich=0)
drucken('Test Score=",Spielstand[0])
drucken("Test Accuracy =', Spielstand[1])

Teil 2: Sudoku aus einem Bild lesen und erkennen
LESEN SIE DAS PUZZLE-SUDOKU
Lesen Sie ein Sudoku mit OpenCv mit dem folgenden Code:
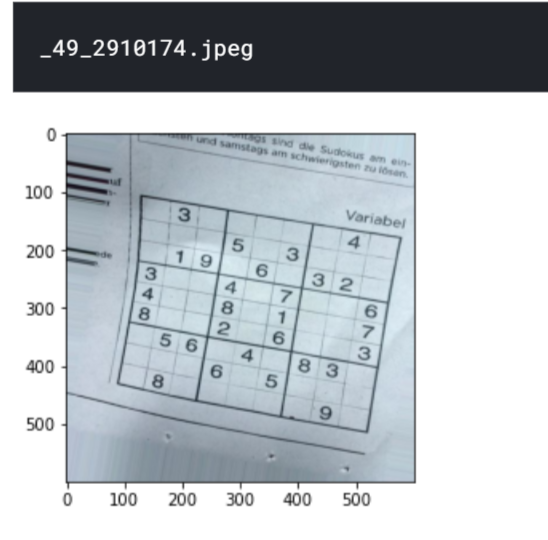
# Wählen Sie zufällig ein Bild aus dem Datensatz aus
Ordner="Sudoku-Box-Erkennung/Aug"
a=zufällige.Auswahl(os.listdir(Mappe))
drucken(ein)
sudoku_a = cv2.imread(folder+'/'+a)
plt.figur()
plt.imshow(sudoku_a)
plt.zeigen()
Verarbeiten Sie das Bild für die weitere Analyse mit dem folgenden Code vor;
#Vorverarbeitung des zu lesenden Bildes
sudoku_a = cv2.resize(sudoku_a, (450,450))
# Funktion auf Graustufen, verwischen und ändern Sie die Aufnahmeschwelle des Bildes
def Vorverarbeitung(Bild):
grau = cv2.cvtColor(Bild, cv2.COLOR_BGR2GRAY)
Unschärfe = cv2.GaussianBlur(grau, (3,3),6)
    #Unschärfe = cv2.bilateralFilter(grau,9,75,75)
Schwellenwert_img = cv2.adaptiveThreshold(verwischen,255,1,1,11,2)
    Rückgabeschwelle_img
Schwelle = Vorverarbeitung(sudoku_a)
#let's look at what we have got
plt.figure()
plt.imshow(Schwelle)
plt.zeigen()
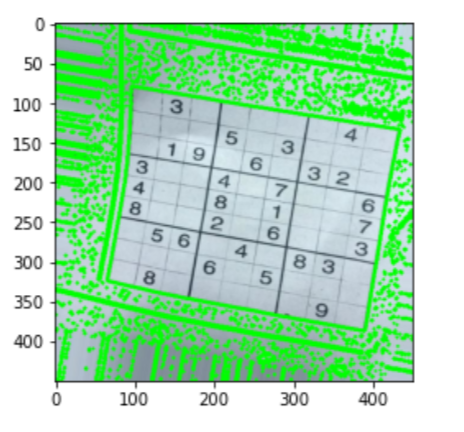
KONTUR ERKENNEN
In diesem Abschnitt, lass uns die kontur erkennen. Wir erkennen weiterhin die größte Kontur des Bildes.
# Den Umriss des Sudoku-Puzzles im Bild finden
Kontur_1 = sudoku_a.copy()
Kontur_2 = sudoku_a.copy()
Kontur, Hierarchie = cv2.findContours(Schwelle,cv2.RETR_EXTERNAL,cv2.CHAIN_APPROX_SIMPLE)
cv2.drawContours(Kontur_1, Kontur,-1,(0,255,0),3)
#let's see what we got
plt.figure()
plt.imshow(Kontur_1)
plt.zeigen()
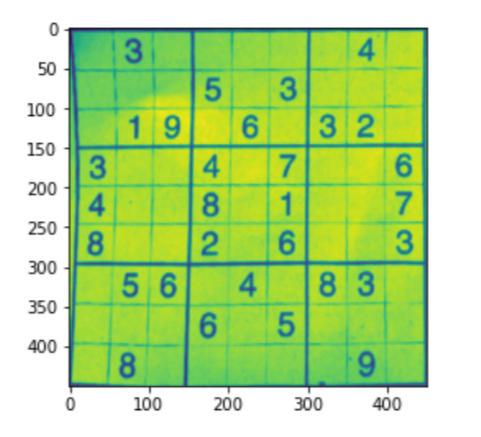
Der folgende Code wird verwendet, um das Sudoku durch Umformen zu trimmen und gut auszurichten.
def main_outline(Kontur):
größte = np.array([])
max_area = 0
    für i in Kontur:
Bereich = cv2.contourArea(ich)
        wenn Bereich >50:
peri = cv2.arcLength(ich, Wahr)
approx = cv2.approxPolyDP(ich , 0.02* peri, Wahr)
            wenn Bereich > max_area und len(ca) ==4:
größte = ca
max_area = Bereich
    Rückkehr am größten ,max_area
def reframe(Punkte):
Punkte = Punkte.Umformen((4, 2))
points_new = np.zeros((4,1,2),dtype = zB int32)
add = Punkte.Summe(1)
Punkte_neu[0] = Punkte[z.B. argmin(hinzufügen)]
Punkte_neu[3] = Punkte[z.B. armax(hinzufügen)]
diff = np.diff(Punkte, Achse =1)
Punkte_neu[1] = Punkte[z.B. argmin(unterschied)]
Punkte_neu[2] = Punkte[z.B. armax(unterschied)]
    Rückgabepunkte_neu
def Splitzellen(img):
Zeilen = np.vsplit(img,9)
Kästen = []
    für r in Reihen:
cols = np.hsplit(R,9)
        für Box in Spalten:
boxen.anhängen(Kasten)
    Rückgabeboxen
black_img = np.zeros((450,450,3), z.B. uint8)
größte, maxArea = main_outline(Kontur)
wenn größte.Größe != 0:
größte = umrahmen(größte)
cv2.drawContours(Kontur_2, größte,-1, (0,255,0),10)
pts1 = zB float32(größte)
pts2 = zB float32([[0,0],[450,0],[0,450],[450,450]])
Matrix = cv2.getPerspectiveTransform(pts1, pts2)
  imagewrap = cv2.warpPerspective(sudoku_a,Matrix,(450,450))
imagewrap =cv2.cvtColor(Bildumbruch, cv2.COLOR_BGR2GRAY)
plt.figur()
plt.imshow(Bildumbruch)
plt.zeigen()
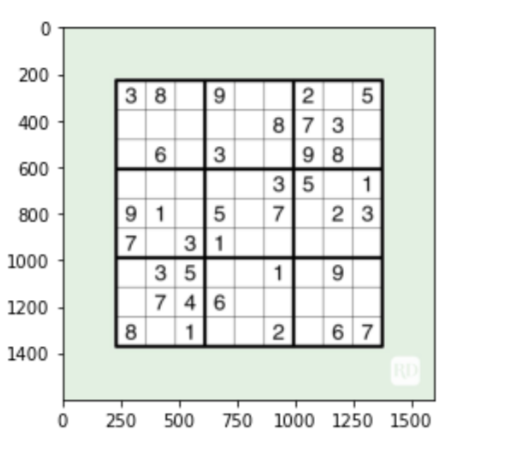
# Importieren des zu lösenden Rätsels
puzzle = cv2.imread("su-puzzle / su.jpg")
#let's see what we got
plt.figure()
plt.imshow(Puzzle)
plt.zeigen()
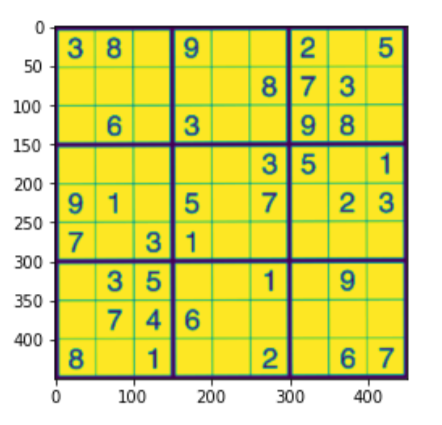
# Den Umriss des Sudoku-Puzzles im Bild finden
su_contour_1= su_puzzle.copy()
su_contour_2= sudoku_a.copy()
su_contour, Hierarchie = cv2.findContours(su_puzzle,cv2.RETR_EXTERNAL,cv2.CHAIN_APPROX_SIMPLE)
cv2.drawContours(su_contour_1, su_contour,-1,(0,255,0),3)
black_img = np.zeros((450,450,3), z.B. uint8)
su_größte, su_maxArea = main_outline(su_contour)
if su_biggest.size != 0:
su_biggest = umrahmen(su_größte)
cv2.drawContours(su_contour_2,su_biggest,-1, (0,255,0),10)
su_pts1 = np.float32(su_größte)
su_pts2 = np.float32([[0,0],[450,0],[0,450],[450,450]])
su_matrix = cv2.getPerspectiveTransform(su_pts1, su_pts2)
su_imagewrap = cv2.warpPerspective(Puzzle,su_matrix,(450,450))
su_imagewrap =cv2.cvtColor(su_imagewrap, cv2.COLOR_BGR2GRAY)
plt.figur()
plt.imshow(su_imagewrap)
plt.zeigen()
TEILEN SIE DIE ZELLEN UND KLASSIFIZIEREN SIE DIE ZIFFERN
In diesem Abschnitt, lass uns die Zellen teilen und die Ziffern klassifizieren.
- Unterteile das Sudoku zuerst in 81 Zellen mit leeren Ziffern oder Leerzeichen
- Zuschneiden der Zellen
- Verwenden Sie das Modell, um die Ziffern in den Zellen zu ordnen, sodass leere Zellen als Null sortiert werden
- Schließlich, Erkenne die Ausgabe in einem Array von 81 Ziffern.
sudoku_cell = splitcells(su_imagewrap)
#Let's have alook at the last cell
plt.figure()
plt.imshow(sudoku_cell[58])
plt.zeigen()
def CropCell(Zellen):
Zellen_croped = []
    für Bild in Zellen:
img = np.array(Bild)
img = img[4:46, 6:46]
img = Image.fromarray(img)
Cells_croped.append(img)
    zurück Cells_croped
sudoku_cell_croped=CropCell(sudoku_cell)
#Let's have alook at the last cell
plt.figure()
plt.imshow(sudoku_cell_croped[58])
plt.zeigen()
Teil 3: LÖSEN SIE DAS SODOKU
In diesem Abschnitt werden wir zwei Operationen durchführen:
- Ummodellieren der Matrix in eine Matrix von 9 x 9
- Lösen Sie das Array mit Rekursion
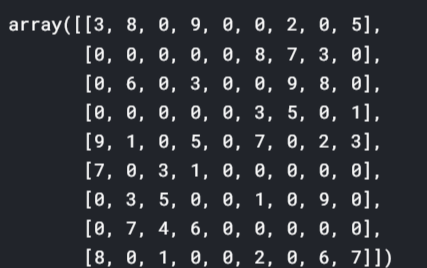
# Umformen des Rasters in eine 9x9-Matrix
Raster = np.reshape(Netz,(9,9))
Netz
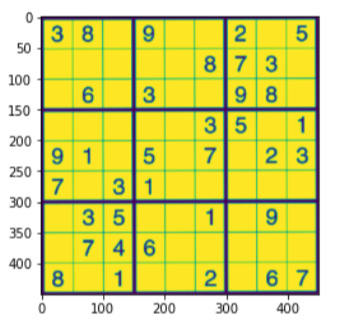
#Zum Vergleichen
plt.figur()
plt.imshow(su_imagewrap)
plt.zeigen()
Überprüfen Sie den folgenden Code, um das Sudoku weiter zu lösen:
def next_box(Quiz):
    für Reihe im Bereich(9):
        für Spalte in Reichweite(9):
            wenn quiz[Reihe][col] == 0:
                Rückkehr (Reihe, col)
    falsch zurückgeben
#Funktion zum Ausfüllen der möglichen Werte durch Auswertung von Zeilen, Spalten und kleineren Zellen
auf jeden Fall möglich (Quiz,Reihe, col, n):
    #globales Quiz
    für mich in Reichweite (0,9):
        wenn quiz[Reihe][ich] == n und Reihe != ich:
            falsch zurückgeben
    für mich in Reichweite (0,9):
        wenn quiz[ich][col] == n und col != ich:
            falsch zurückgeben
Zeile0 = (Reihe)//3
col0 = (col)//3
    für mich in Reichweite(Reihe0*3, Reihe0*3 + 3):
        für j im Bereich(col0 * 3, col0 * 3 + 3):
            wenn quiz[ich][J]==n und (ich,J) != (Reihe, col):
                falsch zurückgeben
    true zurückgeben
#Rekursionsfunktion zum Durchlaufen, bis eine gültige Antwort gefunden wurde.
auf jeden Fall lösen(Quiz):
val = next_box(Quiz)
    wenn val falsch ist:
        true zurückgeben
    anders:
Reihe, col = val
        für n im Bereich(1,10): #n ist die mögliche Lösung
            wenn möglich(Quiz,Reihe, col, n):
Quiz[Reihe][col]=n
                wenn lösen(Quiz):
                    true zurückgeben
                anders:
Quiz[Reihe][col]=0
        Rückkehr
def Gelöst(Quiz):
    für Reihe im Bereich(9):
        wenn Zeile % 3 == 0 und Reihe != 0:
drucken("....................")
        für Spalte in Reichweite(9):
            wenn col % 3 == 0 und col != 0:
drucken("|", Ende=" ")
            wenn col == 8:
drucken(Quiz[Reihe][col])
            anders:
drucken(str(Quiz[Reihe][col]) + " ", Ende="")
lösen(Netz)
Überprüfen Sie den folgenden Code, um das Endergebnis zu erhalten:
wenn lösen(Netz):
Gelöst(Netz)
anders:
drucken("Lösungen existieren nicht. Modell falsch gelesene Ziffern.")
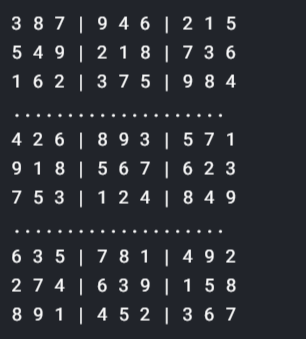
Viva!! Wir sind fertig mit dem AuflösungDas "Auflösung" bezieht sich auf die Fähigkeit, feste Entscheidungen zu treffen und gesetzte Ziele zu erreichen. Im persönlichen und beruflichen Kontext, Dabei geht es darum, klare Ziele zu definieren und einen Aktionsplan zu entwickeln, um diese zu erreichen. Entschlossenheit ist entscheidend für persönliches Wachstum und Erfolg in verschiedenen Lebensbereichen, denn es ermöglicht Ihnen, Hindernisse zu überwinden und sich auf das zu konzentrieren, was wirklich wichtig ist.... des Sudokus mit dem tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit.... Wenn Sie mehr Informationen wünschen, siehe links unten:
https://www.youtube.com/watch?v=G_UYXzGuqvM
https://www.kaggle.com/yashchoudhary/deep-sudoku-solver-multiple-approaches
https://www.youtube.com/watch?v = QR66rMS_ZfA
Abschließende Anmerkungen
Dann, In diesem Artikel, wir hatten ein ausführliches Gespräch über Lösen Sie Sudoku mit Deep Learning. Ich hoffe, Sie lernen etwas aus diesem Blog und helfen Ihnen in Zukunft. Danke fürs Lesen und deine Geduld. Viel Glück!
Sie können meine Artikel hier einsehen: Artikel
E-Mail-Identifikation: [E-Mail geschützt]
Verbinden Sie sich mit mir auf LinkedIn: LinkedIn.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





