
Dieser Artikel wurde im Rahmen der Data Science Blogathon
In diesem Artikel soll erläutert werden, rote neuronale FaltungFaltungsneurale Netze (CNN) sind eine Art von neuronaler Netzwerkarchitektur, die speziell für die Datenverarbeitung mit einer Gitterstruktur entwickelt wurde, als Bilder. Sie verwenden Faltungsschichten, um hierarchische Merkmale zu extrahieren, Dies macht sie besonders effektiv bei Mustererkennungs- und Klassifizierungsaufgaben. Dank seiner Fähigkeit, aus großen Datenmengen zu lernen, CNNs haben Bereiche wie Computer Vision revolutioniert.. und wie man CNN mit der TensorFlow Keras-Bibliothek kompiliert. In diesem Artikel werden die folgenden Themen behandelt.
Analysieren wir zunächst die rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen.. Faltung.
Rote neuronale Faltung (CNN)
Das tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... Es ist eine sehr wichtige Teilmenge des maschinellen Lernens aufgrund seiner hohen Leistung in mehreren Bereichen. La rote neuronale convolucional (CNN) ist eine leistungsstarke Art von Deep Learning zur Bildverarbeitung, die häufig in der Computer Vision verwendet wird und Bild- und Videoerkennung zusammen mit einem Empfehlungssystem und der Verarbeitung natürlicher Sprache umfasst (NLP).
CNN verwendet ein mehrschichtiges System, bestehend aus dem EingabeschichtDas "Eingabeschicht" bezieht sich auf die Anfangsebene in einem Datenanalyseprozess oder in neuronalen Netzwerkarchitekturen. Seine Hauptfunktion besteht darin, Rohinformationen zu empfangen und zu verarbeiten, bevor sie von nachfolgenden Schichten transformiert werden. Im Kontext des maschinellen Lernens, Die richtige Konfiguration der Eingabeschicht ist entscheidend, um die Effektivität des Modells zu gewährleisten und seine Leistung bei bestimmten Aufgaben zu optimieren...., das Ausgabe-LayerDas "Ausgabe-Layer" ist ein Konzept, das im Bereich der Informationstechnologie und des Systemdesigns verwendet wird. Es bezieht sich auf die letzte Schicht eines Softwaremodells oder einer Architektur, die für die Präsentation der Ergebnisse für den Endbenutzer verantwortlich ist. Diese Schicht ist entscheidend für die Benutzererfahrung, Da es eine direkte Interaktion mit dem System und die Visualisierung der verarbeiteten Daten ermöglicht.... und eine verborgene Schicht, die aus mehreren Faltungsschichten besteht, gruppierte Ebenen, vollständig verbundene Schichten. Wir werden alle Schichten im nächsten Abschnitt des Artikels besprechen, während wir die CNN-Konstruktion erklären..
Lassen Sie uns die Konstruktion von CNN mit der Keras-Bibliothek besprechen und erklären, wie CNN funktioniert.
CNN-Gebäude
Wir werden die verwenden Malaria-Zell-Imaging-Datensatz. Dieser Datensatz besteht aus 27,558 Bilder von mikroskopischen Blutproben. Der Datensatz besteht aus 2 Ordner: Ordner: parasitiert und nicht infiziert. Beispielbilder
ein) parasitierte Blutprobe
B) Nicht infizierte Blutprobe
Wir werden den Aufbau von CNN gemeinsam mit CNN besprechen und an den folgenden Arbeiten arbeiten 6 Schritte:
Paso 1: erforderliche Bibliotheken importieren
Paso 2: Initialisieren Sie CNN und fügen Sie eine FaltdeckelDie Faltungsschicht, grundlegend in Convolutional Neural Networks (CNN), Es wird hauptsächlich für die Datenverarbeitung mit gitterartigen Strukturen verwendet, als Bilder. Dieser Layer wendet Filter an, die relevante Features extrahieren, wie Kanten und Texturen, Ermöglicht dem Modell, komplexe Muster zu erkennen. Seine Fähigkeit, die Dimensionalität von Daten zu reduzieren und wichtige Informationen zu speichern, macht es zu einem wichtigen Werkzeug für Computer-Vision-Aufgaben..
Paso 3: Gruppierungsvorgang
Paso 4: füge zwei Faltungsschichten hinzu
Paso 5 – Abflachungsvorgang
Paso 6: Schicht und Ausgabeschicht vollständig verbunden
Diese 6 Schritte erklären, wie CNN funktioniert, im folgenden Bild gezeigt:
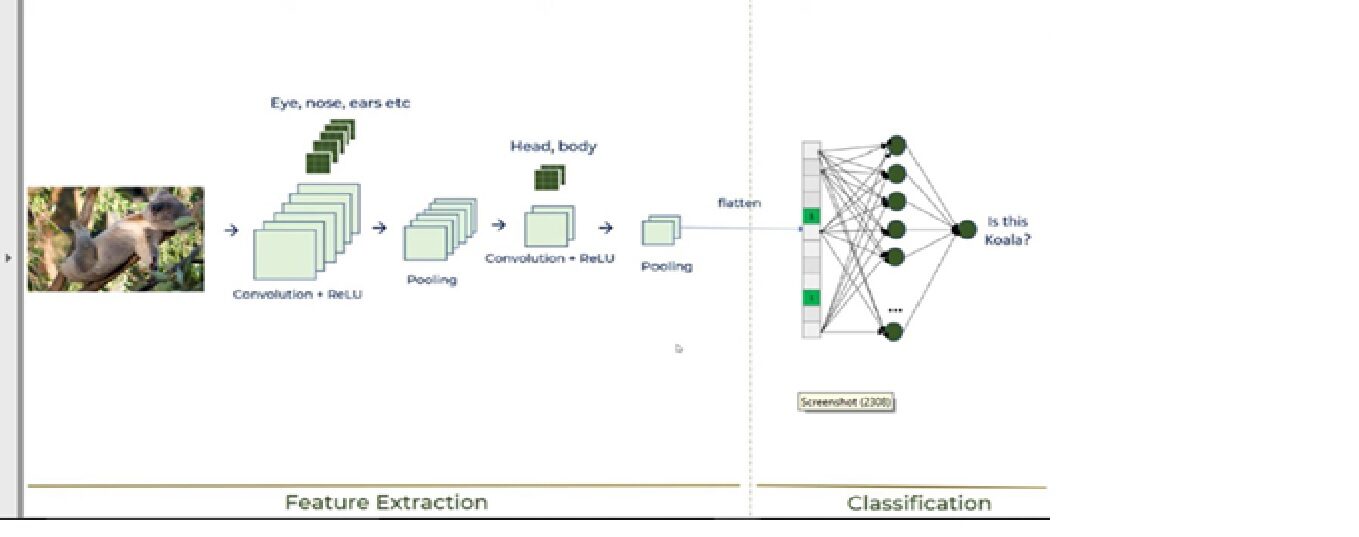
Jetzt, Lass uns jeden Schritt analysieren:
1. Importieren Sie erforderliche Bibliotheken
Bitte, siehe untenstehenden Link für detaillierte Erklärungen zu Keras-Modulen.
https://keras.io/getting_started/
Python-Code:
From tensorflow.keras.layers import Input, Lambda, Dicht, Ebnen,Conv2D
von tensorflow.keras.models Modell importieren
aus tensorflow.keras.applications.vgg19 importieren VGG19
aus tensorflow.keras.applications.resnet50 import preprocess_input
aus tensorflow.keras.preprocessing import image
from tensorflow.keras.preprocessing.image import ImageDataGenerator,load_img
von tensorflow.keras.models importieren Sequential
numpy als np importieren
von glob importieren glob
import matplotlib.pyplot als plt
aus tensorflow.keras.layers importieren MaxPooling2D
2. CNN initialisieren und eine Faltungsschicht hinzufügen
Python-Code:
model=sequentiell()

model.add(Conv2D(filter=16,kernel_size=2,padding="gleich",Aktivierung="Lebenslauf",input_shape=(224,224,3)))
Zuerst müssen wir die sequentielle Klasse starten, da es mehrere Schichten gibt, um CNN zu erstellen, und alle müssen nacheinander sein. Dann fügen wir die erste Faltungsschicht hinzu, in der wir angeben müssen 5 Argumente. Dann, Lassen Sie uns jedes Argument und seinen Zweck analysieren.
· Filter
Der Hauptzweck der Faltung besteht darin, Merkmale im Bild mit einem Merkmalsdetektor zu finden. Später, setze sie auf eine Feature-Map, das die Besonderheiten von Bildern bewahrt.
Der Feature-Detektor, was als Filter bekannt ist, auch zufällig initialisiert und dann, nach vielen Iterationen, der Filtermatrixparameter, der sich am besten zum Trennen von Bildern eignet, wird ausgewählt. Zum Beispiel, das Auge, Nase, etc. von Tieren wird als Merkmal angesehen, das verwendet wird, um Bilder mit Filtern oder Merkmalsdetektoren zu klassifizieren. Hier verwenden wir 16 Funktionen.
· Kernel_Größe
Kernel_size bezieht sich auf die Größe des Filterarrays. Hier verwenden wir eine Filtergröße von 2 * 2.
· Füllung
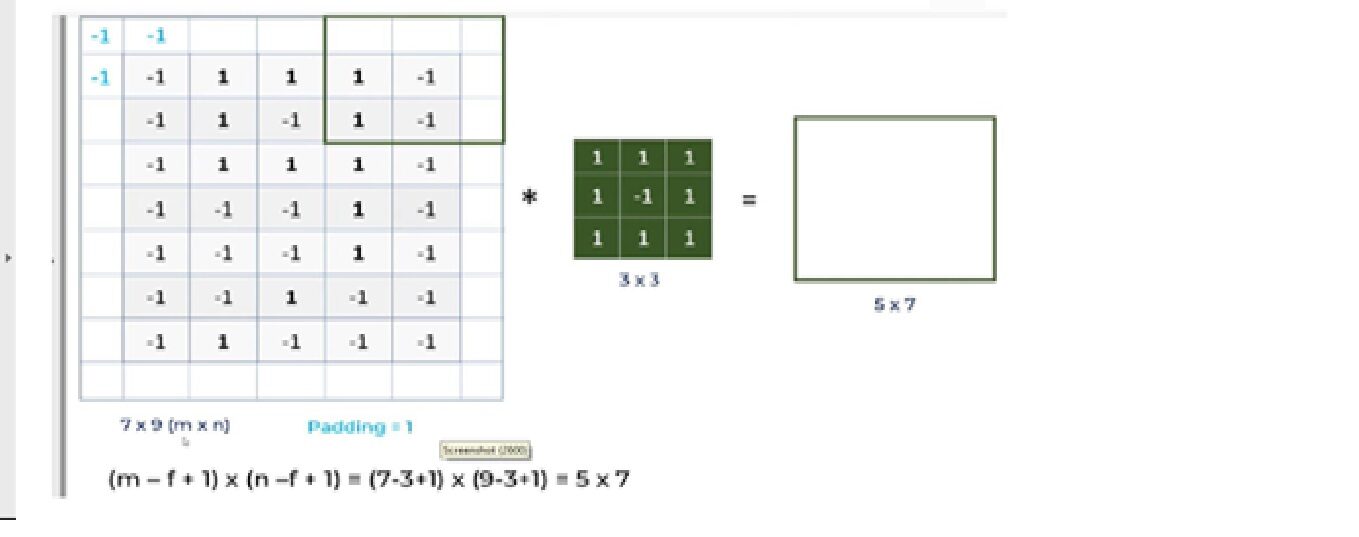
Lassen Sie uns besprechen, was das Problem mit CNN ist und wie der Füllvorgang das Problem lösen wird.
ein. Für ein Graustufenbild (nxn) und ein Filter / Ader (fxf), die Dimensionen des aus einer Faltungsoperation resultierenden Bildes sind (n – F + 1) x (n – F + 1).
Dann, zum Beispiel, ein Bild von 5 * 7 und einer Filterkerngröße von 3 * 3, das Ausgabeergebnis nach der Faltungsoperation wäre eine Größe von 3 * 5. Deswegen, das Bild verkleinert sich jedes Mal, wenn die Faltungsoperation ausgeführt wird.
B. Pixel, befindet sich in den ecken, haben einen sehr kleinen Beitrag im Vergleich zu den Pixeln in der Mitte.
Dann, um diese Probleme zu mildern, der Füllvorgang wird durchgeführt. Das Auffüllen ist ein einfacher Vorgang zum Hinzufügen von Ebenen mit 0 Ö -1 zu den Eingabebildern, um die oben genannten Probleme zu vermeiden.
Hier verwenden wir Padding = Same arguments, was beschreibt, dass die Ausgabebilder die gleichen Abmessungen wie die Eingabebilder haben.
· AuslöserfunktionDie Aktivierungsfunktion ist eine Schlüsselkomponente in neuronalen Netzen, da es den Output eines Neurons auf der Grundlage seiner Eingabe bestimmt. Sein Hauptzweck besteht darin, Nichtlinearitäten in das Modell einzuführen, Ermöglicht das Erlernen komplexer Muster in Daten. Es gibt verschiedene Aktivierungsfunktionen, wie das Sigmoid, ReLU und tanh, jedes mit besonderen Eigenschaften, die sich auf die Leistung des Modells in verschiedenen Anwendungen auswirken.... – LebenslaufDie Aktivierungsfunktion von ReLU (Gleichgerichtete Lineareinheit) Es wird aufgrund seiner Einfachheit und Effektivität häufig in neuronalen Netzen verwendet. Definiert als ( F(x) = max(0, x) ), ReLU lässt Neuronen nur dann feuern, wenn die Eingabe positiv ist, Dies hilft, das Problem des Gradientenverblassens zu mildern. Es hat sich gezeigt, dass seine Verwendung die Leistung bei verschiedenen Deep-Learning-Aufgaben verbessert, ReLU zu einer Option machen..
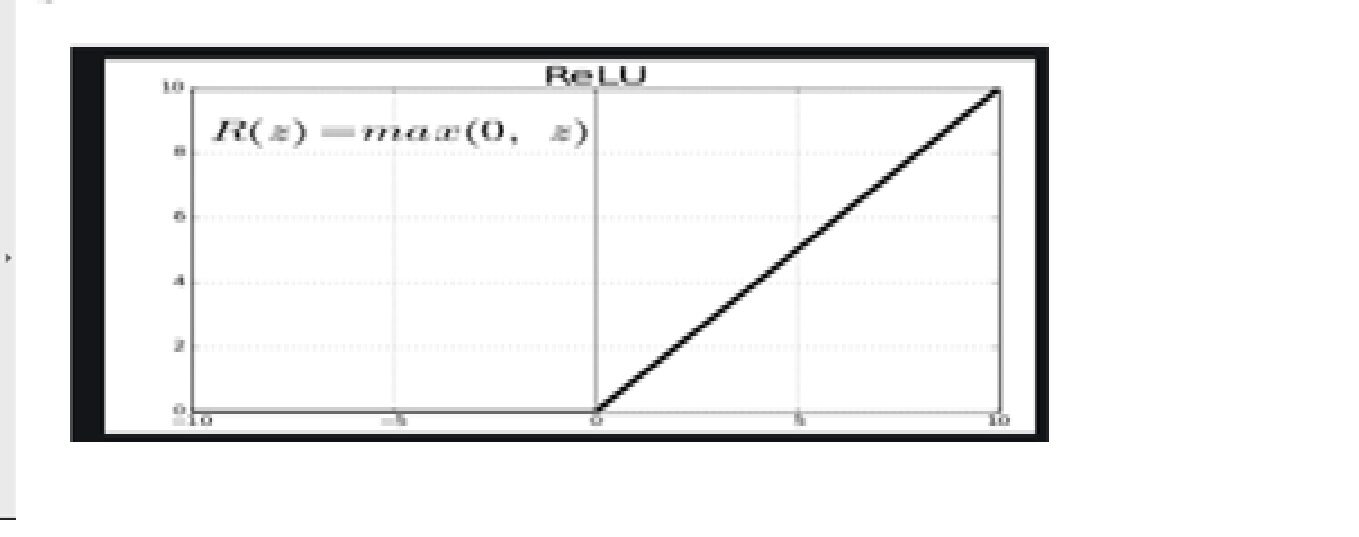
Da die Bilder nicht linear sind, um Nichtlinearität bereitzustellen, das Aktivierungsfunktion von ReluDie Aktivierungsfunktion von ReLU (Gleichgerichtete Lineareinheit) Es wird aufgrund seiner Einfachheit und Effektivität häufig in neuronalen Netzen verwendet. ist definiert als ( F(x) = max(0, x) ), Das bedeutet, dass es eine Ausgabe von Null für negative Werte und ein lineares Inkrement für positive Werte erzeugt. Seine Fähigkeit, das Problem des Gradient Fading zu mildern, macht es zu einer bevorzugten Wahl in tiefen Architekturen.... Wird nach einer Faltungsoperation angewendet.
Relu bedeutet gleichgerichtete lineare Aktivierungsfunktion. Die Relu-Funktion generiert die Eingabe direkt, wenn sie positiv ist; andererseits, erzeugt null.
· Eingabeformular
Dieses Argument zeigt die Größe des Bildes an: 224 * 224 * 3. Da die Bilder im RGB-Format so sind, Der dritte Abmessungen"Dimension" Es handelt sich um einen Begriff, der in verschiedenen Disziplinen verwendet wird, wie z.B. Physik, Mathematik und Philosophie. Er bezieht sich auf das Ausmaß, in dem ein Objekt oder Phänomen analysiert oder beschrieben werden kann. In der Physik, zum Beispiel, Es ist die Rede von räumlichen und zeitlichen Dimensionen, während es sich in der Mathematik auf die Anzahl der Koordinaten beziehen kann, die notwendig sind, um einen Raum darzustellen. Es zu verstehen, ist grundlegend für das Studium und... des Bildes ist 3.
3. Poolbetrieb
Python-Code:
model.add(MaxPooling2D(pool_size=2))
Wir müssen die Gruppierungsoperation nach der Initialisierung von CNN anwenden. Clustering ist ein Downsampling-Vorgang des Bildes. Der Gruppierungs-Layer wird verwendet, um die Dimensionen von Feature-Maps zu reduzieren. Deswegen, Die Pooling-Schicht reduziert die Menge an ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... zu lernen und den Rechenaufwand im neuronalen Netz zu reduzieren.
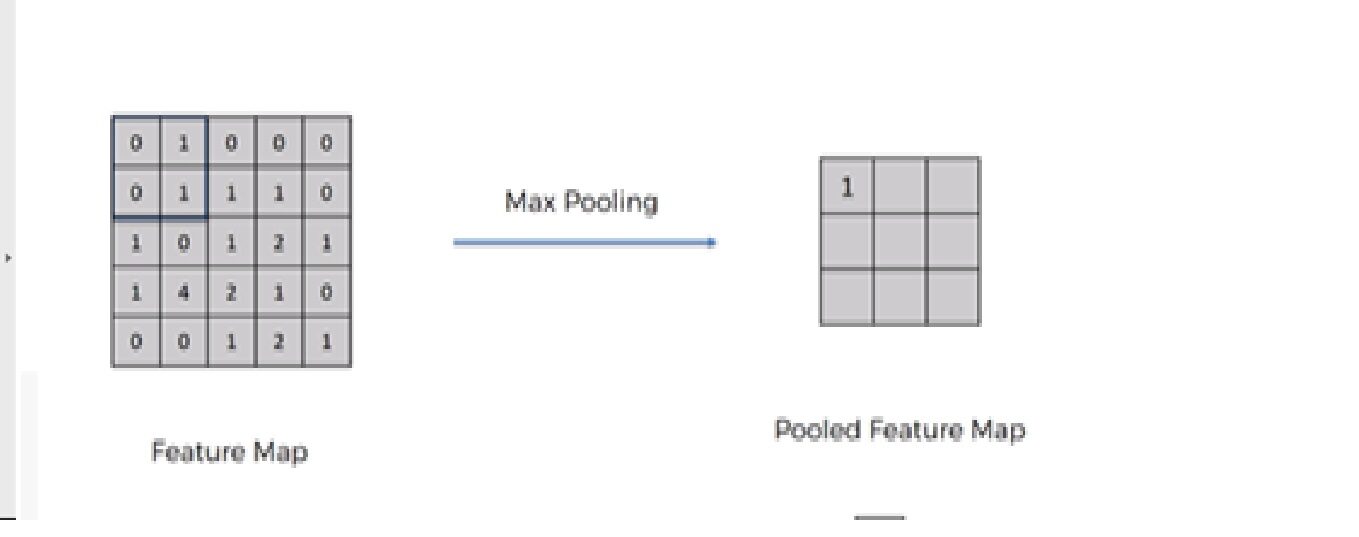
Zukünftige Operationen werden an Zusammenfassungselementen ausgeführt, die von der Gruppierungsschicht erstellt wurden. anstelle von genau lokalisierten Merkmalen, die von der Faltungsschicht erzeugt werden. Dies führt beim robusteren Modell zu Variationen in der Ausrichtung des Merkmals im Bild..
Es gibt hauptsächlich 3 Typen Gruppierung: –
1. Maximale Gruppierung
2. Durchschnittliche Gruppierung
3. Globale Gruppierung
4. Fügen Sie zwei Faltungsschichten hinzu
Um zwei weitere Faltungsschichten hinzuzufügen, Wir müssen die Schritte wiederholen 2 Ja 3 mit einer leichten Änderung in der Anzahl der Filter.
Python-Code:
model.add(Conv2D(filter=32,kernel_size=2,padding="gleich",Aktivierung ="Lebenslauf"))
model.add(MaxPooling2D(pool_size=2))
model.add(Conv2D(filter=64,kernel_size=2,padding="gleich",Aktivierung="Lebenslauf"))
model.add(MaxPooling2D(pool_size=2))
Wir modifizieren die 2Norddakota Ja 3rd Faltungsschichten mit Filternummer 32 Ja 64 beziehungsweise.
5. Abflachungsvorgang
Python-Code:
model.add(Ebnen())
Die Abflachungsoperation besteht darin, den Datensatz in eine 1-D-Matrix umzuwandeln, um in die nächste Schicht einzutreten, das ist die vollständig verbundene Schicht.
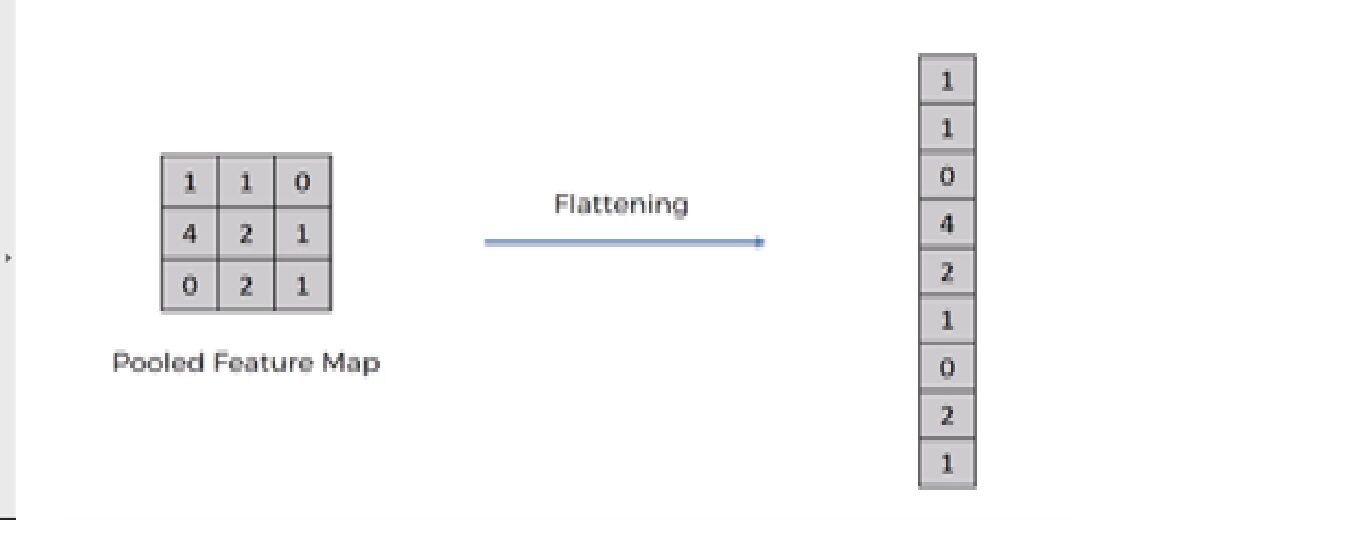
Nach Abschluss der 3 Schritte, jetzt haben wir die Feature Map gruppiert. Jetzt glätten wir unseren Ausgang nach zwei Schritten in einer Spalte. Weil wir diese 1D-Daten in eine künstliche neuronale Netzwerkschicht einfügen müssen.
6. Vollständig verbundene Schicht und Ausgabeschicht
Die Ausgabe der Abflachungsoperation dient als Eingabe in das neuronale Netz. Das Ziel des künstlichen neuronalen Netzwerks macht das neuronale Faltungsnetzwerk fortschrittlicher und leistungsfähig genug, um Bilder zu klassifizieren.
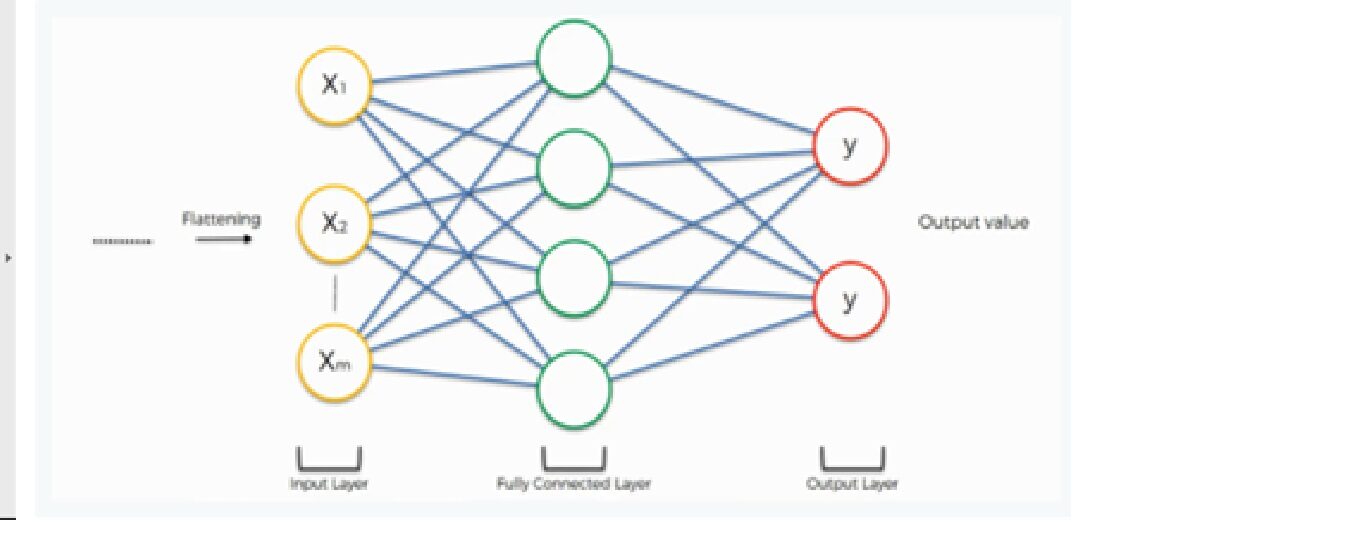
Hier verwenden wir eine dichte Klasse aus der Keras-Bibliothek, um eine vollständig verbundene Ebene und eine Ausgabeebene zu erstellen.
Python-Code:
model.add(Dicht(500,Aktivierung="Lebenslauf"))

model.add(Dicht(2,Aktivierung="softmax"))
Die softMax enable-Funktion wird verwendet, um die Ausgabeschicht aufzubauen. Analysieren wir die Aktivierungsfunktion von softmax.
Softmax-Aktivierungsfunktion
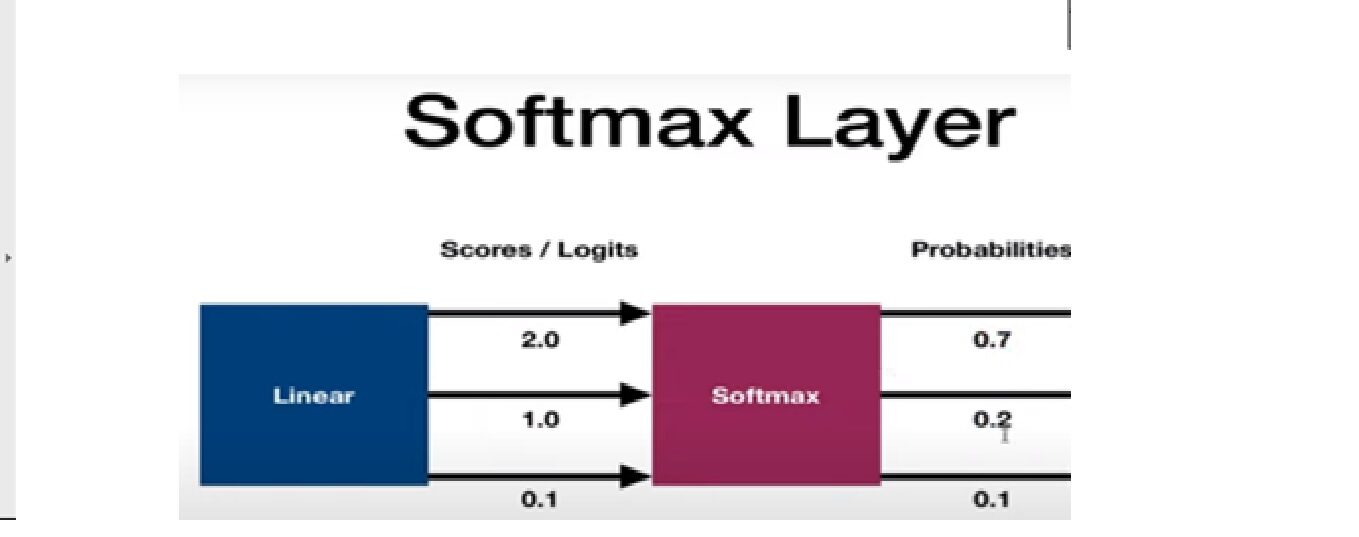
Sie wird als letzte Aktivierungsfunktion eines neuronalen Netzes verwendet, um die Ausgabe des neuronalen Netzes auf eine Wahrscheinlichkeitsverteilung über die Vorhersageklassen zu bringen. Die Ausgabe von Softmax ist in Wahrscheinlichkeiten jedes möglichen Ergebnisses, um die Klasse vorherzusagen. Die Summe der Wahrscheinlichkeiten muss für alle möglichen Vorhersageklassen eins sein.
Jetzt, Analysieren wir die AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... und die Evaluierung des Convolutional Neural Networks. Wir werden diesen Abschnitt in besprechen 3 Schritte; –
Paso 1: das CNN-Modell kompilieren
Paso 2: Passen Sie das Modell in das Trainingsset an
Paso 3: das Ergebnis bewerten
Paso 1: das CNN-Modell kompilieren
Codezeile
model.compile (Verlust = ‚kategoriale_Kreuzentropie‘, Optimierer = ‚Adam‘, Metriken =['Richtigkeit'])
Hier verwenden wir 3 Argumente: –
· VerlustfunktionDie Verlustfunktion ist ein grundlegendes Werkzeug des maschinellen Lernens, das die Diskrepanz zwischen Modellvorhersagen und tatsächlichen Werten quantifiziert. Ziel ist es, den Trainingsprozess zu steuern, indem dieser Unterschied minimiert wird, Dadurch kann das Modell effektiver lernen. Es gibt verschiedene Arten von Verlustfunktionen, wie z. B. mittlerer quadratischer Fehler und Kreuzentropie, jeder für unterschiedliche Aufgaben geeignet und...
Wir verwenden die kategoriale_Kreuzentropie Verlustfunktion, die in der Klassifizierungsaufgabe verwendet wird. Dieser Verlust ist ein sehr gutes Maß dafür, wie unterscheidbar zwei diskrete Wahrscheinlichkeitsverteilungen voneinander sind..
Bitte, Eine detaillierte Beschreibung der verschiedenen Arten der Verlustfunktion finden Sie unter folgendem Link:
· Optimierer
Wir benutzen Adam Optimizer wird verwendet, um neuronale Netzwerkgewichte und Lernrate zu aktualisieren. Optimierer werden verwendet, um Optimierungsprobleme durch Minimieren der Funktion zu lösen.
Bitte, siehe den Link unten für eine detaillierte Erklärung der verschiedenen Arten von Optimierern:
· Messwertargumente
Hier, Wir verwenden Präzision als Metrik, um die Leistung des Faltungsalgorithmus für neuronale Netze zu bewerten.
Paso 2: Passen Sie das Modell in das Trainingsset an
Codezeile:
model.fit_generator(Trainingsset,validation_data=test_set,Epochen=50, steps_per_epoch = only(Trainingsset), validation_steps=len(test_set) )
Wir passen das CNN-Modell an den Trainingsdatensatz an mit 50 Iterationen und jede Iteration hat unterschiedliche Schritte zum Trainieren und Bewerten von Schritten basierend auf der Dauer des Test- und Trainingssatzes.
Paso 3: – Bewerten Sie das Ergebnis
Wir vergleichen die Präzisions- und Verlustfunktion für den Trainings- und Testdatensatz.
Code: Verlustdiagrammplot
plt.plot(r.geschichte[Verlust], Etikett="Zugverlust")
plt.plot(r.geschichte[Validierungsverlust], Etikett="Wertverlust")
plt.legende()
plt.zeigen()
plt.savefig('LossVal_loss')
Produktion
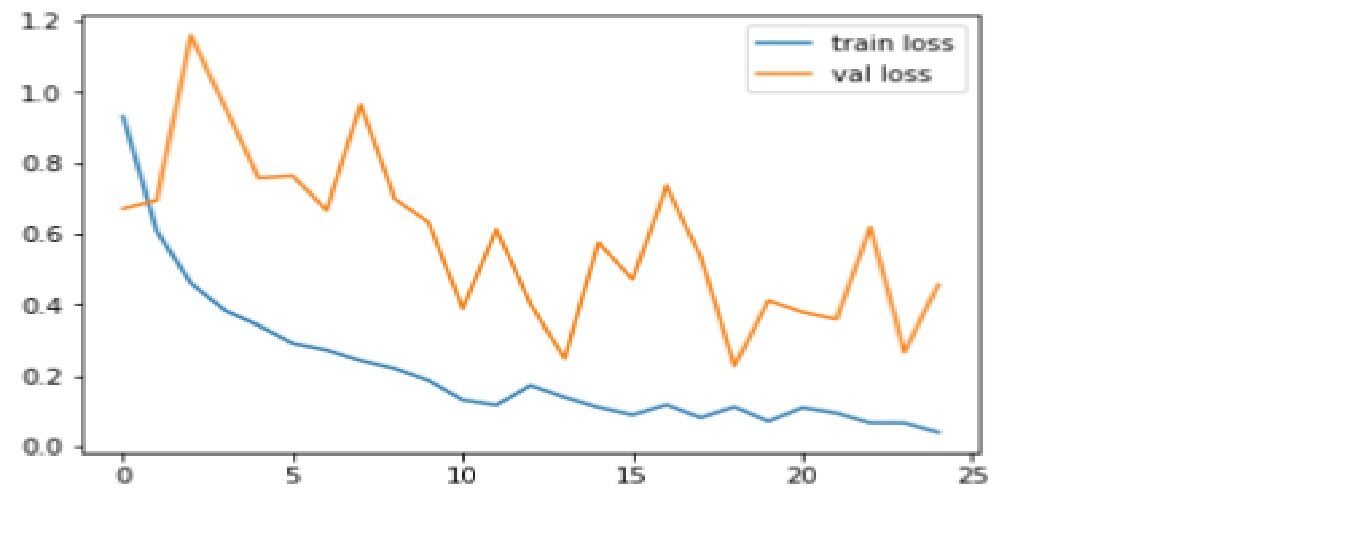
Verlust ist die Strafe für eine schlechte Vorhersage. Ziel ist es, den Validierungsverlust so gering wie möglich zu halten. Ein bisschen Overfitting ist fast immer gut. Alles was zählt, schließlich, es ist: ist der geringstmögliche Validierungsverlust.
Code: Präzisionsdiagramm zeichnen
plt.plot(r.geschichte[Genauigkeit], Etikett="Zugak")
plt.plot(r.geschichte[Validierungsgenauigkeit], Etikett="Wertguthaben")
plt.legende()
plt.zeigen()
plt.savefig('AccVal_acc')
Produktion
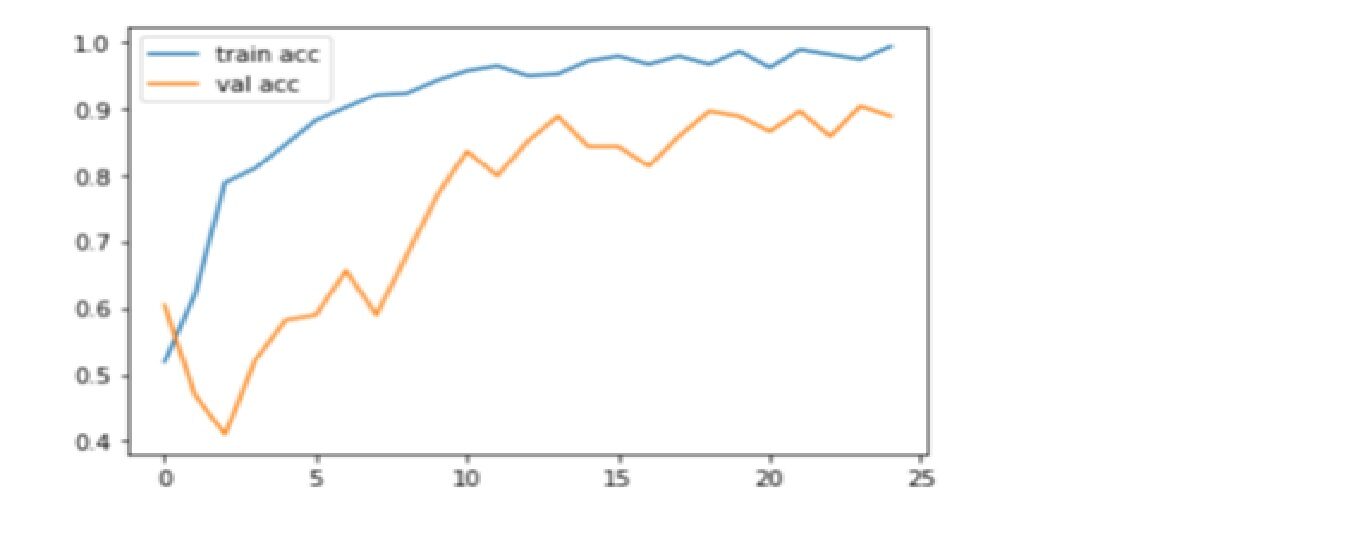
Genauigkeit ist eine Metrik zur Bewertung von Klassifizierungsmodellen. Informell, Präzision ist der Bruchteil der Vorhersagen, die unser Modell richtig gemacht hat. Hier, Wir können sehen, dass die Präzision nahe bei . liegt 90% im Validierungstest, der zeigt, dass ein CNN-Modell bei Präzisionsmetriken gut abschneidet.
Danke fürs Lesen! Viel Spaß beim tiefen Lernen!
Verweise:
1. https://www.superdatascience.com/
2. https://www.youtube.com/watch?v=H-bcnHE6Mes
Über mich :
Soja Jitendra Sharma, Data Science Praktikant bei Nabler, y me dedico a PGDM-Big Data Analytics del Goa Institute of Management. Sie können mich über kontaktieren LinkedIn Ja Github.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





