
Dieser Artikel wurde im Rahmen der Data Science Blogathon
In diesem Artikel, Wir beantworten diese grundlegenden Fragen und erstellen eine rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen.. Grundlegend zur Durchführung der linearen Regression.
Was ist ein neuronales Netz?
Die Grundeinheit des Gehirns wird als Neuron bezeichnet, es gibt ungefähr 86 Milliarden Neuronen in unserem Nervensystem, die mit 10 ^ 14-10 ^ 15 Synapse. michJedes Neuron empfängt ein Signal von den Synapsen und gibt es nach Verarbeitung des Signals aus.. Diese Idee wird aus dem Gehirn extrahiert, um ein neuronales Netzwerk aufzubauen.
Jedes Neuron realisiert ein Skalarprodukt zwischen den Eingaben und den Gewichten, Vorurteile hinzufügen, wendet eine WeckfunktionDie Aktivierungsfunktion ist eine Schlüsselkomponente in neuronalen Netzen, da es den Output eines Neurons auf der Grundlage seiner Eingabe bestimmt. Sein Hauptzweck besteht darin, Nichtlinearitäten in das Modell einzuführen, Ermöglicht das Erlernen komplexer Muster in Daten. Es gibt verschiedene Aktivierungsfunktionen, wie das Sigmoid, ReLU und tanh, jedes mit besonderen Eigenschaften, die sich auf die Leistung des Modells in verschiedenen Anwendungen auswirken.... und gibt die Ausgaben aus. Wenn eine große Anzahl von Neuronen zusammen vorhanden sind, um eine große Anzahl von Ausgaben zu ergeben, es entsteht eine neurale Schicht. Schließlich, mehrere Schichten verbinden sich zu einem neuronalen Netz.
Arquitectura de red neuronal
Neuronale Netze entstehen, wenn sich mehrere neuronale Schichten zu einem Netz verbinden, oder wir können sagen, dass es einige Ebenen gibt, deren Ausgaben Eingaben für andere Ebenen sind.
Der gebräuchlichste Schichttyp zum Aufbau eines grundlegenden neuronalen Netzes ist der vollständig verbundene Schicht, in denen benachbarte Schichten vollständig gepaart sind und einschichtige Neuronen nicht miteinander verbunden sind.
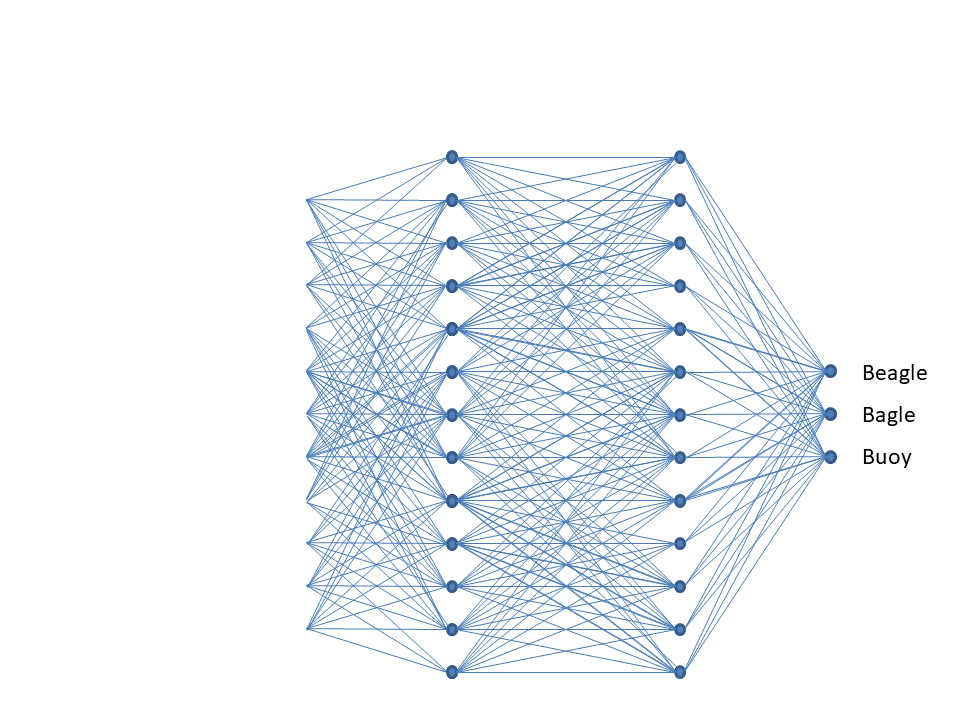
Im Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... anterior, Neuronale Netze werden verwendet, um Datenpunkte in drei Kategorien zu klassifizieren.
Regeln der Namensgebung. Wenn das N-Schichten-Neuralnetzwerk, Wir zählen nicht die EingabeschichtDas "Eingabeschicht" bezieht sich auf die Anfangsebene in einem Datenanalyseprozess oder in neuronalen Netzwerkarchitekturen. Seine Hauptfunktion besteht darin, Rohinformationen zu empfangen und zu verarbeiten, bevor sie von nachfolgenden Schichten transformiert werden. Im Kontext des maschinellen Lernens, Die richtige Konfiguration der Eingabeschicht ist entscheidend, um die Effektivität des Modells zu gewährleisten und seine Leistung bei bestimmten Aufgaben zu optimieren..... Deswegen, ein einschichtiges neuronales Netz beschreibt ein Netz ohne versteckte Schichten (Eingang wird direkt auf Ausgang abgebildet). Im Fall unseres Codes, Wir werden ein einschichtiges neuronales Netzwerk verwenden, nämlich, Wir haben keine versteckte Schicht.
AusgabeschichtDas "Ausgabe-Layer" ist ein Konzept, das im Bereich der Informationstechnologie und des Systemdesigns verwendet wird. Es bezieht sich auf die letzte Schicht eines Softwaremodells oder einer Architektur, die für die Präsentation der Ergebnisse für den Endbenutzer verantwortlich ist. Diese Schicht ist entscheidend für die Benutzererfahrung, Da es eine direkte Interaktion mit dem System und die Visualisierung der verarbeiteten Daten ermöglicht..... Anders als alle Schichten in einem neuronalen Netz, Neuronen in der Ausgangsschicht haben normalerweise keine Feuerfunktion (oder Sie können denken, dass sie eine lineare Identitätsaktivierungsfunktion haben). Dies liegt daran, dass die letzte Ausgabeschicht normalerweise die Klassenergebnisse darstellt (zum Beispiel, in der Klassifizierung), das sind willkürliche Realwertzahlen oder eine Art Realwertziel (zum Beispiel, im Rückschritt). Da wir die Regression mit einer einzelnen Schicht durchführen, Wir haben keine Aktivierungsfunktion.
Dimensionierung neuronaler Netze. Die beiden Metriken, die Menschen häufig verwenden, um die Größe neuronaler Netze zu messen, sind die Anzahl der Neuronen oder, häufiger, Die Anzahl der ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.....
Bibliotheken
Wir werden drei grundlegende Bibliotheken für dieses Modell verwenden, numpy, matplotlib und TensorFlow.
- Numpy: Dies fügt Unterstützung für große, mehrdimensionale Arrays und Arrays hinzu, zusammen mit einer großen Sammlung von High-Level-Mathematikfunktionen. In unserem Fall, wir werden Daten mit Hilfe von Numpy generieren.
- Matplotlib: Dies ist eine Plotterbibliothek für Python, Wir werden die Endergebnisse mit Grafiken in Matplotlib visualisieren.
- Tensorflow: Diese Bibliothek hat einen besonderen Fokus auf die AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... und tiefe neuronale Netzwerk-Inferenz. Wir können die Layer direkt importieren und trainieren, Testfunktionen, ohne das ganze Programm schreiben zu müssen.
numpy als np importieren
import matplotlib.pyplot als plt
Tensorflow als tf importieren
Daten generieren
Wir können unsere eigenen numerischen Daten für diesen Prozess mit der Funktion np.unifrom generieren () das erzeugt einheitliche Daten. Hier, wir verwenden zwei Eingabevariablen xs und zs, Hinzufügen von etwas Rauschen, um die Datenpunkte zu randomisieren und, Schließlich, das VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Ziel ist definiert als y = 2 * xs-3 * zs + 5 + Lärm. Die Größe des Datensatzes beträgt 1000.
Beobachtungen=1000
xs=np.random.uniform(-10,10,(Beobachtungen,1))
zs=np.random.uniform(-10,10,(Beobachtungen,1))
created_inputs=np.column_stack((xs,zs))
Rauschen=np.random.uniform(-10,10,(Beobachtungen,1))
generiertes_ziel=2*xs-3*zs+5+Rauschen
Nach dem Generieren der Daten, speichern Sie sie in einer .npz-Datei, damit sie für das Training verwendet werden können.
np. wissen('TF_intro',input=generierte_eingaben,target=generated_target)
training_data=np.load('TF_intro.npz')
Unser Ziel ist es, die endgültigen Gewichte so nah wie möglich an die tatsächlichen Gewichte zu bringen., nämlich [2,-3].
Modell definieren
Hier, wir werden die benutzen dichte SchichtBei der dichten Schicht handelt es sich um eine geologische Formation, die sich durch ihre hohe Kompaktheit und Widerstandsfähigkeit auszeichnet. Er ist häufig unter der Erde zu finden, wo es als Barriere für den Fluss von Wasser und anderen Flüssigkeiten wirkt. Seine Zusammensetzung variiert, aber es enthält in der Regel Schwermineralien, was ihm einzigartige Eigenschaften verleiht. Diese Schicht ist für die Geologie und die Untersuchung der Wasserressourcen von entscheidender Bedeutung, da sie die Verfügbarkeit und Qualität von Wasser beeinflusst.. , um das Modell zu erstellen und den Tropfen der SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in... Keras Optimizer Stochastik.
Ein Gradient ist die Steigung einer Funktion. Misst den Grad, in dem sich eine Variable mit Änderungen einer anderen Variable ändert. Mathematisch, Gradientenabstieg ist eine konvexe Funktion, deren Ausgabe die teilweise Ableitung eines Parametersatzes aus ihren Eingaben ist. Je höher die Steigung, je steiler die Steigung.
Ausgehend von einem Anfangswert, Gradient Descent läuft iterativ, um die optimalen Werte der Parameter zu finden, um den minimal möglichen Wert für die gegebene Kostenfunktion zu finden. Das Wort „stochastisch“ bezieht sich auf ein zufälliges Wahrscheinlichkeitssystem oder einen Prozess. Deswegen, de Stochastischer Gradientenabstieg, einige Proben werden zufällig ausgewählt, anstelle des Datensatzes für jede Iteration.
Angenommen, der eingang hat 2 Variablen, Einlassgröße = 2 und Ausgabegröße = 1.
Wir setzen die Lernrate auf 0.02, die weder zu hoch noch zu niedrig ist, und der Epochenwert = 100.
input_size=2
output_size=1
Modelle = tf.keras.Sequential([
                             tf.harte.Schichten.Dense(Ausgabegröße)
                            ])
custom_optimizer=tf.keras.optimizers.SGD(Lernrate=0.02)
Modelle.compile(Optimizer=custom_optimizer,Verlust="mittlere quadratische Fehler")
Modelle.fit(Trainingsdaten['Eingabe'],Trainingsdaten['Ziele'],Epochen=100, ausführlich=1)
Gewichtungen und Verzerrungen ermitteln
Wir können die vorhergesagten Werte von Gewichten und Bias drucken und auch speichern.
Modelle.Schichten[0].get_weights()
[Array([[ 1.3665189],
        [-3.1609795]], dtype=float32), Array([4.9344487], dtype=float32)]
Hier, die erste Matrix repräsentiert die Gewichte und die zweite Matrix repräsentiert die Bias. Wir können deutlich erkennen, dass die prognostizierten Werte der Gewichte sehr nahe am tatsächlichen Wert der Gewichte liegen..
Gewichte=models.layers[0].get_weights()[0]
bias=models.layers[0].get_weights()[1]
Vorhersage und Präzision
Nach der Vorhersage mit den gegebenen Gewichtungen und Bias, ein RMSE-Endwert von 0.02866, was ziemlich niedrig ist.
RMSE ist definiert als der quadratische Mittelwertfehler. Der quadratische Mittelwertfehler nimmt die Differenz für jeden beobachteten und vorhergesagten Wert. Die Formel für den RMSE-Fehler lautet::
https://www.google.com/search?q=rmse+formel&oq=RMSE+Formular&aqs=chrom.0.0i433j0j69i57j0l7.4779j0j7&sourceid=chrom&dh=UTF-8
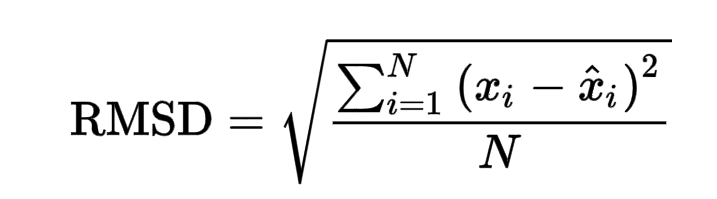
 |
|
|
|
 |
|
|
|
 |
|
|
|
 |
|
|
out=training_data['Ziele'].runden(1)
aus sklearn.metrics import mean_squared_error
mittlere quadratische Fehler(generiertes_ziel, aus, quadriert=Falsch)
Wenn wir die vorhergesagten Daten in einem AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen...., Wir erhalten eine Grafik wie diese:
plt.streuung(np.squeeze(models.predict_on_batch(Trainingsdaten['Eingabe'])),np.squeeze(Trainingsdaten['Ziele']),c="#88c999")
plt.xlabel('Eingabe')
plt.ylabel('Vorhergesagter Output')
plt.zeigen()
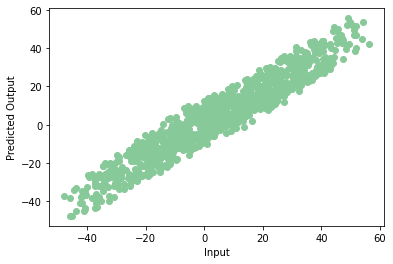
Hurra! Unser Modell wird mit sehr wenigen Fehlern richtig trainiert. Dies ist das Ende Ihres ersten neuronalen Netzes. Beachten Sie, dass wir jedes Mal, wenn wir das Modell trainieren, einen anderen Präzisionswert erhalten können, aber sie werden sich nicht viel unterscheiden.
Danke fürs Lesen! Sie erreichen mich unter [E-Mail geschützt]
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





