
Mein Vater ist immer zögerlich, wenn er online teure Transaktionen abwickelt. Er hat immer Angst, dass die Maschine einen Fehler macht. Stellen Sie sich vor, Sie übertragen alle Ihre finanziellen Vermögenswerte von einem Konto auf ein anderes und, aufgrund eines Datenfehlers, wird auf ein fremdes Konto übertragen. Aber trotzdem, Ich zögere keine Sekunde, irgendeine Art von ... durchzuführen TransaktionDas "Transaktion" bezieht sich auf den Prozess, durch den ein Austausch von Waren stattfindet, Dienstleistungen oder Geld zwischen zwei oder mehr Parteien. Dieses Konzept ist im wirtschaftlichen und rechtlichen Bereich von grundlegender Bedeutung, da es sich um eine gegenseitige Vereinbarung und die Berücksichtigung spezifischer Bedingungen handelt. Transaktionen können formell sein, als Verträge, oder informell, und sind für das Funktionieren der Märkte und Unternehmen von wesentlicher Bedeutung.... online. Was hat unsere Wahrnehmung so stark verändert?? Der Grund ist wahrscheinlich die hohe Präzision bei solchen Transaktionen, die ich seit meiner Kindheit miterlebt habe. Was macht diese unzähligen Transaktionen in Banken aus?, mit Fluggesellschaften, mit E-Commerce sind genauso genau?
In hohem Maße, das liegt an RDBMS, die sich strikt an die ACID-Prinzipien hält (Atommörder, Konsistenz, Isolierung und Haltbarkeit). Aber im Laufe der Zeit aufgrund des hohen Drucks wachsender Daten, wir haben angefangen, NoSQL-Datenbanken zu verwenden. NoSQL macht ein Schema überflüssig, Daher, es treibt die Datenverarbeitungsfähigkeit enorm RandMargin ist ein Begriff, der in einer Vielzahl von Zusammenhängen verwendet wird, wie z.B. Buchhaltung, Wirtschaft und Druck. In der Buchhaltung, bezieht sich auf die Differenz zwischen Umsatz und Kosten, die es ermöglicht, die Rentabilität eines Unternehmens zu bewerten. Im Bereich Publishing, Der Rand ist der Leerraum um den Text auf einer Seite, Das macht es gut lesbar und sorgt für eine ästhetische Darstellung. Die korrekte Verwaltung ist unerlässlich.. indem es ACID kompromittiert. Aber trotzdem, mit präzisen Supportanwendungen implementiert, NoSQL bietet eine gute Kombination aus hohen Datenverarbeitungsfunktionen mit guter Präzision. In diesem Artikel werden wir gängige NoSQL-Datenbanken diskutieren.
Bildnachweis: http://www.tomsitpro.com
NoSQL-Vollform?
NoSQL hat weder eine vollständige Form noch eine wirkliche Bedeutung. Der Begriff wurde zufällig auf einer Veranstaltung von Johan Oskarsson geprägt, um über das verteilte Open-Source-Netzwerk zu diskutieren.. Das "#NoSQL" war nur ein Twitter-Hashtag, um dieses Meeting zu veranstalten. Später, einige Leute aus der DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten.... in diesem Treffen fanden sie diesen Hashtag passend, um diese nicht-relationalen Datenbanken zu benennen. Wir haben keine wirklich strenge Definition für NoSQL. Aber trotzdem, Hier sind einige allgemeine Funktionen von NoSQL-Datenbanken:
1. Sie sind nicht relational
2. Hauptsächlich Open Source
3. Alle sind für Cluster geeignet
4. Sie sind weniger Schemata
5. Sie sind aus der Webwelt des 21. Jahrhunderts entstanden.
Aber trotzdem, wir bezeichnen NoSQL oft als schemalos, Dies bedeutet nicht, dass diese Datenbanken keinem Schema folgen. Zum Beispiel, Betrachten Sie den folgenden NoSQL-Ausdruck:
Tab1["Einnahmen" ] * Tab1["Komplette Anzahl"]
NoSQL hat ein implizites Schema, die möglicherweise nicht in der gesamten Datenbank konstant ist. So etwas ist Fluch und Segen zugleich. Die grundlegende Sache ist, dass wir jedes Mal, wenn wir ein Feld ändern möchten, dieses implizite Schema verstehen müssen. Das Gute ist, dass mit einem wechselnden Schema, Im Vergleich zu RDBMS ist viel weniger Aufwand erforderlich, um diese Datenbank hinzuzufügen. Was ist mehr, RDBMS ist mit einem verteilten Netzwerk nicht gut, Was ist bei NoSQL nicht der Fall?.
NoSQL-Datenbanktypen
Aber trotzdem, in der Literatur wurde NoSQL unterteilt in 4 Haupttypen, Ich habe einen sehr interessanten Weg gefunden, der von Martin Fowler vorgeschlagen wurde, um NoSQL zu kategorisieren. Basierend auf der Art und Weise, wie NoSQL Daten speichert, Es gibt hauptsächlich zwei Arten:
1. Datenbank hinzugefügt
2. Graphbasierte Datenbank
Der Hauptunterschied zwischen den beiden besteht darin, dass der Aggregattyp, Die Datenbank versucht, alle Informationen für eine bestimmte ID zu speichern (es kann eine person sein, eine Transaktion oder ein Produkt, etc.) als einzelnes Objekt. Während der Diagrammtyp der genau entgegengesetzten Philosophie folgt. Die grafische Datenbank versucht, die Daten in sehr granulare Informationen zu zerlegen und speichert sie mit allen gemeinsamen Beziehungen oder Kanten. Wir werden die hinzugefügten Datenbanken besprechen, die sind heute häufiger, In diesem Artikel.
Aggregierte Datenbanken
Nehmen wir ein Beispiel, um dieses Konzept der aggregierten Datenbank zu verstehen. So sieht ein Artikel über Analyticsvidhya aus:
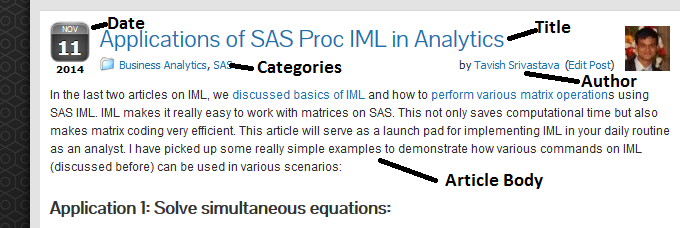 Wenn wir RDBMS verwenden würden, um unsere Daten für DataPeaker zu speichern, wir hätten relationale Tabellen erstellt. Eine kann für Informationen im Zusammenhang mit dem Autor sein, ein anderer kann sich auf die Informationen beziehen, die sich auf den Artikel beziehen, und noch ein anderer kann jeder Kategorie entsprechen. Aber wenn wir einen Artikel öffnen, wir brauchen all diese informationen zusammen. Deswegen, Wir sind mehr an aggregierten Informationen als an so granularen Informationen interessiert. Aber trotzdem, granulare Informationen hätten mir einen besseren Analyseumfang geben können, Sie könnten also mehr daran interessiert sein, die Ladezeit der Webseite zu minimieren. Deswegen, wir brauchen eine Datenbank, in der all diese Informationen an einem Ort gespeichert sind. Dies kann als aggregatorientierte Datenbanken bezeichnet werden.
Schlüsselwertdatenbanken / Dokumentendatenbanken :
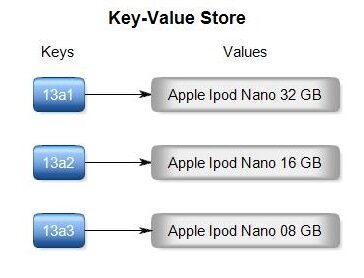
Schlüsselwertdatenbanken und Dokumentendatenbanken sind sich sehr ähnlich. Sie können sich Dokumentdatenbanken als eine verschachtelte Form von Schlüsselwertdatenbanken vorstellen. Dann, eine einfache Schlüsselwertdatenbank wird angezeigt:
Bildnachweis: http://nosql.rishabhagrawal.com
Jetzt, wenn ich Informationen zu einem iPod erhalten möchte von 16 GB, Ich muss nur das KET . bereitstellen „13a2“ zur Datenbank. So sieht eine Dokumentendatenbank aus:
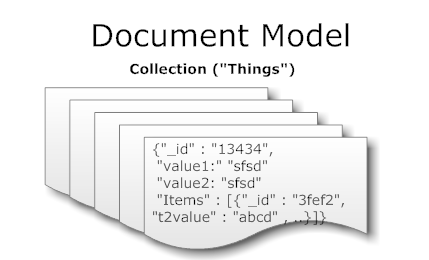
Denken Sie daran, dass wir in jedem Dokument aggregierte Informationen zu dieser Identifizierung haben. Verknüpfen Sie dies mit unserem Analyticsvidhya-Beispiel. In unserem Fall, Wir werden alle Namen des Autors haben, Titel, etc. als Schlüssel-Wert-Paare in jedem Dokument. Jetzt kann ich das gesamte Dokument auf einmal extrahieren, da es im selben Objekt gespeichert ist.
Spaltenorientierte Datenbanken :
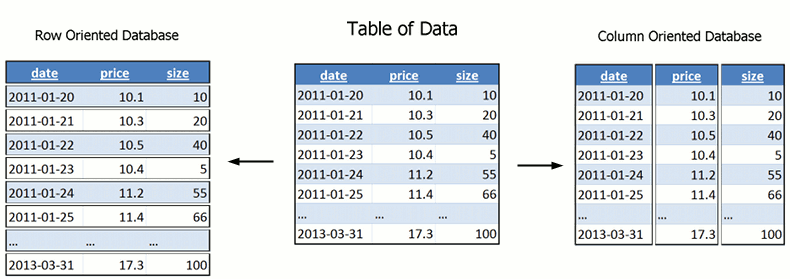
Angenommen, Sie haben eine RDBMS-Auftragstabelle mit 1 Millionen Zeilen und 100 Säulen. Jetzt möchten Sie alle Namen von Kunden mit Bestellungen von mehr als . extrahieren $ 500. Grundsätzlich, brauche einen Befehl in nur zwei Spalten, aber um diese Abfrage zu stellen, im Wesentlichen müssen Sie durch die navigieren 100 Säulen. Spaltenorientierte Datenbanken bieten eine Lösung für dieses Problem. Eine detaillierte Diskussion dieser Art von Datenbank würde den Rahmen dieses Artikels sprengen., Aber was Sie verstehen müssen, ist nur das zugrunde liegende Konzept. Hier ist ein einfaches Beispiel für eine zeilen- und spaltenorientierte Datenbank:
Bildnachweis: www.timestored.com
Spaltenorientierte Datenbank speichert jede Spalte an einem separaten Ort, wodurch wir nur die Spalten erreichen, die für uns notwendig sind. Dadurch werden Abfragen bei Such- und Filtervorgängen viel schneller.
Abschließende Anmerkungen
NoSQL-Datenbanken stoßen an unsere Grenzen beim Speichern und Analysieren von Daten. Mit solchen Strukturen ohne Schema, sie erlauben uns auch, Variablen zu ändern / Attribute jederzeit. Sie sind außergewöhnlich schnell bei der Ausführung von Abfragen für diese aggregierten Entitäten. Aber trotzdem, Diese Anweisung enthält einen Titel, der für den Fall angegeben ist, dass die Operation nicht auf der aggregierten Ebene der Tabelle ausgeführt werden soll, wird komplizierter im Vergleich zu RDBMS. Zum Beispiel, wenn wir Daten für jede Bestellung in der aggregierten NoSQL-Datenbank gespeichert haben. Alle Anfragen zu diesen Bestell-IDs werden außergewöhnlich schnell sein. Aber falls Sie Informationen auf Kunden- oder Produktebene benötigen, Diese Tabellen sind möglicherweise nicht sehr effizient. Für solche Prozesse, Sie müssen Abfragen schreiben für Karte verkleinernMapReduce ist ein Programmiermodell, das entwickelt wurde, um große Datensätze effizient zu verarbeiten und zu generieren. Unterstützt von Google, Bei diesem Ansatz wird die Arbeit in kleinere Aufgaben aufgeteilt, die auf mehrere Knoten in einem Cluster verteilt sind. Jeder Knoten verarbeitet seinen Teil und dann werden die Ergebnisse kombiniert. Mit dieser Methode können Sie Anwendungen skalieren und große Informationsmengen verarbeiten, in der Welt von Big Data von grundlegender Bedeutung zu sein..... Deswegen, es hängt von der Art der Nutzung ab, welche Datenbank am besten zu Ihnen passt.
War der Artikel hilfreich für dich? Teilen Sie uns Ihre Erfahrungen mit verschiedenen Arten von NoSQL-Datenbanken mit. Teilen Sie uns Ihre Meinung zu diesem Artikel im unten stehenden Feld mit..





