
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
Verarbeitung natürlicher Sprache (PNL) ist ein Feld, in dem künstliche Intelligenz und Linguistik zusammenlaufen. Das Ziel besteht darin, dass Computer die Sprache der realen Welt oder die natürliche Sprache verstehen, damit sie Aufgaben als Antwort auf Fragen ausführen können, Sprachübersetzung und vieles mehr.
NLP hat viele Anwendungen in verschiedenen Bereichen.
1. NLP ermöglicht die Erkennung und Vorhersage von Krankheiten basierend auf elektronischen Krankenakten.
2. Wird verwendet, um Kundenfeedback zu erhalten.
3. Zur Identifizierung von Fake News.
4. Chatbots.
5. Social-Media-Monitoring, etc.
Was ist ein Transformator??
Die Architektur des Transformer-Modells wurde von Ashish Vaswani . vorgestellt, Noam Shazeer, Niki Parmar, Jakob Razoreit, Lion Jones, Aidan N. Gomez, Lukasz Kaiser und Illia Polosukhin im Artikel „Aufmerksamkeit ist alles, was Sie brauchen“. [1]
Das Transformer-Modell extrahiert die Merkmale jedes Wortes mithilfe eines Selbstaufmerksamkeitsmechanismus, um die Bedeutung jedes Wortes im Satz zu kennen. Es werden keine anderen wiederkehrenden Einheiten verwendet, um diese Funktion zu extrahieren, es sind nur Aktivierungen und gewichtete Summen, damit können sie sehr effizient und parallelisierbar sein.
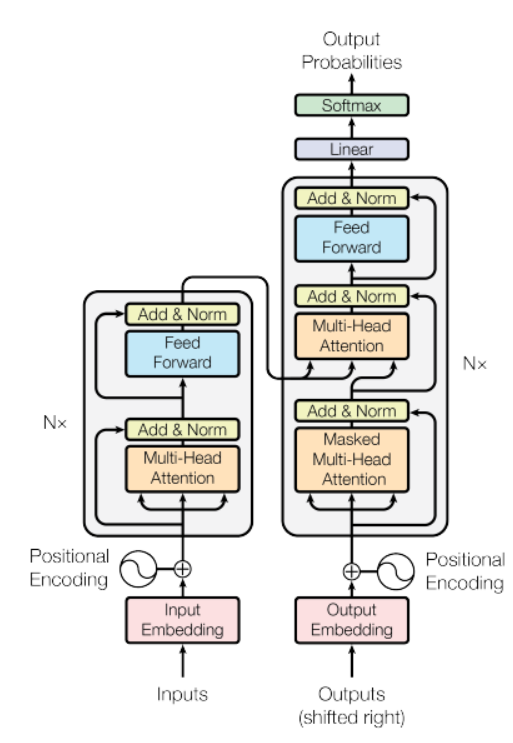
Quelle: dokumentieren „Aufmerksamkeit ist alles was du brauchst“
Im Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... anterior, auf der linken Seite befindet sich ein Encoder-Modell und auf der rechten Seite der Decoder. Sowohl der Encoder als auch der Decoder enthalten einen zentralen Block von Aufmerksamkeit und ein Feedback-Netzwerk N-mal wiederholt.
In der Abbildung oben, auf der linken Seite befindet sich ein Encoder-Modell und auf der rechten Seite der Decoder. Sowohl der Codierer als auch der Decodierer enthalten einen zentralen Aufmerksamkeitsblock und ein Feedback-Netzwerk, das N-mal wiederholt wird.
Hat einen Stapel von 6 Encoder und 6 Decoder, der Encoder enthält zwei Schichten (Unterschichten), nämlich, eine mehrköpfige Self-Care-Schicht und ein vollständig verbundenes Forward-Feed-Netzwerk. Der Decoder enthält drei Schichten (Unterschichten), eine mehrköpfige Selbstpflegeschicht, eine weitere Multi-Head-Self-Care-Schicht zur Durchführung von Self-Care an Encoder-Ausgängen und ein vollständig verbundenes Forward-Feed-Netzwerk. Cada subcapa en Decoder y Encoder tiene una conexión residual con StandardisierungNormung ist ein grundlegender Prozess in verschiedenen Disziplinen, , die darauf abzielt, einheitliche Standards und Kriterien zur Verbesserung von Qualität und Effizienz festzulegen. In Kontexten wie dem Ingenieurwesen, Bildung und Verwaltung, Standardisierung erleichtert den Vergleich, Interoperabilität und gegenseitiges Verständnis. Bei der Implementierung von Standards, Der Zusammenhalt wird gefördert und die Ressourcen werden optimiert, die zu einer nachhaltigen Entwicklung und zur kontinuierlichen Verbesserung der Prozesse beiträgt.... de capa.
Beginnen wir mit dem Aufbau eines Sprachübersetzungsmodells
Hier verwenden wir den Multi30k-Datensatz. Mach dir keine Sorgen, der Datensatz wird mit einem Code-Snippet heruntergeladen.
Zuerst, den Datenverarbeitungsteil, den wir verwenden werden Fackel PyTorch-Modul. das Fackel hat Dienstprogramme zum Erstellen von Datensätzen, die leicht wiederholt werden können, um ein Sprachübersetzungsmodell zu erstellen. Der folgende Code lädt den Datensatz herunter und tokenisiert auch einen Rohtext, construirá el vocabulario y convertirá tokens en un TensorTensoren sind mathematische Strukturen, die Konzepte wie Skalare und Vektoren verallgemeinern. Sie werden in verschiedenen Disziplinen eingesetzt, einschließlich Physik, Ingenieurwesen und maschinelles Lernen, um mehrdimensionale Daten darzustellen. Ein Tensor kann als mehrdimensionale Matrix visualisiert werden, , die es ermöglicht, komplexe Beziehungen zwischen verschiedenen Variablen zu modellieren. Ihre Vielseitigkeit und Fähigkeit, große Informationsmengen zu verarbeiten, machen sie zu grundlegenden Werkzeugen in der Datenanalyse und -verarbeitung.....
Mathematik importieren
Fackeltext importieren
Taschenlampe importieren
brenner.nn als nn importieren
aus Torchtext.data.utils import get_tokenizer
aus Sammlungen importieren Zähler
aus fackeltext.vocab importieren Vocab
aus Torchtext.utils importieren download_from_url, Extract_Archive
aus fackel.nn.utils.rnn import pad_sequence
aus Torch.utils.data Import DataLoader
aus Fackelimport Tensor
von fackel.nn importieren (TransformEncode, TransformatorDecoder,TransformerEncoderLayer, TransformerDecoderLayer)
importieren
Importzeit
url_base ="https://raw.githubusercontent.com/multi30k/dataset/master/data/task1/raw/"
train_urls = ('train.de.gz', 'train.en.gz')
val_urls = ('val.de.gz', 'val.en.gz')
test_urls = ('test_2016_flickr.de.gz', 'test_2016_flickr.en.gz')

train_filepaths = [Extract_Archive(download_from_url(url_base + URL))[0] für URL in train_urls]
val_filepaths = [Extract_Archive(download_from_url(url_base + URL))[0] für URL in val_urls]
test_filepaths = [Extract_Archive(download_from_url(url_base + URL))[0] für URL in test_urls]

de_tokenizer = get_tokenizer('spacy', Sprache="de_core_news_sm")
de_tokenizer = get_tokenizer('spacy', Sprache="de_core_web_sm")

def build_vocab(Dateipfad, Tokenisierer):
Zähler = Zähler()
mit io.open(Dateipfad, Kodierung="utf8") als f:
für string_ in f:
counter.update(Tokenisierer(Zeichenfolge_))
zurück Vokabeln(Schalter, Sonderangebote=['<unk>', '<Pad>', '<Bündel>', '<eos>'])

de_vocab = build_vocab(train_filepaths[0], de_tokenizer)
de_vocab = build_vocab(train_filepaths[1], de_tokenizer)

def data_process(Dateipfade):
raw_de_iter = iter(io.öffnen(Dateipfade[0], Kodierung="utf8"))
raw_en_iter = iter(io.öffnen(Dateipfade[1], Kodierung="utf8"))
Daten = []
zum (raw_de, raw_de) im Reißverschluss(raw_de_iter, raw_en_iter):
de_tensor_ = brenner.tensor([de_vocab[Zeichen] für Token in de_tokenizer(raw_de.rstrip("n"))],
dtype=torch.long)
de_tensor_ = brenner.tensor([de_vocab[Zeichen] für Token in en_tokenizer(raw_de.rstrip("n"))],
dtype=torch.long)
Daten.anhängen((de_tensor_, de_tensor_))
Daten zurückgeben


train_data = data_process(train_filepaths)
val_data = data_process(val_filepaths)
test_data = data_process(test_filepaths)
Gerät = Taschenlampe.Gerät('cuda' if torch.cuda.is_available() else 'cpu')


BATCH_SIZE = 128
PAD_IDX = de_vocab['<Pad>']
BOS_IDX = de_vocab['<Bündel>']
EOS_IDX = de_vocab['<eos>']
Dann verwenden wir das PyTorch DataLoader-Modul, das einen Datensatz und einen Sampler kombiniert, und ermöglicht es uns, über den gegebenen Datensatz zu iterieren. Der DataLoader unterstützt iterierbare und Map-Style-Datensätze mit Single- oder Multithread-Laden, Wir können auch die Ladereihenfolge und die Speicherfixierung anpassen.
# DataLoader
def generieren_batch(data_batch):
  de_batch, de_batch = [], []
  zum (de_item, de_item) in data_batch:
    de_batch.append(fackel.kat([fackel.tensor([BOS_IDX]), de_item, fackel.tensor([EOS_IDX])], dim=0))
    de_batch.anhängen(fackel.kat([fackel.tensor([BOS_IDX]), de_item, fackel.tensor([EOS_IDX])], dim=0))
  de_batch = pad_sequence(de_batch, padding_value=PAD_IDX)
  de_batch = pad_sequence(de_batch, padding_value=PAD_IDX)
  zurück de_batch, de_batch
train_iter = DataLoader(train_data, batch_size=BATCH_SIZE,
shuffle=Wahr, collate_fn=generate_batch)
valid_iter = DataLoader(Wertdaten, batch_size=BATCH_SIZE,
shuffle=Wahr, collate_fn=generate_batch)
test_iter = DataLoader(Testdaten, batch_size=BATCH_SIZE,
shuffle=Wahr, collate_fn=generate_batch)
Also konstruieren wir den Transformator. Hier, Der Encoder verarbeitet den Input-Stream, indem er ihn durch eine Reihe von Feed-Forward-, Multi-Head-Care-Netzwerkschichten weiterleitet. Die Ausgabe dieses Encoders wird im Folgenden als Speicher bezeichnet und wird zusammen mit den Zieltensoren dem Decoder zugeführt. Encoder und Decoder sind Ende-zu-Ende trainiert.
# Transformator
Klasse Seq2SeqTransformer(nn.Modul):
    def __init__(selbst, num_encoder_layers: int, num_decoder_layers: int,
                 emb_size: int, src_vocab_size: int, tgt_vocab_size: int,
                 dim_feedforward:int = 512, aussteigen:schweben = 0.1):
        Super(Seq2SeqTransformer, selbst).__drin__()
        Encoder_Layer = TransformerEncoderLayer(d_model=emb_size, nhead=NHEAD,
                                                dim_feedforward=dim_feedforward)
        self.transformer_encoder = TransformerEncoder(Encoder_Schicht, num_layers=num_encoder_layers)
        decoder_layer = TransformerDecoderLayer(d_model=emb_size, nhead=NHEAD,
                                                dim_feedforward=dim_feedforward)
        self.transformer_decoder = TransformerDecoder(Decoder_Layer, num_layers=num_decoder_layers)
        self.generator = nn.Linear(emb_size, tgt_vocab_size)
        self.src_tok_emb = TokenEinbettung(src_vocab_size, emb_size)
        self.tgt_tok_emb = TokenEinbettung(tgt_vocab_size, emb_size)
        self.positional_encoding = PositionalEncoding(emb_size, ausfallen = ausfallen)

    def vorwärts(selbst, src: Tensor, trg: Tensor, src_mask: Tensor,
                tgt_mask: Tensor, src_padding_mask: Tensor,
                tgt_padding_mask: Tensor, memory_key_padding_mask: Tensor):
        src_emb = self.positional_encoding(self.src_tok_emb(src))
        tgt_emb = self.positional_encoding(self.tgt_tok_emb(trg))
        Speicher = self.transformer_encoder(src_emb, src_mask, src_padding_mask)
        outs = self.transformator_decoder(tgt_emb, Erinnerung, tgt_mask, Keiner,
                                        tgt_padding_mask, memory_key_padding_mask)
        zurück self.generator(raus)

    def codieren(selbst, src: Tensor, src_mask: Tensor):
        Rückgabe self.transformator_encoder(self.positional_encoding(
                            self.src_tok_emb(src)), src_mask)

    def decodieren(selbst, tgt: Tensor, Erinnerung: Tensor, tgt_mask: Tensor):
        Rückgabe self.transformator_decoder(self.positional_encoding(
                          self.tgt_tok_emb(tgt)), Erinnerung,
                          tgt_mask)
Text, der in Token umgewandelt wird, wird durch Token-Einbettungen dargestellt. Die Positionscodierungsfunktion wird der Token-Einbettung hinzugefügt, damit wir die Begriffe der Wortreihenfolge erhalten können.
Klasse PositionalEncoding(nn.Modul):
    def __init__(selbst, emb_size: int, aussteigen, maxlen: int = 5000):
        Super(Positionskodierung, selbst).__drin__()
        den = fackel.exp(- fackel.arange(0, emb_size, 2) * math.log(10000) / emb_size)
        pos = fackel.arange(0, maxlen).umformen(maxlen, 1)
        pos_embedding = fackel.zeros((maxlen, emb_size))
        pos_embedding[:, 0::2] = fackel.sünde(Pos * den)
        pos_embedding[:, 1::2] = fackel.cos(Pos * den)
        pos_embedding = pos_embedding.unsqueeze(-2)
        self.dropout = nn.Dropout(aussteigen)
        self.register_buffer('pos_embedding', pos_embedding)

    def vorwärts(selbst, token_embedding: Tensor):
        Rückkehr self.dropout(token_embedding +
                            self.pos_embedding[:token_embedding.size(0),:])

Klasse TokenEinbettung(nn.Modul):
    def __init__(selbst, vocab_size: int, emb_size):
        Super(TokenEinbettung, selbst).__drin__()
        self.embedding = nn.Embeddding(vocab_size, emb_size)
        self.emb_size = emb_size
    def vorwärts(selbst, Token: Tensor):
        zurück self.embedding(Token.lang()) * math.sqrt(self.emb_size)
Hier, im Code unten, eine nachfolgende Wortmaske wird erstellt, um zu verhindern, dass ein Zielwort auf seine nachfolgenden Wörter achtet. Hier werden auch die Masken erstellt, um Quell- und Ziel-Padding-Token zu maskieren.
def create_square_subsequent_mask(Größe):
    Maske = (fackel.triu(fackel.ones((Größe, Größe), Gerät=GERÄT)) == 1).transponieren(0, 1)
    mask = mask.float().masked_fill(Maske == 0, schweben('-inf')).masked_fill(Maske == 1, schweben(0.0))
    Maske zurückgeben
def create_mask(src, tgt):
    src_seq_len = src.shape[0]
    tgt_seq_len = tgt.form[0]

    tgt_mask = generate_square_subsequent_mask(tgt_seq_len)
    src_mask = fackel.null((src_seq_len, src_seq_len), Gerät=GERÄT).Typ(fackel.bool)

    src_padding_mask = (src == PAD_IDX).transponieren(0, 1)
    tgt_padding_mask = (tgt == PAD_IDX).transponieren(0, 1)
    src_mask zurückgeben, tgt_mask, src_padding_mask, tgt_padding_mask
Luego defina los ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... del modelo y cree una instancia del modelo.
SRC_VOCAB_SIZE = len(de_vocab)
TGT_VOCAB_SIZE = len(de_vocab)
EMB_SIZE = 512
NHEAD = 8
FFN_HID_DIM = 512
BATCH_SIZE = 128
NUM_ENCODER_LAYERS = 3
NUM_DECODER_LAYERS = 3
NUM_EPOCHS = 50
GERÄT = Taschenlampe.Gerät('cuda:0' if torch.cuda.is_available() else 'cpu')
Transformator = Seq2SeqTransformer(NUM_ENCODER_LAYERS, NUM_DECODER_LAYERS,
                                 EMB_SIZE, SRC_VOCAB_SIZE, TGT_VOCAB_SIZE,
                                 FFN_HID_DIM)

für p in transformator.parameters():
    wenn p.dim() > 1:
        nn.init.xavier_uniform_(P)

transformator = transformator.to(Gerät)

loss_fn = fackel.nn.CrossEntropyLoss(ignore_index=PAD_IDX)

Optimierer = brenner.optim.Adam(
    transformator.parameter(), lr=0,0001, Betas=(0.9, 0.98), eps = 1.-9.
)
Definieren Sie zwei verschiedene Funktionen, nämlich, für Training und Auswertung.
def train_epoch(Modell, train_iter, Optimierer):
    modell.zug()
    Verluste = 0
    für idx, (src, tgt) aufzählen(train_iter):
        src = src.to(Gerät)
        tgt = tgt.to(Gerät)
        tgt_input = tgt[:-1, :]

        src_mask, tgt_mask, src_padding_mask, tgt_padding_mask = create_mask(src, tgt_input)

        logits = Modell(src, tgt_input, src_mask, tgt_mask,
                       src_padding_mask, tgt_padding_mask, src_padding_mask)

        optimizer.zero_grad()

        tgt_out = tgt[1:, :]
        Verlust = Verlust_fn(logits.reshape(-1, logits.shape[-1]), tgt_out.reshape(-1))
        verlust.rückwärts()

        Optimierer.Schritt()
        Verluste += Verlust.Gegenstand()
    fackel.save(Modell, WEG)

    Renditeverluste / len(train_iter)


def auswerten(Modell, val_iter):
    model.eval()
    Verluste = 0
    für idx, (src, tgt) In (aufzählen(valid_iter)):
        src = src.to(Gerät)
        tgt = tgt.to(Gerät)

        tgt_input = tgt[:-1, :]

        src_mask, tgt_mask, src_padding_mask, tgt_padding_mask = create_mask(src, tgt_input)

        logits = Modell(src, tgt_input, src_mask, tgt_mask,
                       src_padding_mask, tgt_padding_mask, src_padding_mask)
        tgt_out = tgt[1:, :]
        Verlust = Verlust_fn(logits.reshape(-1, logits.shape[-1]), tgt_out.reshape(-1))
        Verluste += Verlust.Gegenstand()
    Renditeverluste / len(val_iter)
Trainiere jetzt das Modell.
für Epoche in Reichweite(1, NUM_EPOCHS+1):
    start_time = time.time()
    train_loss = train_epoch(Transformator, train_iter, Optimierer)
    end_time = time.time()
    val_loss = auswerten(Transformator, valid_iter)
    drucken((F"Epoche: {Epoche}, Zugverlust: {train_loss:.3F}, Wertverlust: {Wertverlust:.3F}, "
           F"Epochenzeit = {(endzeit - Startzeit):.3F}S"))
Dieses Modell wird unter Verwendung der Transformatorarchitektur so trainiert, dass es schneller trainiert und auch im Vergleich zu anderen RNN-Modellen zu einem geringeren Validierungsverlust konvergiert..
def gierig_decode(Modell, src, src_mask, max_len, startsymbol):
    src = src.to(Gerät)
    src_mask = src_mask.to(Gerät)
    Speicher = model.encode(src, src_mask)
    ys = fackel.ones(1, 1).füllen_(startsymbol).Typ(fackel.lang).zu(Gerät)
    für mich in Reichweite(max_len-1):
        memory = memory.to(Gerät)
        memory_mask = fackel.null(ys.shape[0], Speicher.Form[0]).zu(Gerät).Typ(fackel.bool)
        tgt_mask = (create_square_subsequent_mask(ys.größe(0))
                                    .Typ(fackel.bool)).zu(Gerät)
        out = model.decode(y, Erinnerung, tgt_mask)
        out = out.transponieren(0, 1)
        prob = model.generator(aus[:, -1])
        _, next_word = fackel.max(prob, schwach = 1)
        next_word = next_word.item()

        ys = fackel.cat([y,
                        fackel.ones(1, 1).type_as(src.data).füllen_(next_word)], dim=0)
        if next_word == EOS_IDX:
          brechen
    zurück y


def übersetzen(Modell, src, src_vocab, tgt_vocab, src_tokenizer):
    model.eval()
    Token = [BOS_IDX] + [src_vocab.stoi[nahm] für tok in src_tokenizer(src)] + [EOS_IDX]
    num_tokens = len(Token)
    src = (Taschenlampe.LongTensor(Token).umformen(num_tokens, 1))
    src_mask = (fackel.nullen(num_tokens, num_tokens)).Typ(fackel.bool)
    tgt_tokens = greedy_decode(Modell, src, src_mask, max_len=num_tokens + 5, start_symbol=BOS_IDX).ebnen()
    Rückkehr " ".beitreten([tgt_vocab.itos[nahm] für tok in tgt_tokens]).ersetzen("<Bündel>", "").ersetzen("<eos>", "")
Jetzt, Testen wir unser Übersetzungsmodell.
Ausgabe = übersetzen(Transformator, "Eine Gruppe von Menschen steht vor einem Iglu .", de_vocab, de_vocab, de_tokenizer)
drucken(Ausgang)
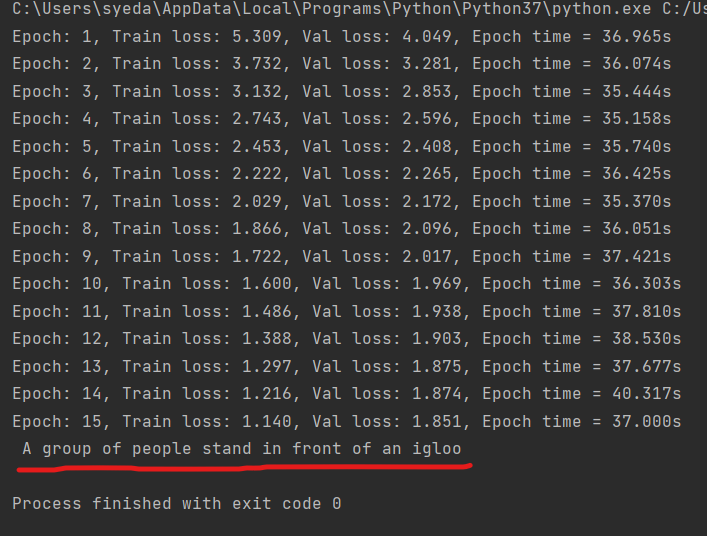
Über der roten Linie ist das Ergebnis des Übersetzungsmodells. Sie können es auch mit Google Translate vergleichen.
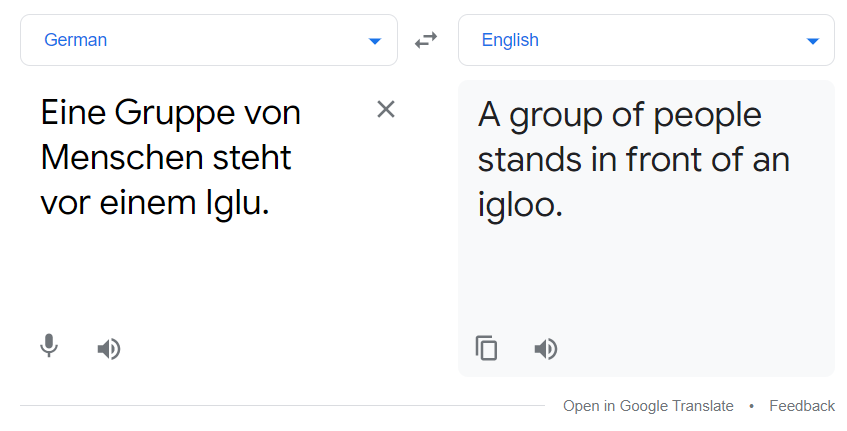
Die obige Übersetzung und die Ausgabe unseres Modells stimmten überein. Das Modell ist nicht das Beste, aber bis zu einem gewissen punkt funktioniert es noch.
Referenz
[1]. Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Razoreit, Lion Jones, Aidan N. Gomez, Lukasz Kaiser und Illia Polosukhin: Aufmerksamkeit ist alles was du brauchst, Dezember von 2017, DOI: https://arxiv.org/pdf/1706.03762.pdf
Auch für weitere Informationen, sehen https://pytorch.org/tutorials/
Vielen Dank
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





