
Die Welt wird vom Zufall regiert. Der Zufall verfolgt uns jeden Tag unseres Lebens.
– Paul Auster
Zufallszahlen umgeben uns in der Welt der Datenwissenschaft. Hin und wieder muss ich schnell zufällige Zahlen finden, um ein Gedankenexperiment durchzuführen oder einem Publikum ein Konzept zu demonstrieren, aber ohne große Datensätze herunterladen zu müssen.
Von der Erstellung von Dummy-Daten über die zufällige Reproduktion der Daten zu Trainings- und Testzwecken bis hin zur Initialisierung von Gewichten eines neuronalen Netzes, Wir generieren die ganze Zeit Zufallszahlen in Python. Sie werden dieses Konzept lieben, wenn Sie nach diesem Artikel den Dreh raus haben.
Meiner Meinung nach, Zufallszahlengenerierung ist ein Thema, das jeder in der Datenwissenschaft kennen sollte. Ich werde Sie hier durch den gesamten Prozess der Generierung von Zufallszahlen in Python führen und ihn auch mit verschiedenen Techniken demonstrieren.
Neu bei Python? Mit diesen beiden kostenlosen Kursen kannst du loslegen:
Inhaltsverzeichnis
- Zufällige Bibliothek
- Aussaat von Zufallszahlen
- Generieren von Zufallszahlen in einem Bereich
- Zufällig aus einer Liste nehmen
- Mische eine Liste
- Generierung von Zufallszahlen nach Verteilungen
Generieren von Zufallszahlen in Python mit der Zufallsbibliothek
Das ist die gute Nachricht: Es gibt mehrere Möglichkeiten, in Python Zufallszahlen zu generieren. Die einfachste Methode ist zu verwenden zufällig Modul. Es ist ein in Python integriertes Modul und erfordert keine Installation. Dieses Modul verwendet a Pseudozufallszahlengenerator (PRNG) bekannt als Mersenne Twister Zufallszahlen generieren.
Ein Pseudo-Zufallszahlengenerator ist ein deterministischer Zufallszahlengenerator. Erzeugt keine wirklichen Zufallszahlen. Nimm eine Zahl als Eingabe und erzeuge eine Zufallszahl dafür.
Notiz: Verwenden Sie nicht die zufällig Modul zur Generierung von Zufallszahlen aus Sicherheitsgründen. Für kryptografische und Sicherheitszwecke, du kannst den ... benutzen Geheimnisse Modul, das Sie verwenden echte Zufallszahlengeneratoren (WEISS).
Aussaat von Zufallszahlen
Wie wir im vorherigen Abschnitt besprochen haben, das Zufallsmodul nimmt eine Zahl als Eingabe und erzeugt dafür eine Zufallszahl. Dieser Anfangswert wird als Seed bezeichnet, und das Verfahren wird als Seed bezeichnet..
Die Zahlen, die wir mit Pseudo-Zufallszahlengeneratoren generieren, sind deterministisch. Dies bedeutet, dass sie mit demselben Seed repliziert werden können..
Lass es uns mit einem Beispiel verstehen:
zufällig importieren

drucken('Zufallszahl 1=>',zufällig.zufällig())
drucken('Zufallszahl 2=>',zufällig.zufällig())
Hier, Ich benutze die Zufallsfunktion () was eine Zufallszahl im Bereich erzeugt [0.0, 1.0]. Beachten Sie hier, dass ich den Wert des Samens nicht erwähnt habe. Standardmäßig, als Seed wird die aktuelle Systemzeit in Millisekunden verwendet. Schauen wir uns die Ausgabe an.
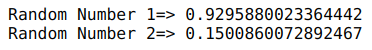
Beide Zahlen unterscheiden sich aufgrund der zeitlichen Änderung während der Ausführung von der ersten Anweisung zur zweiten Anweisung. Mal sehen, was passiert, wenn wir die Generatoren mit dem gleichen Wert pflanzen:
random.seed(42)
drucken('Zufallszahl 1=>',zufällig.zufällig())

random.seed(42)
drucken('Zufallszahl 2=>',zufällig.zufällig())
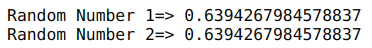
Wir bekommen hier die gleichen Zahlen. Aus diesem Grund sind Pseudo-Zufallszahlengeneratoren deterministisch und werden nicht für Sicherheitszwecke verwendet, da jeder, der den Seed hat, dieselbe Zufallszahl generieren kann.
Generieren von Zufallszahlen in einem Bereich
Bis jetzt, wir wissen, wie man Zufallszahlen im Bereich erzeugt [0.0, 1.0]. Aber, Was ist, wenn wir eine Zahl in einem anderen Bereich als diesem erstellen müssen??
Eine Möglichkeit besteht darin, die von der zurückgegebenen Zahlen zu multiplizieren und zu addieren zufällig() Funktion. Zum Beispiel, zufällig.zufällig () * 3 + 2 gibt Zahlen im Bereich zurück [2.0, 5.0]. Aber trotzdem, das ist eher ein workaround, keine direkte lösung.
Mach dir keine Sorgen! Das Zufallsmodul hat Ihren Rücken hier. Bietet Uniform() Ja Dating () Funktionen, die wir dafür nutzen können. Lass uns eins nach dem anderen verstehen.
Uniform()
Die einheitliche Funktion () aus dem Zufallsmodul nimmt der Start- und Endwert eines Bereichs als Argumente und gibt eine zufällige Gleitkommazahl im Bereich zurück. [beginnend, Ende]:
drucken('Zufallszahl im Bereich(2,8)=>', zufällig.uniform(2,8))
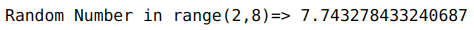
Dating ()
Diese Funktion ähnelt der uniformen Funktion (). Der einzige Unterschied besteht darin, dass die gleichförmige Funktion () gibt Gleitkomma-Zufallszahlen und die randint-Funktion zurück () gibt eine ganze Zahl zurück. Gibt auch die Zahl im Bereich zurück [beginnend, Ende]:
drucken('Zufallszahl in einem Bereich(2,8)=>', random.randint(2,8))

Zufällig aus einer Liste nehmen
Auswahl() Ja Optionen () sind die beiden Funktionen des Zufallsmoduls, mit denen wir Werte zufällig aus einer Liste auswählen können. Beide Funktionen nehmen eine Liste als Argument und wählen zufällig einen Wert daraus aus. Könnt ihr erraten, was der Unterschied ist? Auswahl() Ja Optionen () es ist?
Auswahl() Wählen Sie einfach einen einzelnen Wert aus einer Liste aus, während Optionen () Wählen Sie mehrere Werte aus einer Liste aus mit Ersatz. Das Tolle an diesen Funktionen ist, dass sie auch mit einer Liste arbeiten, die Strings enthält. Sehen wir sie in Aktion:
a=[5, 9, 20, 10, 2, 8]
drucken('Zufällig ausgewählte Zahl=>',random.choice(ein))
drucken('Zufällig ausgewählte Zahl=>',random.choices(ein,k=3))
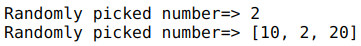
Wie du siehst, Auswahl() hat einen eindeutigen Wert von zurückgegeben ein Ja Optionen () hat drei Werte von zurückgegeben ein. Hier, k ist die Länge der Liste, die von zurückgegeben wird Optionen ().
Eine weitere Sache, die Ihnen möglicherweise in den Antworten auffällt, die von . zurückgegeben wurden Optionen () ist, dass jeder Wert nur einmal vorkommt. Sie können die Wahrscheinlichkeit erhöhen, dass jeder Wert ausgewählt wird, indem Sie ein Array wie . übergeben Pesos al Optionen () Funktion. Dann, erhöhen wir die Wahrscheinlichkeit von 10 noch bis zu dreimal und lass uns die Ergebnisse sehen:
für _ in Reichweite(5):
   drucken('Zufällig ausgewählte Zahl=>',random.choices(ein,Gewichte=[1,1,1,3,1,1],k=3))
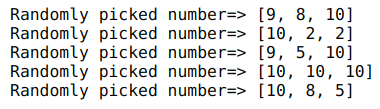
Hier, wir können sehen was passiert ist 10 in jeder Ziehung auf der Liste. Da ist auch ein Stichprobe() Funktion im Zufallsmodul, die ähnlich funktioniert wie Optionen () Funktion, sondern nimmt zufällige Stichproben aus einer Liste kein Ersatz.
Mische eine Liste
Nehmen wir an, wir möchten keine Werte aus einer Liste auswählen, aber wir wollen sie nur nachbestellen. Wir können dies mit der Mischen() Zufallsmodulfunktion. Dies Mischen() Die Funktion nimmt die Liste als Argument und mischt die Liste stattdessen:
drucken('Ursprüngliche Liste=>',ein)
random.shuffle(ein)
drucken('Gemischte Liste=>',ein)
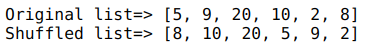
Notiz: die Shuffle-Funktion () gibt keine Liste zurück.
Generierung von Zufallszahlen nach Verteilungen
Ein überraschenderes Merkmal des Zufallsmoduls ist, dass es uns ermöglicht, Zufallszahlen basierend auf verschiedenen Wahrscheinlichkeitsverteilungen zu generieren. Es gibt verschiedene Funktionen wie Gauss(), expovariieren (), etc., die uns dabei helfen.
Wenn Sie mit Wahrscheinlichkeitsverteilungen nicht vertraut sind, Ich empfehle Ihnen, diesen Artikel zu lesen: 6 Allgemeine Wahrscheinlichkeitsverteilungen, die jeder Data Science-Experte kennen sollte.
Gauss()
Beginnen wir mit der gebräuchlichsten Wahrscheinlichkeitsverteilung, nämlich, Normalverteilung. Gauss() ist eine Funktion des Zufallsmoduls, der verwendet wird, um Zufallszahlen gemäß einer Normalverteilung zu erzeugen. Nehmen Sie den Mittelwert und die Standardabweichung als Argument und geben Sie eine Zufallszahl zurück:
für _ in Reichweite(5):
   drucken(zufällig.gauss(0,1))
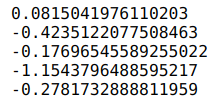
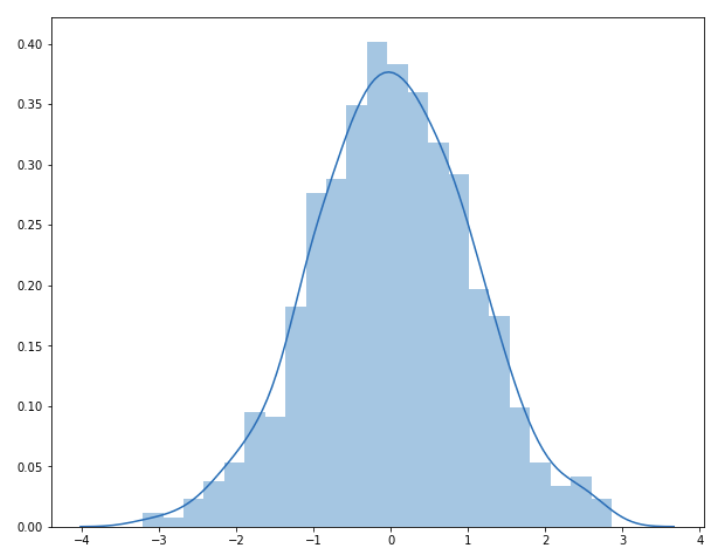
Hier, verfolgen 1000 Zufallszahlen erzeugt durch die Gauss() Funktion für Mittelwert gleich 0 und Standardabweichung als 1. Sie können oben sehen, dass alle Punkte um den Mittelwert verteilt sind und nicht weit verteilt sind, da die Standardabweichung . ist 1.
expovariieren ()
Die Exponentialverteilung ist eine weitere sehr häufige Wahrscheinlichkeitsverteilung, die Sie finden werden. das expovariieren () Die Funktion wird verwendet, um eine Zufallszahl gemäß der Exponentialverteilung zu erhalten. Es nimmt den Wert von Lambda als Argument und gibt einen Wert von zurück 0 auf positiv unendlich, wenn Lambda positiv ist, und von negativ unendlich bis 0 wenn Lambda negativ ist:
drucken('Zufallszahl aus Exponentialverteilung=>',random.expovariate(10))

Abschließende Anmerkungen
Ich verwende oft Zufallszahlen, um Dummy-Datensätze zu erstellen und für Zufallsstichproben. Ich würde gerne wissen, wie Sie Zufallszahlen in Ihren Projekten verwenden, Kommentiere also unten mit deinen Gedanken und teile sie mit der Community.
Wenn Sie diesen Artikel informativ fanden, Teilen Sie es mit Ihren Freunden und kommentieren Sie unten Ihre Fragen und Kommentare. Ich habe unten einige erstaunliche Artikel zu Python und Data Science als Referenz aufgelistet:





