
Einführung
Hallo an alle für diese praktische Einführung in das maschinelle Lernen mit einfacher linearer Regression.. Dann legen wir los:
Dann, Machen wir uns mit den Begriffen vertraut, die verwendet werden:
Maschinelles Lernen (ML): ML ist eine Anwendung für künstliche Intelligenz (ER) die Systeme in die Lage versetzt, automatisch aus Erfahrungen zu lernen und sich zu verbessern, ohne explizit programmiert zu werden. ML konzentriert sich auf die Entwicklung von Computerprogrammen, die auf Daten zugreifen und diese verwenden können, um selbst zu lernen.
Datensatz: Eine Sammlung zusammengehöriger Informationssätze, die aus separaten Elementen besteht, aber von einem Computer als Einheit bearbeitet werden kann.
Datenvisualisierung: Es ist eine Darstellung von Daten oder Informationen in einem Diagramm, Diagramme oder andere visuelle Formate, die für die Analyse nützlich sind, wie Predictive Analytics, die als nützliche Visualisierung für die Präsentation dienen kann.
Datenbereinigung: Es ist der Prozess des Korrigierens oder Entfernens falscher Daten, korrupt, falsch formatiert, Duplikate oder unvollständig innerhalb eines Datensatzes.
Überwachtes LernenÜberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem ein Modell mit einem Satz von beschrifteten Daten trainiert wird. Jede Eingabe im Dataset ist mit einer bekannten Ausgabe verknüpft, So kann das Modell lernen, Ergebnisse für neue Eingaben vorherzusagen. Diese Methode wird häufig in Anwendungen wie der Bildklassifizierung eingesetzt., Spracherkennung und Trendvorhersage, und unterstreicht seine Bedeutung in...: Das Modell wird unter Verwendung von ‚markierten Daten‘. Es wird gesagt, dass die Datensätze Beschriftungen enthalten, die ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... Eingabe und Ausgabe. Vereinfachen: ‚Die Daten sind bereits mit der korrekten Antwort gekennzeichnet‘.
Einfache lineare Regression: Es ist ein Regressionsmodell, das die Beziehung zwischen der VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... unabhängigen und der abhängigen Variablen mithilfe einer Geraden schätzt [y = mx + C], wobei beide Variablen quantitativ sein müssen.
Modelle: Die Ergebnisse werden mithilfe von Algorithmen gewonnen und setzen sich aus Daten des Modells und einem Vorhersagealgorithmus zusammen..
Modell von AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen....: Beim betreuten Lernen, ein ML-Algorithmus erstellt ein Modell, indem er viele Beispiele untersucht und versucht, ein Modell zu finden, das den Verlust minimiert und die Vorhersagegenauigkeit verbessert.
Dies sind die wenigen Begriffe, die in diesem Artikel verwendet werden und mit denen Sie sich vertraut machen sollten. Beginnen wir nun mit der Analyse und Vorhersage des Modells. In diesem Tutorial, Ich werde überwachte Daten und einfache lineare Regression zur Analyse und Vorhersage verwenden. Das ultimative Ziel ist es, die Körpergröße einer Person vorherzusagen und ihr Alter mithilfe des trainierten Modells unter Verwendung der verfügbaren Daten so genau wie möglich anzugeben.. Ich habe die universelle Lieblingsprogrammiersprache für ML verwendet, nämlich. Felshaken zum Erstellen und Trainieren des ML-Modells und der Google Colab-Umgebung.
Die erforderlichen Schritte sind:
1. Datensatzimport.
2. Datenvisualisierung
3. Datenbereinigung
4. Baue das Modell und trainiere es
5.Machen Sie Vorhersagen zu unsichtbaren Daten
—————————————————————————————————————————————————— ————————
1. Datensatzimport:
Der erste und wichtigste Schritt ist der Import des Datensatzes. Wir haben mehrere Websites, auf denen diese Datensätze von jedem verwendet werden können. Ähnlich, Beginnen wir mit dem Importieren des Datasets, das wir in diesem Tutorial verwenden werden.

Diese einzelne Codezeile hilft uns, die für das Tutorial verwendeten Daten direkt von der URL zu erhalten.
Datensatz <- Klicken Sie auf den Link, um den Datensatz zu erhalten, der die oben erwähnte URL ist.
2. Datenvisualisierung:
In diesem Schritt, nach dem Importieren der Daten und Mounten mit Colab, Verschaffen wir uns einen Überblick über den Datensatz, indem wir ein Modul namens Pandas importieren. Da der Datensatz eine Erweiterung von .pkl . hat, Wir sehen es nur an der Funktion, die in der Pandas-Bibliothek verfügbar ist.
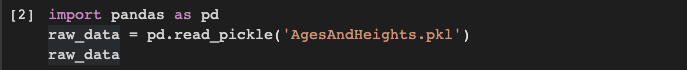
Wir importieren die Bibliothek, um den Datensatz zu lesen und speichern ihn in einer Variablen namens Rohdaten. Dann zeigen wir den Inhalt von Rohdaten die in tabellarischer Form vorliegt.
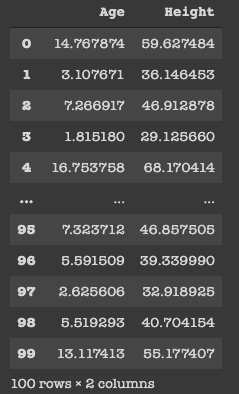
Wir können nur die Daten sehen, die wir haben und enthalten 2 Säulen, nämlich, Alter (in Jahren) und Höhe (in Zoll) Ja 100 Reihen, was eigentlich die Darstellung einer Person ist.
Diese einzelne Codezeile hat einen großen Einfluss darauf, wie wir den Datensatz betrachten. Wir hatten nur eine numerische Ansicht des Datensatzes, aber jetzt können wir diese Zelle ausführen, um eine Histogrammansicht des Datensatzes zu erhalten, was sehr nützlich ist. Stellt die in den einzelnen Spalten vorhandenen Daten als einzelne Diagramme dar.
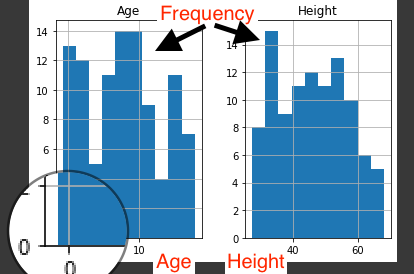
Die Y-Achse in beiden Diagrammen bezieht sich auf die Häufigkeit und die X-Achse repräsentiert das Alter bzw. die Körpergröße..
3. Datenbereinigung:
Wir müssen das Modell mit gültigen Datensätzen erstellen und die nicht nachvollziehbaren Daten bereinigen. Im Bild oben, Wir können wissen, dass es einige Einträge gibt, die ein Alter von weniger als null haben, was keinen sinn macht. Deswegen, Wir müssen diese Daten bereinigen, um mehr Präzision zu erhalten.
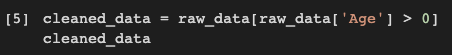
Ich verwende variabel data_cleaned gültige Alterswerte zu speichern und dem Benutzer anzuzeigen.
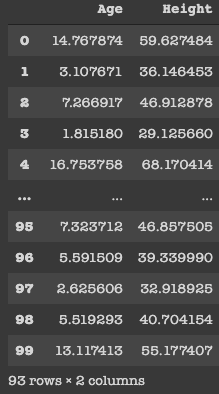
Anfänglich, wir hatten 100 Reihen, aber nach der Datenbereinigung, Es ist ganz klar, dass es sieben Reihen gibt, die ein Alter hatten <0 und wir haben sie entfernt. Als Profi, Wir dürfen die Daten nicht löschen, da wir sie reduzieren und, Daher, die Genauigkeit unseres Modells ist reduziert. Um es einfach zu halten, Ich habe sie gerade gelöscht.
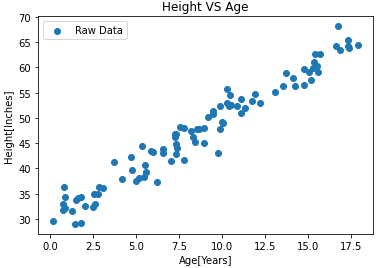
Visualisieren Sie saubere Daten: jetzt habe ich die sauberen daten verwendet und als grafik visualisiert.
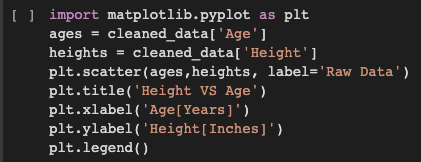
Um Python-Grafiken zu plotten, Ich importiere die matplotlib.pyplot-Bibliothek. Ich stelle das Alter auf der X-Achse und die Körpergröße auf der Y-Achse dar. Die Punkte in der Grafik beziehen sich auf die Rohdaten.
4. Baue das Modell und trainiere es:
Hier kommt der ML-Algorithmus ins Spiel., nämlich, einfache lineare Regression.
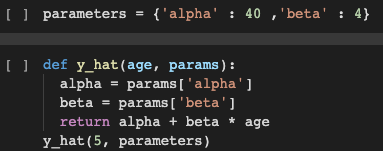
Ich habe ein Wörterbuch namens Parameter verwendet, das alfa Ja Beta als Schlüssel mit 40 Ja 4 als Werte bzw.. Ich habe auch eine Funktion definiert y_hat was Alter und Parameter als Parameter nimmt. Diese Funktion verwendet die Grundgleichung in einer geraden Linie und gibt y . zurück, nämlich, Höhe wie in unserem Fall. Wenn wir die erforderlichen Parameter übergeben und die Funktion ausführen, Wir stellen fest, dass die Höhe, die wir für das Alter als Eingabe erhalten, nicht übereinstimmt. Deswegen, wir verwenden die unten genannte Funktion, um das Modell regnen zu lassen.
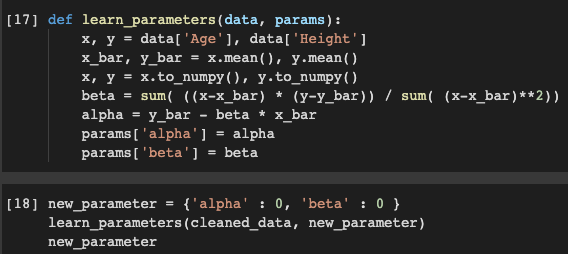
Hier verwenden wir eine Methode, um das richtige Alpha und Beta zu finden. Die Funktion Lernparameter Sie akzeptieren data_cleaned und ein Dummy-Wörterbuch neuer_parameter die einen beliebigen Wert für Alpha und Beta haben können. Dann, wenn wir sie als Argumente an die Parameter übergeben und die Funktion ausgeführt wird, Wir können den richtigen Wert von Alpha und Beta erhalten, der nahe bei liegt 30 Ja 2 bzw. ersetzen Sie die alten Werte durch die neuen.
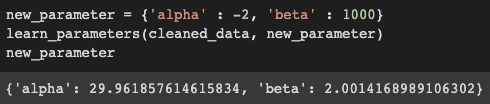
Wir haben die Alpha- und Beta-Werte genau gefunden, und unser nächstes Ziel ist es, die Daten zu trainieren. Aber lassen Sie mich die ungeübten prognostizierten Werte wie genau sie sind.
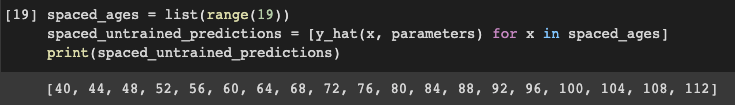
Ich verwende eine Liste namens räumliche_alter die Werte von hat 0 ein 18 (Finale – 1). Dann eine andere Liste namens spaced_untrained_predictions die die vorhergesagten Werte für die Höhe hat, verwendet die y_hat oben definierte Funktion, um es vorherzusagen. Diese Werte werden grafisch aufgetragen und angezeigt.
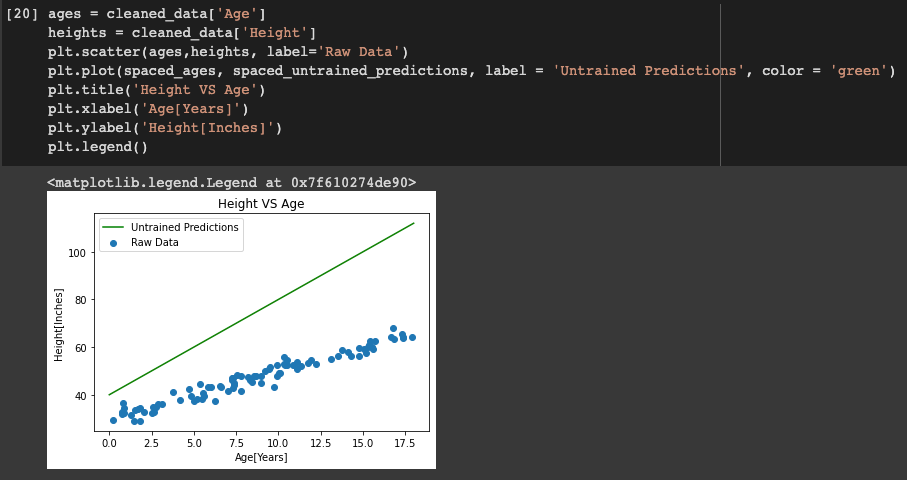
Die grüne Linie zeigt, dass die spaced_untrained_predictions sind stark von den tatsächlichen Werten abgewichen und die Genauigkeit ist sehr schlecht. Deswegen, es ist notwendig, die Genauigkeit zu erhöhen, für die wir die Daten trainieren müssen.
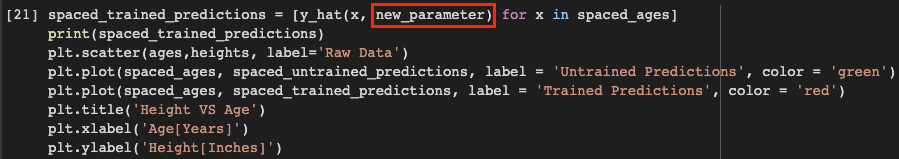
Also anstatt zu verwenden Parameter wir gebrauchen neue_parameter da es den genauen Wert von enthält alfa Ja Beta und speichert es in einer Liste namens spaced_trained_predictions. Dann, wenn wir dafür einen Graphen zeichnen, wir können einen sichtbaren Unterschied sehen und die Genauigkeit hat sich stark erhöht. Deswegen, wir haben das Modell erfolgreich gebaut und trainiert. Beweis dafür sind die Werte von spaced_trained_predictions und die Grafik.
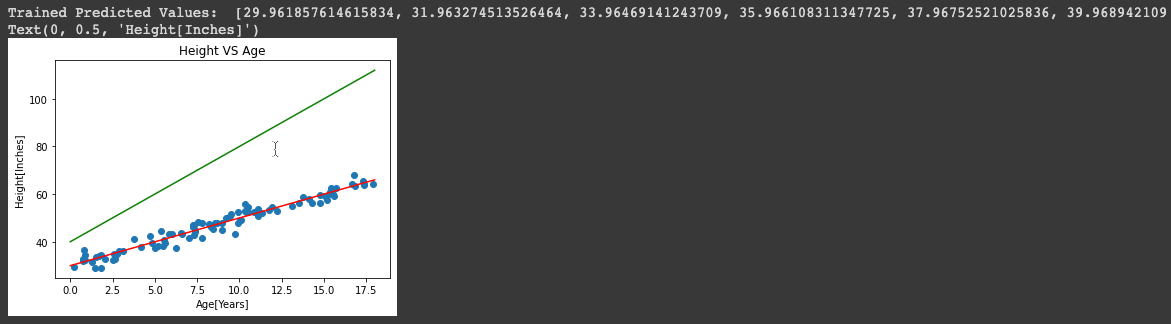
Die Greenline bezieht sich auf die Werte von spaced_untrained_predictions und Redline bezieht sich auf die Werte von spaced_trained_predictions.
5.Machen Sie Vorhersagen zu unsichtbaren Daten:
Mit Hilfe dieses trainierten Modells, jetzt können wir genaue Vorhersagen treffen.
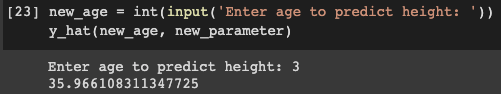
Dann, Wir können sehen, dass wir für jedes bestimmte Alter die mögliche Körpergröße in Zoll finden. Schließlich, wir haben das Modell erfolgreich und mit höchster Präzision trainiert, was ist das Endziel dieses Tutorials.
Als Referenz, Ich habe die eingefügt Link zum Notizbuch du spielst mit ihm. Ich hoffe, eine Verbindung herzustellen LinkedIn auch und teilen Sie Ihre wertvollen Kommentare. Bleiben Sie dran für weitere Blogs dieser Art😊.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





