
Dieser Beitrag wurde im Rahmen der . veröffentlicht Data Science Blogathon
Einführung
um Ihre Daten besser zu verstehen, was bei der weiteren Datenvorverarbeitung hilft. Und Datenvisualisierung ist der Schlüssel, da es das explorative Datenanalyseverfahren rationalisiert und die Daten einfach durch wunderbare Diagramme und Grafiken analysiert.
Inhaltsverzeichnis
- Datenvisualisierung
- Explorative Datenanalyse
- Univariate Analyse
- Kategoriale Daten
- Numerische Daten
- Bivariate Analyse / multivariat
- Numerisch und numerisch
- Numerisch und kategorial
- Kategorisch und kategorisch
- Abschließende Anmerkungen
Datenvisualisierung
Die Datenvisualisierung stellt Text oder numerische Daten in einem visuellen Format dar, was das Verständnis der durch die Daten ausgedrückten Informationen erleichtert. UNS, die Menschen, Wir erinnern uns leichter an Bilder als an lesbaren Text, Python stellt uns daher verschiedene Bibliotheken zur Datenvisualisierung wie Matplotlib zur Verfügung, Seegeboren, verschwörerisch, etc. In diesem Tutorial, Wir werden Matplotlib und Seaborn verwenden, um verschiedene Techniken zum Erkunden von Daten mit verschiedenen Diagrammen durchzuführen.
Explorative Datenanalyse
Hypothesen erstellen, Es ist sehr wichtig, verschiedene Geschäftsannahmen zu testen, während man sich mit jeder Problemstellung des maschinellen Lernens befasst, und dies ist es, was EDA hilft, dies zu erreichen. Es gibt verschiedene Tools und Techniken, um Ihre Daten zu verstehen, und die Grundvoraussetzung ist, dass Sie über Numpy-Kenntnisse für mathematische Operationen und Pandas für die Datenmanipulation verfügen.
Wir werden einen sehr beliebten Titanic-Datensatz verwenden, mit dem jeder vertraut ist und von dem heruntergeladen werden kann hier.
Beginnen wir nun mit der Untersuchung von Daten und dem Studium verschiedener Datenvisualisierungsdiagramme mit unterschiedlichen Datentypen.. Und um einige der Techniken zu demonstrieren, Wir werden auch einen integrierten Datensatz von seaborn als Trinkgelddaten verwenden, der die Trinkgelder erklärt, die jeder Kellner von verschiedenen Kunden erhält..
Beginnen wir mit dem Importieren von Bibliotheken und Laden von Daten
numpy als np importieren
Pandas pd importieren
import matplotlib.pyplot als plt
Seegeboren als sns importieren
aus seegeborenen Import load_dataset
#titanischer Datensatz
data = pd.read_csv("titanic_train.csv")
#Tipps-Datensatz
Tipps = load_dataset("Tipps")
Univariate Analyse
El análisis univariado es la forma más simple de análisis donde exploramos una sola VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern..... Eine univariate Analyse wird durchgeführt, um die Daten besser zu beschreiben. Wir führen univariate Analysen von numerischen und kategorialen Variablen unterschiedlich durch, da der Plot unterschiedliche Graphen verwendet.
Kategoriale Daten
Eine Variable mit textbasierten Informationen wird als kategoriale Variablen bezeichnet. Schauen wir uns mehrere Diagramme an, mit denen wir kategoriale Daten visualisieren können.
1) CountPlot
Countplot es simplemente un gráfico de recuento de frecuencias en forma de BalkengrafikDas Balkendiagramm ist eine visuelle Darstellung von Daten, die rechteckige Balken verwendet, um Vergleiche zwischen verschiedenen Kategorien anzuzeigen. Jeder Balken stellt einen Wert dar, und seine Länge ist proportional zu ihm. Diese Art von Diagramm ist nützlich, um Trends zu visualisieren und zu analysieren, Erleichterung der Interpretation quantitativer Informationen. Es ist in verschiedenen Disziplinen weit verbreitet, wie z.B. Statistiken, Marketing und Forschung, Aufgrund seiner Einfachheit und Effektivität..... Zeichnen Sie die Anzahl für jede Kategorie auf einem separaten Balken. Wenn wir die Zählfunktion von Pandas-Werten in einer beliebigen Spalte verwenden, ist die gleiche visuelle Form der Zählwertfunktion. In unserer Datenzielvariable überlebt es und ist kategorisch, Also lasst uns ein Tally-Diagramm davon zeichnen.
sns.countplot(data['Survived'])
plt.show()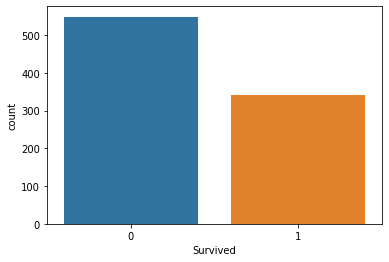
2) KuchendiagrammDas Tortendiagramm, Auch bekannt als Tortendiagramm, ist eine visuelle Darstellung, die das Verhältnis verschiedener Teile zu einem Ganzen zeigt. Es wird häufig in der Statistik verwendet, um die Verteilung kategorialer Daten zu veranschaulichen. Jeder Abschnitt des Diagramms stellt einen Prozentsatz des Gesamtwerts dar., Erleichterung des Vergleichs zwischen Kategorien. Sein klares und prägnantes Design macht es zu einem effektiven Werkzeug für die Präsentation quantitativer Informationen....
Darüber hinaus ist das Kreisdiagramm das gleiche wie das Zähldiagramm., es gibt Ihnen nur zusätzliche Informationen über den Prozentsatz der Präsenz jeder Kategorie in den Daten, was bedeutet, welche Kategorie das Gewicht in den Daten erhält. Schauen wir uns die Spalte Sex an, Wie hoch ist der Prozentsatz der reisenden männlichen und weiblichen Mitglieder?.
data['Sex'].value_counts().plot(kind="pie", autopct="%.2f")
plt.show()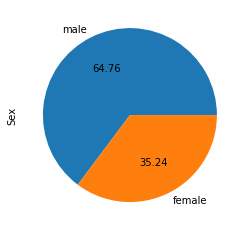
Numerische Daten
Numerische Datenanalyse ist unerlässlich, da das Verständnis der Verteilung von Variablen hilft, die Daten weiter zu verarbeiten. Meistens werden Sie bei den numerischen Daten eine Menge Inkonsistenzen feststellen, untersuchen Sie daher numerische Variablen.
1) Histogramm
Ein Histogramm ist ein Verteilungsdiagramm von numerischen Spaltenwerten. Es erstellt einfach Bins in verschiedenen Wertebereichen und stellt sie dar, wo wir visualisieren können, wie die Werte verteilt sind. Wir können sehen, wo mehr Werte zu finden sind, als positiv, negativ oder in der Mitte (Medien). Werfen wir einen Blick auf die Spalte Alter.
plt.hist(data['Age'], bins=5)
plt.show()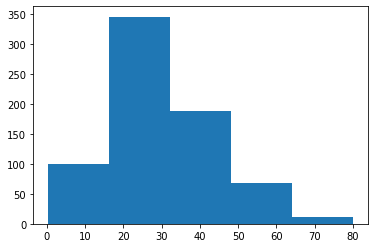
2) Distplot
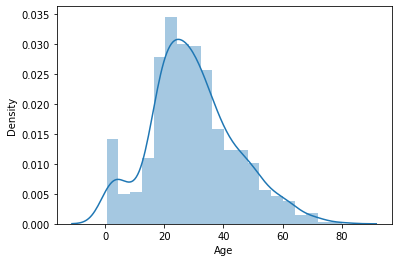
Distplot wird auch als zweites Histogramm bezeichnet, da es sich um eine leicht erweiterte Version des Histogramms handelt.. Distplot gibt uns ein KDE (Schätzung der Kerneldichte) über Histogramm erklärendes PDF (Wahrscheinlichkeitsdichtefunktion), was bedeutet, mit welcher Wahrscheinlichkeit jeder Wert in dieser Spalte vorkommt. Wenn Sie schon einmal Statistik studiert haben, die PDF-Funktion solltest du unbedingt kennen.
sns.distplot(Daten['Alter'])
plt.zeigen()
3) Box-Plot
Boxplot ist eine sehr interessante Handlung, die einfach eine Zusammenfassung von . darstellt 5 Zahlen. Für eine Zusammenfassung von 5 Zahlen, Wir müssen einige Begriffe beschreiben.
- MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird....: Mittelwert in Serie nach Sortierung
- Perzentil: gibt die Anzahl der Werte an, die vor diesem Perzentil vorhanden sind, als, als Beispiel, 50 unter Perzentil 25, so erklärt es die Summe von 50 Werte, die unter dem Perzentil liegen 25
- Minimum und Maximum: das sind keine Minimal- und Maximalwerte, Sie beschreiben vielmehr die untere und obere Grenze der Standardabweichung, die anhand des Interquartilsabstands berechnet wird. (IQR).
IQR = Q3 - Q1
Untere_Grenze = Q1 - 1.5 * IQR
Upper_bounday = Q3 +  1.5 * IQR
Hier sind Q1 und Q3 das erste Quantil (Perzentil 25) und das dritte Quantil (Perzentil 75)
Bivariate Analyse / multivariat
Wir haben mehrere Diagramme untersucht, um einzigartige numerische und kategoriale Daten zu untersuchen. Die bivariate Analyse wird verwendet, wenn wir die Verbindung zwischen 2 verschiedene Variablen und wir müssen es tun, weil, schließlich, Unsere Hauptaufgabe besteht darin, die Verbindung zwischen den Variablen zu untersuchen, um ein leistungsstarkes Modell zu erstellen. Und wenn wir mehr analysieren als 2 Variablen zusammen, bekannt als multivariate Analyse. Wir werden an verschiedenen Graphen für die bivariate und multivariate Analyse arbeiten.
Numerisch und numerisch
Zuerst, Lassen Sie uns die Grafiken untersuchen, wenn beide Variablen numerisch sind.
1) StreudiagrammEin Streudiagramm ist eine visuelle Darstellung, die die Beziehung zwischen zwei numerischen Variablen mithilfe von Punkten auf einer kartesischen Ebene zeigt. Jede Achse stellt eine Variable dar, und die Position jedes Punktes gibt seinen Wert in Bezug auf beide an.. Diese Art von Diagramm ist nützlich, um Muster zu erkennen, Korrelationen und Trends in den Daten, Erleichterung der Analyse und Interpretation quantitativer Zusammenhänge....
Das Zeichnen der Verbindung zwischen zwei Streudiagrammen numerischer Variablen ist ein einfaches Diagramm. Veamos la vinculación entre la cuenta total y la propina proporcionada a través de un AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen.....
sns.scatterplot(tips["total_bill"], tips["tip"])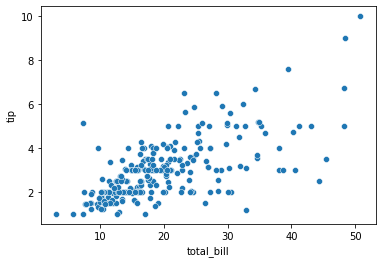
Multivariate Analyse mit Streudiagramm
wir können auch Beziehungen von grafisch darstellen 3 Variablen oder 4 Variablen mit einem Streudiagramm. Angenommen, wir möchten das getrennte Verhältnis von Männern und Frauen mit der bereitgestellten Gesamtrechnung und dem bereitgestellten Trinkgeld ermitteln.
sns.scatterplot(tips["total_bill"], tips["tip"], hue=tips["sex"])
plt.show()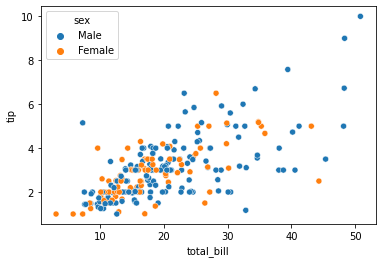
Wir können auch die multivariate Analyse von sehen 4 Variablen mit Streudiagrammen mit Stilargumenten. Angenommen, jetzt, zusammen mit dem Geschlecht, Ich möchte auch wissen, ob der Kunde Raucher war oder nicht, damit wir dies tun können.
sns.scatterplot(tips["total_bill"], tips["tip"], hue=tips["sex"], style=tips['smoker'])
plt.show()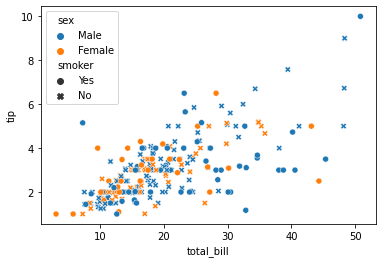
Numerisch und kategorial
Wenn eine Variable numerisch und die andere kategorial ist, Es gibt mehrere Grafiken, die wir für bivariate und multivariate Analysen verwenden können.
1) Balkengrafik
Das Balkendiagramm ist ein einfaches Diagramm, mit dem wir eine kategoriale Variable auf der x-Achse und eine numerische Variable auf der y-Achse darstellen und die Beziehung zwischen beiden Variablen untersuchen können.. Die schwarze Spitze am oberen Rand jedes Balkens zeigt das Konfidenzintervall. Entdecken wir die P-Klasse mit dem Alter.
sns.barplot(data['Pclass'], data['Age'])
plt.show()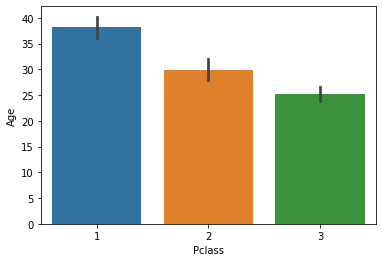
Multivariate Analyse durch Balkendiagramm
Hues Argument ist sehr nützlich und hilft bei der Analyse von mehr als 2 Variablen. Jetzt, zusammen mit der obigen Verlinkung, wir wollen mit geschlecht zu tun haben.
sns.barplot(data['Pclass'], data['Fare'], hue = data["Sex"])
plt.show()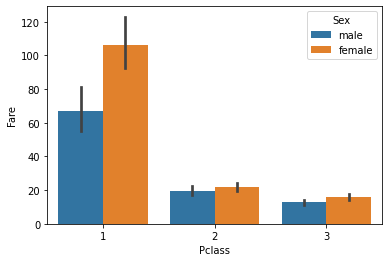
2) Box-Plot
Ya hemos estudiado sobre BoxplotsBox-Diagramme, Auch bekannt als Box- und Whisker-Diagramme, sind statistische Werkzeuge, die die Verteilung eines Datensatzes darstellen. Diese Diagramme zeigen den Median, Quartile und Ausreißer, Ermöglicht die Visualisierung von Datenvariabilität und -symmetrie. Sie sind nützlich für den Vergleich zwischen verschiedenen Gruppen und in der explorativen Analyse, So lassen sich Trends und Muster in den Daten leichter erkennen.... en el análisis univariante anterior. wir können für beide Variablen einen separaten Boxplot zeichnen. Lassen Sie uns das Geschlecht mit dem Alter anhand eines Boxplots untersuchen.
sns.boxplot(data['Sex'], data["Age"])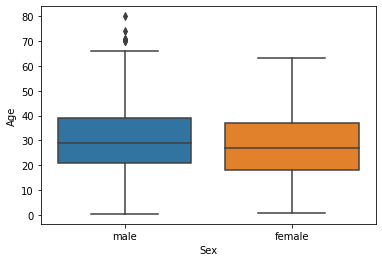
Multivariate Analyse mit Boxplot
Zusammen mit Alter und Geschlecht, mal sehen wer überlebt hat und wer nicht.
sns.boxplot(data['Sex'], data["Age"], data["Survived"])
plt.show()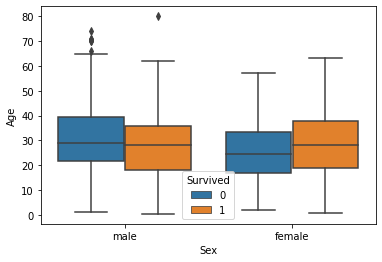
3) Distplot
Distplot erklärt PDF-Funktion durch Schätzung der Kerneldichte. Distplot hat keinen Tonhöhenparameter, aber wir können es schaffen. Angenommen, wir möchten die Wahrscheinlichkeit von Personen mit einer Altersspanne mit Überlebenswahrscheinlichkeit sehen und herausfinden, deren Überlebenswahrscheinlichkeit für die Altersspanne der Sterblichkeitsrate hoch ist.
sns.distplot(data[data['Survived'] == 0]['Age'], hist=False, color="blue")
sns.distplot(data[data['Survived'] == 1]['Age'], hist=False, color="orange")
plt.show()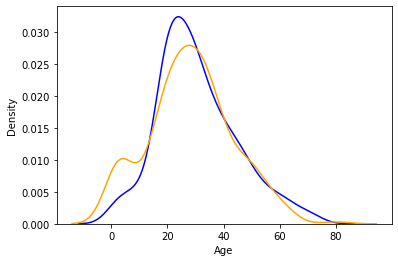
Wie wir sehen können, die grafik ist wirklich sehr interessant. das Blau zeigt die Wahrscheinlichkeit des Sterbens und das orange Diagramm zeigt die Überlebenswahrscheinlichkeit. Wenn wir es beobachten, können wir sehen, dass die Überlebenswahrscheinlichkeit von Kindern größer ist als die des Todes und dass es bei älteren Menschen umgekehrt ist. Diese kleine Analyse sagt manchmal einige wichtige Dinge über die Daten aus und hilft bei der Vorbereitung von Datengeschichten.
Kategorisch und kategorisch
Jetzt werden wir an kategorialen und kategorialen Spalten arbeiten.
1) Heatmapein "Heatmap" ist eine grafische Darstellung, die Farben verwendet, um die Dichte von Daten in einem bestimmten Bereich anzuzeigen. Häufig in der Datenanalyse verwendet, Marketing und Verhaltensstudien, Diese Art der Visualisierung ermöglicht es Ihnen, Muster und Trends schnell zu erkennen. Durch chromatische Variationen, Heatmaps erleichtern die Interpretation großer Informationsmengen, dabei helfen, fundierte Entscheidungen zu treffen....
Wenn Sie jemals eine Pandas-Kreuztabellenfunktion verwendet haben, Heatmap ist nur eine äquivalente visuelle Darstellung davon. Einfach, zeigt an, wie viel Präsenz einer Kategorie in Verbindung mit einer anderen Kategorie im Datensatz vorhanden ist. lass es mich zuerst mit der Kreuztabelle und später mit der Heatmap zeigen.
pd.crosstab(data['Pclass'], data['Survived'])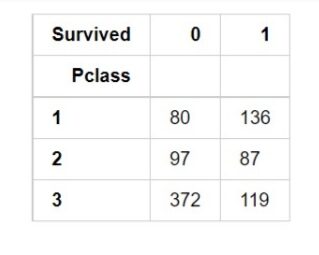
Jetzt, mit der Heatmap, Wir müssen herausfinden, wie viele Menschen überlebt und gestorben sind.
sns.heatmap(pd.crosstab(data['Pclass'], data['Survived']))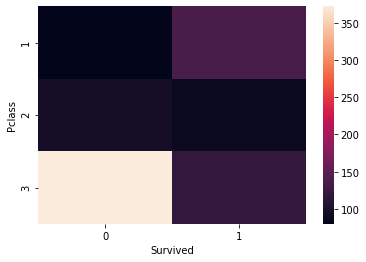
2) Clusterkarte
Wir können auch eine Cluster-Map verwenden, um die Verbindung zwischen zwei kategorialen Variablen zu verstehen. Eine Cluster-Map zeichnet einfach ein Dendrogramm, das die Kategorien äquivalenten Verhaltens zusammen zeigt..
sns.clustermap(pd.crosstab(data['Parch'], data['Survived']))
plt.show()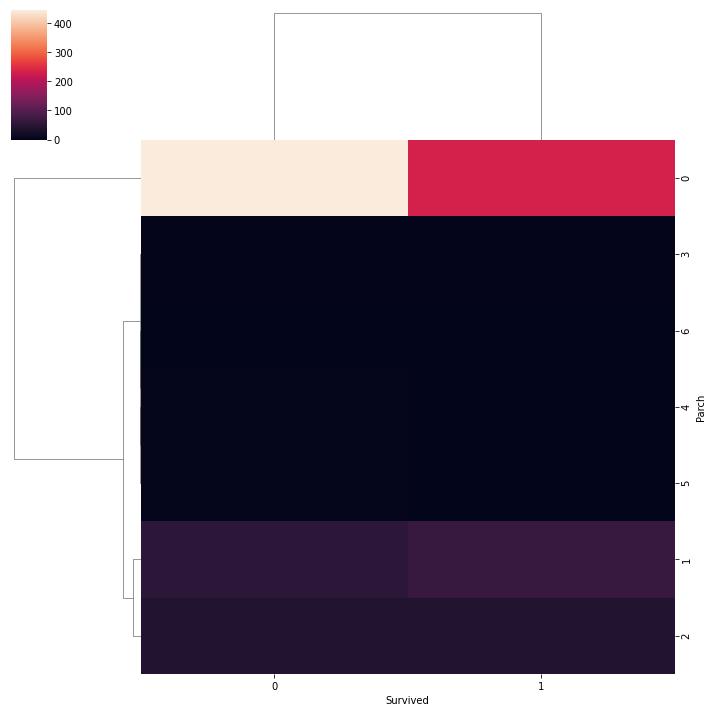
Wenn Sie Clustering-Algorithmen hauptsächlich auf DBSCAN kennen, dann solltest du das Dendrogramm kennen. Dann, Dies sind alles Diagramme, die hauptsächlich bei explorativen Analysen verwendet werden. Es gibt noch ein paar weitere Plots, die Sie als gewalttätigen Plot zeichnen können, Linienmuster, ein gemeinsamer Schuss, der nicht hauptsächlich verwendet wird.
Das komplette Notebook für mehr Übung in EDA und Datenvisualisierung ist in meinen Notebooks von kaggle aktiviert, greife darauf zu hier.
Abschließende Anmerkungen
EDA ist nur ein Schlüssel zum besseren Verständnis und zur besseren Darstellung Ihrer Daten, was, während, hilft Ihnen, ein leistungsfähigeres und allgemeineres Modell zu erstellen. Datenvisualisierung ist einfach durchzuführen EDA, damit andere unsere Analyse leichter verstehen.
Ich hoffe, es war einfach, alle Plots, die wir gezeichnet haben, nachzuholen. Wenn Sie Zweifel haben, Erwähnen Sie es im Kommentarbereich unten. Ich helfe dir gerne.
Über den Autor
Raghav Agrawal
Ich studiere Informatik. Ich mag Data Science und Big Data sehr. Ich liebe es, mit Daten zu arbeiten und neue Technologien zu lernen. Bitte, melde dich gerne bei mir Linkedin.





