
Überblick
- Was ist K steht für Clustering?
- Umsetzung von K steht für Clustering
- WCSS- und Ellbogen-Methode, um die Anzahl der Cluster zu ermitteln
- Python-Implementierung von K bedeutet Clustering
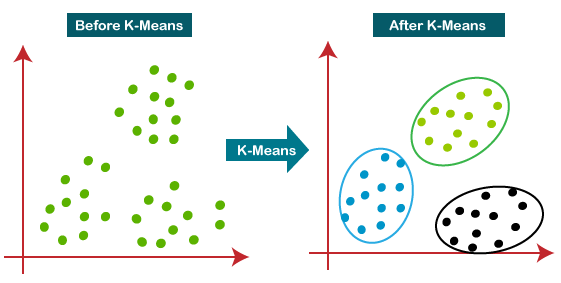
K mean ist einer der beliebtesten unüberwachten maschinellen Lernalgorithmen zur Lösung von Klassifikationsproblemen. K bedeutet, dass die nicht gekennzeichneten Daten in mehrere Gruppen unterteilt werden, sogenannte Cluster, basierend auf ähnlichen Eigenschaften, gängige Muster.
Inhaltsverzeichnis
- Was ist Clustering??
- Was bedeutet der K-Algorithmus?
- Schematische Implementierung von KMeans Clustering
- Wählen Sie die richtige Anzahl von Clustern
- Python-Implementierung
1. Was ist Clustering??
Angenommen, wir haben eine Anzahl N von unmarkierten multivariaten Datensätzen von verschiedenen Tieren wie Hunden, gatos, Vögel, etc. Die Technik zum Aufteilen von Datensätzen in mehrere Gruppen, basierend auf ähnlichen Eigenschaften und Eigenschaften, es heißt Clustering..
Die gebildeten Gruppen werden als Cluster bezeichnet. Die Clustering-Technik wird in mehreren Bereichen eingesetzt, wie Bilderkennung, Spam-Filterung
Clustering wird im Algorithmus von Unüberwachtes LernenUnüberwachtes Lernen ist eine Technik des maschinellen Lernens, die es Modellen ermöglicht, Muster und Strukturen in Daten ohne vordefinierte Beschriftungen zu identifizieren. Durch Algorithmen wie k-means und Hauptkomponentenanalyse, Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, wie z. B. Kundensegmentierung, Anomalieerkennung und Datenkomprimierung. Seine Fähigkeit, verborgene Informationen preiszugeben, macht es zu einem wertvollen Werkzeug in der... im maschinellen Lernen als Multivariate Daten können in mehrere Gruppen unterteilt werden, ohne Vorgesetzten, basierend auf einem gemeinsamen Muster, das in Datensätzen verborgen ist.
2. Was bedeutet der K-Algorithmus?
Der Kmeans-Algorithmus ist ein iterativer Algorithmus, der eine Gruppe von n Datensätzen in k Untergruppen aufteilt / Cluster basierend auf Ähnlichkeit und ihrem mittleren Abstand vom Schwerpunkt dieser Untergruppe / insbesondere gebildet..
K, hier ist die vordefinierte Anzahl von Clustern, die der Algorithmus bildet. Wenn K = 3, bedeutet, dass die Anzahl der Cluster, die aus dem Datensatz gebildet werden, ist 3
Schritte des Mean-K-Algorithmus
Die Funktionsweise des K-Means-Algorithmus wird in den folgenden Schritten erklärt:
Paso 1: Wählen Sie den Wert von K aus, um die Anzahl der zu bildenden Cluster zu bestimmen.
Paso 2: Wählen Sie K zufällige Punkte aus, die als Schwerpunkt fungieren.
Paso 3: Jeden Datenpunkt zuordnen, basierend auf seiner Entfernung von zufällig ausgewählten Punkten (Schwerpunkt), zum nächsten Schwerpunkt / schließen, das die vordefinierten Gruppen bildet.
Paso 4: Platziere einen neuen Schwerpunkt jeder Gruppe.
Paso 5: Schritt wiederholen 3, wodurch jeder Datenpunkt dem neuen nächstgelegenen Schwerpunkt jeder Gruppe neu zugewiesen wird.
Paso 6: Wenn eine Neuzuweisung auftritt, gehe zu Schritt 4; andererseits, gehe zu Schritt 7.
Paso 7: ENDEN
3. Schematische Implementierung von K bedeutet Clustering
PASO 1:Wählen wir die Anzahl k von Clustern, nämlich, K = 2, den Datensatz zu trennen und in verschiedene Cluster zu platzieren. Wir werden einige auswählen 2 zufällige Punkte, die als Zentroide fungieren, um die Gruppe zu bilden.
PASO 2: Jetzt weisen wir jeden Datenpunkt einem AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen.... basierend auf seiner Entfernung zum nächstgelegenen K-Punkt oder Zentrum zu. Dies wird durch Zeichnen eines MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird.... zwischen beiden Zentroiden. Betrachten Sie das folgende Bild:
PASO 3: die Punkte auf der linken Seite der Linie befinden sich in der Nähe des blauen Schwerpunkts und die Punkte auf der rechten Seite der Linie befinden sich in der Nähe des gelben Schwerpunkts. Der linke bildet eine Gruppe mit blauem Schwerpunkt und der rechte mit gelbem Schwerpunkt..
PASO 4:wiederholen Sie den Vorgang ein neuer Schwerpunkt. So wählen Sie die neuen Schwerpunkte, wir finden den neuen Schwerpunkt dieser Schwerpunkte, unten gezeigt:
PASO 5: Dann, wir werden jeden Datenpunkt dem neuen Schwerpunkt neu zuweisen. Wir werden den gleichen vorherigen Vorgang wiederholen (mit einer Mittellinie). Der gelbe Datenpunkt auf der blauen Seite der Medianlinie wird in die blaue Gruppe aufgenommen
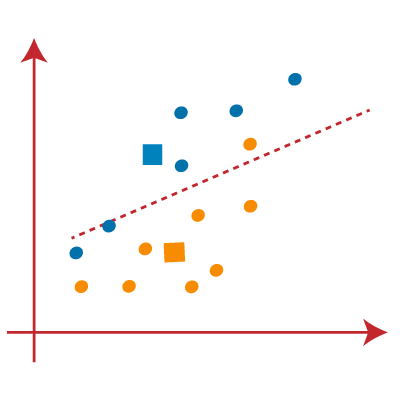
PASO 6: Da die Umverteilung erfolgt ist, Wir wiederholen den vorherigen Schritt zum Finden neuer Schwerpunkte.
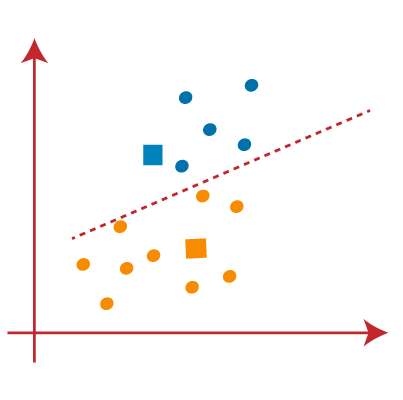
PASO 7: Wir wiederholen den vorherigen Vorgang zur Ermittlung des Schwerpunkts der Schwerpunkte, wie im Folgenden gezeigt.
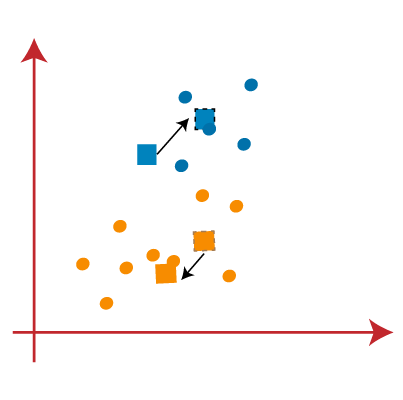
PASO 8: Nach dem Finden der neuen Schwerpunkte, wir werden die Medianlinie erneut zeichnen und die Datenpunkte neu zuweisen, wie in den vorherigen Schritten.
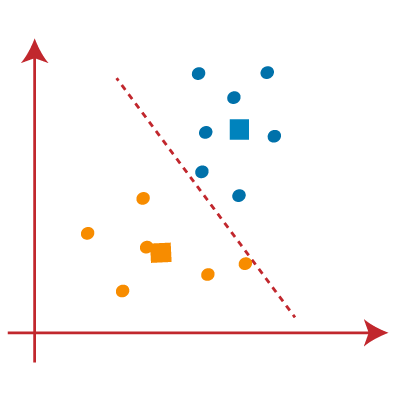
PASO 9: Schließlich, Wir werden Punkte basierend auf der Medianlinie trennen, so dass zwei Gruppen gebildet werden und keine unterschiedlichen Punkte in einer einzigen Gruppe enthalten sind.
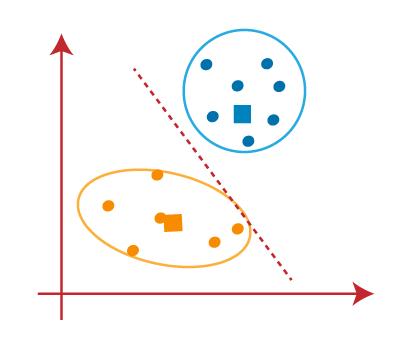
Die letzte Gruppe, die gebildet wird, ist die folgende
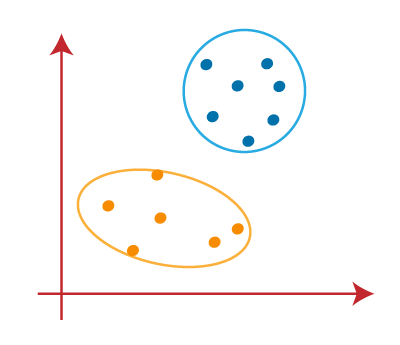
4. Wählen Sie die richtige Anzahl von Clustern
Die Anzahl der Cluster, die wir für den Algorithmus wählen, darf nicht zufällig sein. Jeder einzelne Cluster wird gebildet, indem die mittleren Entfernungen jedes Datenpunkts innerhalb eines Clusters von seinem Schwerpunkt berechnet und verglichen werden.
Wir können die richtige Anzahl von Clustern mithilfe der Summe der Quadrate innerhalb des Clusters bestimmen ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen.... (WCSS).
WCSS Repräsentiert die Summe der Quadrate der Abstände der Datenpunkte in jeder einzelnen Gruppe von ihrem Schwerpunkt.
Die Hauptidee besteht darin, den Abstand zwischen den Datenpunkten und dem Schwerpunkt der Cluster zu minimieren. Der Prozess wird iteriert, bis ein Mindestwert für die Summe der Distanzen erreicht ist.
So finden Sie den optimalen Wert von Clustern, Ellenbogenmethode folgen Sie den folgenden Schritten:
1 Führen Sie die GruppierungDas "Gruppierung" Es handelt sich um ein Konzept, das sich auf die Organisation von Elementen oder Individuen in Gruppen mit gemeinsamen Merkmalen oder Zielen bezieht. Dieses Verfahren wird in verschiedenen Disziplinen eingesetzt, einschließlich Psychologie, Pädagogik und Biologie, um die Analyse und das Verständnis von Verhaltensweisen oder Phänomenen zu erleichtern. Im Bildungsbereich, zum Beispiel, Gruppenbildung kann die Interaktion und das Lernen unter den Schülern verbessern, indem sie die Arbeit fördert.. von K-Means in einem gegebenen Datensatz für verschiedene K-Werte (das geht von 1 al 10).
2 Für jeden Wert von K, berechnet den WCSS-Wert.
3 Zeichnen Sie eine Grafik / Kurve zwischen WCSS-Werten und jeweiliger Clusteranzahl K.
4 Der spitze Krümmungspunkt oder ein Punkt (das sieht aus wie ein Ellenbogengelenk) des Rahmens wie ein Arm, wird als das Beste angesehen / optimaler K-Wert
5. Python-Implementierung
Importieren Sie relevante Bibliotheken
numpy als np importieren
Pandas als pd importieren
importiere statsmodels.api als sm
import matplotlib.pyplot als plt
Seegeboren als sns importieren
sns.set()
aus sklearn.cluster importieren KMeans
Laden der Daten
data = pd.read_csv('Countryclusters.csv')
Daten
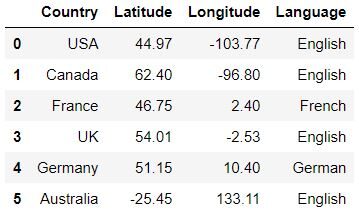
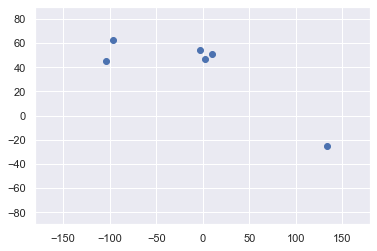
Die Daten grafisch darstellen
plt.streuung(Daten['Längengrad'],Daten['Breitengrad'])
plt.xlim(-180,180)
plt.ylim(-90,90)
plt.zeigen()
Funktion auswählen
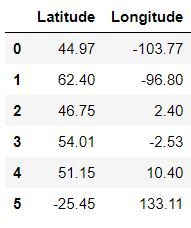
 x = data.iloc[:,1:3] # 1t für Zeilen und zweitens für Spalten
x
Gruppierung
kmeans = KMeans(3)
bedeutet.fit(x)
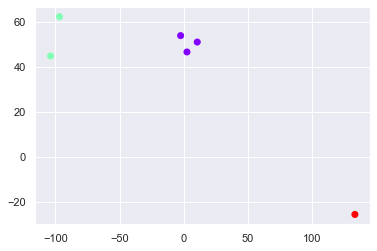
Clustering-Ergebnisse
identifizierte_cluster = kmeans.fit_predict(x)
identifizierte_cluster
Array([1, 1, 0, 0, 0, 2])
data_with_clusters = data.copy()
data_with_clusters['Cluster'] = identifizierte_cluster
plt.streuung(data_with_clusters['Längengrad'],data_with_clusters['Breitengrad'],c=data_with_clusters['Cluster'],cmap='rainbow')
Versuchen Sie es mit einer anderen Methode (zu finden in. Von Gruppen zur Auswahl)
WCSS und Ellenbogenmethode
wcss=[]
für mich in Reichweite(1,7):
kmeans = KMeans(ich)
kmeans.fit(x)
wcss_iter = kmeans.inertia_
wcss.append(wcss_iter)

number_clusters = Bereich(1,7)
plt.plot(number_cluster,WC)
plt.titel('Der Elbow-Titel')
plt.xlabel('Anzahl der Cluster')
plt.ylabel('WCSS')
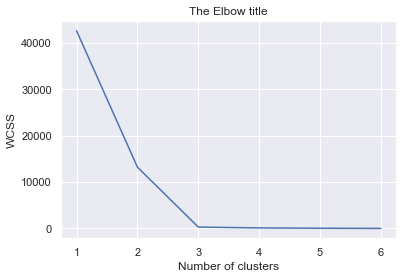
wir können wählen 3 selbstverständlich. Konglomerate, Diese Methode zeigt die gute Anzahl von Clustern.
Damit beende ich diesen Blog.
Hallo allerseits, Namasté
Mein Name ist Pranshu Sharma und ich bin ein Data Science-Enthusiast
Vielen Dank, dass Sie sich Ihre wertvolle Zeit genommen haben, um diesen Blog zu lesen.. Auf Fehler gerne hinweisen (schließlich, ich bin lehrling) und hinterlasse die entsprechenden Kommentare oder hinterlasse einen Kommentar.
Dhanyvaad !!
Rückmeldung:
Email: [E-Mail geschützt]
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





