
Einführung
Zeit ist der wichtigste Faktor bei der Entscheidung, ob ein Unternehmen auf- oder absteigen wird. Aus diesem Grund sehen wir In-Store-Verkäufe und E-Commerce-Plattformen, die sich an Festivals orientieren.. Diese Unternehmen analysieren jahrelange Ausgabendaten, um den besten Zeitpunkt zum Öffnen von Türen zu ermitteln und einen Anstieg der Verbraucherausgaben zu erkennen..
Aber, Wie können Sie, als Datenwissenschaftler, Führen Sie diese Analyse durch? Mach dir keine Sorgen, Du musst keine Zeitmaschine bauen! Die Zeitreihenmodellierung ist eine leistungsstarke Technik, die als Zugang zum Verständnis und zur Vorhersage von Trends und Mustern dient..
Aber auch ein Modell von ZeitreiheEine Zeitreihe ist eine Reihe von Daten, die zu aufeinanderfolgenden Zeitpunkten gesammelt oder gemessen werden, in der Regel in regelmäßigen Zeitabständen. Diese Art der Analyse ermöglicht es Ihnen, Muster zu erkennen, Trends und Zyklen in Daten im Zeitverlauf. Seine Anwendung ist breit gefächert, in Bereichen wie Wirtschaft, Meteorologie und öffentliche Gesundheit, Erleichterung von Vorhersagen und Entscheidungsfindung auf der Grundlage historischer Informationen.... Es hat verschiedene Facetten. Die meisten Beispiele, die wir im Web sehen, befassen sich mit univariaten Zeitreihen. Leider, Anwendungsfälle aus der realen Welt funktionieren nicht so. Es gibt mehrere Variablen im Spiel, und sie alle gleichzeitig zu handhaben, macht einem Data Scientist Mut.
In diesem Artikel, Wir werden verstehen, was eine multivariate Zeitreihe ist und wie man damit umgeht. Wir nehmen auch eine Fallstudie auf und implementieren diese in Python, um Ihnen ein praktisches Verständnis des Themas zu vermitteln..
Inhaltsverzeichnis
- Univariate versus multivariate Zeitreihen
- Univariate Zeitreihen
- Multivariate Zeitreihen
- Verwaltung einer multivariaten Zeitreihe: automatische Vektorregression (WO)
- Warum brauchen wir VAR?
- Stationarität in einer multivariaten Zeitreihe
- Abteilung Zugvalidierung
- Python-Implementierung
1. Univariate versus multivariate Zeitreihen
Dieser Artikel setzt eine gewisse Vertrautheit mit univariaten Zeitreihen voraus, seine Eigenschaften und die verschiedenen Techniken zur Vorhersage. Da sich dieser Artikel auf multivariate Zeitreihen konzentriert, Ich schlage vor, dass Sie die folgenden Artikel lesen, die als gute Einführung in univariate Zeitreihen dienen:
Aber ich gebe Ihnen einen kurzen Überblick darüber, was eine univariate Zeitreihe ist., bevor Sie auf die Details einer multivariaten Zeitreihe eingehen. Schauen wir uns sie einzeln an, um den Unterschied zu verstehen.
1.1 Univariate Zeitreihen
Eine univariate Zeitreihe, wie der Name schon sagt, Es handelt sich um eine Serie mit einem einzigartigen VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... zeitabhängig.
Zum Beispiel, Schauen Sie sich den Beispieldatensatz unten an, der aus den Temperaturwerten besteht (stündlich), während der letzten 2 Jahre. Hier, Temperatur ist die abhängige Variable (zeitabhängig).
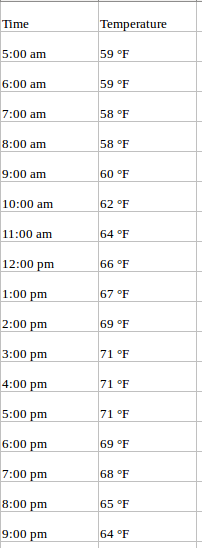
Wenn wir gebeten werden, die Temperatur für die nächsten Tage vorherzusagen, wir werden uns die vergangenen Werte ansehen und versuchen, ein Muster zu messen und zu extrahieren. Wir würden feststellen, dass die Temperatur morgens und nachts niedriger ist, während es am Nachmittag seinen Höhepunkt erreicht. Was ist mehr, wenn Sie Daten der letzten Jahre haben, Sie werden feststellen, dass es in den Monaten November bis Januar kälter ist, während es von April bis Juni vergleichsweise heißer ist.
Solche Beobachtungen werden uns helfen, zukünftige Werte vorherzusagen.. Ist Ihnen aufgefallen, dass wir nur eine Variable verwenden (die Temperatur des letzten 2 Jahre)? Deswegen, das nennt man Analyse / Univariate Zeitreihenprognose.
1.2 Multivariate Zeitreihen (MTS)
Eine multivariate Zeitreihe hat mehr als eine zeitabhängige Variable. Jede Variable hängt nicht nur von ihren vergangenen Werten ab, es hat auch eine gewisse Abhängigkeit von anderen Variablen. Diese Abhängigkeit wird verwendet, um zukünftige Werte zu prognostizieren. Klingt kompliziert? Lassen Sie mich erklären.
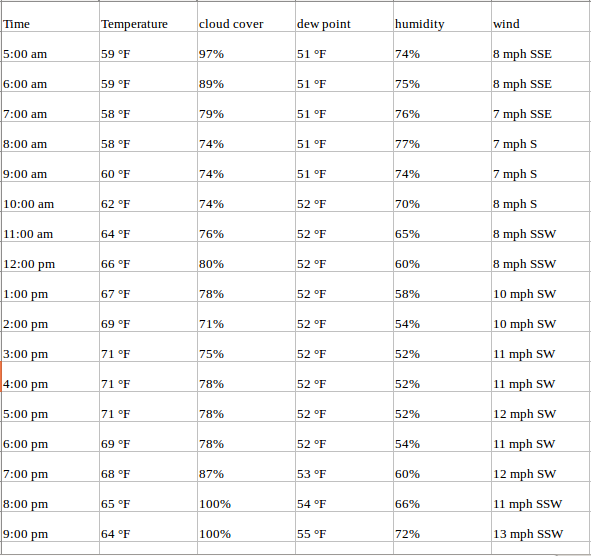
Betrachten Sie das obige Beispiel. Nehmen wir nun an, dass unser Datensatz den Prozentsatz der Schweißbildung enthält, Taupunkt, Windgeschwindigkeit, der Prozentsatz der Wolkenbedeckung, etc. zusammen mit dem Temperaturwert der letzten zwei Jahre. In diesem Fall, mehrere Variablen müssen berücksichtigt werden, um die Temperatur optimal vorherzusagen. Eine Reihe wie diese würde in die Kategorie der multivariaten Zeitreihen fallen.. Unten ist eine Illustration davon:
Jetzt, da wir verstehen, wie eine multivariate Zeitreihe aussieht, Lassen Sie uns verstehen, wie wir damit eine Prognose erstellen können.
2. Verwaltung einer multivariaten Zeitreihe – WO
In diesem Abschnitt, Ich stelle Ihnen eine der am häufigsten verwendeten Methoden zur multivariaten Zeitreihenprognose vor: Automatische Vektorregression (WO).
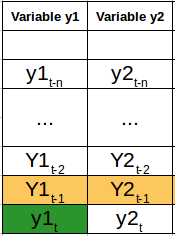
In einem VAR-Modell, jede Variable ist eine lineare Funktion der Vergangenheitswerte von sich selbst und der Vergangenheitswerte aller anderen Variablen. Um das besser zu erklären, Ich werde ein einfaches visuelles Beispiel verwenden:
Wir haben zwei Variablen, y1 und y2. Wir müssen den Wert dieser beiden Variablen zum Zeitpunkt t . vorhersagen, aus den angegebenen Daten der n übergebenen Werte. Vereinfachen, Ich habe den Lag-Wert als angenommen 1.
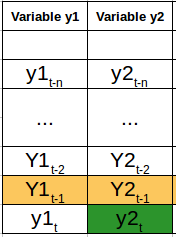
Um y1 . zu berechnen
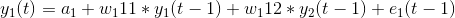
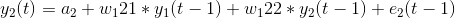
Hier,
- a1 und a2 sind die konstanten Terme,
- w11, w12, w21 und w22 sind die Koeffizienten,
- e1 und e2 sind die Fehlerterme
Diese Gleichungen ähneln der Gleichung eines AR-Prozesses. Da der AR-Prozess für univariate Zeitreihendaten verwendet wird, Zukunftswerte sind nur Linearkombinationen Ihrer eigenen Vergangenheitswerte. Betrachten Sie den AR-Prozess (1):
Ja
In diesem Fall, Wir haben nur eine Variable – Ja, ein konstanter Begriff – ein, ein Fehlerbegriff – e, und ein Koeffizient – w. Um die mehreren variablen Terme in jeder Gleichung für VAR . unterzubringen, wir werden Vektoren verwenden. Wir können die Gleichungen schreiben (1) Ja (2) wie folgt:
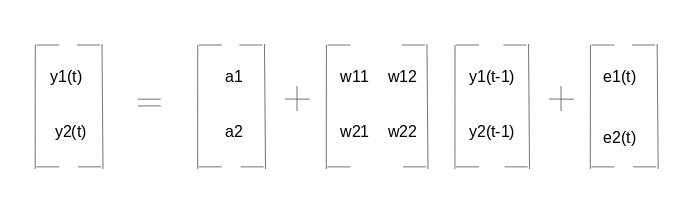
Die beiden Variablen sind y1 und y2, gefolgt von einer Konstante, eine Koeffizientenmetrik, ein Verzögerungswert und eine Fehlermetrik. Dies ist die Vektorgleichung für einen VAR-Prozess (1). Für einen VAR-Prozess (2), ein weiterer Vektorterm wird für die Zeit hinzugefügt (t-2) auf die Gleichung, um für Lags zu verallgemeinern:
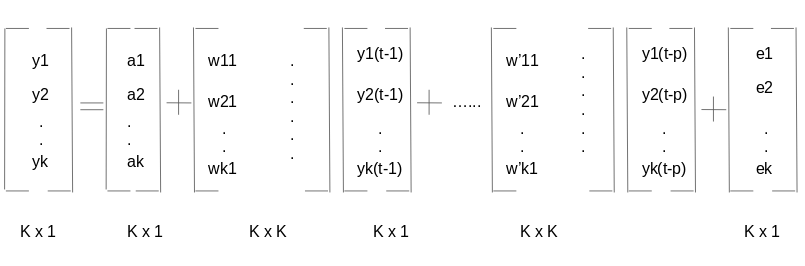
Die obige Gleichung repräsentiert einen VAR-Prozess (P) mit Variablen y1, y2… yk. Das gleiche kann geschrieben werden als:
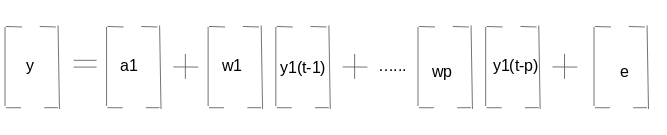
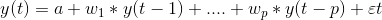
Der BegriffT in der Gleichung repräsentiert den multivariaten Vektor weißes Rauschen. Für eine multivariate Zeitreihe, eT muss ein stetiger Zufallsvektor sein, der die folgenden Bedingungen erfüllt:
- E (eT) = 0
Der Erwartungswert für den Fehlervektor ist 0 - E (et1, et2‚) =12
Erwarteter Wert von εT y εT‚ist die Standardabweichung der Reihe
3. Warum brauchen wir VAR?
Erinnern Sie sich an das Beispiel der Vorhersage gemäßigter Temperaturen, die wir zuvor gesehen haben. Es kann argumentiert werden, dass sie als multiple univariate Reihe behandelt wird. Wir können es mit einfachen univariaten Prognosemethoden wie AR . lösen. Da das Ziel darin besteht, die Temperatur vorherzusagen, wir können einfach die anderen Variablen entfernen (außer Temperatur) und passe ein Modell an die verbleibende univariate Reihe an.
Eine andere einfache Idee besteht darin, die Werte jeder Serie einzeln mit den uns bereits bekannten Techniken vorherzusagen.. Dies würde die Arbeit extrem erleichtern!! Dann, Warum sollte ich eine andere Prognosetechnik lernen?? Ist dieses Thema nicht schon kompliziert genug?
Aus den obigen Gleichungen (1) Ja (2), Es ist klar, dass jede Variable die vergangenen Werte jeder Variablen verwendet, um die Vorhersagen zu treffen. Im Gegensatz zu AR, VAR ist in der Lage, die Beziehung zwischen mehreren Variablen zu verstehen und zu nutzen.. Dies ist nützlich, um das dynamische Verhalten der Daten zu beschreiben und liefert auch bessere Prognoseergebnisse.. Was ist mehr, Die Implementierung von VAR ist so einfach wie die Verwendung jeder anderen univariaten Technik (was Sie im letzten Abschnitt sehen werden).
4. Stationarität einer multivariaten Zeitreihe
Aus dem Studium des univariaten Konzepts wissen wir, dass uns eine stationäre Zeitreihe, In den meisten Fällen, ein besserer Satz von Vorhersagen. Wenn Sie mit dem Konzept der Stationarität nicht vertraut sind, zuerst diesen Artikel lesen: Eine sanfte Einführung in den Umgang mit instationären Zeitreihen.
Um zusammenzufassen, für eine gegebene univariate Zeitreihe:
Ja
Die Reihe heißt stationär, wenn der Wert von | C | <1. Jetzt, Erinnere dich an die Gleichung unseres VAR-Prozesses:
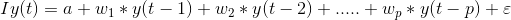
Notiz: I ist die Identitätsmatrix.
Stellen Sie die Gleichung in Bezug auf dar Verzögerungsoperatoren, haben:
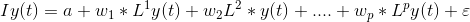
Nimm alle Bedingungen und
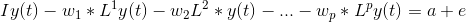
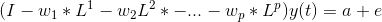
Der Koeffizient von y
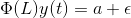
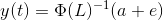
Damit eine Reihe stationär ist, die Eigenwerte von | Phi (L)-1| muss kleiner sein als 1 im Modul. Dies mag angesichts der Anzahl der Variablen in der Ableitung kompliziert erscheinen. Diese Idee wurde im folgenden Video an einem einfachen Zahlenbeispiel erklärt. Ich empfehle Ihnen, es sich anzusehen, um Ihr Verständnis zu festigen:
Ähnlich dem Augmented Dickey-Fuller-Test für univariate Reihen, Wir haben den Johansen-Test, um die Stationarität aller multivariaten Zeitreihendaten zu überprüfen. Wie Sie den Test durchführen, erfahren Sie im letzten Abschnitt dieses Artikels.
5. Abteilung Zugvalidierung
Wenn Sie zuvor mit univariaten Zeitreihendaten gearbeitet haben, Lernen Sie die Zugvalidierungssets kennen. Die Idee beim Erstellen eines Validierungssatzes besteht darin, die Leistung des Modells zu analysieren, bevor es verwendet wird, um Vorhersagen zu treffen..
Das Erstellen eines Validierungssets für Zeitreihenprobleme ist schwierig, da wir die Zeitkomponente berücksichtigen müssen. Man kann die nicht direkt verwenden train_test_split Ö k-fach Validierung, da dies das Muster in der Serie unterbricht. Das Validierungsset muss unter Berücksichtigung der Datums- und Uhrzeitwerte erstellt werden.
Angenommen, wir müssen die Temperatur vorhersagen, Taupunkt, der Prozentsatz der Wolken, etc. für die nächsten zwei Monate mit Daten der letzten zwei Jahre. Eine mögliche Methode besteht darin, die Daten der letzten zwei Monate beiseite zu halten und das Modell in der 22 verbleibende Monate.
Sobald das Modell trainiert wurde, wir können es verwenden, um Vorhersagen über den Validierungssatz zu treffen. Basierend auf diesen Vorhersagen und den tatsächlichen Werten, Wir können überprüfen, wie gut das Modell funktioniert hat und bei welchen Variablen das Modell nicht so gut funktioniert hat. Und um die endgültige Vorhersage zu treffen, den vollständigen Datensatz verwenden (Kombinieren Sie Zug- und Validierungssets).
6. Python-Implementierung
In diesem Abschnitt, Wir implementieren das Vector AR-Modell in einen Spielzeugdatensatz. Ich habe dafür den Luftqualitätsdatensatz verwendet und Sie können ihn herunterladen unter hier.
#erforderliche Pakete importieren
Pandas als pd importieren
import matplotlib.pyplot als plt
%matplotlib inline

#Daten lesen
df = pd.read_csv("AirQualityUCI.csv", parse_dates=[[Datum, Uhrzeit]])

#Überprüfen Sie die dtypes
df.dtypes
Date_Time-Objekt
CO(GT)            int64
PT08.S1(CO)       int64
NMHC(GT)          int64
C6H6(GT)          int64
PT08.S2(NMHC)     int64
NOx(GT)           int64
PT08.S3(NOx)      int64
NO2(GT)           int64
PT08.S4(NO2)      int64
PT08.S5(O3)       int64
T int64
RH int64
AH int64
dtyp: Objekt
Der Datentyp der Datum (und Uhrzeit die Spalte ist Objekt und wir müssen es ändern in Datum (und Uhrzeit. Was ist mehr, um die Daten aufzubereiten, Wir brauchen die IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht.... Haben Datum (und Uhrzeit. Folgen Sie den folgenden Befehlen:
df[Datum_Uhrzeit] = pd.to_datetime(df.Datum_Uhrzeit , format="%d/%m/%Y %H.%M.%S")
data = df.drop([Datum_Uhrzeit], Achse=1)
data.index = df.Date_Time
Der nächste Schritt besteht darin, mit den fehlenden Werten umzugehen. Da die fehlenden Werte in den Daten durch einen Wert ersetzt werden -200, wir müssen den fehlenden Wert mit einer besseren Zahl imputieren. Bedenken Sie: wenn der aktuelle Taupunktwert fehlt, wir können mit Sicherheit davon ausgehen, dass er nahe am Wert der vorherigen Stunde liegen wird. Macht Sinn, Wahrheit? Hier, ich werde unterstellen -200 mit dem vorherigen Wert.
Sie können den Wert durch den Durchschnitt einiger vorheriger Werte ersetzen, oder der Wert zur gleichen Zeit am Vortag (du kannst deine teilen (S) Idee (S) fehlende Werte im Kommentarbereich unten unterstellen).
#Behandlung von fehlenden Werten
cols = data.columns
für j in Spalten:
    für mich in Reichweite(0,len(Daten)):
       wenn Daten[J][ich] == -200:
           Daten[J][ich] = Daten[J][i-1]

#Überprüfung der Stationarität
von statsmodels.tsa.vector_ar.vecm import coint_johansen
#da der Test nur für funktioniert 12 Variablen, Ich habe zufällig fallen gelassen
#in der nächsten Iteration, Ich würde einen anderen fallen lassen und die Eigenwerte überprüfen
johan_test_temp = data.drop([ CO(GT)'], Achse=1)
coint_johansen(johan_test_temp,-1,1).eig
Unten ist das Testergebnis:
Array([ 0.17806667,  0.1552133 ,  0.1274826 ,  0.12277888,  0.09554265,
        0.08383711,  0.07246919,  0.06337852,  0.04051374,  0.02652395,
        0.01467492,  0.00051835])
Jetzt können wir fortfahren und das Validierungsset erstellen, das zum Modell passt, und die Leistung des Modells testen:
#Erstellen des Zug- und Validierungssets
Zug = Daten[:int(0.8*(len(Daten)))]
gültig = Daten[int(0.8*(len(Daten))):]

#passt das modell
aus statsmodels.tsa.vector_ar.var_model import VAR

Modell = VAR(endog = Zug)
model_fit = model.fit()

# Vorhersage zur Validierung machen
Vorhersage = model_fit.forecast(model_fit.y, Schritte = len(gültig))
Vorhersagen haben die Form einer Matrix, wobei jede Liste die Vorhersagen in der Zeile darstellt. Wir werden dies in ein vorzeigbares Format umwandeln.
#Konvertieren von Vorhersagen in Datenrahmen
pred = pd.DataFrame(Index=Bereich(0,len(Vorhersage)),Spalten=[cols])
für j im Bereich(0,13):
    für mich in Reichweite(0, len(Vorhersage)):
       pred.iloc[ich][J] = Vorhersage[ich][J]

#rmse überprüfen
für ich in cols:
    drucken(rmse-Wert für, ich, ist : ', sqrt(mittlere quadratische Fehler(pred[ich], gültig[ich])))
Vorherige Codeausgabe:
Effektivwert für CO(GT) ist :  1.4200393103392812
Effektivwert für PT08.S1(CO) ist :  303.3909208229375
Effektivwert für NMHC(GT) ist :  204.0662895081472
Effektivwert für C6H6(GT) ist :  28.153391799471244
Effektivwert für PT08.S2(NMHC) ist :  6.538063846286176
Effektivwert für NOx(GT) ist :  265.04913993413805
Effektivwert für PT08.S3(NOx) ist :  250.7673347152554
Effektivwert für NO2(GT) ist :  238.92642219826683
Effektivwert für PT08.S4(NO2) ist :  247.50612831072633
Effektivwert für PT08.S5(O3) ist :  392.3129907890131
Effektivwert für T is :  383.1344361254454
Effektivwert für RH ist :  506.5847387424092
Effektivwert für AH ist :  8.139735443605728
Nach dem Testen im Validierungsset, lass uns das Modell an den kompletten Datensatz anpassen
#letzte Vorhersagen machen
Modell = VAR(gerade = Daten)
model_fit = model.fit()
yhat = model_fit.forecast(model_fit.y, Schritte=1)
drucken(yhat)
Abschließende Anmerkungen
Bevor Sie mit diesem Artikel beginnen, die Idee, mit einer multivariaten Zeitreihe zu arbeiten, schien entmutigend zu sein. Es ist ein komplexes Thema, Nehmen Sie sich also Zeit, um die Details zu verstehen. Der beste Weg zu lernen ist zu üben, Daher hoffe ich, dass die obige Python-Implementierung für Sie hilfreich ist.
Ich empfehle Ihnen, diesen Ansatz für einen Datensatz Ihrer Wahl zu verwenden. Dies wird Ihr Verständnis dieses komplexen, aber sehr nützlichen Themas weiter festigen.. Wenn Sie Anregungen oder Fragen haben, teile es im Kommentarbereich.





