
Spark ist eine Datenanalyse-Engine, die hauptsächlich für die Verarbeitung großer Datenmengen verwendet wird. Es ermöglicht uns, Daten und Rechenoperationen auf mehrere Cluster zu verteilen, um eine signifikante Leistungssteigerung zu verstehen.
Heute, Spark wird von Datenwissenschaftlern aufgrund seiner verschiedenen Vorteile gegenüber anderen Datenverarbeitungstools bevorzugt. Al usar Spark, die Kosten für die Abholung, Datenspeicherung und -übertragung nimmt ab. Wenn wir an einem realen Problem arbeiten, wir haben wahrscheinlich große Datenmengen zu verarbeiten. Deswegen, die verschiedenen Engines, die als Hadoop . vertrieben werden, Funke, etc. werden zu den wichtigsten Werkzeugen im Data-Science-Ökosystem.
PySpark
PySpark ist ein Datenanalysetool, das von Apache SparkApache Spark ist eine Open-Source-Datenverarbeitungs-Engine, die die schnelle und effiziente Analyse großer Informationsmengen ermöglicht. Sein Design basiert auf dem Speicher, Dies optimiert die Leistung im Vergleich zu anderen Batch-Verarbeitungstools. Spark wird häufig in Big-Data-Anwendungen verwendet, Maschinelles Lernen und Echtzeitanalysen, Dank seiner Benutzerfreundlichkeit und... Community zur Verwendung von Python in Verbindung mit Spark. Es ermöglicht uns, mit RDD (Belastbarer verteilter Datensatz)RDD (Belastbarer verteilter Datensatz) ist eine grundlegende Abstraktion in Apache Spark, die eine effiziente Verarbeitung großer Datenmengen ermöglicht. Es zeichnet sich durch seine Fähigkeit aus, fehlertolerant zu sein, Aktivieren der Wiederherstellung verlorener Daten durch Neuerstellen von Partitionen. RDDs sind unveränderlich, Erleichterung der Parallelisierung von Abläufen und Verbesserung der Leistung beim verteilten Rechnen. Seine Verwendung ist für die Datenanalyse unerlässlich.. und DataFrames in Python. PySpark verfügt über zahlreiche Funktionen, die es zu einem erstaunlichen Framework machen und wenn es um den Umgang mit großen Datenmengen geht, PySpark bietet uns eine schnelle Verarbeitung in Echtzeit, Flexibilität, In-Memory-Computing und verschiedene andere Funktionen. Es ist eine Python-Bibliothek zur Verwendung von Spark, die die Einfachheit der Python-Sprache mit der Effizienz von Spark kombiniert.
Pyspark-Datenrahmen
Ein DataFrame ist eine verteilte Sammlung von Daten in Zeilen unter benannten Spalten. In einfachen Worten, Wir können sagen, dass es dasselbe ist wie eine Tabelle in einem DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten.... oder eine Excel-Tabelle mit Spaltenüberschriften. DataFrames sind in erster Linie darauf ausgelegt, eine umfangreiche Sammlung strukturierter oder halbstrukturierter Daten zu verarbeiten.
In diesem Artikel, wir werden das besprechen 10 PySpark-Funktionen, die für die effiziente Datenanalyse strukturierter Daten am nützlichsten und wesentlich sind.
Wir verwenden Google Colab als IDE für diese Datenanalyse.
Zuerst müssen wir PySpark auf Google Colab installieren. Danach, Wir importieren das Modul pyspark.sql und erstellen eine SparkSession, die ein Spark SQL API-Einstiegspunkt ist.
#pyspark installieren
!pip installieren pyspark
#pyspark importieren
pyspark importieren

#Sparksessio importieren
aus pyspark.sql importieren SparkSession

#ein Sparksession-Objekt erstellen und appName bereitstellen
spark=SparkSession.builder.appName("pysparkdf").getOrCreate()
Dieses SparkSession-Objekt interagiert mit Spark SQL-Funktionen und -Methoden. Jetzt, Lassen Sie uns einen Spark-DataFrame erstellen, indem wir eine CSV-Datei lesen. Wir verwenden einen einfachen Datensatz, nämlich Nährwerte von 80 Getreideprodukte erhältlich bei Kaggle.
#Erstellen eines Datenrahmens mit Spark-Objekt durch Lesen der CSV-Datei
df = Spark.read.option("Header", "Stimmt").csv("/content/cereal.csv")
#Zeige df erstellt nach oben 10 Reihen
df.show(10)
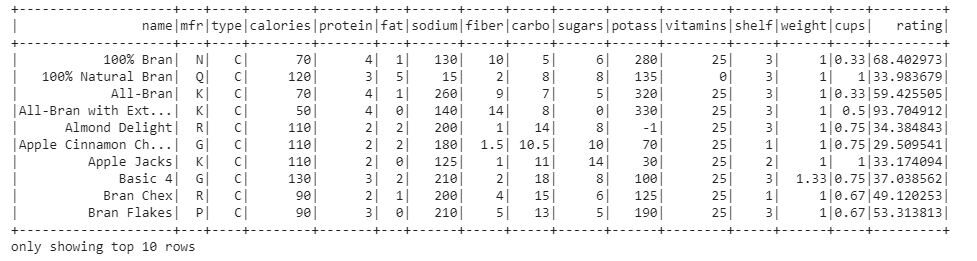
Dies ist der Datenrahmen, den wir für die Datenanalyse verwenden. Jetzt, Lassen Sie uns das Schema des DataFrame drucken, um mehr über den Datensatz zu erfahren.
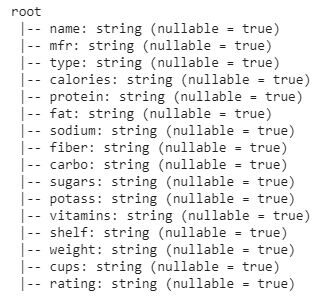
Der DataFrame besteht aus 16 Funktionen oder Spalten. Jede Spalte enthält Werte vom Typ string.
Fangen wir mit den Funktionen an:
- Bitte auswählen(): Die Auswahlfunktion hilft uns, eine Teilmenge ausgewählter Spalten aus dem gesamten Datenrahmen anzuzeigen, wir müssen nur die gewünschten Spaltennamen übergeben. Drucken wir drei beliebige Spalten des Datenrahmens mit auswählenDer Befehl "AUSWÄHLEN" ist in SQL von grundlegender Bedeutung, Wird zum Abfragen und Abrufen von Daten aus einer Datenbank verwendet. Ermöglicht das Angeben von Spalten und Tabellen, Filtern von Ergebnissen mithilfe von Klauseln wie "WO" und Bestellung mit "SORTIEREN NACH". Seine Vielseitigkeit macht es zu einem unverzichtbaren Werkzeug für die Datenmanipulation und -analyse, Erleichterung der effizienten Beschaffung spezifischer Informationen.... ().
df.select('Name', 'MFR', 'Bewertung').zeigen(10)
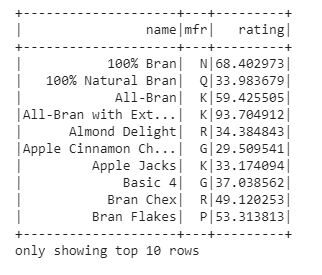
Am Ausgang, wir haben die Teilmenge des Datenrahmens mit drei Namensspalten, mfr, Bewertung.
- mitSpalte (): Die Funktion withColumn wird verwendet, um eine Spalte zu manipulieren oder eine neue Spalte mit der vorhandenen Spalte zu erstellen. Es ist eine Transformationsfunktion, Wir können auch den Datentyp jeder vorhandenen Spalte ändern.
Im DataFrame-Schema, Wir haben gesehen, dass alle Spalten vom Typ string sind. Ändern wir den Datentyp der Kalorienspalte in eine ganze Zahl.
df.withColumn("Kalorien",df['Kalorien'].werfen("Ganze Zahl")).printSchema()
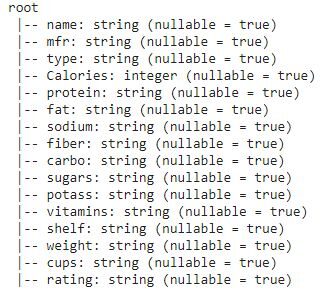
Im Schema, Wir können sehen, dass die Spalte Kaloriendatentyp in den Integer-Typ geändert wurde.
- gruppiere nach(): Die groupBy-Funktion wird verwendet, um die Daten in Gruppen in DataFrame zu sammeln und ermöglicht es uns, Aggregatfunktionen an den gruppierten Daten auszuführen. Dies ist eine sehr häufige Datenanalyseoperation, die der groupBy-Klausel in SQL ähnelt.
Lassen Sie uns die Anzahl jedes Getreides herausfinden, das im Datensatz vorhanden ist.
df.groupBy("Name", "Kalorien").zählen().zeigen()
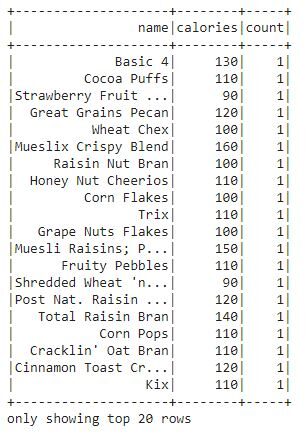
- Sortieren nach (): Die orderBy-Funktion wird verwendet, um den gesamten Datenrahmen basierend auf der bestimmten Spalte im Datenrahmen zu sortieren. Sortieren von Zeilen im Datenrahmen basierend auf Spaltenwerten. Standardmäßig, ist aufsteigend sortiert.
Analysieren wir den Datenrahmen basierend auf der Proteinspalte des Datensatzes.
df.orderBy("Protein").zeigen()
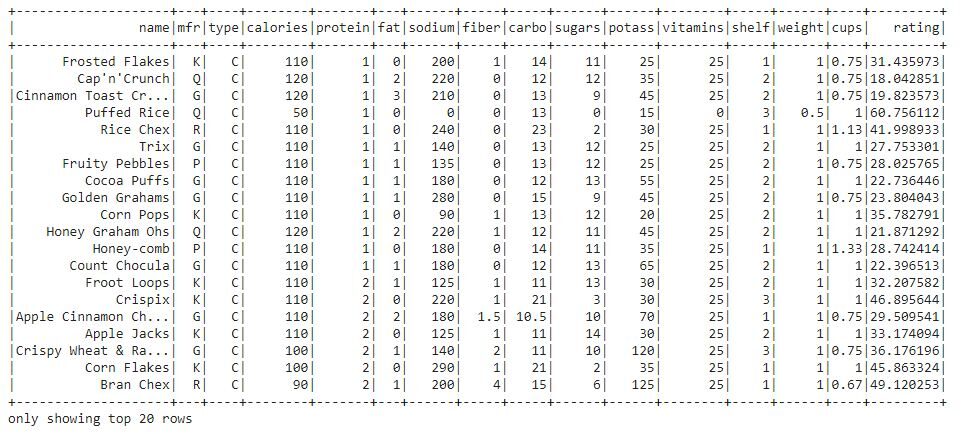
Wir können sehen, dass der gesamte Datenrahmen basierend auf der Proteinspalte geordnet ist.
- auseinander brechen(): Die Spaltung () Wird verwendet, um eine Datenrahmen-String-Spalte in mehrere Spalten aufzuteilen. Diese Funktion wird mit Hilfe von withColumn . auf den Datenrahmen angewendet () und wählen Sie ().
Die Spalte mit dem Datenrahmennamen enthält Werte in zwei Zeichenfolgenwörtern. Teilen wir die Namensspalte aus dem Leerraum zwischen zwei Zeichenfolgen in zwei Spalten auf.
fropm pyspark.sql.functions import split
df1 = df.mitSpalte('Name1', Teilt(df['Name'], " ").getItem(0))
        .mitSpalte('Name2', Teilt(df['Name'], " ").getItem(1))
df1.select("Name", "Name1", "Name2").zeigen()
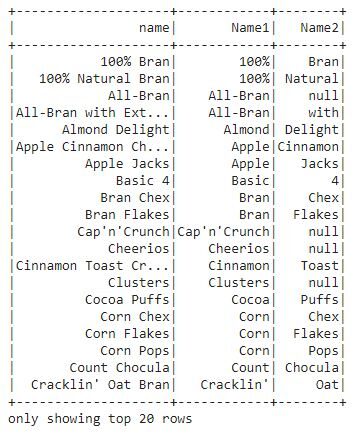
In dieser Ausgabe, Wir können sehen, dass die Namensspalte in Spalten unterteilt ist.
- beleuchtet(): Die Funktion lit wird verwendet, um dem Datenrahmen eine neue Spalte hinzuzufügen, die Literale oder einen konstanten Wert enthält.
Lass uns eine Spalte hinzufügen „Aufnahmemenge“ die einen konstanten Wert für jedes der Getreide zusammen mit dem Namen des jeweiligen Getreides enthält.
aus pyspark.sql.functions importieren lit
df2 = df.select(col("Name"),zündete("75 gm").alias("Aufnahmemenge"))
df2.show()
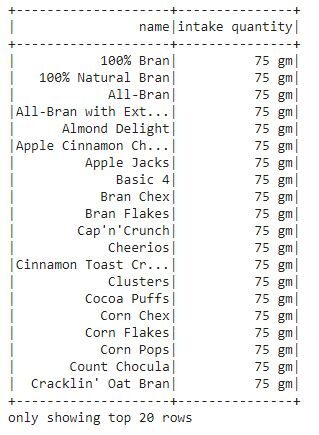
Am Ausgang, Wir können sehen, dass eine neue Spalte "eingenommene Menge" erstellt wird, die die aufgenommene Menge jedes Getreides enthält.
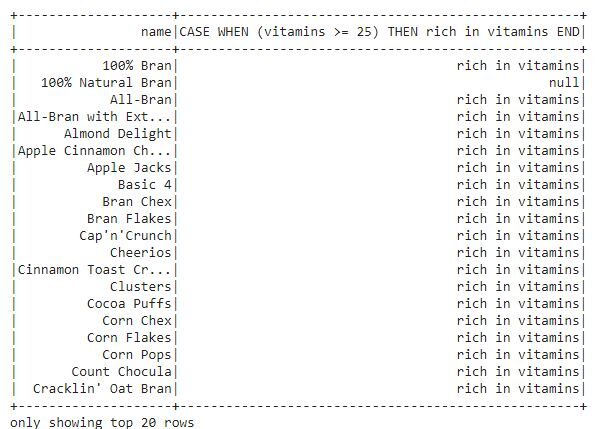
- Wenn(): Wenn die Funktion verwendet wird, um die Ausgabe basierend auf der bestimmten Bedingung anzuzeigen. Werten Sie die bereitgestellte Bedingung aus und geben Sie dann die Werte entsprechend zurück. Es ist eine SQL-Funktion, die PySpark unterstützt, um mehrere Bedingungen in einer Sequenz zu überprüfen und den Wert zurückzugeben. Diese Funktion funktioniert ähnlich wie if-then-else- und switch-Anweisungen.
Schauen wir uns vitaminreiche Cerealien an.
aus pyspark.sql.functions importieren, wenn
df.select("Name", Wenn(df.vitamine >= "25", "reich an Vitaminen")).zeigen()
- Filter(): Die Filterfunktion wird verwendet, um Daten in Zeilen basierend auf bestimmten Spaltenwerten zu filtern. Zum Beispiel, Wir können Cerealien filtern, die Kalorien gleich haben 100.
aus pyspark.sql.functions Importfilter
df.filter(df.kalorien == "100").zeigen()
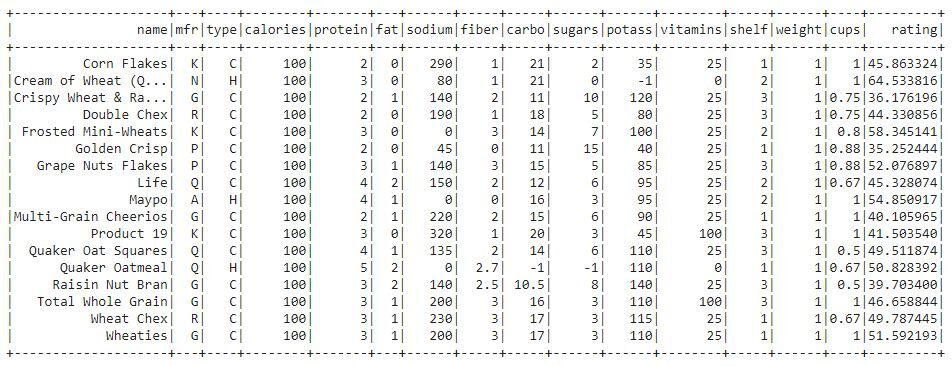
In dieser Ausgabe, Wir können sehen, dass die Daten nach den Getreidesorten gefiltert werden, die 100 Kalorien.
- ist Null () / isNotNull (): Diese beiden Funktionen werden verwendet, um herauszufinden, ob im DataFrame Nullwerte vorhanden sind. Es ist die wichtigste Funktion für die Datenverarbeitung. Es ist das Hauptwerkzeug für die Datenbereinigung.
Lassen Sie uns herausfinden, ob im Datensatz Nullwerte vorhanden sind.
#isNotNull()
aus pyspark.sql.functions-Import *
#Daten nach Nullwerten filtern
df.filter(df.name.isNotNull()).zeigen()
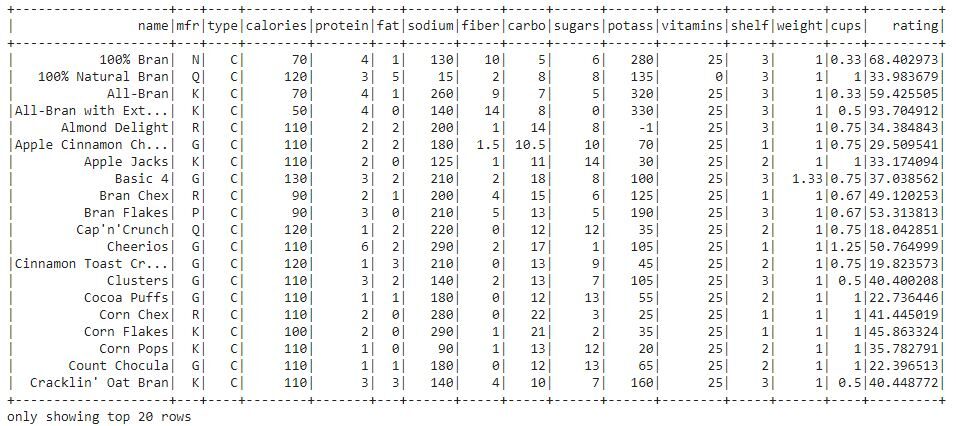
In diesem Datensatz sind keine Nullwerte vorhanden. Deswegen, der gesamte Datenrahmen wird angezeigt.
Es ist null():
df.filter(df.name.isNull()).zeigen()
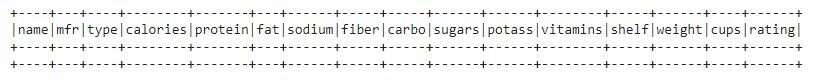
Nochmal, keine Nullwerte. Deswegen, ein leerer Datenrahmen wird angezeigt.
In diesem Blog, wir haben die besprochen 9 weitere nützliche Funktionen für eine effiziente Datenverarbeitung. Diese PySpark-Funktionen sind die Kombination aus Python- und SQL-Sprachen.
Danke fürs Lesen. Bitte lassen Sie es mich wissen, wenn es Kommentare oder Feedback gibt.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





