
Überblick
- Erhalten Sie eine Einführung in die logistische Regression mit R und Python
- Die logistische Regression ist ein beliebter Klassifizierungsalgorithmus, der verwendet wird, um ein binäres Ergebnis vorherzusagen.
- Es gibt mehrere Metriken, um ein logistisches Regressionsmodell zu bewerten, als Matrix der Verwirrung, Kurve AUC-ROC, etc.
Einführung
Jeden Algorithmus für maschinelles Lernen funktioniert am besten unter bestimmten Bedingungen. Stellen Sie sicher, dass Ihr Algorithmus den Annahmen entspricht / Anforderungen sorgt für überlegene Leistung. Kein Algorithmus kann in irgendeiner Bedingung verwendet werden. Zum Beispiel: Haben Sie jemals versucht, zu verwenden? lineare Regression in einem VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... kategorial abhängig? Versuche es erst gar nicht! Denn Sie werden nicht geschätzt, wenn Sie extrem niedrige Werte der angepassten R²- und F-Statistik erhalten.
jedoch, in solchen Situationen, Sie sollten versuchen, Algorithmen wie Logistische Regression zu verwenden, Entscheidungsbäume, SVM, Zufälliger Wald, etc. Für einen schnellen Überblick über diese Algorithmen, Ich empfehle zu lesen: Grundlagen des maschinellen Lernalgorithmus.
Mit diesem Beitrag, Ich vermittle Ihnen nützliches Wissen über die logistische Regression in R. Sobald Sie die lineare Regression beherrschen, das ist der natürliche nächste schritt auf deiner reise. Es ist auch leicht zu erlernen und umzusetzen, aber Sie müssen die Wissenschaft hinter diesem Algorithmus kennen.
Ich habe versucht, diese Konzepte so einfach wie möglich zu erklären. Lasst uns beginnen.
Projekt zur Anwendung der logistischen RegressionProblemstellungHR Analytics revolutioniert die Arbeitsweise von HR-Abteilungen, führt zu höherer Effizienz und insgesamt besseren Ergebnissen. Los recursos humanos han estado utilizando la AnalyseAnalytics bezieht sich auf den Prozess des Sammelns, Messen und analysieren Sie Daten, um wertvolle Erkenntnisse zu gewinnen, die die Entscheidungsfindung erleichtern. In verschiedenen Bereichen, wie Business, Gesundheit und Sport, Analysen können Muster und Trends erkennen, Prozesse optimieren und Ergebnisse verbessern. Der Einsatz fortschrittlicher Werkzeuge und statistischer Techniken ist unerlässlich, um Daten in anwendbares und strategisches Wissen umzuwandeln.... im Laufe der Jahre. Aber trotzdem, die Zusammenstellung, Die Datenverarbeitung und -analyse erfolgte weitgehend manuell und, Angesichts der Natur der Dynamik der Personalabteilung und der KPIKennzahlen, o Wichtige Leistungsindikatoren, Dabei handelt es sich um Kennzahlen, die von Organisationen verwendet werden, um ihren Erfolg beim Erreichen bestimmter Ziele zu bewerten. Diese Indikatoren ermöglichen es Ihnen, den Fortschritt zu überwachen und fundierte Entscheidungen zu treffen. Es gibt verschiedene Arten von KPIs, die je nach Branche und den strategischen Zielen des Unternehmens variieren kann. Die korrekte Umsetzung ist unerlässlich, um die Effizienz und Effektivität der Abläufe zu verbessern.... der Personalabteilung, der Fokus hat sich auf die Humanressourcen beschränkt. Deswegen, Es ist überraschend, dass die Personalabteilungen so spät im Spiel die Nützlichkeit von maschinellem Lernen erkannt haben. Dies ist eine Gelegenheit, Predictive Analytics zu testen, um Mitarbeiter zu identifizieren, die am ehesten befördert werden. |
Was ist logistische Regression??
Logistische Regression ist a Klassifizierungsalgorithmus. Wird verwendet, um ein binäres Ergebnis vorherzusagen (1/0, Jawohl / Nein, Wahr / Gefälscht) gegeben eine Menge unabhängiger Variablen. Um ein binäres Ergebnis darzustellen / kategorisch, wir verwenden Dummy-Variablen. Sie können sich die logistische Regression auch als Sonderfall der linearen Regression vorstellen, wenn die Ergebnisvariable kategorial ist., wobei wir den Logarithmus der Wahrscheinlichkeiten als abhängige Variable verwenden. In einfachen Worten, prognostiziert die Eintrittswahrscheinlichkeit eines Ereignisses durch Anpassen der Daten an eine Logit-Funktion.
Herleitung der logistischen Regressionsgleichung
Die logistische Regression ist Teil einer größeren Klasse von Algorithmen, die als verallgemeinertes lineares Modell bekannt sind. (glm). In 1972, Nelder und Wedderburn schlugen dieses Modell vor, um ein Mittel zur Verwendung der linearen Regression für Probleme bereitzustellen, die nicht direkt für die Anwendung der linearen Regression geeignet waren.. Eigentlich, schlug eine Klasse verschiedener Modelle vor (lineare Regression, ANOVA, Giftregression, etc.) das beinhaltete die logistische Regression als Sonderfall.
Die Grundgleichung des verallgemeinerten linearen Modells lautet:
g(E(Ja)) = α + βx1 + x2
Hier, g () ist die Linkfunktion, E (Ja) ist der Erwartungswert der Zielvariablen und α + βx1 + γx2 ist der lineare Prädiktor (ein, B, γ vorhergesagt werden). Die Rolle der Linkfunktion ist „Verknüpfung“ der Erwartungswert von y zum linearen Prädiktor.
Wichtige Punkte
- GLM geht nicht von einer linearen Beziehung zwischen abhängigen und unabhängigen Variablen aus. Aber trotzdem, nimmt eine lineare Beziehung zwischen der Linkfunktion und den unabhängigen Variablen im Logit-Modell an.
- Die abhängige Variable muss nicht normalverteilt sein.
- Verwendet kein OLS (Gewöhnliche kleinste Quadrate) para la estimación de ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten..... jedoch, verwendet Maximum-Likelihood-Schätzung (MLE).
- Fehler müssen unabhängig, aber nicht normalverteilt sein.
Lassen Sie uns anhand eines Beispiels mehr verstehen:
Wir erhalten ein Muster von 1000 Kunden. Wir müssen die Wahrscheinlichkeit vorhersagen, dass ein Kunde kauft (Ja) eine bestimmte Zeitschrift oder nicht. Wie du siehst, wir haben eine kategoriale Ergebnisvariable, Wir werden logistische Regression verwenden.
Um mit der logistischen Regression zu beginnen, Ich werde zuerst die einfache lineare Regressionsgleichung schreiben, wobei die abhängige Variable in eine Verknüpfungsfunktion eingeschlossen ist:
g(Ja) = βo + B(Alter) ---- (ein)
Notiz: Um das Verständnis zu erleichtern, he considerado ‚Alter‘ als unabhängige Variable.
In der logistischen Regression, es geht uns nur um die Wahrscheinlichkeit der abhängigen Variablen des Ergebnisses (Erfolg oder Misserfolg). Wie oben beschrieben, g () ist die Linkfunktion. Diese Funktion wird durch zwei Dinge hergestellt: Erfolgswahrscheinlichkeit (P) und Ausfallwahrscheinlichkeit (1-P). p muss die folgenden Kriterien erfüllen:
- Es sollte immer positiv sein (seit p> = 0)
- Es muss immer kleiner als gleich sein 1 (seit p <= 1)
Jetzt, wir werden diese einfach erfüllen 2 Bedingungen und kommen Sie zum Kern der logistischen Regression. So stellen Sie die Linkfunktion ein, wir werden g bezeichnen () mit ‚P‘ anfangs und schließlich werden wir diese Funktion ableiten.
Da die Wahrscheinlichkeit immer positiv sein muss, wir werden die lineare Gleichung in Exponentialform setzen. Für jeden Steigungswert und jede abhängige Variable, der Exponent dieser Gleichung wird niemals negativ sein.
p = exp(βo + B(Alter)) = e^(βo + B(Alter)) ------- (B)
Damit die Wahrscheinlichkeit kleiner ist als 1, wir müssen p durch eine Zahl teilen, die größer ist als p. Dies kann einfach durch:
p = exp(βo + B(Alter)) / exp(βo + B(Alter)) + 1 = e^(βo + B(Alter)) / e^(βo + B(Alter)) + 1 ----- (C)
Verwenden von (ein), (B) Ja (C), wir können die Wahrscheinlichkeit neu definieren als:
p = e^y/ 1 + e^y --- (D)
wo p ist die Erfolgswahrscheinlichkeit. Dies (D) ist die Logit-Funktion
Wenn p die Erfolgswahrscheinlichkeit ist, 1-p ist die Ausfallwahrscheinlichkeit, die geschrieben werden kann als:
q = 1 - p = 1 - (e^y / 1 + e^y) --- (e)
wo q ist die Ausfallwahrscheinlichkeit
Durch Teilen, (D) / (e), wir erhalten,
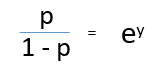
Nach der Aufnahme auf beiden Seiten, wir erhalten,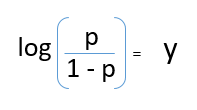
Protokoll (P / 1-P) ist die Linkfunktion. Die logarithmische Transformation der Ergebnisgröße erlaubt es uns, einen nichtlinearen Zusammenhang linear zu modellieren.
Nach Einsetzen des Wertes von y, wir werden bekommen:
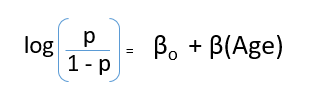
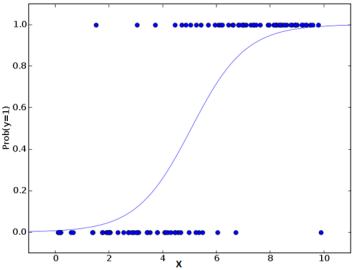
Dies ist die Gleichung, die in der logistischen Regression verwendet wird. Hier (P / 1-P) ist der seltsame Grund. Wenn der Logarithmus des ungeraden Verhältnisses als positiv bestimmt wird, die Erfolgswahrscheinlichkeit ist immer höher als 50%. Unten sehen Sie ein typisches Logistikmodelldiagramm. Sie können sehen, dass die Wahrscheinlichkeit nie unterschreitet 0 und darüber 1.
Leistung des logistischen Regressionsmodells
Um die Leistung eines logistischen Regressionsmodells zu bewerten, Wir müssen einige Metriken berücksichtigen. Unabhängig vom Werkzeug (SAS, R, Python) in dem ich arbeiten würde, immer gucken:
1. AIC (Akaike Informationskriterien) – Die analoge Metrik des adjustierten R2 in der logistischen Regression ist AIC. AIC ist das Anpassungsmaß, das das Modell für die Anzahl der Koeffizienten des Modells bestraft. Deswegen, Wir bevorzugen immer das Modell mit einem Mindestwert von AIC.
2. Nullabweichung und Restabweichung – Die Nullabweichung gibt die Antwort an, die von einem Modell mit nichts anderem als einem Schnittpunkt vorhergesagt wird. Verringern Sie den Wert, besseres Modell. Die Restabweichung gibt die von einem Modell vorhergesagte Antwort beim Hinzufügen unabhängiger Variablen an. Verringern Sie den Wert, besseres Modell.
3. Verwirrung Matrix: Es ist nichts anderes als eine tabellarische Darstellung der tatsächlichen Werte gegenüber den prognostizierten.. Dies hilft uns, die Genauigkeit des Modells zu finden und eine Überanpassung zu vermeiden.. So sieht das aus:
 Quelle: (Stecker – n – Spielstand)
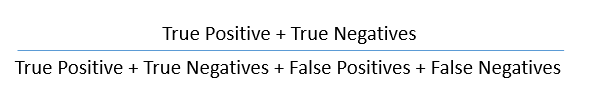
Sie können die berechnen Präzision Ihres Modells mit:
Aus der Konfusionsmatrix, Spezifität und Sensitivität können wie unten dargestellt abgeleitet werden:
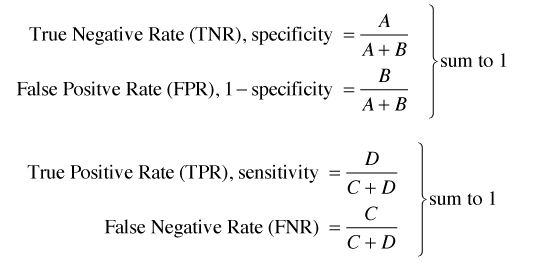
Spezifität und Sensitivität spielen bei der Ableitung der ROC-Kurve eine entscheidende Rolle..
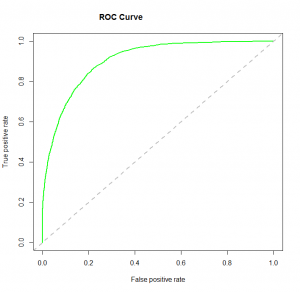
4. ROC-Kurve: Die Betriebscharakteristik des Empfängers (ROC) fasst die Leistung des Modells zusammen, indem es die Kompromisse zwischen der Rate der wahren positiven Ergebnisse bewertet (Empfindlichkeit) und die False-Positive-Rate (1 Spezifität). ROC . grafisch darstellen, es ist ratsam, p . anzunehmen> 0.5 da es uns mehr um die Erfolgsquote geht. ROC fasst die Vorhersagekraft für alle möglichen Werte von p . zusammen> 0.5. Die Fläche unter der Kurve (AUC), Gerufen IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht.... Präzision (EIN) oder Konkordanzindex, ist eine perfekte Leistungsmetrik für die ROC-Kurve. Je größer die Fläche unter der Kurve, desto besser ist die Vorhersagekraft des Modells. Unten ist eine Beispiel-ROC-Kurve. Der ROC eines perfekten Vorhersagemodells hat TP gleich 1 und FP gleich 0. Diese Kurve berührt die obere linke Ecke des Diagramms..
Notiz: Für Modellleistung, Sie können auch die Wahrscheinlichkeitsfunktion betrachten. Es wird so genannt, weil es die Werte der Koeffizienten auswählt, die die Wahrscheinlichkeit der Erklärung der beobachteten Daten maximieren. Zeigt eine gute Anpassung an, wenn sich der Wert eins nähert, und eine schlechte Anpassung der Daten, wenn sich ihr Wert null nähert.
Logistisches Regressionsmodell in R und Python
R-Code ist unten angegeben, aber wenn Sie ein Python-Benutzer sind, Hier ist ein erstaunliches Codefenster zum Erstellen Ihres logistischen Regressionsmodells. Jupyter muss nicht geöffnet werden, hier kannst du alles machen:
Verfügbarkeit berücksichtigen, Dieses Modell habe ich in unserer Übungsaufgabe gebaut: der Dressify-Datensatz. Sie können es herunterladen hier.
Ohne sich mit Feature Engineering zu befassen, Hier ist das einfache Skript für das logistische Regressionsmodell:
einstellen('C:/Users/manish/Desktop/dressdata')
#load data
train <- lesen.csv('Train_Old.csv')
#create training and validation data from given data
install.packages('caTools')
Bücherei(caTools)
set.seed(88)
Teilt <- probe.split(train$empfohlen, Splitverhältnis = 0.75)
#get training and test data
dresstrain <- Teilmenge(Bahn, split == WAHR)
Kleidertest <- Teilmenge(Bahn, teilen == FALSCH)
#logistic regression model
model <- glm (Empfohlen ~ .-ID, Daten = Dresstrain, Familie = Binomial)
Zusammenfassung(Modell)
Vorhersagen <- Vorhersagen(Modell, Typ="Antwort")
#confusion matrix
table(dresstrain$empfohlen, Vorhersagen > 0.5)
#ROCR Curve
library(ROCR)
ROCRpred <- Vorhersage(Vorhersagen, dresstrain$empfohlen)
ROCRperf <- Leistung(ROCRpred, ''tpr',''fpr')
Handlung(ROCRperf, colorize = WAHR, text.adj = c(-0.2,1.7))
#plot glm
library(ggplot2)
ggplot(kleiderkette, aes(x=Bewertung, y=Empfohlen)) + geom_point() +
stat_smooth(Methode="glm", Familie="Binomial-", se = FALSCH)
Diese Daten erfordern viel Bereinigung und Feature-Engineering. Der Umfang dieses Artikels beschränkte mich darauf, das Beispiel auf die Konstruktion des logistischen Regressionsmodells zu konzentrieren.. Diese Daten sind erhältlich üben. Ich empfehle Ihnen, an diesem Problem zu arbeiten. Es gibt viel zu lernen.
Abschließende Anmerkungen
In diesem Stadium, Sie kennen bereits die Wissenschaft hinter der logistischen Regression. Ich habe oft gesehen, dass Leute die Verwendung dieses Algorithmus kennen, ohne Kenntnisse über seine Kernkonzepte zu haben. Ich habe mein Bestes versucht, diesen Teil so einfach wie möglich zu erklären. Das obige Beispiel zeigt nur das Skelett der Verwendung der logistischen Regression in R. Bevor Sie sich dieser Phase wirklich nähern, Sie müssen Ihre entscheidende Zeit in das Feature-Engineering investieren.
Was ist mehr, Ich empfehle Ihnen, an dieser Reihe von Problemen zu arbeiten. Du würdest Dinge erforschen, mit denen du vielleicht noch nie konfrontiert warst.
Habe ich etwas wichtiges verpasst? Findest du diesen Artikel hilfreich? Teile deine Meinung / Gedanken im Kommentarbereich unten.





