
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
Maschine. Es ist inspiriert von der Funktionsweise eines menschlichen Gehirns und, Daher, ist ein Satz neuronaler Netzalgorithmen, der versucht, die Funktionsweise eines menschlichen Gehirns zu imitieren und aus Erfahrungen zu lernen.
In diesem Artikel, Lassen Sie uns lernen, wie ein rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen.. und wie es sich verbessert, um die besten Vorhersagen zu treffen.
Inhaltsverzeichnis
- Neuronale Netze und ihre Komponenten
- Perzeptron und mehrschichtiges Perzeptron
- Schrittweise Arbeit des neuronalen Netzes
- Rückvermehrung und wie sie funktioniert
- Kurz zu den Aktivierungsfunktionen
Künstliche neuronale Netze und ihre Komponenten
Neuronale Netze ist ein computergestütztes Lernsystem, das ein Netzwerk von Funktionen verwendet, um eine Dateneingabe von einem Weg in eine gewünschte Ausgabe zu verstehen und zu übersetzen, normalerweise in anderer Form. Das Konzept des künstlichen neuronalen Netzes wurde von der Humanbiologie und der Art und Weise inspiriert, wie Neuronen des menschlichen Gehirns arbeiten zusammen, um die Eingaben der menschlichen Sinne zu verstehen.
In einfachen Worten, Neuronale Netze sind eine Reihe von Algorithmen, die versuchen, Muster zu erkennen, Datenbeziehungen und Informationen durch den Prozess, der inspiriert ist und wie das Gehirn funktioniert / Menschliche Biologie.
Komponenten (Bearbeiten) / Neuronale Netzwerkarchitektur
Ein einfaches neuronales Netz besteht aus drei Komponenten :
- EingabeebeneDas "Eingabeschicht" bezieht sich auf die Anfangsebene in einem Datenanalyseprozess oder in neuronalen Netzwerkarchitekturen. Seine Hauptfunktion besteht darin, Rohinformationen zu empfangen und zu verarbeiten, bevor sie von nachfolgenden Schichten transformiert werden. Im Kontext des maschinellen Lernens, Die richtige Konfiguration der Eingabeschicht ist entscheidend, um die Effektivität des Modells zu gewährleisten und seine Leistung bei bestimmten Aufgaben zu optimieren....
- Versteckter Umhang
- AusgabeschichtDas "Ausgabe-Layer" ist ein Konzept, das im Bereich der Informationstechnologie und des Systemdesigns verwendet wird. Es bezieht sich auf die letzte Schicht eines Softwaremodells oder einer Architektur, die für die Präsentation der Ergebnisse für den Endbenutzer verantwortlich ist. Diese Schicht ist entscheidend für die Benutzererfahrung, Da es eine direkte Interaktion mit dem System und die Visualisierung der verarbeiteten Daten ermöglicht....
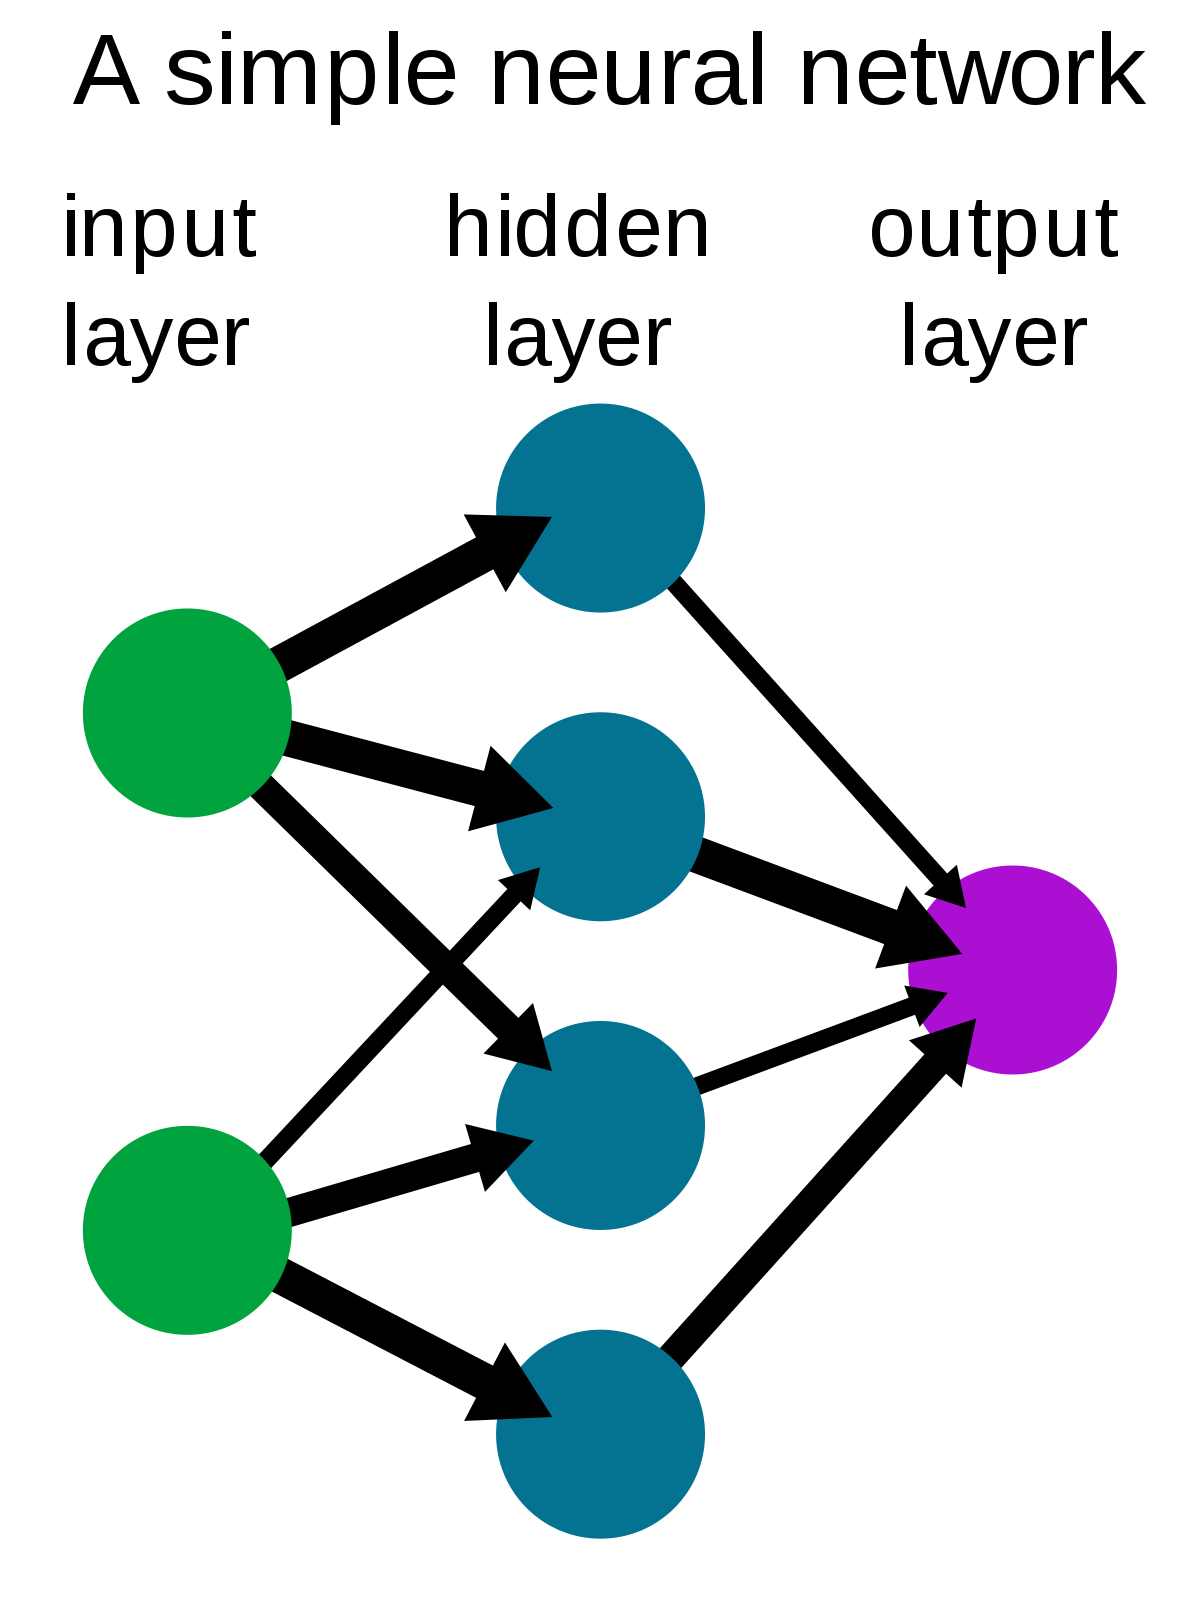
Quelle: Wikipedia
Eingabeebene: Auch als Eingabeknoten bekannt, sind die eingänge / Informationen von der Außenwelt, die dem Modell zur Verfügung gestellt werden, um zu lernen und Schlussfolgerungen zu ziehen. Die Eingabeknoten geben die Informationen an die nächste Schicht weiter, nämlich, versteckte Schicht.
Versteckter Umhang: Die versteckte Schicht ist der Satz von Neuronen, in dem alle Berechnungen mit den Eingabedaten durchgeführt werden. In einem neuronalen Netz kann es beliebig viele versteckte Schichten geben. Das einfachste Netzwerk besteht aus einer einzelnen versteckten Schicht.
Ausgabeschicht: Die Ausgabeschicht ist die Ausgabe / Modellschlussfolgerungen aus allen durchgeführten Berechnungen. Es kann einen oder mehrere Knoten in der Ausgabeschicht geben. Wenn wir ein binäres Klassifizierungsproblem haben, das KnotenNodo ist eine digitale Plattform, die die Verbindung zwischen Fachleuten und Unternehmen auf der Suche nach Talenten erleichtert. Durch ein intuitives System, Ermöglicht Benutzern das Erstellen von Profilen, Erfahrungen austauschen und Zugang zu Stellenangeboten erhalten. Der Fokus auf Zusammenarbeit und Networking macht Nodo zu einem wertvollen Werkzeug für diejenigen, die ihr berufliches Netzwerk erweitern und Projekte finden möchten, die mit ihren Fähigkeiten und Zielen übereinstimmen.... Abfahrtsort ist 1, aber bei Mehrklassenklassifizierung, Ausgabeknoten können mehr sein als 1.
Perzeptron und mehrschichtiges Perzeptron
Perzeptron ist eine einfache Form eines neuronalen Netzes und besteht aus einer einzigen Schicht, in der alle mathematischen Berechnungen durchgeführt werden.
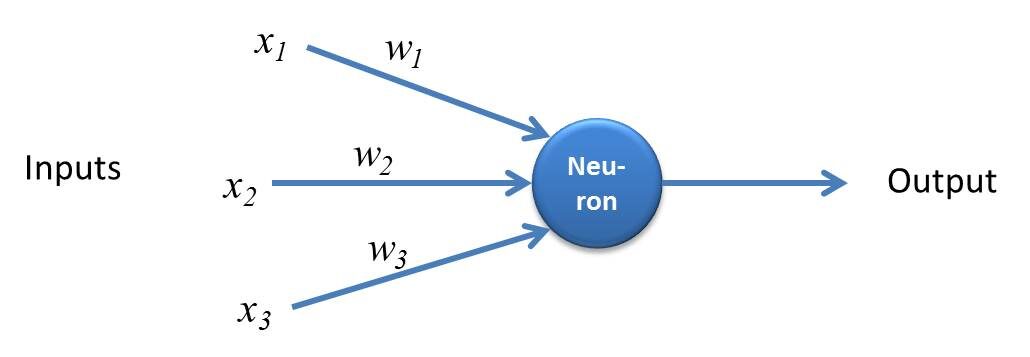
Quelle: kindsonthegenius.com
Während, Mehrschichtiges Perzeptron auch bekannt als Künstliche neurale Netzwerke Es besteht aus mehr als einer Wahrnehmung, die zu einem mehrschichtigen neuronalen Netz zusammengefasst sind.
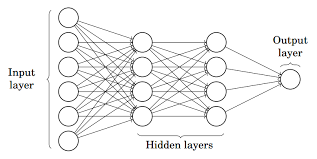
Quelle: Halb
Im Bild oben, Das künstliche neuronale Netz besteht aus vier miteinander verbundenen Schichten:
- Eine Eingabeschicht, mit 6 Eingabeknoten.
- Vorderseite 1 versteckt, mit 4 versteckte Knoten / 4 Perzeptronen
- Versteckter Umhang 2, mit 4 versteckte Knoten
- Ausgabeschicht mit 1 Ausgangsknoten
Schritt für Schritt Working de la rote neuronale künstliche
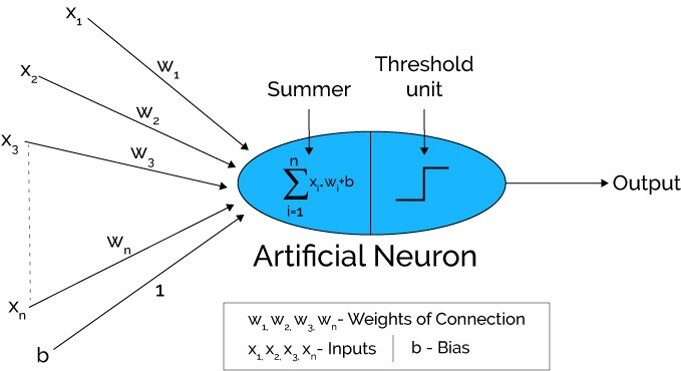
Quelle: Xenonstack.com
-
Im ersten Schritt Die Eingabeeinheiten werden übergeben, nämlich, die Daten werden mit einigen Gewichtungen an die versteckte Schicht übergeben.. Wir können eine beliebige Anzahl von versteckten Schichten haben. Im Bild oben, die Eingänge x1,x2,x3,….XNorden ist bestanden.
-
Jede verborgene Schicht besteht aus Neuronen. Alle Eingänge sind mit jedem Neuron verbunden.
-
Nach Übermittlung der Tickets, Alle Berechnungen werden in der versteckten Schicht durchgeführt (Blaues Oval im Bild)
Die Berechnung in verdeckten Schichten erfolgt in zwei Schritten, die wie folgt sind: :
-
Zuerst, alle Eingaben werden mit ihren Gewichten multipliziert. Das Gewicht ist das SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in... oder Koeffizient jedes VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern..... Zeigt die Stärke des jeweiligen Inputs an. Nach dem Zuweisen der Gewichte, eine Bias-Variable wird hinzugefügt. Voreingenommenheit ist eine Konstante, die dem Modell hilft, optimal zu passen.
MIT1 = W1*In1 + W2*In2 + W3*In3 + W4*In4 + W5*In5 + B
W1, W2, W3, W4, W5 sind die den In-Eingängen zugewiesenen Gewichte1, In2, In3, In4, In5, und b ist der Bias.
- Später, im zweiten schritt, das Das WeckfunktionDie Aktivierungsfunktion ist eine Schlüsselkomponente in neuronalen Netzen, da es den Output eines Neurons auf der Grundlage seiner Eingabe bestimmt. Sein Hauptzweck besteht darin, Nichtlinearitäten in das Modell einzuführen, Ermöglicht das Erlernen komplexer Muster in Daten. Es gibt verschiedene Aktivierungsfunktionen, wie das Sigmoid, ReLU und tanh, jedes mit besonderen Eigenschaften, die sich auf die Leistung des Modells in verschiedenen Anwendungen auswirken.... gilt für die lineare Gleichung Z1. Die Aktivierungsfunktion ist eine nichtlineare Transformation, die auf die Eingabe angewendet wird, bevor sie an die nächste Neuronenschicht gesendet wird. Die Bedeutung der Aktivierungsfunktion besteht darin, dem Modell Nichtlinearität zu verleihen.
Es gibt verschiedene Aktivierungsfunktionen, die im nächsten Abschnitt aufgeführt werden.
-
Der gesamte in Punkt beschriebene Prozess 3 auf jeder versteckten Schicht durchgeführt. Nachdem du jede versteckte Schicht durchgegangen bist, wir gehen zur letzten schicht, nämlich, unsere Ausgabeschicht, die uns die endgültige Ausgabe liefert.
Der oben erläuterte Prozess wird als Vorwärtspropagation bezeichnet.
-
Nachdem Sie die Vorhersagen von der Ausgabeschicht erhalten haben, der Fehler wird berechnet, nämlich, die Differenz zwischen tatsächlicher und erwarteter Leistung.
Wenn der Fehler groß ist, dann werden Schritte unternommen, um den Fehler zu minimieren und zum gleichen Zweck, Rückwärtsausbreitung wird durchgeführt.
Was ist Rückwärtsausbreitung und wie funktioniert sie??
Reverse Propagation ist der Prozess des Aktualisierens und Findens der optimalen Werte von Gewichten oder Koeffizienten, die dem Modell helfen, den Fehler zu minimieren, nämlich, die Differenz zwischen den tatsächlichen und den vorhergesagten Werten.
Aber hier ist die Frage: Wie werden Gewichte aktualisiert und neue Gewichte berechnet??
Gewichte werden mit Hilfe von Optimierern aktualisiert.. Optimierer sind die Methoden / mathematische Formulierungen, um die Attribute neuronaler Netze zu ändern, nämlich, die Gewichte, um den Fehler zu minimieren.
Abwärts geneigte Rückwärtsausbreitung
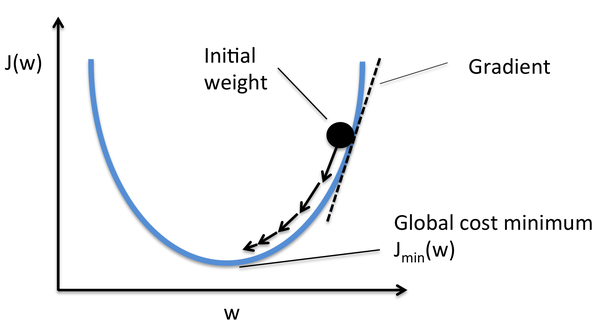
Gradient Descent ist einer der Optimierer, der bei der Berechnung der neuen Gewichte hilft. Lassen Sie uns Schritt für Schritt verstehen, wie Gradient Descent die Kostenfunktion optimiert.
Im Bild unten, die Kurve ist unsere Kostenfunktionskurve und unser Ziel ist es, den Fehler so zu minimieren, dass JMindest nämlich, globale Minima sind erreicht.
Quelle: Quora
Schritte zum Erreichen des globalen Minimums:
-
Zuerst, Gewichte werden zufällig initialisiert nämlich, der Zufallswert des Gewichts und der Schnittpunkte werden dem Modell zugewiesen, während die Vorwärtsausbreitung und Fehler werden berechnet nach all der rechnung. (Wie oben besprochen)
-
So dass er die Steigung wird berechnet, nämlich, abgeleitet aus Fehler mit aktuellen Gewichten
-
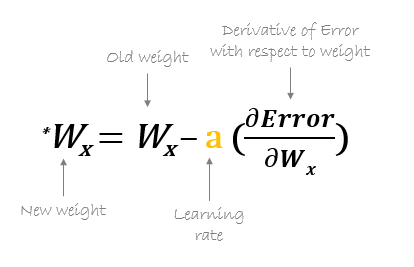
Später, die neuen Gewichte werden nach folgender Formel berechnet, wo a ist die Lernrate Dies ist der Parameter, der auch als Schrittweite bekannt ist, um die Geschwindigkeit oder die Schritte der Rückwärtsausbreitung zu steuern. Bietet zusätzliche Kontrolle darüber, wie schnell wir uns um die Kurve bewegen möchten, um globale Tiefststände zu erreichen.
Quelle: hmkcode.com
4.Dieser Vorgang der Berechnung der neuen Gewichte, dann die Fehler der neuen Gewichte und dann die Aktualisierung der Gewichte. geht weiter, bis wir globale Tiefststände erreichen und der Verlust minimiert ist.
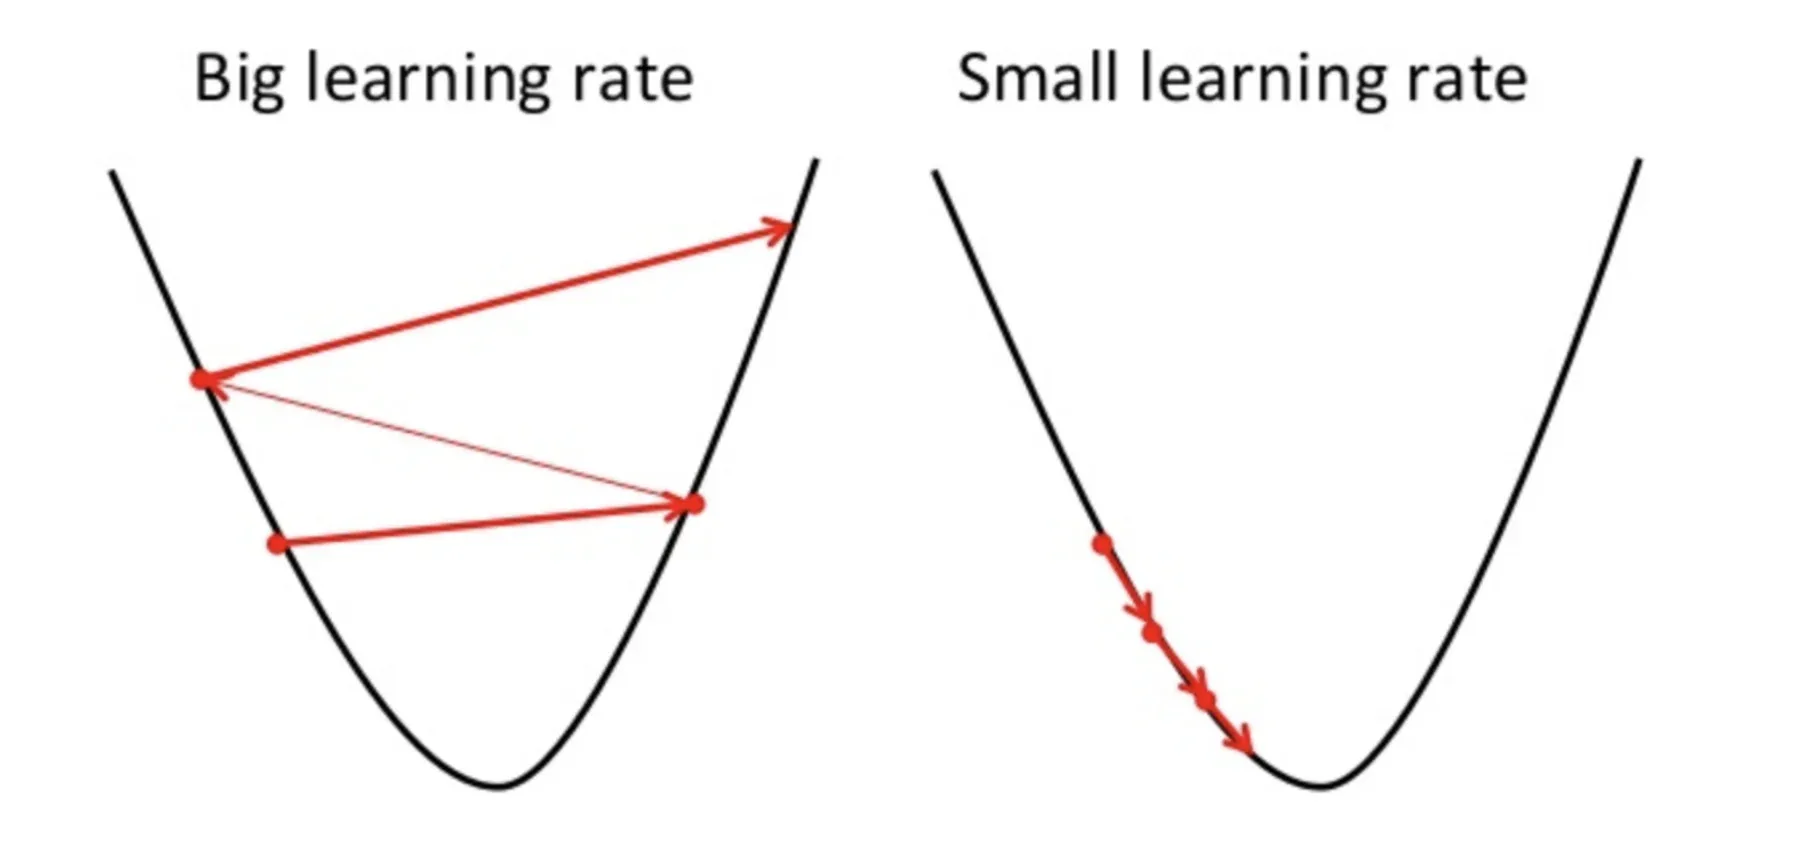
Zu beachten ist hierbei, dass die Lernrate, nämlich, a in unserem Gewichtsupdate Die Gleichung muss mit Bedacht gewählt werden. Die Lernrate ist der Betrag der Veränderung oder die Größe des Schrittes, der unternommen wird, um die globalen Minima zu erreichen. Es sollte nicht zu klein sein da es einige Zeit dauern wird, sich zu konvergieren, ebenso gut wie es sollte nicht sehr groß sein die die globalen Minima überhaupt nicht erreichen. Deswegen, die Lernrate ist der Hyperparameter, den wir basierend auf dem Modell wählen müssen.
Quelle: Educative.io
Die detaillierte Mathematik und die Backpropagation-Kettenregel kennen, siehe Anhang Lernprogramm.
Kurz zu den Aktivierungsfunktionen
Triggerfunktionen sind an jedes Neuron angehängt und sind mathematische Gleichungen, die bestimmen, ob ein Neuron feuern soll oder nicht, basierend darauf, ob die Eingabe des Neurons für die Vorhersage des Modells relevant ist oder nicht. Der Zweck der Aktivierungsfunktion besteht darin, eine Nichtlinearität in die Daten einzuführen.
Verschiedene Arten von Triggerfunktionen sind:
- Sigmoid-Aktivierungsfunktion
- TanH-Aktivierungsfunktion / Hyperbolischer Tangens
- Funktion der gleichgerichteten Lineareinheit (LebenslaufDie Aktivierungsfunktion von ReLU (Gleichgerichtete Lineareinheit) Es wird aufgrund seiner Einfachheit und Effektivität häufig in neuronalen Netzen verwendet. Definiert als ( F(x) = max(0, x) ), ReLU lässt Neuronen nur dann feuern, wenn die Eingabe positiv ist, Dies hilft, das Problem des Gradientenverblassens zu mildern. Es hat sich gezeigt, dass seine Verwendung die Leistung bei verschiedenen Deep-Learning-Aufgaben verbessert, ReLU zu einer Option machen..)
- Undichte ReLU
- Softmax
In diesem Blog finden Sie eine detaillierte Erklärung der Aktivierungsfunktionen.
Abschließende Anmerkungen
Hier schließe ich meine Schritt-für-Schritt-Erklärung des ersten Neuronalen Netzes von Tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... Was ist es ANA. Ich habe versucht, den Prozess von Propagation Forwarding und Backpropagation so einfach wie möglich zu erklären. Ich hoffe, dieser Artikel war es wert, gelesen zu werden 🙂
Bitte, melde dich gerne bei mir LinkedIn und teile deinen wertvollen Input. Bitte, schau dir meine anderen Artikel hier an.
Über den Autor
Soja Deepanshi Dhingra, Ich arbeite derzeit als Data Science Researcher und habe einen Hintergrund in Analytik, explorative Datenanalyse, Maschinelles Lernen und Deep Learning.
Die in diesem Artikel über das künstliche neuronale Netz gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





