
Dieser Beitrag wurde im Rahmen der Data Science Blogathon
Einführung
Probenahme, um die Wahrscheinlichkeit eines Bereichs einer unbekannten Größe zu erhalten. Klingt schwierig! mach dir keine Sorgen, Wir werden dies in diesem Beitrag ausführlich untersuchen
Eine kurze Geschichte:
Die Monte-Carlo-Methode wurde von John Neumann und Ulam Stanislaw erfunden, um die Entscheidungsfindung unter unsicheren Bedingungen zu fördern.. Es ist nach einer bekannten Kasinostadt in Monte Carlo namens Monaco benannt, da das Element des Zufalls im Mittelpunkt des Modellierungsansatzes steht, da es einem Roulette-Spiel ähnelt.
in einfachen Worten, Die Monte-Carlo-Simulation ist eine Methode der Schätzung des Wertes von a unbekannte Menge mit Hilfe der Inferenzstatistik. Sie müssen sich nicht mit Inferenzstatistiken befassen, um ein solides Verständnis dafür zu bekommen, wie die Monte-Carlo-Simulation funktioniert.. Trotz dieses, In diesem Beitrag werden nur die Punkte der Inferenzstatistik behandelt, die für uns in der Monte-Carlo-Simulation relevant sind.
Inferenzstatistik befasst sich mit Population das ist unsere Reihe von Beispielen und Stichprobe, das ist eine geeignete Teilmenge der Bevölkerung. Der wichtigste Punkt, auf den Sie achten sollten, ist, dass es sich um eine Zufallsstichprobe handelt neigen dazu, das gleiche zu zeigen Merkmale / Eigentum als die Bevölkerung, aus der es stammt.
Wir werden ein Beispiel sehen, um zu verstehen, wie die Monte-Carlo-Simulation funktioniert.
Unser Ziel ist es, abzuschätzen, wie hoch die Wahrscheinlichkeit ist, dass wir gewinnen, wenn wir eine Münze unendlich oft werfen..
1. Sagen wir, wir drehen es einmal um und machen weiter. Sind wir sicher, dass unsere Antwort ist 1?
2. Jetzt haben wir die Münze erneut geworfen und es kam wieder Kopf.. Sind wir sicher, dass die nächste Version auch vor uns liegt?
3. Wir drehen es immer wieder um, Sagen wir 100 mal, und seltsamerweise taucht jedes Mal der Kopf auf. Jetzt, müssen wir die Tatsache akzeptieren, dass die nächste Runde zu einem weiteren Kopf führen wird?
4. Ändern wir das Szenario und nehmen wir an, dass 100 Freigaben, 52 führte dazu, dass der Kopf ruhte, 48 sie wurden zu Kreuzen. Ist die Wahrscheinlichkeit, dass der nächste Wurf den Kopf trifft? 52/100? Angesichts der Beobachtung, ist unsere beste Schätzung, aber das Vertrauen wird gering bleiben.
Warum gibt es einen Unterschied im Konfidenzniveau??
Es ist wichtig zu wissen, dass unsere Schätzung von zwei Dingen abhängt
1. Größe: Die Größe der Stichprobe (als Beispiel, 100 vs 2 In den Fällen 2 Ja 4 beziehungsweise)
2. Unterschied: Stichprobenabweichung (alle Ergebnisse als Kopf vs. 52 Köpfe wie im Fall 3 Ja 4 beziehungsweise)
3. Wenn die Varianz der Beobachtung zunimmt (Fälle 3 Ja 4), Es besteht weiterer Beobachtungsbedarf (wie in den Fällen 2 Ja 4) das gleiche Maß an Selbstvertrauen haben.
Jetzt werden wir ein Roulette-Spiel simulieren (Python):
Roulette ist ein Spiel, in dem eine Scheibe mit Blöcken (halb rot und halb schwarz) in dem ein Ball enthalten sein kann, mit einem Ball drehen. Wir müssen eine Zahl erraten und ob die Kugel auf dieser Zahl landet, dann ist es ein Gewinn, und wir verdienen einen Betrag von (Betrag, der für einen Slot bezahlt wird
) x (Nein. Anzahl der gesamten Steckplätze in der Maschine).
Klasse Roulette():
    def __init__(selbst):
        self.pockets = []
        für mich in Reichweite(1,37):
            self.pockets.append(ich)
        self.ball = None
        self.pocketOdds = len(self.pockets) - 1
Def Spin(selbst):
    self.ball = zufällige Wahl(self.pockets)
def betPocket(selbst, Tasche, Amtsamt):
    wenn str(Tasche) == str(self.ball):
        return amt*self.pocketOdds
    else: return -amt
def __str__(selbst):
        return 'Fair Roulette'
def playRoulette(Spiel, numSpins, Tasche, Wetten):
    totPocket = 0
    für mich in Reichweite(numSpins):
        game.spin()
    totPocket += game.betPocket(Tasche, Wetten)
    wenn toPrint:
        drucken (numSpins, 'spins of', Spiel)
        drucken ('Erwartete Rendite Wetten', Tasche, '=',
            str(100*totPocket/numSpins) + '%n')
    Rückkehr (totPocket/numSpins)
Spiel = Roulette()
für numSpins in (100, 1000000):
    für mich in Reichweite(3):
        spielenRoulette(Spiel, numSpins, 5, 1, Wahr)
100 Roulette dreht sich
Erwartete Renditewetten 5 = -100.0%
100 Roulette dreht sich
Erwartete Renditewetten 5 = 42.0%
100 Roulette dreht sich
Erwartete Renditewetten 5 = -26.0%
1000000 Roulette dreht sich
Erwartete Renditewetten 5 = -0,0546%
1000000 Roulette dreht sich
Erwartete Renditewetten 5 = 0,502%
1000000 Roulette dreht sich
Erwartete Renditewetten 5 = 0,7764%
Gesetz der großen Zahlen
In wiederholten unabhängigen Tests mit der konstanten p-Wahrscheinlichkeit der Population für ein bestimmtes Ergebnis bei jedem Test, die Wahrscheinlichkeit, dass das Ergebnis eintritt, Mit anderen Worten, aus Proben gewonnen. Unterscheidet sich von p konvergiert auf Null Als die die Anzahl der Versuche geht ins Unendliche.
Es bedeutet einfach, dass, wenn Abweichungen auftreten (Abweichung) des erwarteten Verhaltens (Wahrscheinlichkeit p), es ist wahrscheinlich, dass diese Abweichungen in Zukunft durch die entgegengesetzte Abweichung kompensiert werden.
Lassen Sie uns nun über einen interessanten Vorfall sprechen, der am stattfand 18 August 1913, in einem Monte-Carlo-Casino. beim Roulette, Schwarz stellte sechsundzwanzig Mal hintereinander einen Rekord auf, und Panik entstand, um auf Rot zu setzen (um die Abweichung vom erwarteten Verhalten abzugleichen)
Lassen Sie uns diese Situation mathematisch analysieren
1. Wahrscheinlichkeit 26 fortlaufend rot = 1 / 67,108,865
2. Wahrscheinlichkeit 26 aufeinanderfolgende rot, wenn die 25 vorherige Rollen waren rot = 1/2
Rückfall zum Mittelwert
1. Nach einem extremen Zufallsereignis, das nächste zufällige Ereignis wird wahrscheinlich weniger extrem sein, damit der Mittelwert erhalten bleibt.
2. Als Beispiel, wenn das Rouletterad gedreht wird 10 Zeiten und die Roten kommen jedes Mal, dann ist es ein extremes Ereignis = 1/1024 und es ist wahrscheinlich, dass in der nächsten 10 Umdrehungen bekommen wir weniger als 10 rot, aber die durchschnittliche Zahl ist 5 nur.
Dann, wenn wir den Mittelwert betrachten 20 wendet sich, wird näher am erwarteten Mittelwert liegen 50% von rot als von 100% in der ersten 10 wendet sich.
Jetzt ist es an der Zeit, sich der Realität zu stellen.
Stichprobenraum möglicher Ergebnisse
1. Es ist nicht möglich, eine perfekte Genauigkeit durch Stichproben zu garantieren, noch kann gesagt werden, dass eine Schätzung nicht genau richtig ist..
Wir stehen hier vor einer Frage: Wie viele Proben müssen wir uns ansehen, bevor wir uns auf unsere Antwort verlassen können??
Hängt von der Variabilität in der zugrunde liegenden Verteilung ab.
Konfidenzniveaus und Konfidenzintervalle
Genau wie in einer realen Lebenssituation, Wir können uns bei keinem unbekannten Parameter sicher sein, der aus einer Stichprobe für die gesamte Population gewonnen wurde, also verwenden wir Konfidenzniveaus und Konfidenzintervalle.
Das Konfidenzintervall stellt einen Bereich bereit, in dem der unbekannte Wert wahrscheinlich enthalten ist, mit der Gewissheit, dass der unbekannte Wert strikt innerhalb dieses Bereichs liegt..
Als Beispiel, die Rendite von Wetten auf einem Spielautomaten 1000 mal beim Roulette ist -3% mit einem RandMargin ist ein Begriff, der in einer Vielzahl von Zusammenhängen verwendet wird, wie z.B. Buchhaltung, Wirtschaft und Druck. In der Buchhaltung, bezieht sich auf die Differenz zwischen Umsatz und Kosten, die es ermöglicht, die Rentabilität eines Unternehmens zu bewerten. Im Bereich Publishing, Der Rand ist der Leerraum um den Text auf einer Seite, Das macht es gut lesbar und sorgt für eine ästhetische Darstellung. Die korrekte Verwaltung ist unerlässlich.. des Fehlers von +/- 4% mit einem Konfidenzniveau von 95%.
Es kann weiter dekodiert werden, wenn wir einen unendlichen Test von durchführen 1000,
durchschnittliche Leistung / erwartetes Mittel wäre -3%
Die Ausbeute variiert zwischen + 1% Ja -7% das neben dem 95% der Zeiten.
Wahrscheinlichkeitsdichtefunktion (PDF).
Die allgemeine Formverteilung wird durch die Wahrscheinlichkeitsdichtefunktion festgelegt (PDF). Es wird festgestellt als die Wahrscheinlichkeit, dass die VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... liegt zwischen einem.
Die Fläche unter der Kurve zwischen den beiden PDF-Punkten ist die Wahrscheinlichkeit, dass die Zufallsvariable innerhalb dieses Bereichs liegt..
Lassen Sie uns unser Lernen mit einem Beispiel abschließen:
Nehmen wir an, es wird ein Kartenspiel gemischt und wir müssen die Wahrscheinlichkeit dafür ermitteln 2 aufeinanderfolgende Könige, wenn sie die Karten in der Reihenfolge platzieren, in der sie platziert wurden.
Analytische Methode:
P (wenigstens 2 aufeinanderfolgende Könige) = 1-P (keine aufeinanderfolgenden Könige)
= 1- (49! x 48!) / ((49-4)! X52!) = 0.217376
Durch Monte-Carlo-Simulation:
Schritte
1. Wählen Sie wiederholt zufällige Datenpunkte aus: hier gehen wir davon aus, dass das Mischen der Karten zufällig ist
2. Durchführen deterministischer Berechnungen. Mehrere davon mischen und finden die Ergebnisse.
3. Kombinieren Sie die Ergebnisse: Erkunden Sie das Ergebnis und enden Sie mit unserem Fazit.
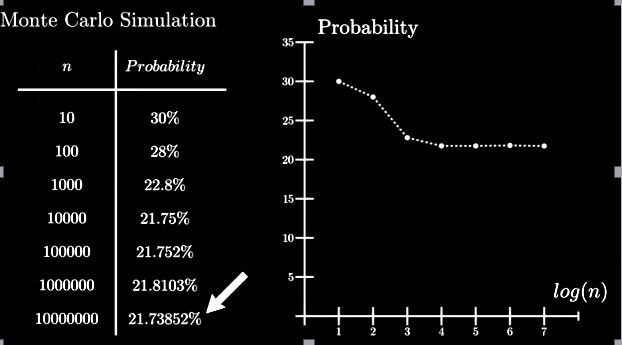
Durch die Monte-Carlo-Methode erreichen wir eine nahezu exakte Lösung aus der analytischen Methode.
Vorteile der Monte-Carlo-Simulation
- Einfach zu implementieren und bietet statistische Stichproben für numerische Experimente mit dem Computer.
- Es liefert uns zufriedenstellende Näherungslösungen für rechenintensive mathematische Probleme..
- Es kann sowohl für deterministische als auch für stochastische Probleme verwendet werden..
Nachteile der Monte-Carlo-Simulation
- Manchmal dauert es lange, da wir eine große Anzahl von Proben generieren müssen, um das gewünschte zufriedenstellende Ergebnis zu erzielen.
- Die mit dieser Methode erhaltenen Ergebnisse sind nur die Annäherung an die wahre Antwort und nicht die exakte Antwort..
Über den Autor
Soja Dinesh Junjariya, ein Btech-Student vom IIT Jodhpur.
Für jeden Vorschlag, kommentiere unten.
Die in diesem Beitrag gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





