
introduction
est un élément important, ainsi que l'une des étapes les plus sous-estimées de tout projet de science des données. L'EDA est essentielle pour une analyse de données bien définie et structurée et doit être effectuée avant la phase de modélisation de l'apprentissage automatique.
Il s'agit de trouver des idées à partir des données après une observation attentive et de résumer davantage ses principales caractéristiques.. Généralement, les données réelles avec lesquelles nous travaillons contiennent beaucoup « bruit » Oui, donc, effectuer une analyse de données manuellement sur de tels ensembles de données devient un processus compliqué et fastidieux.
Tutoriel d'introduction à Python: calcul scientifique avec des pandas | par un passionné d'analyse de données | Moitié
Piton est l'un des langages les plus utilisés pour Science des données notamment en raison de la présence de diverses bibliothèques et packages qui facilitent l'analyse des données.
Respectivement, Pandas est l'une des bibliothèques Python les plus populaires qui permet de présenter les données d'une manière adaptée à l'analyse grâce à son Série Oui Trame de données Structures de données. Fournit diverses fonctions et méthodes pour simplifier et accélérer le processus d'analyse des données.
Ici, nous utilisons le jeu de données "TITANIC" pour effectuer la mise en œuvre pratique de toutes les fonctions.
En premier lieu, nous importons la bibliothèque Numpy et pandas puis lisons le jeu de données.

Commençons maintenant
1. df.head (): Par défaut, renvoie le premier 5 lignes de bloc de données. Pour modifier la valeur par défaut, vous pouvez insérer une valeur entre parenthèses pour modifier le nombre de lignes renvoyées.
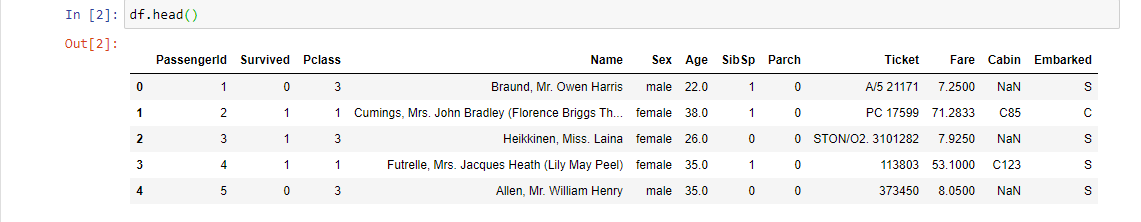
2. df.queue (): Par défaut, renvoie le dernier 5 lignes de bloc de données. Cette fonction est utilisée pour obtenir les n dernières lignes. Cette fonction renvoie les n dernières lignes de l'objet en fonction de la position.
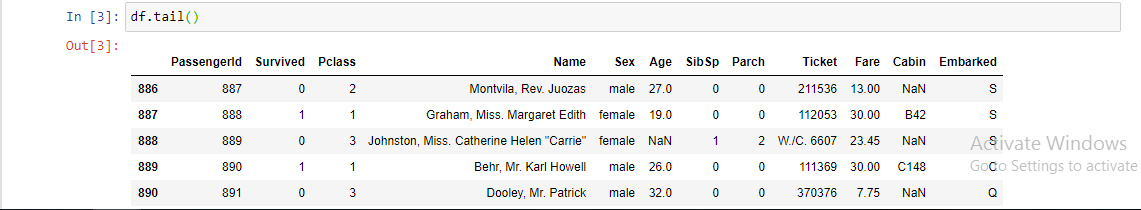
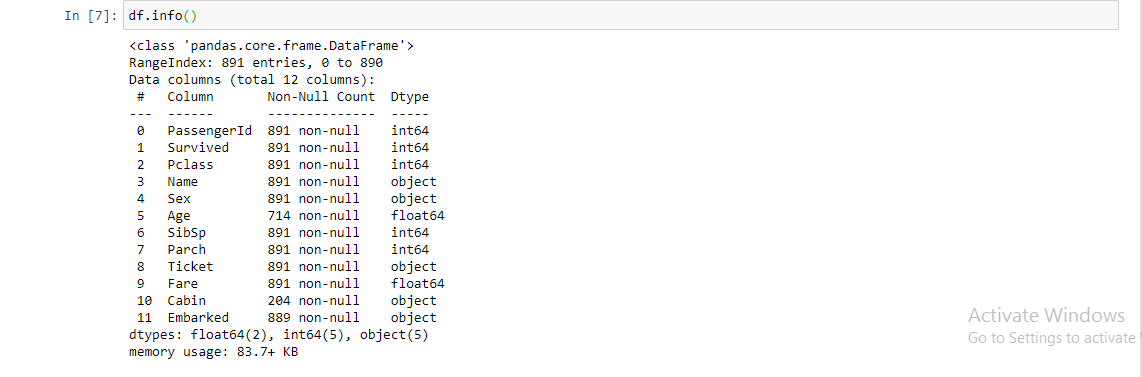
3. df.info (): Aide à obtenir un aperçu rapide de l'ensemble de données. Cette fonction est utilisée pour obtenir un bref résumé de la trame de données. Cette méthode imprime des informations sur un DataFrame, y compris le type de indiceLe "Indice" C’est un outil fondamental dans les livres et les documents, qui vous permet de localiser rapidement les informations souhaitées. Généralement, Il est présenté au début d’une œuvre et organise les contenus de manière hiérarchique, y compris les chapitres et les sections. Sa préparation correcte facilite la navigation et améliore la compréhension du matériau, ce qui en fait une ressource incontournable tant pour les étudiants que pour les professionnels dans divers domaines.... et les types de colonne, valeurs non nulles et utilisation de la mémoire.
4. df. Forme: Affiche le nombre de dimensions ainsi que la taille de chacune dimension"Dimension" C’est un terme qui est utilisé dans diverses disciplines, comme la physique, Mathématiques et philosophie. Il s’agit de la mesure dans laquelle un objet ou un phénomène peut être analysé ou décrit. En physique, par exemple, On parle de dimensions spatiales et temporelles, alors qu’en mathématiques, il peut faire référence au nombre de coordonnées nécessaires pour représenter un espace. Sa compréhension est fondamentale pour l’étude et.... Étant donné que les trames de données sont bidimensionnelles, la forme qu'il renvoie est le nombre de lignes et de colonnes.

5. taille df.: Renvoie un entier qui représente le nombre d'éléments dans cet objet. Renvoie le nombre de lignes s'il s'agit de Series; autrement, renvoie le nombre de lignes multiplié par le nombre de colonnes s'il s'agit d'un DataFrame.

6. df.ndim: Renvoie la dimension du cadre / série de données. 1 pour une dimension (série), 2 pour deux dimensions (trame de données).

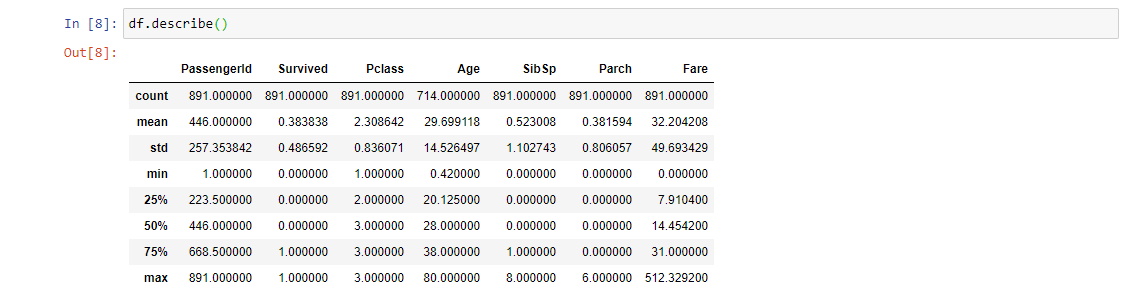
7. df.décrire (): Renvoie un résumé statistique des colonnes numériques présentes dans l'ensemble de données. Cette méthode calcule certaines mesures statistiques telles que le centile, la moyenne et l'écart type des valeurs numériques de la série ou du DataFrame.
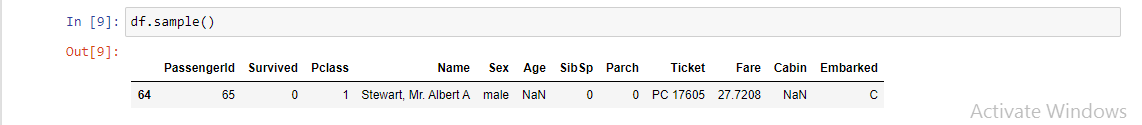
8. df.échantillon (): Utilisé pour échantillonner au hasard dans une ligne ou dans une colonne. Vous permet de sélectionner au hasard des valeurs dans une série ou un DataFrame. Il est utile lorsque nous voulons sélectionner un échantillon aléatoire à partir d'une distribution.
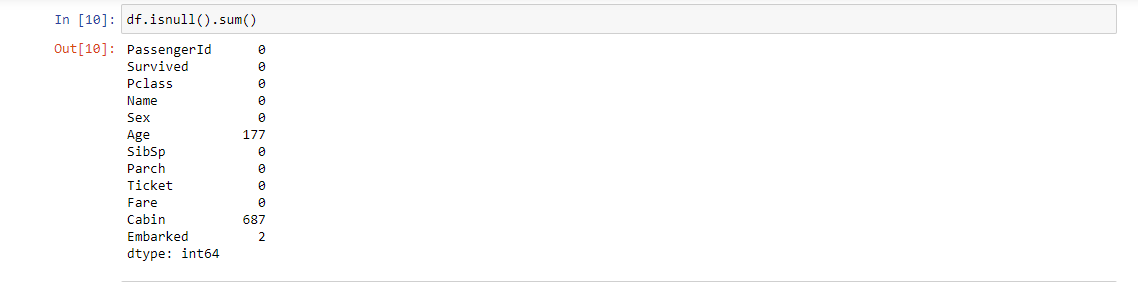
9. df.isnull () .somme (): Renvoie le nombre de valeurs manquantes dans chaque colonne.
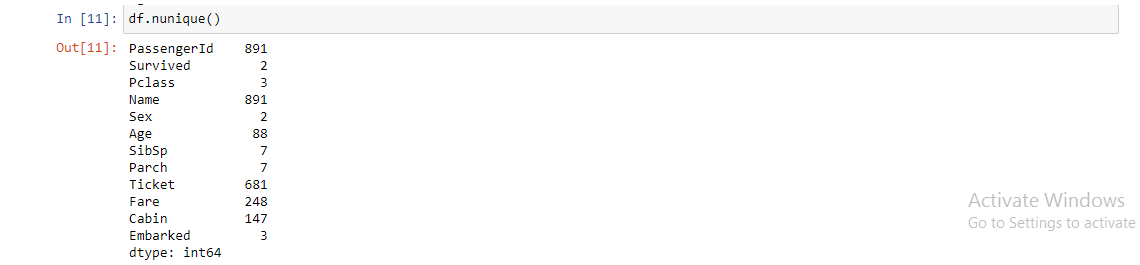
10. df.nunique (): Renvoie le nombre d'éléments uniques dans l'objet. Compte le nombre d'entrées uniques dans les colonnes ou les lignes. Il est très utile dans les caractéristiques catégorielles, surtout dans les cas où on ne connaît pas le nombre de catégories à l'avance.
11. df.index: Cette fonction recherche un élément donné au début de la liste et renvoie l'indice le plus bas où l'élément apparaît.

12. colonnes df .: Renvoie les étiquettes de colonne du bloc de données.

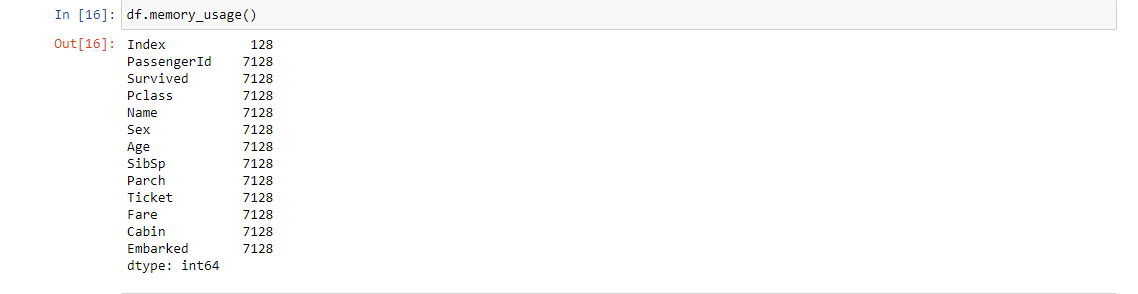
13. df.memory_usage (): Renvoie la quantité de mémoire utilisée par chaque colonne en octets. Il est particulièrement utile lorsque vous travaillez avec de grands blocs de données.
14. df.dropna (): Cette fonction est utilisée pour supprimer une ligne ou une colonne d'un bloc de données qui a un NaN ou des valeurs manquantes.

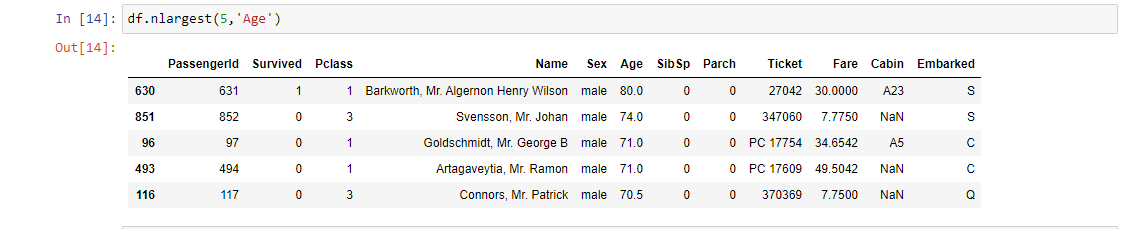
15. df.nlargest (): Retourne le premier Nord lignes classées par Colonnes par ordre décroissant.
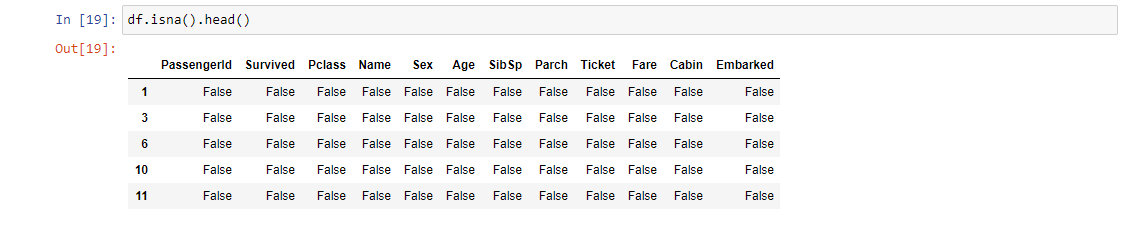
16. df.isna (): Cette fonction renvoie une trame de données remplie de valeurs booléennes avec true indiquant les valeurs manquantes.
17. df.dupliqué (): Renvoie une chaîne booléenne indiquant les lignes en double.

18. value_counts (): Cette fonction est utilisée pour obtenir une série contenant des comptes de valeurs uniques. L'objet résultant sera dans l'ordre décroissant de sorte que le premier élément soit l'élément qui se produit le plus fréquemment. Exclure les valeurs manquantes par défaut. Cette fonction est utile lorsque nous voulons vérifier le problème du déséquilibre des classes pour un variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... categórica.

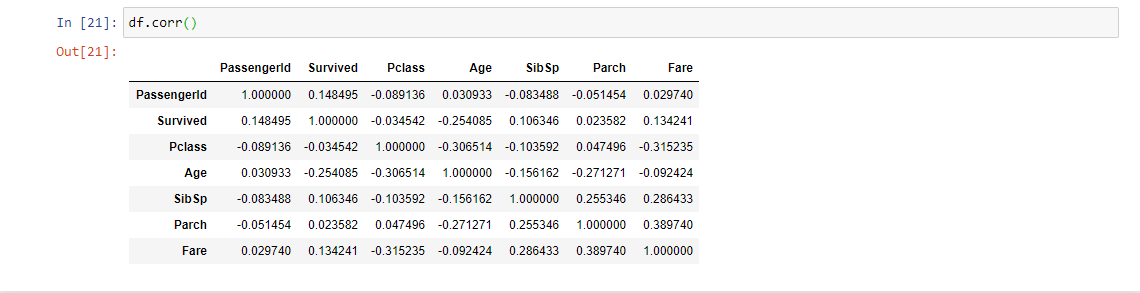
19. df.corr (): Cette fonction est utilisée pour trouver la corrélation par paires de toutes les colonnes de la trame de données. Les valeurs manquantes sont automatiquement exclues. Pour toute colonne de type de données non numérique dans le bloc de données, il est ignoré. Cette fonction est utile lors de la sélection des caractéristiques en examinant la corrélation entre les caractéristiques et la variable cible ou entre les variables.
20. types de df.d: Cette fonction affiche le type de données de chaque colonne.
Remarques finales
Merci pour la lecture!
Si vous avez aimé cela et que vous voulez en savoir plus, visitez mes autres articles sur la science des données et l'apprentissage automatique en cliquant sur le lien
N'hésitez pas à me contacter au Linkedin, Courrier électronique.
Tout ce qui n'est pas mentionné ou voulez-vous partager vos pensées? N'hésitez pas à commenter ci-dessous et je vous répondrai.
Jusque là, rester à la maison, rester en sécurité pour éviter la propagation de COVID-19 [feminine, Et continue d'apprendre!
A propos de l'auteur
Chirag Goyal
Actuellement, Je poursuis mon Bachelor of Technology (B.Tech) en informatique et ingénierie de Institut indien de technologie Jodhpur (IITJ). Je suis très enthousiasmé par l'apprentissage automatique, les l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... et l’intelligence artificielle.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





