
Vue d'ensemble
- Les projets de science des données open source ajoutent beaucoup de valeur à votre CV et vous aident à vous démarquer lors d'un entretien
- Ici il y a 7 projets de science des données open source sur lesquels vous devriez travailler ce mois-ci
introduction
Je vais vous donner quelques conseils que j'aurais aimé que quelqu'un me donne quand j'ai commencé ma carrière dans la science des données.. Quand je parcourais le voyage semé d'obstacles à travers les backwaters de la science des données, J'ai eu beaucoup de mal avant d'avoir mon premier rôle.. Avait toutes les qualifications (ou alors je pensais) mais quelque chose ne va pas.
Cet écart entre ce que j'ai apporté à la table et ce que l'intervieweur attendait était une expérience dans des projets de science des données..
Les projets de science des données ajoutent beaucoup de valeur à votre CV, surtout si vous êtes débutant. La plupart des nouveaux arrivants auront des certifications, mais l'ajout de projets de science des données open source vous donnera un avantage significatif sur la concurrence. Et crois moi, il existe un nombre impressionnant de projets de science des données open source pour vous.

Ici, J'ai dressé une liste des meilleurs projets de science des données open source qui ont été créés ou lancés en juin. Cela fait partie de ma série de projets mensuels où je présente les meilleurs projets de science des données open source sur GitHub.
Si vous voulez voir les projets précédents, Je les ai rassemblés sous forme de cours gratuit. Ils sont structurés par domaine (projets de vision par ordinateur, Projets PNL, etc.) pour que vous puissiez vous concentrer sur le projet que vous voulez. Et si vous êtes nouveau sur GitHub, assurez-vous que vous êtes inscrit à ce cours d'introduction gratuit à Git et GitHub.
Projets de science des données open source pour améliorer votre CV

J'ai divisé les projets en trois catégories selon leur domaine:
- Apprentissage automatique
- Vision par ordinateur
- Autres projets de science des données open source, y compris un ensemble de données impressionnant
Regardons chaque catégorie individuellement.
Projets de machine learning open source
C'est là que vous obtiendrez le terrain de l'apprentissage automatique.. Ici, nous couvrirons trois projets open source utiles liés à l'apprentissage automatique.. Vous pouvez choisir un projet en fonction de vos intérêts ou les essayer tous. J'ai essayé de les garder aussi diversifiés que possible afin que vous puissiez voir un projet sur les documents d'apprentissage automatique et un autre sur la création de pipelines d'apprentissage automatique..
Si vous cherchez des conseils ou êtes nouveau dans ce domaine, Je vais vous diriger vers des ressources d'apprentissage utiles:
La lecture d'articles de recherche sur l'apprentissage automatique est une perspective assez écrasante pour la plupart des professionnels., beaucoup moins pour les débutants. Les data scientists et les chercheurs en machine learning ont tendance à rédiger des articles extrêmement techniques que même les experts ont du mal à décoder.. En réalité, c'est l'un des plus gros points faibles dans notre domaine.
Donc, tout effort pour briser la complexité est toujours le bienvenu. Ce projet utile est une collection d'articles sur la science des données et l'apprentissage automatique « avec des illustrations, annotations et brèves explications des mots-clés techniques, termes et études antérieures qui facilitent la lecture de l'article et de l'idée principale ».
Ce projet était open source sur GitHub la semaine dernière, donc il est mis à jour régulièrement. En ce moment, on peut déjà y voir quelques articles pour que vous puissiez les revoir et vous faire une idée de la façon dont les annotations ont été faites. J'aime particulièrement l'annotation YOLOv1:

Très cool! Allez-y et explorez ce document et les autres. Il y a trop à apprendre!
C'est un projet assez intéressant pour toute personne ayant un peu de connaissances en science des données.

NeoML est un framework d'apprentissage automatique complet qui nous permet de créer, former et mettre en œuvre des modèles d'apprentissage automatique. En résumé, nous pouvons créer un pipeline d'apprentissage automatique de bout en bout sans avoir à dépenser beaucoup d'argent pour des solutions prêtes à l'emploi.
Les scientifiques des données et les ingénieurs de données peuvent l'utiliser pour des tâches de vision par ordinateur et de traitement du langage naturel (PNL), comme prétraitement d'image, classification, analyse de conception de documents, OCR et extraction de données à partir de documents structurés et non structurés.
Voici la fonctionnalité clé de NeoML que j'ai extraite de leur référentiel GitHub:
- Réseaux de neurones compatibles avec plus de 100 types de couches
- Apprentissage automatique traditionnel: plus de 20 algorithmes (classification, régression, regroupement, etc.)
- Prise en charge du processeur et du processeur graphique, inférence rapide
- Prise en charge ONNX
- langues: C ++, Java, Objectif c
- Multi plateforme: le même code peut être exécuté sur Windows, Linux, macOS, iOS et Androïd
Voici un article pour débutants sur la façon de créer des pipelines d'apprentissage automatique:
Voici un autre projet que tout data scientist adorerait, surtout si vous êtes enclin à la recherche. Nous avons souvent du mal à passer d'un environnement de test à un déploiement à grande échelle; ce n'est pas une étape facile à franchir (nous devrions vraiment apprécier le rôle que jouent les ingénieurs de données).
Google, bien sûr, a une solution potentielle pour nous sous la forme de Caliban. Il s'agit d'un outil pour vous aider à démarrer et suivre vos expériences numériques dans un environnement informatique isolé et reproductible.. Caliban a été développé par des chercheurs et des ingénieurs en apprentissage automatique de Google.

Comme ils disent, Caliban « permet de passer facilement d'un simple prototype fonctionnant sur un poste de travail à des milliers de travaux expérimentaux fonctionnant dans le cloud ». Ce sont les points saillants à connaître:
- Développez votre code expérimental localement et testez-le dans un environnement isolé (Docker)
- Déplacez-vous facilement sur les paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... expérimental
- Soumettez vos expériences en tant que tâches cloud, où ils fonctionneront dans le même bac à sable
- Contrôler et suivre les travaux
Projets de vision industrielle open source
Je suis impressionné par les progrès que nous voyons dans la vision par ordinateur (Sans jeu de mots!). On dirait que chaque mois, quand je m'assois pour écrire cet article, Je rencontre de plus en plus de frameworks innovants et de nouvelles approches qui améliorent l'état de l'art dans ce domaine.
Les organisations parcourent le monde à la recherche de talents en vision par ordinateur en ce moment, c'est donc le bon moment pour travailler sur ces projets et se lancer sur le terrain. Si vous n'avez pas encore commencé à lire sur la vision industrielle, voici quelques ressources utiles:
Et si je vous donnais une image cible et vous demandais d'écrire un programme de vision par ordinateur qui créerait l'image à partir de zéro? Oui, c'est la puissance de la vision par ordinateur!
Ce projet open source vraiment cool nous permet d'imiter un processus de dessin lorsqu'une image cible nous est fournie. Voici une petite démo de ce à quoi ressemble le processus:

J'ai hâte de mettre la main dessus et de commencer à dessiner toutes sortes de choses.. Vous aurez besoin des bibliothèques Python suivantes pour exécuter ceci:
- OpenCV 3.4.1
- NumPy 1.16.2
- matplotlib 3.0.3
Le développeur nous a également donné un exemple pour que vous puissiez l'exécuter et voir la magie de la vision par ordinateur se déployer. Je vous suggère également de consulter les articles OpenCV suivants si vous n'avez jamais travaillé avec eux auparavant:
Ce projet open source s'adresse à des data scientists un peu plus avancés. Pour comprendre en quoi consiste ce projet, nous devons comprendre le concept de super résolution d'image unique. En termes simples, l'objectif ici est de construire une image de haute résolutionLa "résolution" fait référence à la capacité de prendre des décisions fermes et d’atteindre les objectifs fixés.. Dans des contextes personnels et professionnels, Il s’agit de définir des objectifs clairs et d’élaborer un plan d’action pour les atteindre. La résolution est essentielle à la croissance personnelle et à la réussite dans divers domaines de la vie, car cela vous permet de surmonter les obstacles et de rester concentré sur ce qui compte vraiment.... à partir d'une entrée correspondante de basse résolution.
Cela ressemble à un projet de vision par ordinateur classique !!
PULSE est une nouvelle solution à cet énoncé de problème. IMPULSION, abréviation de Photo Upsampling via Latent Space Exploration, génère des images ultra-réalistes et haute résolution à des résolutions incroyablement élevées. Et cela est réalisé de manière totalement auto-supervisée et n'est pas limité à un opérateur de dégradation spécifique utilisé pendant le entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.....
Ensuite, un exemple du fonctionnement de PULSE est montré:
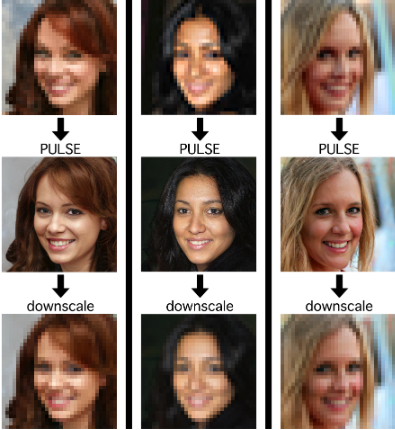
Je vous encourage à lire d'abord le travail de recherche avant de regarder le code. Cela vous donnera une meilleure idée du fonctionnement de PULSE ci-dessous afin que vous puissiez aborder le code beaucoup plus clairement.
Autres projets de science des données open source
Voici quelques projets de science des données open source qui ne rentrent pas dans les deux catégories ci-dessus. En réalité, ce sont deux projets contrastés: l'un s'adresse aux débutants en science des données, tandis que l'autre s'occupe du monde du apprentissage par renforcementL’apprentissage par renforcement est une technique d’intelligence artificielle qui permet à un agent d’apprendre à prendre des décisions en interagissant avec un environnement. Par le biais de commentaires sous forme de récompenses ou de punitions, L’agent optimise son comportement pour maximiser les récompenses accumulées. Cette approche est utilisée dans une variété d’applications, Des jeux vidéo à la robotique en passant par les systèmes de recommandation, se démarquant par sa capacité à apprendre des stratégies complexes.....
Choisissez celui qui vous convient le mieux et commencez à l'explorer.
Je suis sûr que la plupart d'entre vous ont travaillé avec l'ensemble de données Iris. En réalité, il s'agit peut-être même du premier ensemble de données que vous avez utilisé pour comprendre le concept de classification dans l'apprentissage automatique. J'aime à quel point il est facile de comprendre et d'explorer l'ensemble de données.
Mais travailler avec le même ensemble de données peut devenir un peu ennuyeux, surtout lorsque vous apprenez les tenants et aboutissants de l'apprentissage automatique.
C'est là qu'intervient le jeu de données PalmerPenguins.. Cet ensemble de données, open source le mois dernier, se positionne comme une alternative à Iris et vise à fournir un large ensemble de données pour l'exploration et la visualisation des données, surtout pour les débutants. Voici un échantillon des visualisations que vous pouvez créer:

Le lien que j'ai mentionné ci-dessus contient des exemples sur la façon de commencer à explorer ces données. Ils ont même fourni des détails sur les différentes variables, mais n'aimeriez-vous pas explorer cela vous-même? 🙂
Vous pouvez obtenir PalmerPenguins sur votre machine en utilisant le code suivant:
# install.paquets("télécommandes")
télécommandes::install_github("allisonhorst/palmerpingouins")
Je recommande également de consulter les articles populaires ci-dessous sur l'exploration et la visualisation des données.:
Ah, voici un projet open source pour vous tous, amis d'apprentissage par renforcement. SlimeVolleyGym est un environnement de gym simple pour tester des algorithmes d'apprentissage par renforcement à un ou plusieurs agents. Ceci a été créé et open source par hardmaru, une légende dans l'espace d'apprentissage automatique.
C'est ainsi que fonctionne le jeu selon lui (il a créé le jeu lui-même en JavaScript):
Le jeu est très simple: le but de l'agent est de faire tomber le ballon au sol du côté de son adversaire, faire perdre la vie à son adversaire. Chaque agent commence avec cinq vies. L'épisode se termine lorsque l'un des agents perd les cinq vies., ou après leur passage 3000 Pas. Un agent reçoit une récompense de +1 lorsque votre adversaire perd ou -1 quand tu perds une vie.

Vous pouvez installer limovolleygym directement de pip:
pip installer slimevolleygym
Voici quelques excellents tutoriels de notre expert résident en apprentissage par renforcement Ankit Choudhary:
Remarques finales
Uf, il y a beaucoup de projets. Mon objectif, comme toujours, était de garder les projets aussi divers que possible afin que vous puissiez choisir ceux qui correspondent à votre parcours en science des données. Si vous êtes débutant, Je vous suggère de commencer par le jeu de données PalmerPenguins, puisque la plupart des gens ne savent même pas en ce moment. Une belle opportunité de commencer avec un avantage.
J'aimerais connaître votre avis sur le projet open source qui vous a été le plus utile.. Ou faites-moi savoir si vous souhaitez que je présente d'autres projets de science des données ici ou dans le numéro du mois prochain..





