
L'open source fait référence à quelque chose que les gens peuvent modifier et partager car ils sont accessibles à tous. Vous pouvez utiliser le travail de nouvelles façons, l'intégrer dans un projet plus vaste ou trouver un nouvel emploi basé sur l'original. L'open source favorise le libre échange d'idées au sein d'une communauté pour générer des innovations ou des idées créatives et technologiques. Donc, Les développeurs devraient envisager de contribuer à des projets open source pour les raisons suivantes:
1. Vous aide à écrire un code plus propre.
2. Mieux comprendre la technologie.
3. Contribuer à des projets open source vous aide à attirer l'attention, popularité et peut s'appuyer sur votre carrière.
4. Ajouter un projet open source à votre CV augmente son poids.
5. Améliorer les compétences de codage
6. Améliorer les logiciels au niveau de l'utilisateur et de l'entreprise.
 La source: Google images
Pour commencer à contribuer à des projets open source, il y a des prérequis:
1. Apprendre un langage de programmation: car dans la contribution open source, vous devez écrire du code pour vous impliquer dans le développement, besoin d'apprendre un langage de programmation. Cela peut être de n'importe quel choix. Il est facile d'apprendre une autre langue à un stade ultérieur en fonction des besoins du projet.
2. Familiarisez-vous avec les systèmes de contrôle de version: ce sont les outils logiciels qui permettent de conserver au même endroit toutes les modifications qui sont apportées pour les récupérer ultérieurement si nécessaire. Essentiellement, suivre chaque modification apportée par vous au fil du temps au code source. Certains systèmes de contrôle de version populaires sont Git, Mercuriel, CVS, etc. De tous ces, Git est le plus populaire et le plus utilisé dans l'industrie.
Nous allons maintenant examiner quelques-uns des incroyables projets open source auxquels vous pouvez contribuer..
Alors commençons!
1. Caliban
La source: Google images
Il s'agit d'un projet d'apprentissage automatique du géant de la technologie Google. Utilisé pour développer des ordinateurs portables et des workflows de recherche en apprentissage automatique dans un environnement informatique isolé et reproductible. Résoudre un gros problème. Quand les développeurs créent des projets de science des données, il est souvent difficile de créer un environnement de test qui peut montrer votre projet dans une situation réelle. Tous les cas extrêmes ne sont pas prévisibles. Ensuite, Caliban est une solution possible à ce problème. Caliban facilite le développement local de n'importe quel modèle d'apprentissage automatique, exécutez du code sur votre machine, puis testez exactement le même code dans un environnement cloud pour qu'il s'exécute sur de grandes machines. Donc, Les workflows d'enquête dockerisés sont simplifiés, à la fois localement et dans le cloud.
Lien Github: https://github.com/google/caliban
2. Cornia
La source: Google images
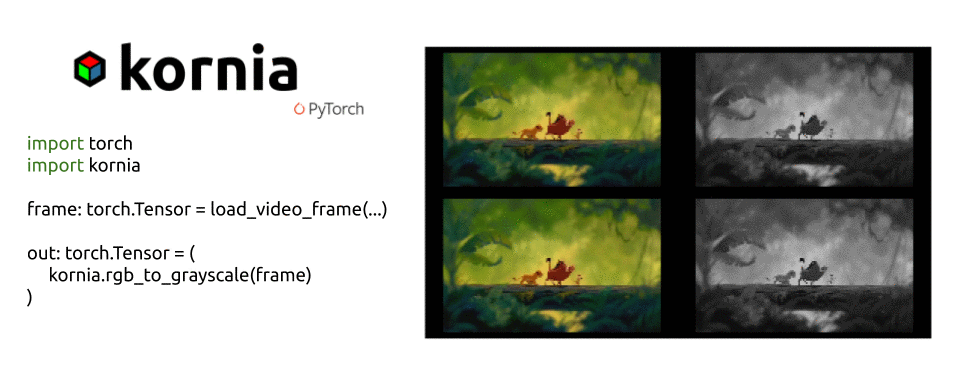
Kornia est une bibliothèque de vision par ordinateur pour PyTorch. Utilisé pour résoudre certains problèmes génériques de vision par ordinateur. Kornia est basé sur PyTorch et s'appuie sur son efficacité et sa puissance CPU pour pouvoir calculer des fonctions complexes. Kornia est un package de bibliothèque utilisé pour former des modèles de réseaux neuronaux et effectuer une transformation d'image, filtrage d'images, détection de contour, géométrie épipolaire, estimation de la profondeur, etc.
Lien Github: https://github.com/kornia/kornia
3. Zoo d'analyse
La source: Google images
Analytics Zoo est une plateforme unifiée d'analyse de données et d'intelligence artificielle qui réunit les programmes TensorFlow, Dur, PyTorche, Étincelle, Flink et Ray dans un pipeline intégré. Cela peut évoluer efficacement d'un ordinateur portable à un grand grappeUn cluster est un ensemble d’entreprises et d’organisations interconnectées qui opèrent dans le même secteur ou la même zone géographique, et qui collaborent pour améliorer leur compétitivité. Ces regroupements permettent le partage des ressources, Connaissances et technologies, favoriser l’innovation et la croissance économique. Les grappes peuvent couvrir une variété d’industries, De la technologie à l’agriculture, et sont fondamentaux pour le développement régional et la création d’emplois.... pour traiter la production de big data. Ce projet est maintenu par Intel-analytique.
Analytics Zoo aide une solution d'IA des manières suivantes:
- Vous aide à prototyper facilement des modèles d'IA.
- La mise à l'échelle est gérée efficacement.
- Aide à ajouter des processus d'automatisation à votre canal ML en tant qu'ingénierie de fonctionnalités, sélection de modèles, etc.
Lien Github: https://github.com/intel-analytics/analytics-zoo
4. Apprentissage automatique automatisé MLJAR pour les humains

La source: Google images
Mljar est une plate-forme de création de modèles de prototypes et de services de mise en œuvre. Pour trouver le meilleur modèle, Mljar recherche différents algorithmes et effectue des ajustements d'hyperparamètres. Fournit des résultats rapides intéressants en exécutant tous les calculs dans le cloud et en créant enfin des modèles d'ensemble. Alors, crée un rapport pour vous à partir de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... d'AutoML. N'est-ce pas cool?
Mljar forme efficacement des modèles pour la classification binaire, classification de plusieurs classes, régression.
Il propose deux types d'interfaces:
- Vous pouvez exécuter des modèles d'apprentissage automatique dans votre navigateur Web
- Fournit un wrapper Python sur l'API Mljar.
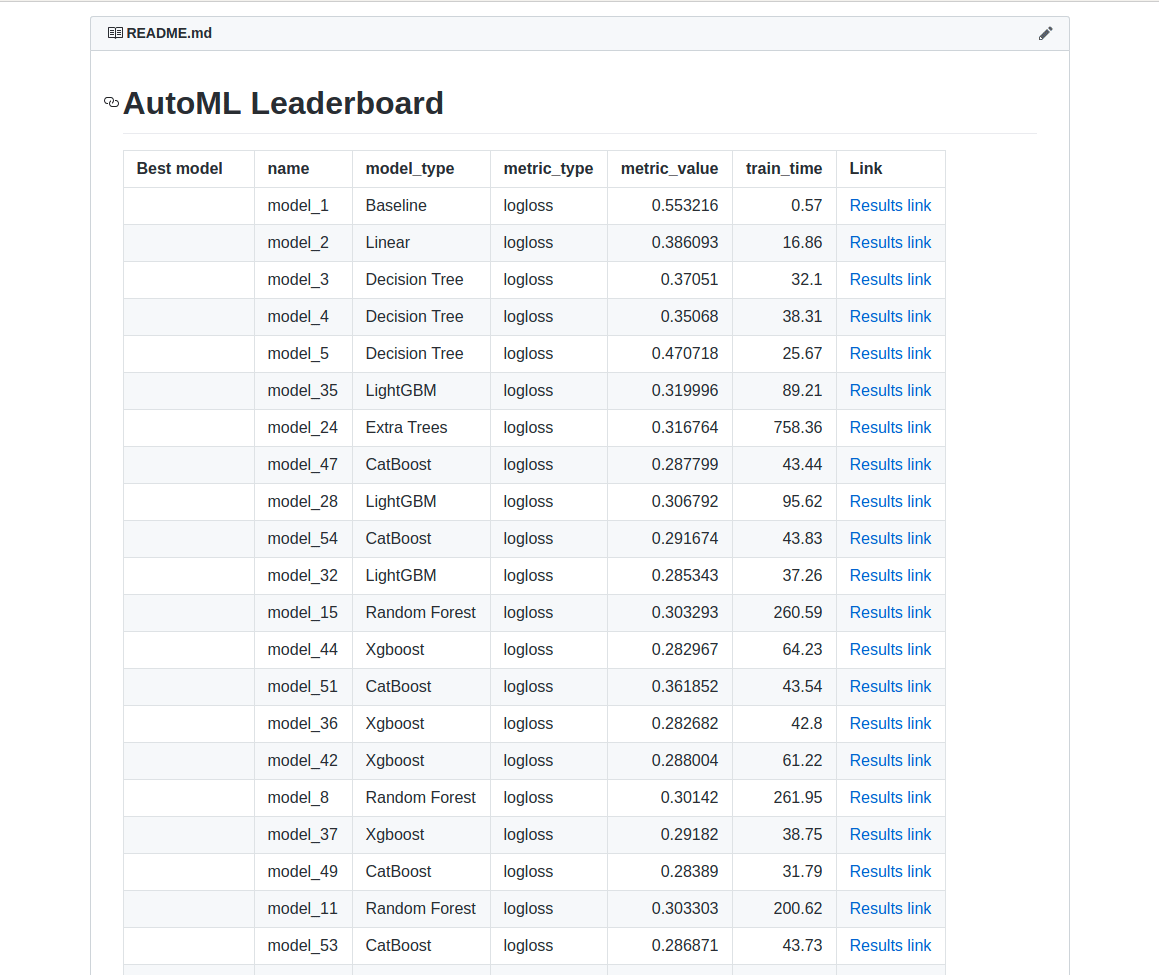
Le rapport reçu de Mljar contient le tableau avec des informations sur le score de chaque modèle et le temps nécessaire pour former chaque modèle. Le rendement est affiché sous forme de nuages de points et de boîtes à moustaches, ce qui permet de vérifier visuellement quels algorithmes fonctionnent le mieux parmi tous. Regarde ça:
La source: Google images
Documentation: https://supervisé.mljar.com/
Code source: https://github.com/mljar/mljar-supervisé
5.DeepDetect
La source: Google images
DeepDetect est une API et un serveur d'apprentissage automatique écrits en C ++. Si vous souhaitez travailler avec des algorithmes d'apprentissage automatique de pointe et que vous souhaitez les intégrer dans des applications existantes, DeepDetect est fait pour vous. DeepDetect prend en charge une grande variété de tâches telles que la classification, segmentationLa segmentation est une technique de marketing clé qui consiste à diviser un large marché en groupes plus petits et plus homogènes. Cette pratique permet aux entreprises d’adapter leurs stratégies et leurs messages aux spécificités de chaque segment, améliorant ainsi l’efficacité de vos campagnes. Le ciblage peut se faire sur des critères démographiques, Psychographique, géographique ou comportementale, Faciliter une communication plus pertinente et personnalisée avec le public cible...., régression, détection d'objets, encodeurs automatiques. Prend en charge le l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... apprentissage supervisé et non supervisé des images, des séries chronologiques, du texte et d'autres types de données. Mais DeepDetect s'appuie sur des bibliothèques d'apprentissage automatique externes telles que:
- Bibliothèques d'apprentissage en profondeur: Tensorflow, Café2, Torche.
- Bibliothèque d'augmentation de données penteLe gradient est un terme utilisé dans divers domaines, comme les mathématiques et l’informatique, pour décrire une variation continue de valeurs. En mathématiques, fait référence au taux de variation d’une fonction, pendant la conception graphique, S’applique à la transition de couleur. Ce concept est essentiel pour comprendre des phénomènes tels que l’optimisation dans les algorithmes et la représentation visuelle des données, permettant une meilleure interprétation et analyse dans...: XGBoost.
- Regroupement avec T-SNE.
Lien Github: https://github.com/jolibrain/deepdetect
6. Dopamine

La source: Google images
Dopamine est un projet open source du géant de la technologie Google. Il est écrit en Python. C'est un cadre de recherche pour la création rapide de prototypes d'algorithmes de apprentissage par renforcementL’apprentissage par renforcement est une technique d’intelligence artificielle qui permet à un agent d’apprendre à prendre des décisions en interagissant avec un environnement. Par le biais de commentaires sous forme de récompenses ou de punitions, L’agent optimise son comportement pour maximiser les récompenses accumulées. Cette approche est utilisée dans une variété d’applications, Des jeux vidéo à la robotique en passant par les systèmes de recommandation, se démarquant par sa capacité à apprendre des stratégies complexes.....
Les principes de conception de la dopamine sont:
- Expérience simple: la dopamine permet aux nouveaux utilisateurs d'effectuer plus facilement des expériences.
- Il est compact et fiable.
- Il facilite également la reproductibilité des résultats.
- C'est souple, donc, permet aux nouveaux utilisateurs d'essayer facilement de nouvelles idées de recherche.
Noter: Regardez ces Cahiers Collaboratifs apprendre à utiliser la dopamine.
Lien Github: https://github.com/google/dopamine
7. TensorFlow
La source: Google images
Tensorflow est le plus connu, populaire et l'un des meilleurs projets d'apprentissage automatique open source sur GitHub. Il s'agit d'une bibliothèque logicielle open source pour le calcul numérique à l'aide de graphiques de flux de données. Il possède une interface Python très facile à utiliser et aucune interface indésirable dans d'autres langages pour créer et exécuter des graphiques de calcul.. TensorFlow fournit des API Python et C stables ++. Tensorflow a des cas d'utilisation étonnants comme:
- En reconnaissance vocale / sonner
- Applications de base de texte
- Reconnaissance d'images
- Détection vidéo
…et beaucoup plus!
Lien GitHub: https://github.com/tensorflow/tensorflow
8. PrédictionIO
La source: Google images
Il est construit sur une pile open source de pointe. Ce serveur d'apprentissage automatique est conçu pour que les scientifiques des données créent des moteurs prédictifs pour toute tâche d'apprentissage automatique.. Certaines de ses caractéristiques étonnantes sont:
- Aide à créer et déployer rapidement un moteur en tant que service Web dans des modèles de production personnalisables.
- Une fois implémenté en tant que service Web, répondre aux requêtes dynamiques en temps réel.
- Prend en charge les bibliothèques de traitement de données et d'apprentissage automatique telles que OpenNLP, Spark MLLib.
- Il simplifie également la gestion de l'infrastructure de données
Lien GitHub: https://github.com/apache/predictionio
9.Scikit-apprendre
La source: Google images
Il s'agit d'une bibliothèque d'outils d'apprentissage automatique gratuits basés sur Python. Fournit divers algorithmes de classification, régression, algorithmes de clustering, y compris les forêts aléatoires, augmentation de la pente, DBSCAN. Ceci est basé sur SciPy qui doit être pré-installé pour que vous puissiez utiliser sci-kit learn. Il propose également des modèles de:
- Méthodes d'ensemble
- Extraction de caractéristiques
- Ajustement de paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet....
- Apprentissage multiple
- Sélection de fonctionnalité
- Réduction de la dimensionnalité
Noter: Pour apprendre sckit-learn, suivre la documentation: https://scikit-learn.org/stable/
Lien GitHub: https://github.com/scikit-learn
10. Pylearn2
Pylearn2 est la bibliothèque d'apprentissage automatique la plus courante parmi tous les développeurs Python. Il est basé sur Theano. Vous pouvez utiliser des expressions mathématiques pour écrire votre complément pendant que Theano prend ou optimisation et stabilisation. Il a des fonctionnalités étonnantes comme:
- Un « algorithme d'entraînement par défaut » pour former le modèle lui-même
-
- Critères d'estimation du modèle
-
- Score correspondant
- Entropie croisée
- Probabilité logarithmique
- Prétraitement de l'ensemble de données
- NormalisationLa normalisation est un processus fondamental dans diverses disciplines, qui vise à établir des normes et des critères uniformes afin d’améliorer la qualité et l’efficacité. Dans des contextes tels que l’ingénierie, Formation et administration, La standardisation facilite la comparaison, Interopérabilité et compréhension mutuelle. Lors de la mise en œuvre des normes, La cohésion est favorisée et les ressources sont optimisées, qui contribue au développement durable et à l’amélioration continue des processus.... du contraste
- Blanchiment ZCA
- Suppression des correctifs (implémenter des algorithmes de type convolution)
Lien GitHub: https://github.com/lisa-lab/pylearn2
Remarques finales:
Contribuer à l'open source vient avec trop de pros. Ensuite, ce sont de bons projets open source pour contribuer.
Merci d'avoir lu si vous êtes arrivé ici
Connectons-nous LinkedIn.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





