
Cet article a été publié dans le cadre du Blogathon sur la science des données
Une anomalie est une observation qui s'écarte significativement de toutes les autres observations. Un système de détection d'anomalies est un système qui détecte les anomalies dans les données. Une anomalie est aussi appelée une valeur aberrante.
Exemple: Disons qu'une colonne de données se compose du revenu mensuel des citoyens et que cette colonne contient également le salaire de Bill Gates. Ensuite, Le salaire de Bill Gates est une valeur aberrante dans ces données.
Algorithmes de détection d'anomalies
Dans ce blog, examinons les algorithmes de détection d'anomalies suivants.
Ce sont quelques-uns des nombreux algorithmes disponibles et ne vous abstenez jamais d'explorer d'autres algorithmes que ceux-ci.
Importez les bibliothèques requises et écrivez les fonctions utilitaires
# détection des valeurs aberrantes python
!pip installer pyod

avertissements d'importation
importer numpy en tant que np
importer des pandas au format pd
de pyod.models.mad import MAD
de pyod.models.knn importer KNN
de pyod.models.lof importer LOF
importer matplotlib.pyplot en tant que plt
depuis sklearn.ensemble importer IsolationForest

# données pour la détection d'anomalies
valeurs_données = [['2021-05-1', 45000.0],
       ['2021-05-2', 70000.0],
       ['2021-05-3', 250000.0],
       ['2021-05-4', 70000.0],
       ['2021-05-5', 45000.0],
       ['2021-05-6', 55000.0],
       ['2021-05-7', 35000.0],
       ['2021-05-8', 60000.0],
       ['2021-05-9', 45000.0],
       ['2021-05-10', 25000.0],
       ['2021-05-11', 142936.0],
       ['2021-05-12', 138026.0],
       ['2021-05-13', 28347.0],
       ['2021-05-14', 40962.66],
       ['2021-05-15', 34543.0],
       ['2021-05-16', 40962.66],
       ['2021-05-17', 25207.0],
       ['2021-05-18', 37502.0],
       ['2021-05-19', 29589.0],
       ['2021-05-20', 78404.0],
       ['2021-05-21', 26593.0],
       ['2021-05-22', 123267.0],
       ['2021-05-23', 46880.0],
       ['2021-05-24', 65361.0],
       ['2021-05-25', 46042.0],
       ['2021-05-26', 48209.0],
       ['2021-05-27', 44461.0],
       ['2021-05-28', 90866.0],
       ['2021-05-29', 46886.0],
       ['2021-05-30', 33456.0],
       ['2021-05-31', 46251.0],
       ['2021-06-1', 29370.0],
       ['2021-06-2', 165620.0],
       ['2021-06-3', 20317.0]]

données = pd.DataFrame(valeurs_données , colonnes=['date', 'amount'])

def fit_model(maquette, Les données, column='amount'):
    # adapter le modèle et le prédire
    df = data.copy()
    data_to_predict = données[colonne].to_numpy().remodeler(-1, 1)
    prédictions = model.fit_predict(data_to_predict)
    df['Predictions'] = prédictions

    retour df

def plot_anomalies(df, x='date', y='amount'):

    # les catégories auront des valeurs de 0 tonne
    # pour chaque valeur dans 0 à n il est mappé dans la palette de couleurs
    catégories = df['Predictions'].to_numpy()
    palette de couleurs = np.array(['g', 'r'])

    f = plt.figure(taille de la figue=(12, 4))
    f = plt.scatter(df[X], df[Oui], c=couleur[catégories])
    f = plt.xlabel(X)
    f = plt.ylabel(Oui)
    f = plt.xticks(rotation=90)
    plt.show()
Les données ci-dessus se composent de deux colonnes, a savoir, date et montant, nous pouvons supposer que les données contiennent le montant des ventes d'une entreprise d'affichage de boulangerie.
A quoi sert la fonction fit_model?
- La fonction fit_model prend le modèle et les données en entrée, ici nous trouvons des anomalies dans la colonne quantité.
- Après cela, change la forme des données en données unidimensionnelles et s'adapte au modèle fourni et prédit les anomalies dans les données et les stocke dans la colonne des prédictions du bloc de données fourni, et le retourne.
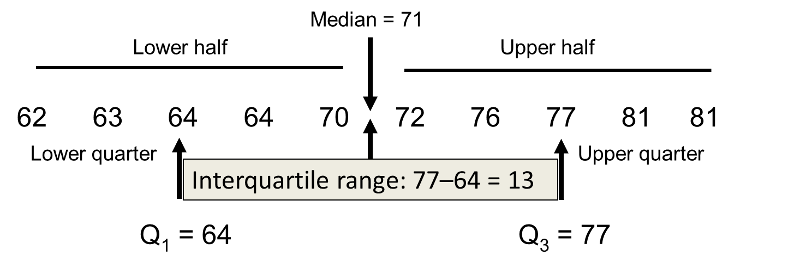
Gamme interquartile
Centiles:
quartile:
-
11er quartile = centile 25
-
2c quartile = centile 50
-
3.1er quartile = centile 75
Gamme interquartile (IQR):
IQR = 3e quartile – 1euh cuartil
Anomalies = [1er quartile – (1.5 * IQR)] O [3e quartile + (1.5 * IQR)]
Les anomalies sont ci-dessous [1er quartile – (1.5 * IQR)] et ci-dessus [3e quartile + (1.5 * IQR)] ces valeurs.
def find_anomalies(valeur, seuil_inférieur, seuil_supérieur):

    si valeur < seuil_inférieur ou valeur > seuil_supérieur:
        revenir 1
    autre: revenir 0

def iqr_anomaly_detector(Les données, column='amount', seuil=1,1):

    df = data.copy()
    quartiles = dict(Les données[colonne].quantile([.25, .50, .75]))
    quartile_3, quartile_1 = quartile[0.75], quartiles[0.25]
    iqr = quartile_3 - quartile_1

    seuil_inférieur = quartile_1 - (seuil * iqr)
    upper_threshold = quartile_3 + (seuil * iqr)

    imprimer(F"Seuil inférieur: {seuil_inférieur}, nSeuil supérieur: {seuil_supérieur}m")

    df['Predictions'] = données[colonne].appliquer(trouver_anomalies, arguments=(seuil_inférieur, seuil_supérieur))
    retour df

iqr_df = iqr_anomaly_detector(Les données)
plot_anomalies(iqr_df)
# sortir
# Seuil inférieur: -2944.050000000003,
# Seuil supérieur: 106441.55
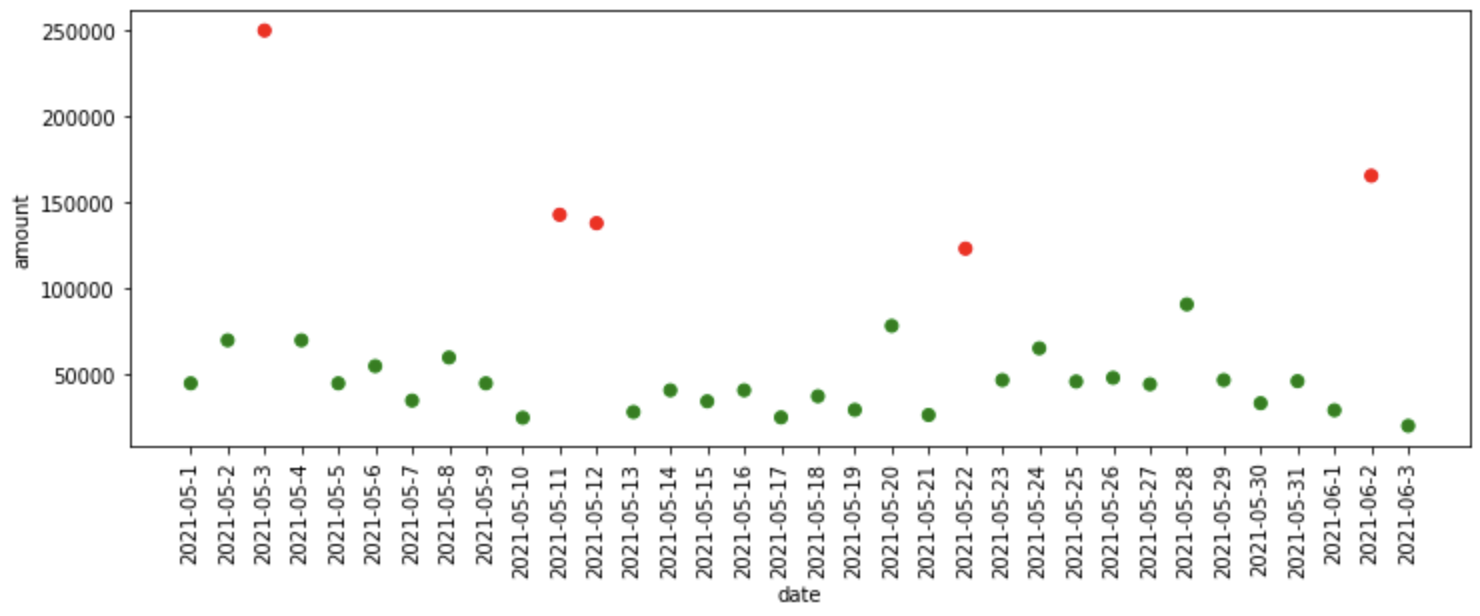
Ce qui s'est passé dans le code ci-dessus?
- En premier lieu, connaître le centile 25 Oui 75, c'est-à-dire, les 1er et 3e quartiles ont été trouvés.
- Et après, on trouve l'intervalle interquartile, qui est la différence entre le troisième et le premier quartile.
- Après cela, on trouve les seuils haut et bas au dessus et en dessous desquels se situent les anomalies, respectivement.
- La fonction find_anomalies ci-dessus trouve les anomalies dans les données selon les seuils donnés.
- Finalement, nous traçons les anomalies trouvées.
Forêt d'isolement
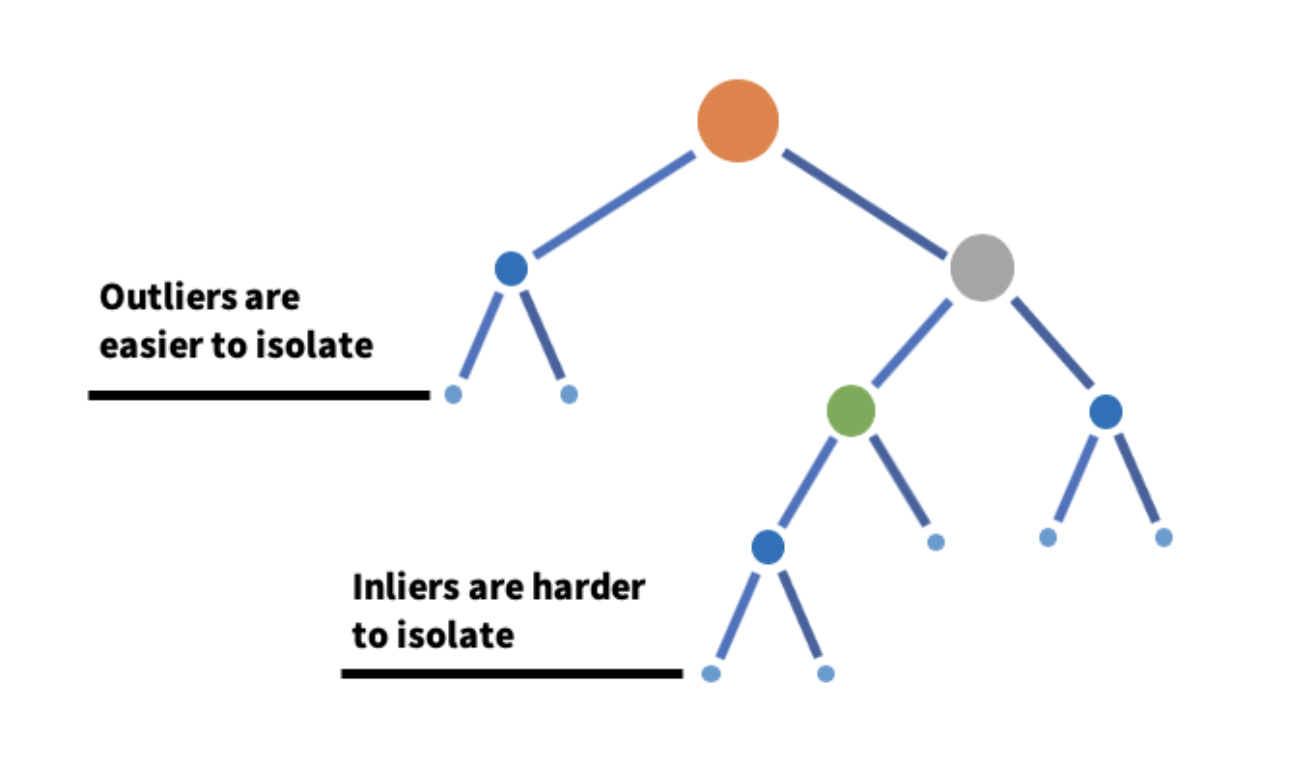
Isolation Forest est un algorithme qui détecte les anomalies en prenant un sous-ensemble de données et en construisant de nombreux arbres d'isolement à partir de celui-ci..
-
L'idée centrale est que les anomalies sont beaucoup plus faciles à isoler que les observations normales et que les anomalies existent à des profondeurs beaucoup plus petites d'un arbre d'isolement.. Un arbre d'isolement est construit en sélectionnant au hasard une caractéristique et en sélectionnant au hasard une valeur de cette caractéristique. Une forêt est construite en ajoutant tous les arbres d'isolement.
iso_forest = Forêt d'isolement(n_estimateurs = 125)
iso_df = fit_model(iso_forêt, Les données)
iso_df['Predictions'] = iso_df['Predictions'].carte(lambda x: 1 si x==-1 sinon 0)
plot_anomalies(iso_df)
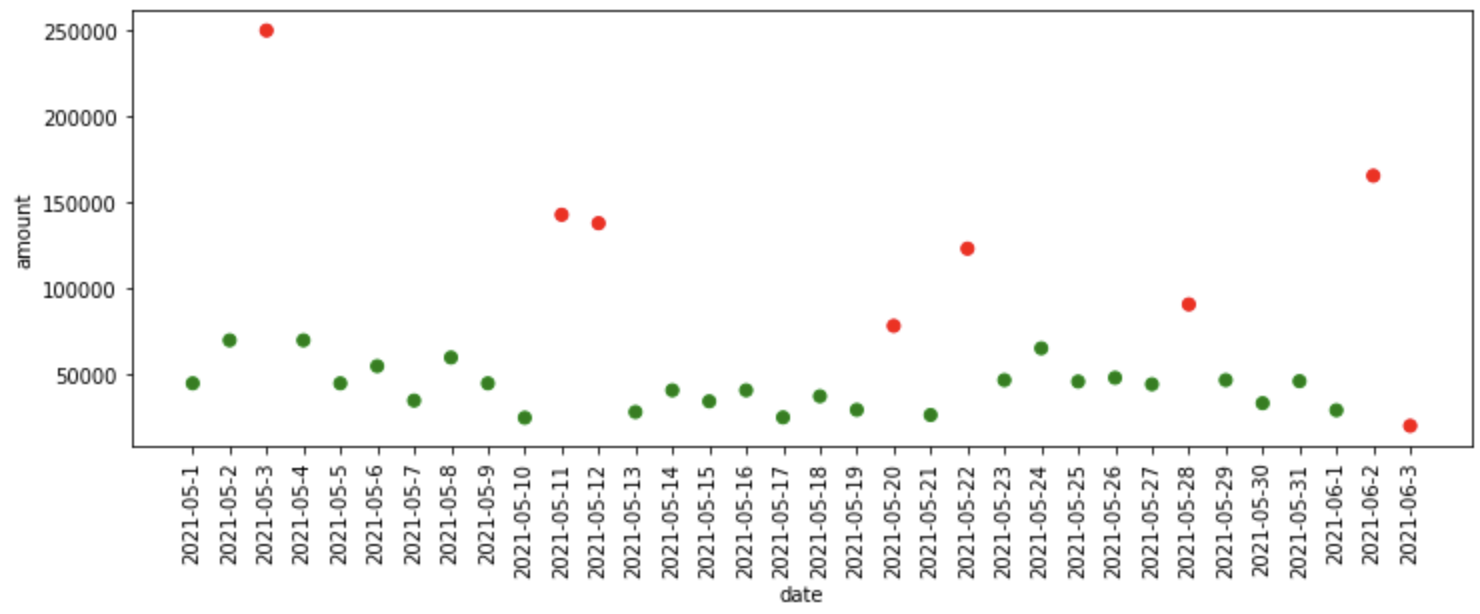
Ce qui s'est passé dans le code ci-dessus?
- Premier, nous définissons le modèle de forêt d'isolement avec 125 arbres d'isolement, puis on passe le modèle, les données comme entrées de la fonction fit_model, où il adapte le modèle aux données et nous fournit des prédictions.
- La forêt d'isolement alloue -1 aux données anormales et 1 aux données normales, donc pour simplifier, nous convertissons la prédiction des données normales (1) une 0 et la prédiction de données anormales (-1) une 1.
- Finalement, nous traçons les anomalies prédites par Isolation Forest.
Écart absolu médian
La desviación absoluta media es la diferencia entre cada observación y la médianLa médiane est une mesure statistique qui représente la valeur centrale d’un ensemble de données ordonnées. Pour le calculer, Les données sont organisées de la plus basse à la plus élevée et le numéro au milieu est identifié. S’il y a un nombre pair d’observations, La moyenne des deux valeurs fondamentales est calculée. Cet indicateur est particulièrement utile dans les distributions asymétriques, puisqu’il n’est pas affecté par les valeurs extrêmes.... de esas observaciones. Une observation qui s'écarte davantage du reste de l'observation est considérée comme une anomalie..
Pourquoi la médiane au lieu de la moyenne?
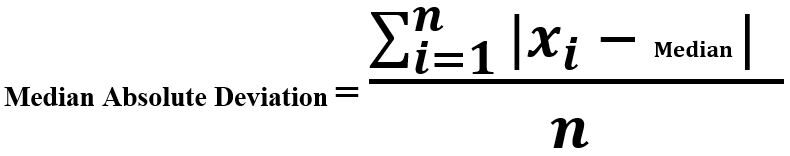
"""Déviation absolue médiane"""
mad_model = MAD()
mad_df = fit_model(mad_model, Les données)
plot_anomalies(mad_df)
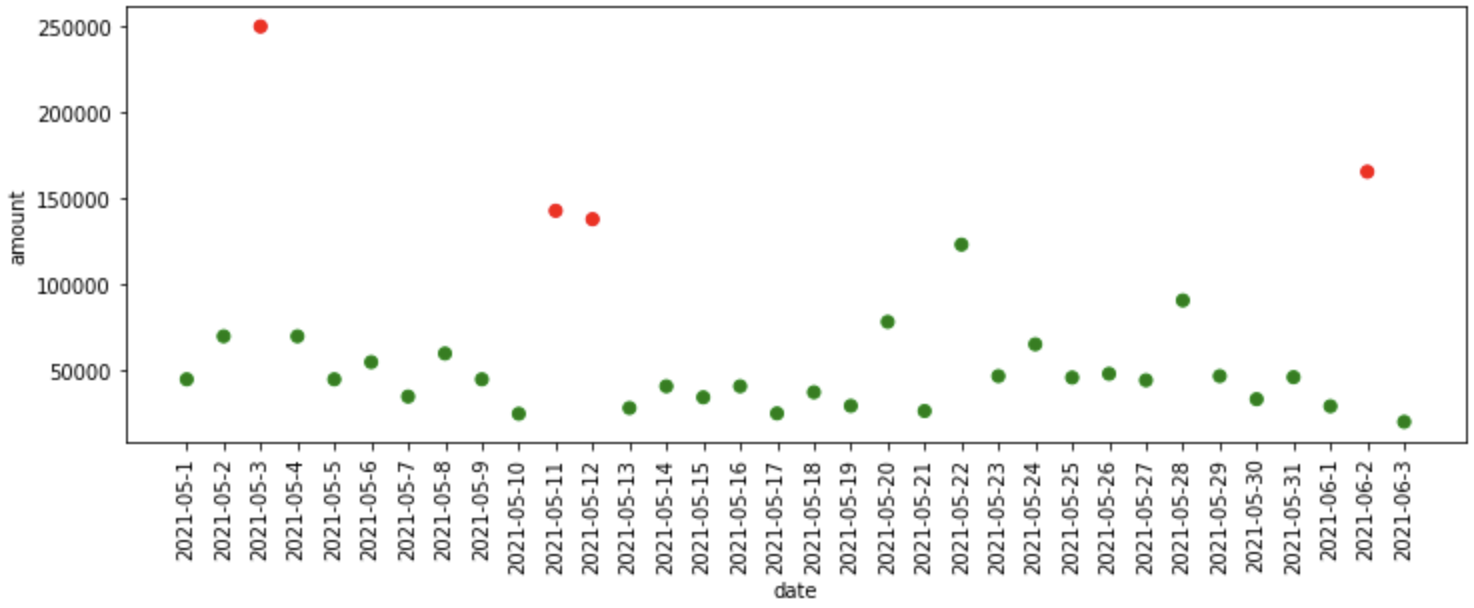
Ce qui s'est passé dans le code ci-dessus?
- Premier, nous définissons le modèle de déviation absolue médiane qui est disponible dans la bibliothèque pyod, puis on passe le modèle, les données comme entrées de la fonction fit_model, où il adapte le modèle aux données et nous fournit des prédictions.
- Finalement, on trace les anomalies prédites par le modèle MAD.
Algorithme K des voisins les plus proches
L'algorithme du K-voisin le plus proche détecte les anomalies en utilisant les distances des K voisins les plus proches comme scores d'anomalie. L'idée est que si une observation est très éloignée des autres observations, alors cette observation est considérée comme une anomalie.
"""Détection des valeurs aberrantes basée sur KNN"""
knn_model = KNN()
knn_df = fit_model(knn_model, Les données)
plot_anomalies(knn_df)
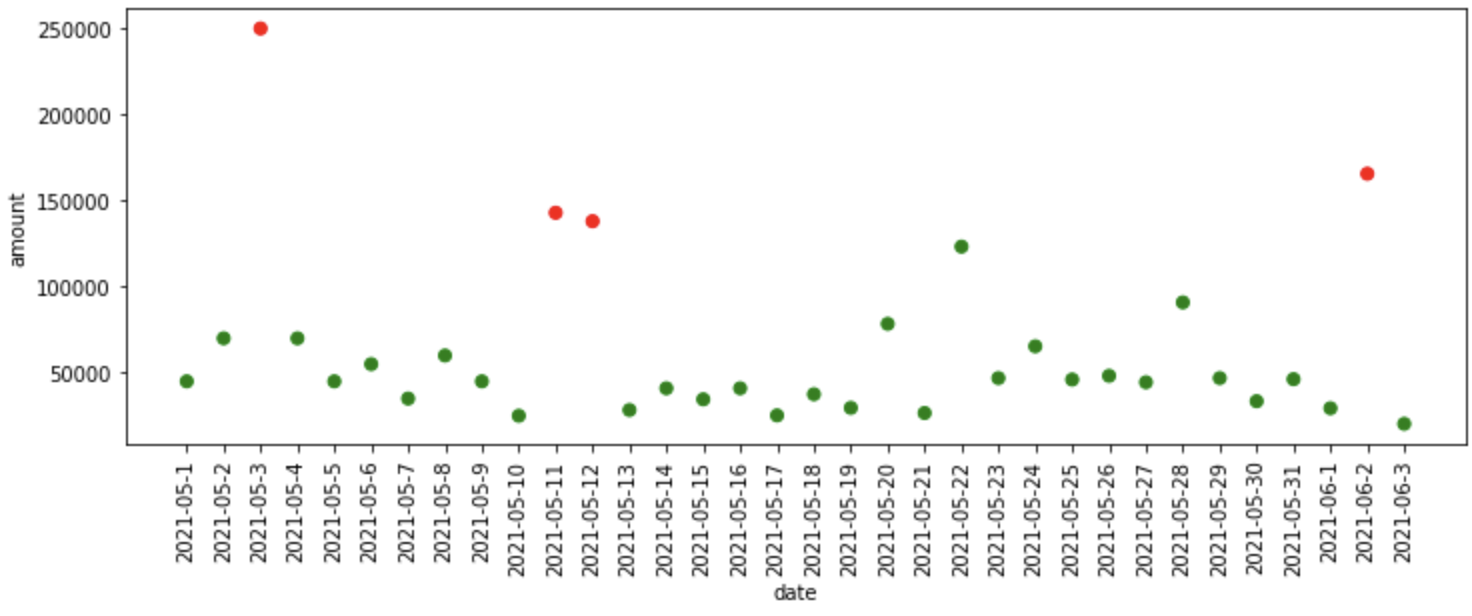
Ce qui s'est passé dans le code ci-dessus?
- Premier, on définit le plus proche voisin modèle K qui est disponible dans la librairie pyod, puis on passe le modèle, les données comme entrées de la fonction fit_model, où il adapte le modèle aux données et nous fournit des prédictions.
- Finalement, on trace les anomalies prédites par le modèle KNN.
Il y a beaucoup de modèles disponibles dans la bibliothèque PyOD comme,
- CBLOF (facteur de valeur aberrante local basé sur le cluster)
- LOF (facteur de valeur aberrante locale)
- HBOS (détection des valeurs aberrantes basée sur l'histogramme)
- OCSVM (SVM d'une classe)
Ne vous abstenez jamais d'expérimenter avec plus d'algorithmes disponibles dans PyOD.
Les implémentations pratiques des algorithmes ci-dessus sont implémentées dans le cahier suivant
Les références
[1] PyOD, Bibliothèque de détection de valeurs atypiques Python
Merci!
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





