
Cet article a été publié dans le cadre du Blogathon sur la science des données
projet. L'EDA est le processus d'enquête sur l'ensemble de données pour découvrir des modèles et des anomalies (Valeurs atypiques) et formuler des hypothèses basées sur notre compréhension de l'ensemble de données.
L'EDA consiste à générer des statistiques récapitulatives pour les données numériques de l'ensemble de données et à créer diverses représentations graphiques pour mieux comprendre les données.. Dans cet article, nous comprendrons EDA à l'aide d'un exemple de jeu de données. nous utiliserons Piton langage (Pandas une bibliothèque) dans ce but.
Importation de bibliothèques
Nous allons commencer par importer les bibliothèques dont nous aurons besoin pour effectuer l'EDA. Ceux-ci incluent NumPy, Pandas, Matplotlib et Seaborn.
importer numpy en tant que np
importer des pandas au format pd
importer matplotlib.pyplot en tant que plt
%matplotlib en ligne
importer seaborn comme sns
Lire les données
Nous allons maintenant lire les données d'un fichier CSV dans un Pandas DataFrame. Vous pouvez télécharger le jeu de données pour votre référence.
df = pd.read_csv(r'C:UsersVipinData AnalyticsStudentsPerformance.csv')
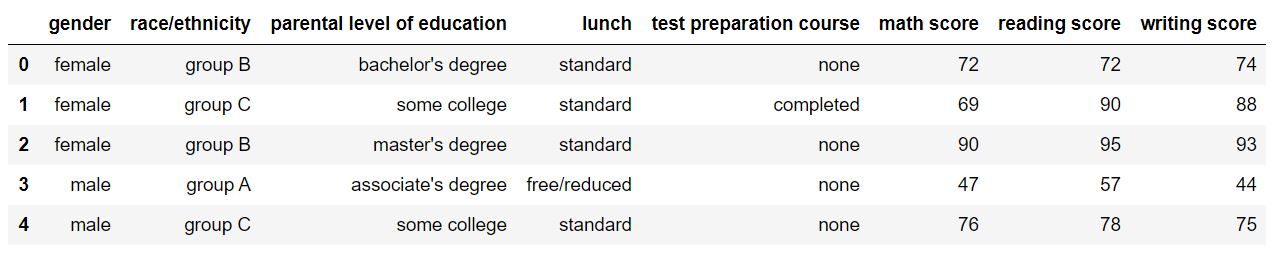
Regardons à quoi ressemble notre ensemble de données en utilisant df.head (). La sortie devrait ressembler à ceci:
Statistiques descriptives
Parfait! Les données ressemblent exactement à ce que nous voulions. Vous pouvez facilement le savoir en regardant simplement l'ensemble de données qui contient des données sur différents élèves d'une école / l'université et leurs notes en 3 sujets. Comencemos mirando los paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... estadísticos descriptivos para el conjunto de datos. Nous utiliserons décrire () pour ca.
df.décrire(inclure="tous")
Al asignar al atributo de inclusión un valor de ‘Tout le monde’, nous veillons à ce que les caractéristiques catégorielles soient également incluses dans le résultat. La sortie DataFrame devrait ressembler à ceci:
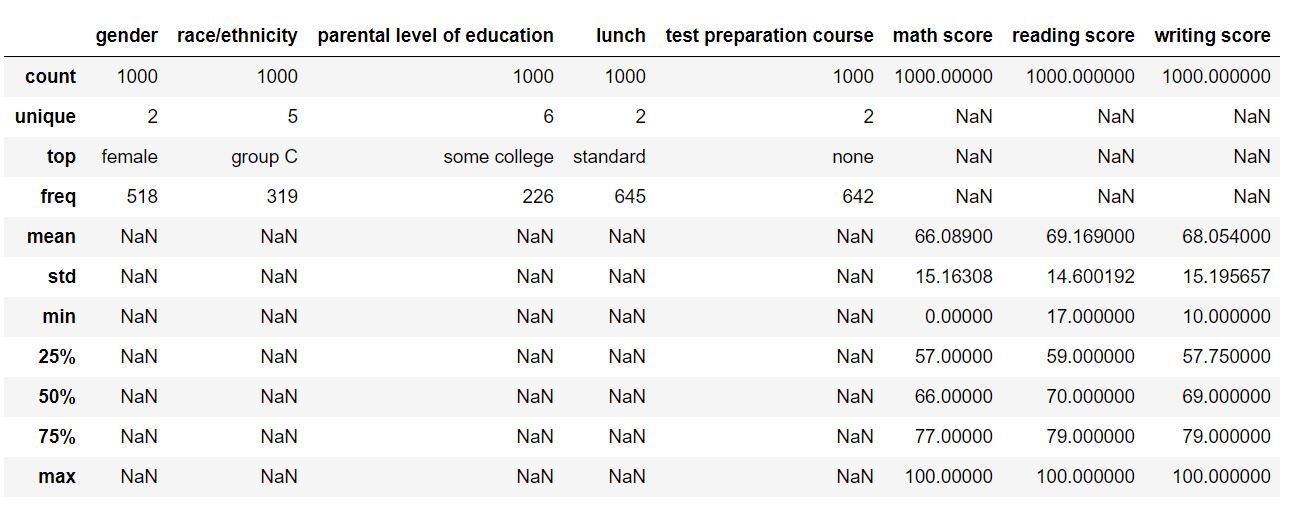
Pour les paramètres numériques, les champs ont été remplis comme la moyenne, l'écart type, les centiles et le maximum. Pour les caractéristiques catégorielles, le décompte est terminé, l'unique, le supérieur (valeur la plus fréquente) et la fréquence correspondante. Cela nous donne une idée générale de notre ensemble de données.
Imputation de la valeur manquante
Maintenant, nous allons vérifier les valeurs manquantes. dans notre jeu de données. En cas de billets manquants, nous les imputerons avec les valeurs appropriées (moda en caso de característica categórica y médianLa médiane est une mesure statistique qui représente la valeur centrale d’un ensemble de données ordonnées. Pour le calculer, Les données sont organisées de la plus basse à la plus élevée et le numéro au milieu est identifié. S’il y a un nombre pair d’observations, La moyenne des deux valeurs fondamentales est calculée. Cet indicateur est particulièrement utile dans les distributions asymétriques, puisqu’il n’est pas affecté par les valeurs extrêmes.... o media en caso de característica numérica). Nous utiliserons la fonction isnull () dans ce but.
df.isnull().somme()
Cela nous dira combien de valeurs manquantes nous avons dans chaque colonne de notre ensemble de données. La sortie (Série Pandas) ça devrait ressembler à ça:
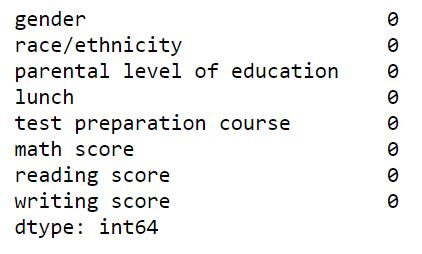
Heureusement pour nous, aucune valeur manquante dans cet ensemble de données. Nous allons maintenant procéder à l'analyse de cet ensemble de données, observer des modèles et identifier les valeurs aberrantes à l'aide de graphiques et de figures.
Représentation graphique
Nous commencerons par Analyse univariée. Nous utiliserons un graphique à barresLe graphique à barres est une représentation visuelle des données qui utilise des barres rectangulaires pour montrer des comparaisons entre différentes catégories. Chaque barre représente une valeur et sa longueur est proportionnelle à celle-ci. Ce type de graphique est utile pour visualiser et analyser les tendances, faciliter l’interprétation des informations quantitatives. Il est largement utilisé dans diverses disciplines, tels que les statistiques, Marketing et recherche, En raison de sa simplicité et de son efficacité.... dans ce but. Nous observerons la répartition des étudiants par sexe, course / ethnie, leur statut de déjeuner et s'ils ont un cours de préparation aux examens ou non.
plt.sous-intrigue(221)

df['sexe'].value_counts().terrain(type='bar', titre="Sexe des étudiants", taille de la figue=(16,9))

plt.xticks(rotation=0)

plt.sous-intrigue(222)

df['race/ethnicity'].value_counts().terrain(type='bar', titre="Race/ethnicité des étudiants")

plt.xticks(rotation=0)

plt.sous-intrigue(223)

df['lunch'].value_counts().terrain(type='bar', titre="Statut du déjeuner des étudiants")

plt.xticks(rotation=0)

plt.sous-intrigue(224)

df['test preparation course'].value_counts().terrain(type='bar', titre="Cours de préparation aux tests")

plt.xticks(rotation=0)

plt.show()
La sortie devrait ressembler à ceci:
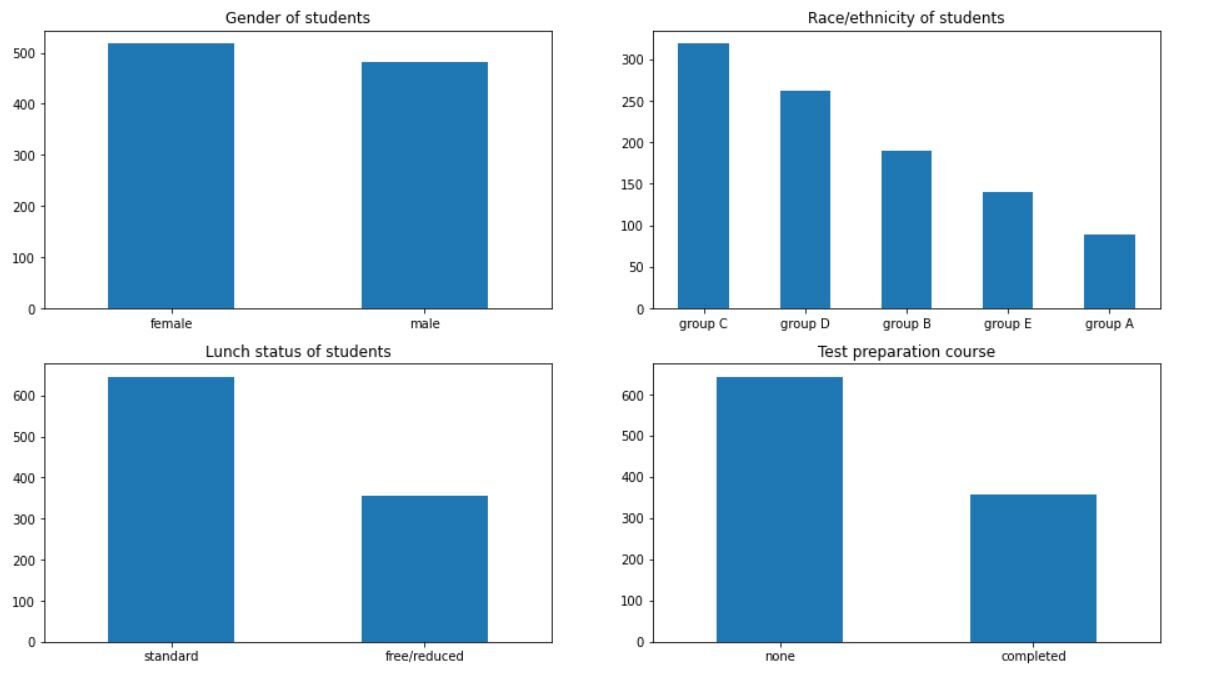
On peut déduire beaucoup de choses du graphique. Il y a plus de filles à l'école que de garçons. La plupart des élèves appartiennent aux groupes C et D. Plus que 60% des élèves ont un déjeuner standard à l'école. En outre, plus que 60% des étudiants n'ont suivi aucun cours de préparation aux examens.
Poursuite de l'analyse univariée, ensuite, nous ferons un boîte à moustaches des colonnes numériques (note en mathématiques, score de lecture et score d'écriture) dans le jeu de données. Une boîte à moustaches nous aide à visualiser les données en termes de quartiles. Identifie également les valeurs aberrantes dans l'ensemble de données, s'il y avait. Nous utiliserons la fonction boxplot () pour ca.
df.boxplot()
La sortie devrait ressembler à ceci:
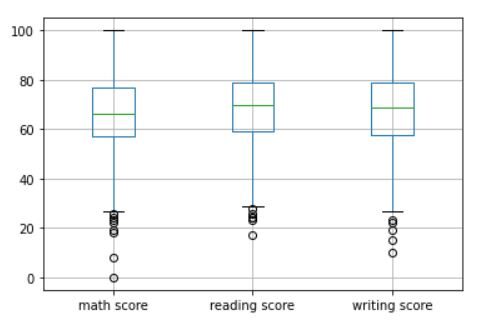
La partie médiane représente l'intervalle interquartile (IQR). La ligne verte horizontale au milieu représente la médiane des données. Les cercles creux près des queues représentent les valeurs aberrantes dans l'ensemble de données. Cependant, car il est tout à fait possible pour un étudiant d'obtenir un score extrêmement bas à un test, nous n'éliminerons pas ces valeurs atypiques.
Maintenant, nous allons faire un parcelle de distribution des notes des élèves en mathématiques. Un diagramme de distribution nous indique comment les données sont distribuées. Nous utiliserons la fonction distplot.
sns.distplot(df['math score'])
L'intrigue dans la sortie devrait ressembler à ceci:
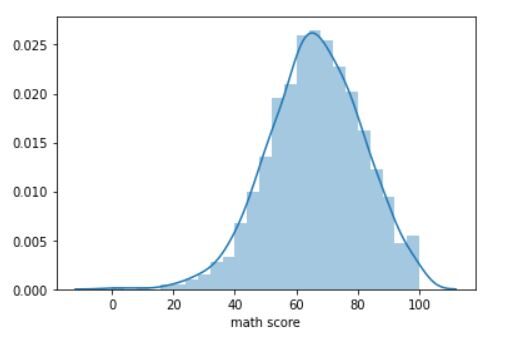
Le graphique représente une courbe en cloche parfaite de près. Le pic est autour 65 points, la moyenne des scores en mathématiques des élèves dans l'ensemble de données. Un graphique de distribution similaire peut également être réalisé pour la lecture et l'écriture des partitions..
Nous allons maintenant voir la corrélation entre 3 scores à l'aide d'un carte de chaleurUn "carte de chaleur" est une représentation graphique qui utilise des couleurs pour montrer la densité des données dans une zone spécifique. Couramment utilisé dans l’analyse de données, Etudes marketing et comportementales, Ce type de visualisation vous permet d’identifier rapidement les modèles et les tendances. Par des variations chromatiques, Les cartes thermiques facilitent l’interprétation de grands volumes d’informations, aider à prendre des décisions éclairées..... Pour ca, nous allons utiliser la fonction corr () y carte thermique () pour cet exercice.
corr = df.corr()
sns.heatmap(corr, annot=Vrai, carré=Vrai)
plt.yticks(rotation=0)
plt.show()
L'intrigue dans la sortie devrait ressembler à ceci:
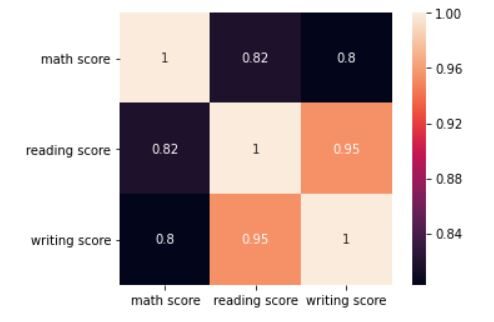
La carte thermique montre que 3 les scores sont fortement corrélés. Le score en lecture a un coefficient de corrélation de 0,95 avec partition d'écriture. Le score en mathématiques a un coefficient de corrélation de 0,82 avec le score de lecture et 0,80 avec partition d'écriture.
Nous allons maintenant passer à Analyse bivariée. Nous allons en regarder un intrigue relationnelle fr Seaborn. Cela nous aide à comprendre la relation entre 2 variables dans différents sous-ensembles de l'ensemble de données. Nous essaierons de comprendre la relation entre la note en mathématiques et la note en écriture des élèves de genres différents.
sns.relplot(x='math score', y='writing score', teinte ="genre", données=df)
L'intrigue relationnelle devrait ressembler à ceci:
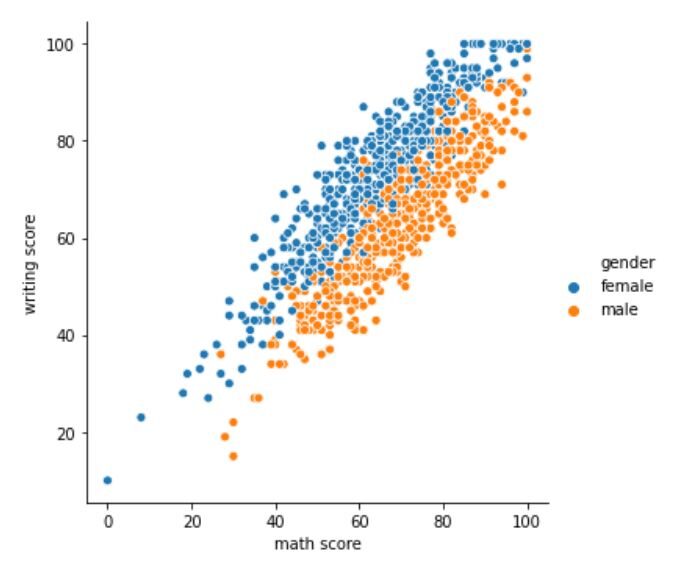
Le graphique montre une nette différence de scores entre les étudiants masculins et féminins. Pour le même score en maths, les étudiantes sont plus susceptibles d'avoir des notes d'écriture plus élevées que les étudiants de sexe masculin. Cependant, pour la même partition d'écriture, les étudiants de sexe masculin devraient obtenir de meilleurs résultats en mathématiques que les étudiants de sexe féminin.
Les graphes relationnels nous aident à effectuer une analyse bivariée. Vous pouvez vous référer à la documentation de la fonction relplot () fr Seaborn ici.
Finalement, nous analyserons les performances des élèves en mathématiques, lecture et écriture selon le niveau d'études de vos parents et le parcours de préparation à l'examen. Premier, Examinons l'impact du niveau d'éducation des parents sur les performances scolaires de leurs enfants à l'aide d'un graphique linéaire.
df.groupby('parental level of education')[['math score', 'reading score', 'writing score']].moyenne().T.plot(taille de la figue=(12,8))
La sortie ressemblera à ceci:
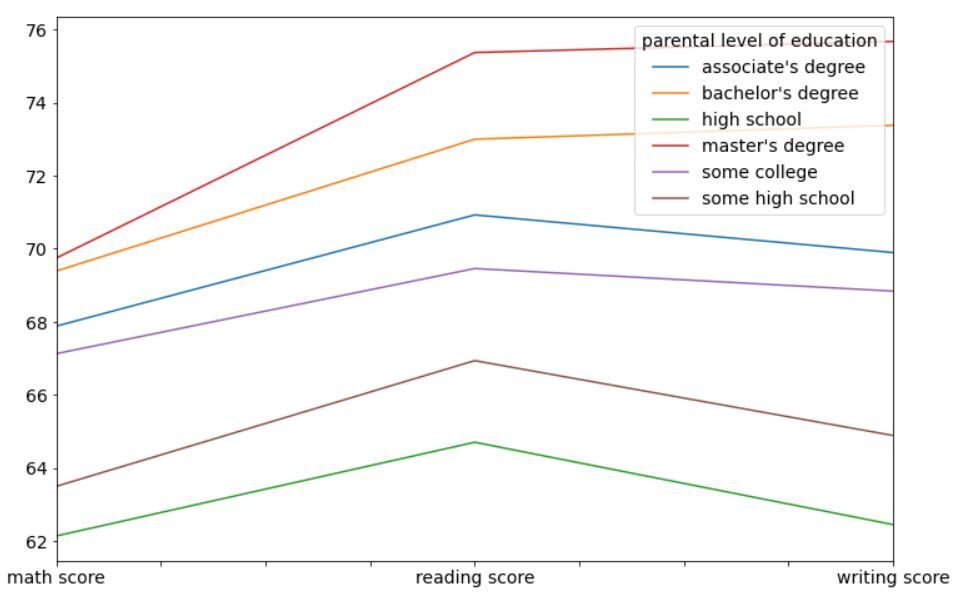
Il ressort très clairement de ce graphique que les élèves dont les parents sont plus instruits que les autres (une maîtrise, baccalauréat et diplôme d'associé) obtiennent de meilleurs résultats en moyenne que les élèves dont les parents sont moins scolarisés (enseignement secondaire). Cela peut être une différence génétique ou simplement une différence dans l'environnement familial des élèves. Les parents plus instruits sont plus susceptibles de pousser leurs élèves vers des études.
En second lieu, Regardons l'impact du cours de préparation au test sur les performances des étudiants à l'aide d'un graphique à barres horizontales.
df.groupby('test preparation course')[['math score', 'reading score', 'writing score']].moyenne().T.plot(kind='barh', taille de la figue=(10,10))
La sortie devrait ressembler à ceci:
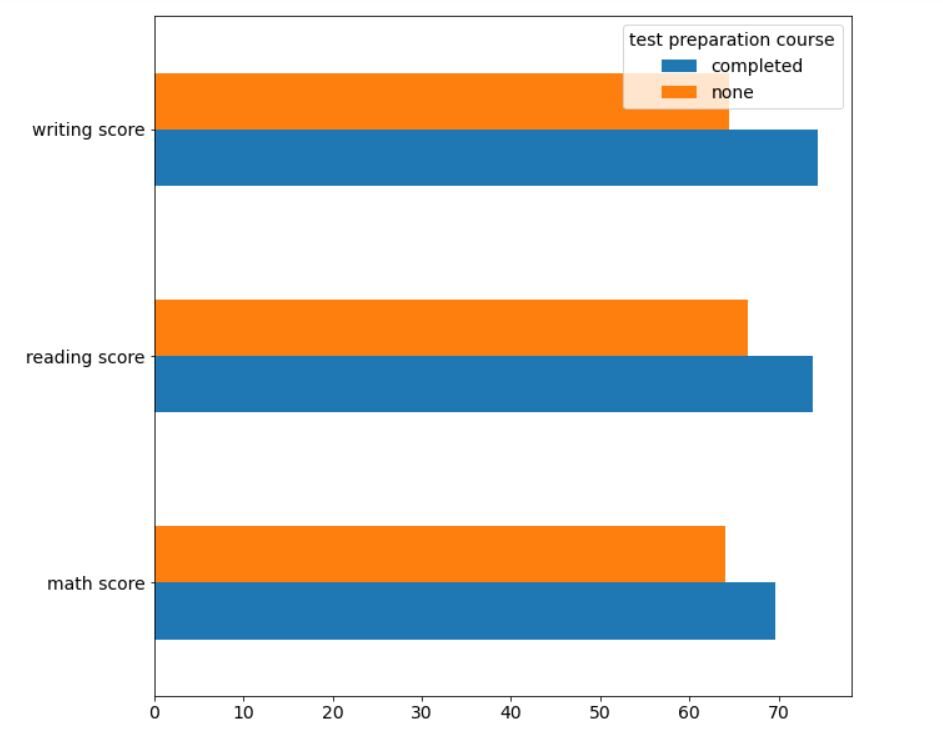
Une fois de plus, il est très clair que les étudiants qui ont terminé le cours de préparation aux examens ont obtenu de meilleurs résultats, En moyenne, par rapport aux étudiants qui n'ont pas opté pour le cours.
Remarques finales
Dans cet article, nous avons compris le sens de l'analyse exploratoire des données (AED) à l'aide d'un échantillon de données. Nous regardons comment nous pouvons analyser l'ensemble de données, en tirer des conclusions et formuler une hypothèse basée sur cette.
L'auteur de cet article est Vishesh Arora. Vous pouvez me joindre à LinkedIn.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





