
L'une des questions les plus courantes, cela se fait en plusieurs forums de science des données il est:
Quelle est la différence entre l'apprentissage automatique et la modélisation statistique?
j'ai fait des recherches pour la dernière 2 ans. Généralement, Il ne me faut pas plus d'une journée pour obtenir une réponse claire au sujet que je recherche. Malgré cela, c'était certainement l'une des noix les plus difficiles à casser. Quand je suis tombé sur cette question au début, J'ai à peine trouvé une réponse claire qui puisse déterminer en quoi l'apprentissage automatique diffère de la modélisation statistique. Étant donné la similitude en termes d'objectif que les deux tentent de résoudre, la seule différence réside dans le volume de données impliquées et la participation humaine pour construire un modèle. Voici un diagramme de Venn intéressant sur la couverture de l'apprentissage automatique et de la modélisation statistique dans l'univers de la science des données (Référence: Institut SAS)
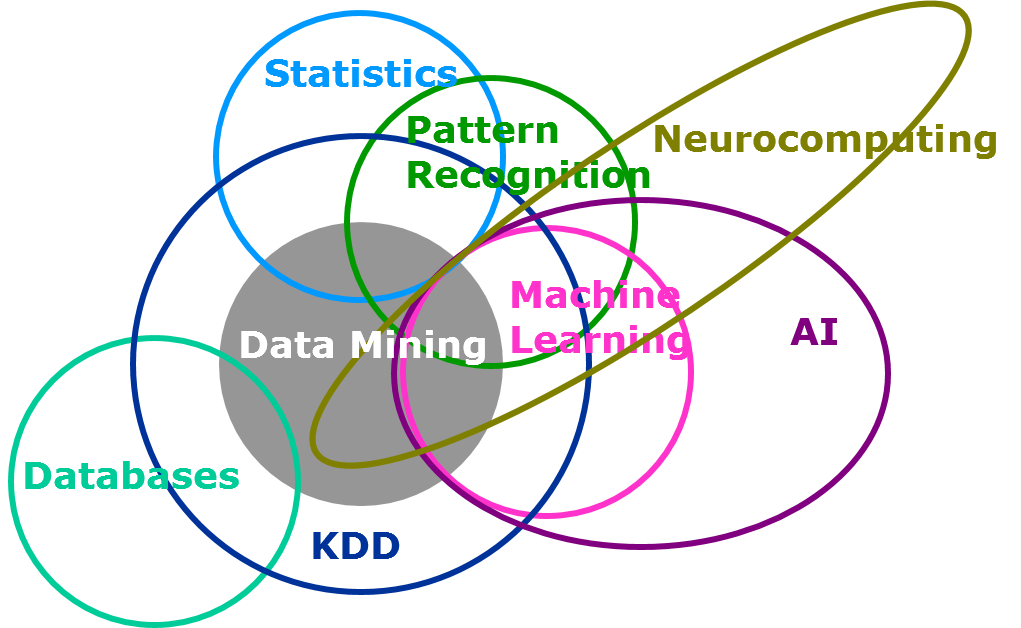
Dans ce billet, Je vais essayer de mettre en évidence la différence entre les deux du mieux que je peux.. J'encourage les personnes les plus expérimentées de cette industrie à ajouter à ce post pour souligner la différence.
Avant de commencer, comprenons l'objectif derrière ce que nous essayons de résoudre pour utiliser l'un de ces outils. L'objectif commun à l'utilisation de l'un ou l'autre de ces outils est Apprendre des données. Les deux approches visent à connaître les phénomènes sous-jacents grâce à l'utilisation des données générées dans la procédure..
Maintenant qu'il est clair que l'objectif de chaque approche est le même, Passons en revue sa définition et ses différences.
avant de continuer: Bases de l'apprentissage automatique pour les débutants
Définition:
Commençons par des définitions simples:
L'apprentissage automatique est …
un algorithme qui peut apprendre des données sans s'appuyer sur une programmation basée sur des règles.
La modélisation statistique est …
formalisation des relations entre variables sous forme d'équations mathématiques.
Pour les gens comme moi, qui aiment comprendre les concepts à partir d'applications pratiques, ces définitions n'aident pas beaucoup. Ensuite, voyons une analyse de rentabilisation ici.
Une analyse de rentabilisation
Regardons maintenant un exemple intéressant rendu public par McKinsey différenciant les deux algorithmes:
Cas : Comprendre le niveau de risque de désabonnement des clients sur une période de temps pour une entreprise de télécommunications.
Données disponibles : Deux conducteurs: A et B
Ce que McKinsey montre ci-dessous est un délice absolu !! Il suffit de regarder le graphique ci-dessous pour comprendre la différence entre un modèle statistique et un algorithme d'apprentissage automatique..
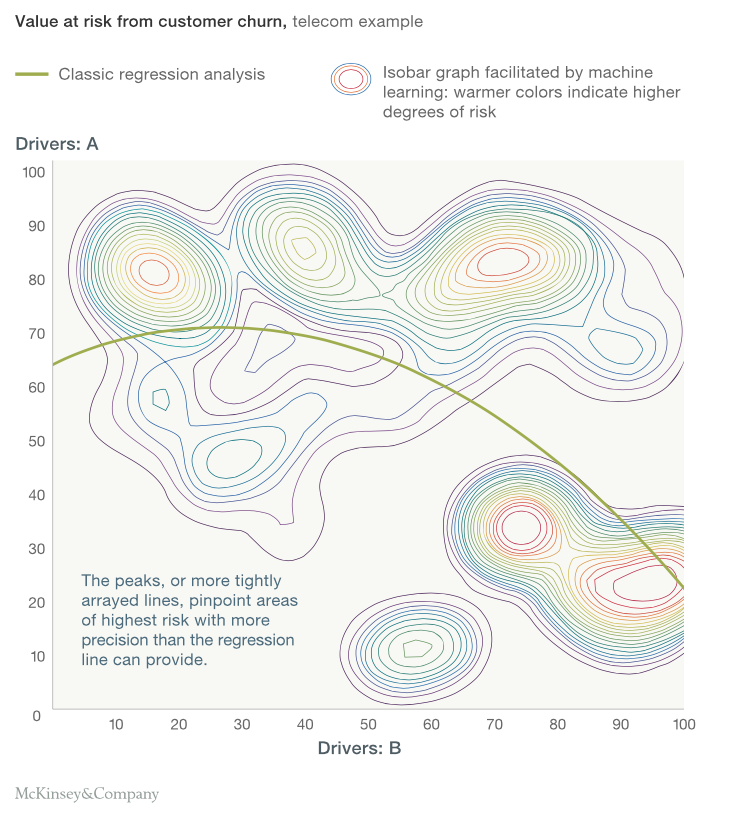
Qu'avez-vous observé dans le graphique précédent? Le modèle statistique consiste à obtenir une formulation simple d'une frontière dans un modèle de classification obstacle. Ici, nous voyons une limite non linéaire qui, Dans une certaine mesure, sépare les personnes à risque des personnes sans risque. Mais quand on voit les contours générés par l'algorithme de Machine Learning, on constate que la modélisation statistique n'est pas comparable pour le problème en question avec l'algorithme de Machine Learning. Les contours d'apprentissage automatique semblent capturer tous les modèles au-delà des limites de la linéarité ou même de la continuité des limites. Voici ce que l'apprentissage automatique peut faire pour vous.
Si ce n'est pas assez d'inspiration, l'algorithme d'apprentissage automatique est utilisé dans les moteurs de recommandation YouTube / Google, etc., qui peut générer des milliards d'observations en une seconde pour arriver à une recommandation presque parfaite. Même avec un ordinateur portable de 16 Go de RAM, je travaille quotidiennement sur des ensembles de données de plusieurs millions de lignes avec des centaines de paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... et je construis un modèle complet en pas plus de 30 minutes. Un modèle statistique, d'autre part, vous avez besoin d'un supercalculateur pour exécuter un million d'observations avec un millier de paramètres.
Différences entre l'apprentissage automatique et la modélisation statistique:
Vu le goût de la différence dans la production de ces deux approches, comprenons la différence entre les deux paradigmes, même s'ils font tous les deux un travail presque équivalent:
- Les écoles d'où ils viennent
- Quand sont-ils apparus?
- Hypothèses dans lesquelles ils travaillent
- Type de données qu'ils traitent
- Nomenclatures des caractéristiques et des objets
- Techniques utilisées
- Pouvoir prédictif et efforts humains impliqués pour le mettre en pratique
Toutes les différences mentionnées précédemment séparent les deux dans une certaine mesure., mais il n'y a pas de ligne dure entre l'apprentissage automatique et la modélisation statistique.
Ils appartiennent à des écoles différentes
L'apprentissage automatique est …
un sous-domaine de l'informatique et de l'intelligence artificielle qui est responsable de la construction de systèmes capables d'apprendre des données, au lieu d'instructions explicitement programmées.
La modélisation statistique est …
un sous-domaine des mathématiques qui est chargé de trouver des relations entre les variables pour prédire un résultat
Ils sont apparus à des moments différents
La modélisation statistique existe depuis des siècles. Malgré cela, l'apprentissage automatique est un développement très récent. Il est apparu au cours de la décennie de 1990 lorsque les progrès constants de la numérisation et de la puissance de calcul bon marché ont permis aux scientifiques des données d'arrêter de construire des modèles finis et, en échange, former des ordinateurs pour le faire. Le volume et la complexité ingérables des mégadonnées dans lesquelles le monde nage a augmenté le potentiel et le besoin d'apprentissage automatique.
Portée des hypothèses impliquées
La modélisation statistique fonctionne avec un certain nombre d'hypothèses. Par exemple, une régression linéaire suppose:
- Lien linéaire entre variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... indépendant et dépendant
- Homocedasticité
- Erreur moyenne à zéro pour chaque valeur dépendante
- Indépendance des observations
- L'erreur doit être répartie uniformément pour chaque valeur de la variable dépendante.
Équivalent, les régressions logistiques viennent avec leur propre ensemble d'hypothèses. Même un modèle non linéaire doit respecter une limite de ségrégation continue. Les algorithmes d'apprentissage automatique supposent certaines de ces choses, mais en général, ils sont sauvés de la plupart de ces hypothèses. Le plus grand avantage de l'utilisation d'un algorithme d'apprentissage automatique est qu'il n'y a pas de continuité possible avec les limites, comme le montre l'étude de cas ci-dessus.. En même temps, nous n'avons pas besoin de spécifier la distribution de la variable dépendante ou indépendante dans un algorithme d'apprentissage automatique.
Types de données avec lesquelles ils traitent
Les algorithmes d'apprentissage automatique sont des outils très variés. Les outils d'apprentissage en ligne prédisent les données à la volée. Ces outils sont capables d'apprendre à partir de milliards d'observations une par une. Ils font des prédictions et apprennent simultanément. D'autres algorithmes comme Random Forest et Gradient Boosting sont également exceptionnellement rapides avec le Big Data.. L'apprentissage automatique fonctionne très bien avec de larges (grand nombre d'attributs) et profond (grand nombre d'observations). Malgré cela, les modèles statistiques sont généralement appliqués pour des données plus petites avec moins d'attributs ou finissent par sur-ajuster.
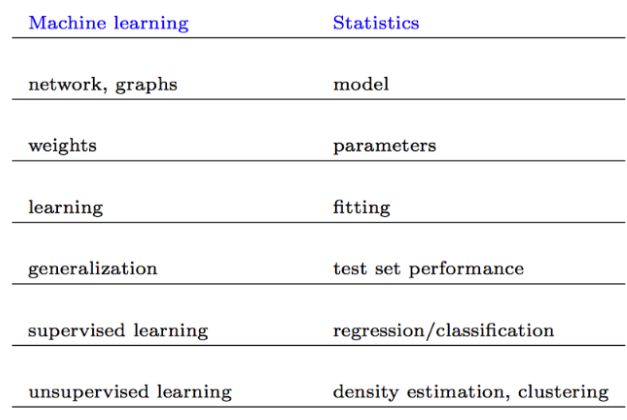
Convention de nommage
Voici des noms qui font référence à presque les mêmes choses:
Formulation
Même lorsque l'objectif final de l'apprentissage automatique et de la modélisation statistique est le même, la formulation de deux est significativement différente.
Dans un modèle statistique, on essaie simplement d'estimer la fonction f dans
Variable dépendante ( Oui ) = f(Variable indépendante) + fonction d'erreur
L'apprentissage automatique supprime la fonction déterministe « F » de l'équation. ça devient juste
Sortir(Oui) ----- > Saisir (X)
Il va essayer de trouver des sacs de X en n dimensions (où n est le nombre d'attributs), où l'occurrence de Y est significativement différente.
Puissance prédictive et effort humain
La nature n'assume rien avant de forcer un événement à se produire.
Ensuite, le moins d'hypothèses dans un modèle prédictif, plus le pouvoir prédictif est grand. Apprentissage automatique, comme le nom le suggère, nécessite un effort humain minimal. L'apprentissage automatique fonctionne par itérations dans lesquelles l'ordinateur essaie de découvrir des modèles cachés dans les données. Parce que la machine fait ce travail avec des données complètes et est indépendante de toutes les hypothèses, le pouvoir prédictif est généralement très fort pour ces modèles. Le modèle statistique est intensif en mathématiques et est basé sur l'estimation de coefficients. Vous avez besoin que le modélisateur comprenne la liaison entre les variables avant de les saisir.
Remarques finales
Malgré cela, il peut sembler que l'apprentissage automatique et la modélisation statistique soient deux branches différentes de la modélisation prédictive, ils sont presque les mêmes. La différence entre les deux s'est considérablement réduite au cours de la dernière décennie. Les deux branches ont beaucoup appris l'une de l'autre et se rapprocheront à l'avenir. J'espère vous avoir suffisamment motivé pour acquérir des compétences dans chacun de ces deux domaines, puis comparer leur complémentarité..
Si vous souhaitez obtenir des algorithmes d'apprentissage automatique, Nous avons ce dont vous avez besoin. Nous sommes en train de créer un parcours d'apprentissage pour l'apprentissage automatique qui sera bientôt publié..
Dites-nous ce que vous pensez être la différence entre l'apprentissage automatique et la modélisation statistique. Avez-vous des études de cas pour souligner les différences entre les deux?





