
Mon père hésite toujours lorsqu'il effectue des transactions coûteuses en ligne. Il a toujours peur que la machine fasse une erreur. Imaginez que vous transfériez tous vos actifs financiers d'un compte à un autre et, en raison d'une erreur de données, est transféré sur le compte de quelqu'un d'autre. Cependant, je ne doute pas une seconde à réaliser tout type de transactionLa "transaction" fait référence au processus par lequel un échange de biens a lieu, services ou argent entre deux ou plusieurs parties. Ce concept est fondamental dans le domaine économique et juridique, puisqu’il implique un accord mutuel et la prise en compte de conditions spécifiques. Les transactions peuvent être formelles, sous forme de contrats, ou informel, et sont essentielles au fonctionnement des marchés et des entreprises.... en ligne. Qu'est-ce qui a fait une si grande différence dans nos perceptions? La raison en est probablement la grande précision de telles transactions dont j'ai été témoin depuis mon plus jeune âge.. Qu'est-ce qui fait que ces myriades de transactions effectuées dans les banques, avec les compagnies aériennes, avec le commerce électronique sont aussi précis?
Dans une large mesure, cela est dû au SGBDR, qui adhère strictement aux principes ACID (atomicité, cohérence, isolation et durabilité). Mais au fil du temps en raison de la forte pression de la croissance des données, nous avons commencé à utiliser des bases de données NoSQL. NoSQL élimine le besoin d'un schéma, donc, pousse la capacité de gestion des données de manière considérable margeLa marge est un terme utilisé dans divers contextes, comme la comptabilité, Économie et imprimerie. En comptabilité, fait référence à la différence entre les revenus et les coûts, qui permet d’évaluer la rentabilité d’une entreprise. Dans le domaine de l’édition, La marge est l’espace blanc autour du texte d’une page, qui le rend facile à lire et offre une présentation esthétique. Sa bonne gestion est essentielle.. en compromettant l'ACID. Cependant, avec des applications de support précises mises en œuvre, NoSQL offre une bonne combinaison de capacités de traitement de données élevées avec une bonne précision. Dans cet article, nous discuterons des bases de données NoSQL populaires.
Crédit d'image: http://www.tomsitpro.com
Formulaire complet NoSQL?
NoSQL n'a pas réellement de forme complète ni même de sens réel. Le terme a été accidentellement inventé lors d'un événement organisé par Johan Oskarsson pour discuter du réseau distribué open source.. Le "#NoSQL" n'était qu'un hashtag Twitter pour accueillir cette réunion. Alors, certaines personnes de la base de donnéesUne base de données est un ensemble organisé d’informations qui vous permet de stocker, Gérez et récupérez efficacement les données. Utilisé dans diverses applications, Des systèmes d’entreprise aux plateformes en ligne, Les bases de données peuvent être relationnelles ou non relationnelles. Une bonne conception est essentielle pour optimiser les performances et garantir l’intégrité de l’information, facilitant ainsi la prise de décision éclairée dans différents contextes.... lors de cette réunion, elles ont trouvé ce hashtag approprié pour nommer ces bases de données non relationnelles. Nous n'avons pas vraiment de définition stricte pour NoSQL. Cependant, Voici quelques caractéristiques communes des bases de données NoSQL:
1. ils ne sont pas relationnels
2. Principalement open source
3. Tous conviennent aux clusters
4. Ce sont moins des schémas
5. Ils ont émergé du monde du Web du 21e siècle.
Cependant, nous nous référons souvent à NoSQL comme sans schéma, cela ne signifie pas que ces bases de données n'adhèrent à aucun type de schéma. Par exemple, considérez l'expression NoSQL suivante:
Tab1["Revenu" ] * Tab1["Le compte total"]
NoSQL a un schéma implicite, qui peut ne pas être constant dans toute la base de données. Une telle chose est à la fois une bénédiction et une malédiction. L'essentiel est que chaque fois que nous voulons modifier un champ, nous devons comprendre ce schéma implicite. La bonne chose est qu'avec un schéma changeant, beaucoup moins d'efforts sont nécessaires pour ajouter cette base de données par rapport au SGBDR. En outre, Le SGBDR n'est pas génial avec un réseau distribué, ce qui n'est pas le cas avec NoSQL.
Types de bases de données NoSQL
Cependant, dans la littérature NoSQL a été divisé en 4 types principaux, J'ai trouvé une manière très intéressante suggérée par Martin Fowler de catégoriser NoSQL. Basé sur la façon dont NoSQL stocke les données, Il est principalement de deux types:
1. Base de données ajoutée
2. Base de données basée sur des graphiques
La principale différence entre les deux est que dans le type d'agrégat, la base de données essaie de stocker toutes les informations pour un identifiant particulier (ça peut être une personne, une transaction ou un produit, etc.) comme un seul objet. Alors que le type de graphique suit la philosophie exactement opposée. La base de données graphique essaie de découper les données en informations très granulaires et les stocke avec toutes les relations ou bords partagés. Nous discuterons des bases de données ajoutées, qui sont plus fréquents aujourd'hui, dans cet article.
Bases de données agrégées
Prenons un exemple pour comprendre ce concept de base de données agrégée. Voici à quoi ressemble un article sur analyticsvidhya:
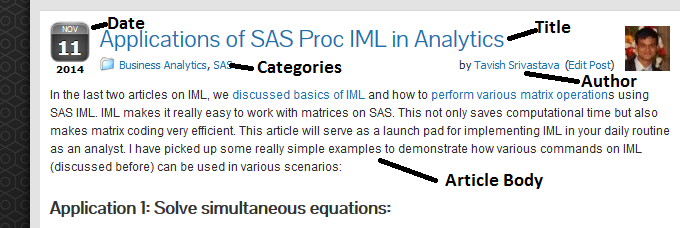 Si nous utilisions le SGBDR pour stocker nos données pour DataPeaker, nous aurions créé des tables relationnelles. On peut être pour des informations liées à l'auteur, un autre peut concerner les informations relatives à l'article et un autre peut correspondre à chaque catégorie. Mais quand on ouvre un article, nous avons besoin de toutes ces informations ensemble. Donc, nous sommes plus intéressés par les informations agrégées que par les informations si granulaires. Cependant, des informations granulaires auraient pu me donner un meilleur champ d'analyse, donc vous pourriez être plus intéressé à minimiser le temps de chargement de la page Web. Donc, nous avons besoin d'une base de données dans laquelle toutes ces informations sont stockées en un seul endroit. Cela peut être appelé bases de données orientées agrégat.
Bases de données de valeurs clés / Bases de données documentaires :
Les bases de données de valeurs clés et les bases de données de documents sont très similaires. Vous pouvez considérer les bases de données de documents comme une forme imbriquée de bases de données de valeurs clés. Ensuite, une base de données clé-valeur simple est affichée:
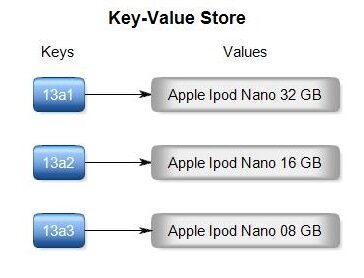
Crédit d'image: http://nosql.rishabhagrawal.com
À présent, si je veux obtenir des informations sur un Ipod depuis 16 FR, J'ai juste besoin de fournir le KET « 13a2 » à la base de données. Voici à quoi ressemblera une base de données de documents:
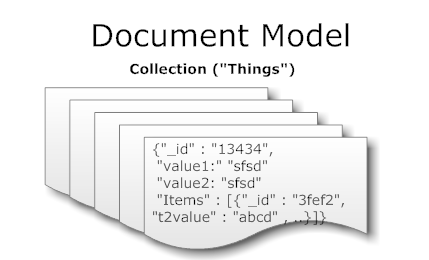
Gardez à l'esprit que dans chaque document, nous avons agrégé des informations sur cette identification. Liez ceci avec notre exemple analyticsvidhya. Dans notre cas, nous aurons tous le nom de l'auteur, nom du titre, etc. sous forme de paires clé-valeur dans chaque document. Maintenant, je peux extraire tout le document à la fois, puisqu'il est stocké dans le même objet.
Bases de données orientées colonnes :
Supposons que vous ayez une table de commande RDBMS avec 1 millions de lignes et 100 Colonnes. Vous voulez maintenant extraire tous les noms des clients avec des commandes de plus de $ 500. Essentiellement, besoin d'une commande dans seulement deux colonnes, mais pour faire cette requête, essentiellement, vous devrez naviguer dans le 100 Colonnes. Les bases de données orientées colonnes apportent une solution à ce problème. Une discussion détaillée de ce type de base de données dépasse le cadre de cet article., mais ce que vous devez comprendre n'est que le concept sous-jacent. Voici un exemple simple de base de données orientée lignes et colonnes:
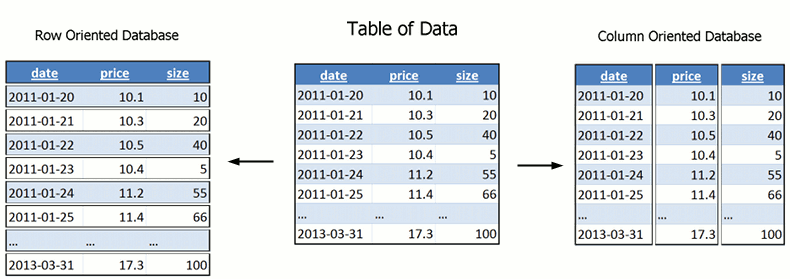
Crédit d'image: www.timestored.com
La base de données orientée colonne stocke chaque colonne dans un emplacement distinct, ce qui nous permet d'atteindre uniquement les colonnes qui nous sont nécessaires. Cela rend les requêtes beaucoup plus rapides dans les opérations de recherche et de filtrage.
Remarques finales
Les bases de données NoSQL repoussent nos limites pour le stockage et l'analyse des données. Avec de telles structures sans schéma, ils nous permettent aussi de changer des variables / attributs à tout moment. Ils sont exceptionnellement rapides pour exécuter des requêtes sur ces entités agrégées. Cependant, cette déclaration est accompagnée d'un titre au cas où l'opération ne devrait pas être effectuée au niveau agrégé de la table, devient plus compliqué par rapport au SGBDR. Par exemple, si nous avons des données stockées pour chaque commande dans une base de données NoSQL agrégée. Toute demande concernant ces ID de commande sera exceptionnellement rapide. Mais au cas où vous auriez besoin d'informations au niveau du client ou du produit, ces tables peuvent ne pas être très efficaces. Pour de tels processus, vous devrez rédiger des requêtes de CarteRéduireMapReduce est un modèle de programmation conçu pour traiter et générer efficacement de grands ensembles de données. Propulsé par Google, Cette approche décompose le travail en tâches plus petites, qui sont répartis entre plusieurs nœuds d’un cluster. Chaque nœud traite sa partie, puis les résultats sont combinés. Cette méthode vous permet de faire évoluer les applications et de gérer d’énormes volumes d’informations, fondamental dans le monde du Big Data..... Donc, tout dépend du type d'utilisation de la base de données qui vous convient le mieux.
L'article vous a-t-il été utile? Partagez avec nous vos expériences avec différents types de bases de données NoSQL. Faites-nous part de vos impressions sur cet article dans la case ci-dessous..





