
Cet article a été publié en tant qu'entrée pour le Blogathon sur la science des données.
introduction
Les chaînes de Markov sont exceptionnellement utiles pour modéliser un processus stochastique à temps discret et espace discret de divers domaines tels que la finance. (mouvement du cours des actions), Algorithmes de PNL (transducteurs à états finis, Modèle de Markov caché pour l'étiquetage POS), ou même en génie physique ( mouvement brownien).
Prenant en compte l'immense utilité de ce concept dans divers domaines et son importance fondamentale pour un nombre important d'algorithmes en science des données, nous couvrirons dans cet article les aspects suivants de la chaîne de Markov:
- Formulation de la chaîne de Markov et explication intuitive
- Aspects et caractéristiques d'une chaîne de Markov
- Applications et cas d'utilisation
Formulation de la chaîne de Markov et explication intuitive
Comprendre ce qu'est une chaîne de Markov, voyons d'abord ce qu'est un processus stochastique, puisque la chaîne de Markov est un type spécial de processus stochastique.
Un processus stochastique est défini comme un ensemble de variables aléatoires X = {Xt: t∈T} défini dans un espace de probabilité commun, prendre des valeurs dans un ensemble commun S (territoire de l'État), et indexé par un ensemble T, Pas souvent [0, ??) et considéré comme le temps (discret ou continu respectivement) (Olivier, 2009). Cela signifie que nous avons des observations à un certain moment et que le résultat est aléatoire variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes..... Tout simplement, un processus stochastique est tout processus qui décrit l'évolution dans le temps d'un phénomène aléatoire.
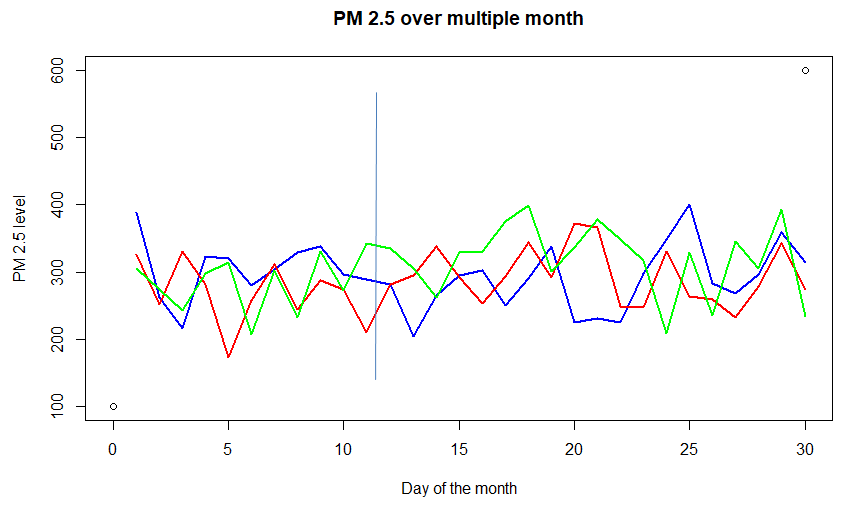
Considérez le graphique ci-dessus de la concentration de PM (affaire particulière) 2.5 dans les airs au-dessus d'une ville pendant des mois différents. Chacune des lignes colorées -rouge, bleu, et vert - (appelé chemin-échantillon) représente une fonction aléatoire du temps. Aussi, envisager n'importe quel jour (disons le 15 de chaque mois), il représente une variable aléatoire. Ainsi, il peut être considéré comme un processus stochastique, c'est-à-dire un processus qui prend différentes entrées fonctionnelles à différents moments. Cet exemple particulier est un cas pour temps discret (comme le temps n'est pas continu, observé une fois par jour) avec un état continu (il peut prendre n'importe quelle valeur positive, pas nécessairement un entier).
Maintenant que nous avons une intuition de base d'un processus stochastique, essayons de comprendre l'un des concepts mathématiques les plus utiles pour la science des données: Chaînes de Markov!
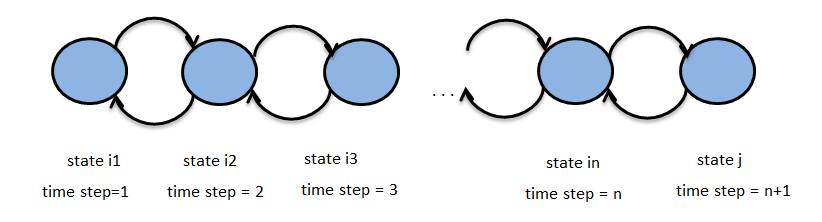
La figure ci-dessus représente une chaîne de Markov, avec les états je1, je2 ,… , jem , j pour les pas de temps 1, 2, .., n+1. Laisser {AVECm}n∈N être le processus stochastique ci-dessus avec espace d'état S. N ici est l'ensemble des nombres entiers et représente le réglage de l'heure et Zm représente l'état de la chaîne de Markov à l'instant n. Supposons que nous ayons la propriété :
P(AVECn+1 = j | AVECm = jem , AVECn-1 = jen-1 , … , AVEC1 = je1) = P(AVECn+1 = j | AVECm = jem)
alors {AVECm}n∈N s'appelle une chaîne de Markov.
Ce terme P(AVECn+1 = j | AVECm= jem) est appelé probabilité de transition. Ainsi, nous pouvons intuitivement voir que pour décrire la chaîne de Markov de manière probabiliste, nous avons besoin (une) la distribution de l'état initial et (b) probabilités de transition.
Prenons la chaîne de Markov ci-dessous pour comprendre ces deux termes plus formellement,
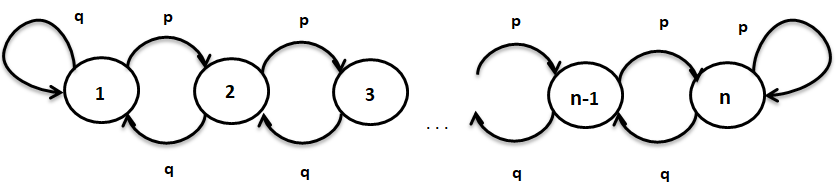
Dans la chaîne de Markov ci-dessus, les états sont 1, 2, …, n et la probabilité de passer de n'importe quel état k à k+1 (pour k =1, 2, …, n-1) est p et passer de l'état k à k-1 est q, où"OÙ" est un terme anglais qui se traduit par "où" en espagnol. Utilisé pour poser des questions sur l’emplacement des personnes, Objets ou événements. Dans des contextes grammaticaux, Il peut fonctionner comme un adverbe de lieu et est fondamental dans la formation des questions. Son application correcte est essentielle dans la communication quotidienne et dans l’enseignement des langues, faciliter la compréhension et l’échange d’informations sur les positions et les orientations.... q = 1-p.
- Les répartition de l'état initial est défini comme
Pi(0) = [P(X0=1), P(X0=2), … , P(X0 = n)]
L'expression précédente est un vecteur ligne avec un élément qui dénote la probabilité que la chaîne de Markov ait l'état i, où je = 1, 2,…, m. Tous les éléments de ce vecteur s'additionnent à 1.
- Les matrice de probabilité de transition c'est comme indiqué ci-dessous :
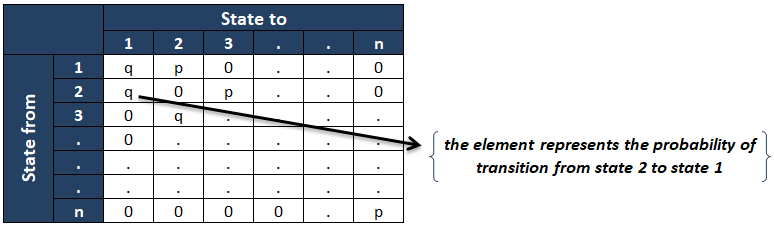
El ije élément de la matrice de probabilité de transition représente le la probabilité conditionnelle de la chaîne est dans l'état j puisqu'elle était dans l'état i à l'instant précédent. Si la matrice de probabilité de transition ne dépend pas de « m » (conditions météorologiques), alors la chaîne est appelée Les Chaîne de Markov homogène.
Aspects et caractéristiques d'une chaîne de Markov
Dans cette section, nous verrons les principaux aspects suivants d'une chaîne de Markov:
- Heure du premier coup: gje(k)
- Temps d'impact moyen (temps d'absorption): hUNE(k)
Le but des deux analyses précédentes est que si nous avons un ensemble d'états souhaités (disons A), et nous voulons calculer combien de temps il faudra pour atteindre l'état souhaité.
Première heure de coup
Imaginer, si on veut connaître la probabilité (conditionnel) que notre chaîne de Markov, qui commence dans un état initial k, atteindre l'état l (l'un des nombreux états souhaités dans A) tant qu'il atteint n'importe quel état dans A. Comment nous le faisons? cette?
Comprenons en définissant quelques termes de base. Soit TUNE être le premier temps qu'il faut pour atteindre l'un des états de l'ensemble A et k être un état dans l'espace d'état mais pas dans A.
Soit gje(k) être défini comme la probabilité conditionnelle d'atteindre l'état l au temps TUNE de l'état k.
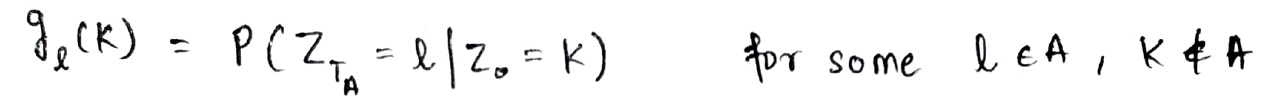
À présent, en utilisant la propriété de Markov, Considérons passer l'état dans le temps = 0 à l'état dans le temps = TUNE comment passer l'état dans le temps = 0 à l'état dans le temps = 1 puis passer d'un état à un autre = 1 à l'état dans le temps = TA. Le même est représenté ci-dessous:
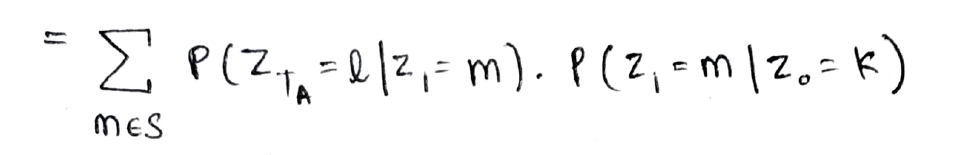
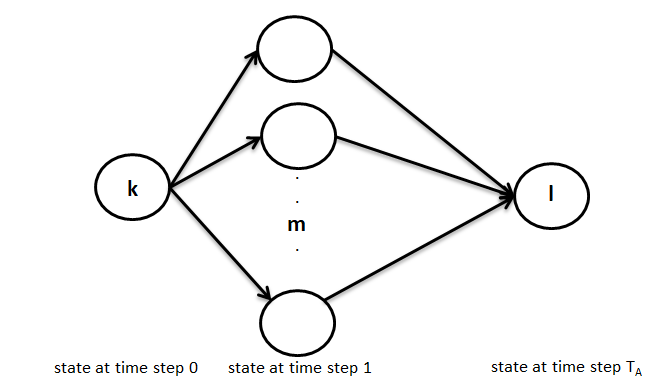
L'équation ci-dessus peut être interprétée graphiquement comme indiqué ci-dessous, c'est-à-dire, dans la première étape, vous pouvez passer de l'état k à l'un des états m en une seule étape, puis passer à TUNE-1 passage de l'état m à l'état souhaité l.
À présent, le premier terme peut être représenté par gje(m) et le deuxième terme représente la probabilité de transition de l'état k à l'état m
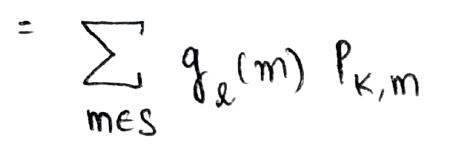
C'est la manière récursive que nous calculons la probabilité souhaitée et l'approche utilisée ci-dessus est appelée Analyse de la première étape (comme nous l'analysons en termes de première étape que l'état prend dans le temps = 0 à l'état dans le temps = 1)
Temps de frappe moyen
En utilisant une approche similaire à celle ci-dessus, on peut aussi calculer le temps moyen (attendu) pour atteindre un ensemble d'états souhaité (disons A) d'un état k sur A.
Definamos hUNE(k) comme le temps attendu pour atteindre un ensemble A à partir de l'état k. Ceci est défini comme indiqué ci-dessous:
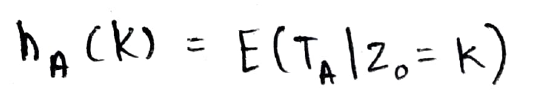
Maintenant que nous savons quelle est la première étape de l'analyse, Pourquoi ne pas l'utiliser à nouveau?
Ensuite, maintenant nous écrivons le terme d'espérance en termes de première étape (c'est-à-dire, atteindre l'état Z1) Comme indiqué ci-dessous:
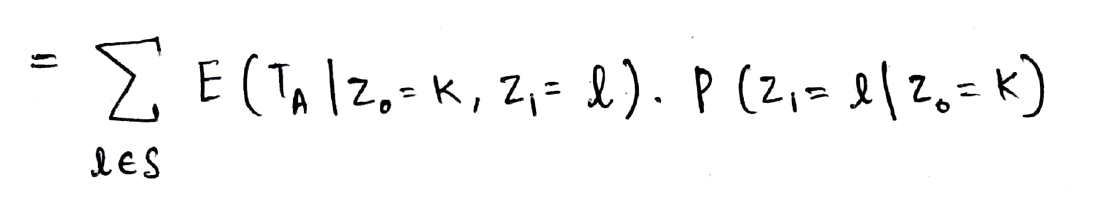
À présent, en utilisant la propriété de Markov, on peut éliminer le Z0 terme tel que nous connaissons l'état dans Z1. Le deuxième terme du produit ci-dessus est la probabilité de transition de l'état k à l'état l (nous avons tellement vu ce concept que maintenant cela ressemble à un calcul 2 + 2 = 4 🙂)
Notez que le terme d'espérance ci-dessous est en termes de Z1 (et non Z0) et donc nous ne pouvons pas l'écrire directement comme hUNE(k). Donc, nous utilisons une astuce mathématique, nous ajoutons 1 dans l'attente et on soustrait 1 aussi pour que nous puissions écrire mathématiquement l'état comme Z0 = je
Et maintenant nous pouvons l'écrire comme hUNE(k).
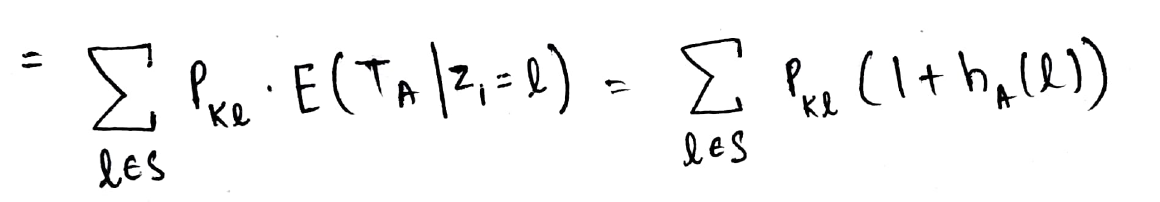
C'est la manière récursive que nous calculons l'espérance désirée !!
Nous connaissons maintenant l'approche fondamentale pour dériver n'importe quelle propriété de Markov avec les deux nouveaux outils que nous avons: Compréhension de matrice de probabilité de transition Oui Approche d'analyse de la première étape.
Applications et cas d'utilisation
Puisque nous sommes maintenant à l'aise avec le concept et les aspects d'une chaîne de Markov, Explorons et comprenons intuitivement l'application et les cas d'utilisation suivants des chaînes de Markov.
- PNL: modèle de Markov caché pour l'étiquetage des points de vente
- Marche aléatoire comme une chaîne de Markov
PNL: modèle de Markov caché pour l'étiquetage des points de vente
Étiquetage d'une partie du discours (PDV) est une application importante de la PNL. Le but de ces problèmes est d'étiqueter chaque mot dans une phrase donnée avec un POS approprié (nom, verbe, adverbe, etc.). Dans le modèle, nous avons des probabilités de transition d'étiquette, c'est-à-dire, puisque l'étiquette du mot précédent est dite ti-1, La tje sera l'étiquette du mot courant. Et le deuxième concept du modèle est la probabilité qu'étant donné l'étiquette du mot courant soit tje, le mot sera wje. Pour le dire plus clairement: le modèle de Markov caché est un type de Modèles génératifs (ensembles) dans lequel les états cachés (ici les étiquettes de PLV) sont considérées comme données et les données observées sont considérées comme générées.
La tje dans la chiffre"Chiffre" est un terme utilisé dans divers contextes, De l’art à l’anatomie. Dans le domaine artistique, fait référence à la représentation de formes humaines ou animales dans des sculptures et des peintures. En anatomie, désigne la forme et la structure du corps. En outre, en mathématiques, "chiffre" Il est lié aux formes géométriques. Sa polyvalence en fait un concept fondamental dans de multiples disciplines.... Ce qui suit fait référence aux balises POS de l’état YWje fait référence aux paroles émises par les États.
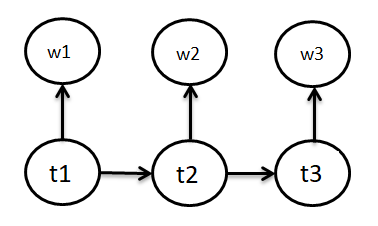
À présent, examinons de plus près l'élément du modèle pour y voir encore plus clairement le processus de Markov. Les éléments du modèle de Markov caché sont:
- Un ensemble d'états: ici Etiquettes PLV
- La sortie de chaque état: ici ‘mot’
- Etat initial: ici je commence la phrase
- Probabilité de transition d'état: ici P (tNord | tn-1)
En plus d'être très utile dans cet aspect de la PNL, les transducteurs à états finis et de nombreux autres algorithmes sont basés sur des chaînes de Markov.
Marche aléatoire
Un autre phénomène intéressant est celui de la marche aléatoire, qui est encore une chaîne de Markov.
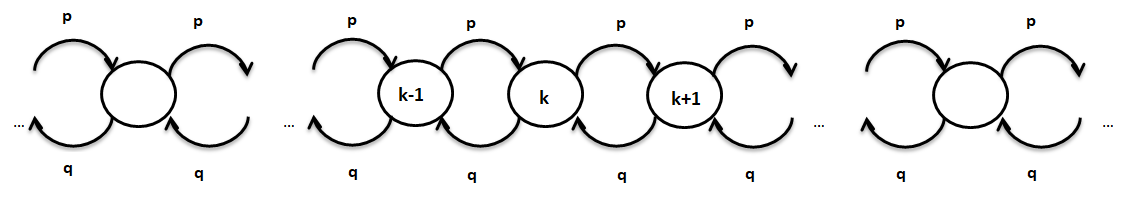
Considérons la marche aléatoire, Comme montré ci-dessus, c'est-à-dire, un mouvement en avant à partir de n'importe quel état peut se produire avec une probabilité p et un recul d'un pas peut se produire avec une probabilité q. Ici le mouvement vers l'avant de l'état k à k + 1 ne dépend que de l'état k et, donc, Random Walk est une chaîne de Markov.
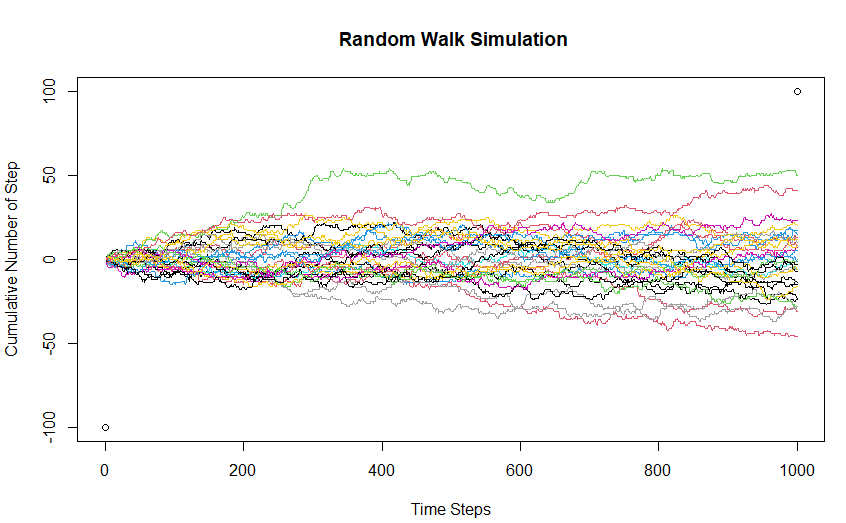
À présent, faisons un pas en avant et comprenons la marche aléatoire comme une chaîne de Markov en utilisant la simulation. On considère ici le cas de la marche unidimensionnelle, où la personne peut avancer ou reculer de n'importe quelle taille (Taille> = 1) avec une probabilité égale.
Ici, j'ai tracé 30 marches aléatoires pour développer l'intuition autour du phénomène. Ici, l'état initial de la chaîne de Markov est 0 (zéro étapes cumulatives initialement). Les choses à garder à l'esprit sont:
- L'espace d'état et le temps de consigne sont tous deux discrets (entiers)
- Il est visuellement clair qu'à un pas de temps donné, l'état suivant n'est déterminé que par l'état actuel et les pas de temps derrière le pas de temps actuel n'aident pas à prédire où sera l'état de la chaîne dans le prochain pas de temps.
- Puisque la probabilité de mouvement vers l'avant est la même que celle du mouvement vers l'arrière, la valeur attendue du nombre cumulé d'étapes est 0.
Le code pour simuler une marche aléatoire de base dans R est donné ci-dessous:
terrain(c(0,1000),c(-100,100), xlab = "Pas de temps", ylab = "Nombre cumulé de pas" , principal = " Simulation de marche aléatoire")
pour (je suis dans 1:30) {
  X <- as.integer(rnorme(1000))
  lignes(cumsum(X), taper = "je", col=échantillon(1:10,1))
}
La chaîne de Markov est une technique très puissante et efficace pour modéliser un processus stochastique de temps et d'espace discrets.. La compréhension des deux applications précédentes ainsi que le concept mathématique expliqué peuvent être utilisés pour comprendre tout type de processus de Markov.
Remarque sur l'auteur: Je suis un étudiant PGDBA (Diplôme d'études supérieures en analyse d'affaires) et IIM Calcutta, IIT Kharagpur et ISI Calcutta, et j'ai terminé mon B.TECH de l'IIT DELHI et j'ai une expérience de travail de ~ 3,5 années en analytique avancée.
N'hésitez pas à nous contacter pour toute discussion sur le sujet à Parth Tyagi | LinkedIn ou écrivez-moi un e-mail à [email protégé]
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





