
R Tu es prêt? Apprenons à grouper en R.
http: // www.pages: //www.rstudio.com/products/rstudio/download/
Visualisation des données avec R
Dans les temps présents, les images parlent plus fort que les chiffres ou l'analyse de mots. Oui, les graphiques et les diagrammes sont plus attrayants et faciles à identifier pour l'œil humain. C'est là qu'intervient l'importance de l'analyse des données R.. Les clients comprennent mieux la représentation graphique de leur croissance / évaluation / distribution de produits. Donc, la science des données est en plein essor de nos jours et R est l'un de ces langages qui offrent une flexibilité dans le traçage et les graphiques, car il a des fonctions et des packages spécifiques pour de telles tâches. RStudio est un logiciel où les données et la visualisation se côtoient, ce qui le rend très favorable pour un analyste de données. Diagrammes de dispersion, boîtes à moustachesDiagrammes encadrés, Aussi connu sous le nom de diagrammes en boîte et à moustaches, sont des outils statistiques qui représentent la distribution d’un ensemble de données. Ces diagrammes montrent la médiane, quartiles et valeurs aberrantes, Permettre de visualiser la variabilité et la symétrie des données. Ils sont utiles pour la comparaison entre différents groupes et pour l’analyse exploratoire, faciliter l’identification des tendances et des modèles dans les données...., graphiques à barres, graphiques en courbes, graphiques en courbes, cartes thermiques, etc. sont possibles dans R avec juste une simple fonction, par exemple: l'histogramme peut être tracé à l'aide de la fonction hist (nom des données) avec paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... comme xlab (balise x), Couleur, devrait, etc.
Profiter de cette commodité, passons à une méthode de Apprentissage non superviséL’apprentissage non supervisé est une technique d’apprentissage automatique qui permet aux modèles d’identifier des modèles et des structures dans des données sans étiquettes prédéfinies. Grâce à des algorithmes tels que les k-moyennes et l’analyse en composantes principales, Cette approche est utilisée dans une variété d’applications, comme la segmentation de la clientèle, Détection d’anomalies et compression de données. Sa capacité à révéler des informations cachées en fait un outil précieux dans le...: regroupement.
Apprentissage supervisé et non supervisé
Il existe deux types d'apprentissage dans l'analyse de données: enseignement superviséL’apprentissage supervisé est une approche d’apprentissage automatique dans laquelle un modèle est formé à l’aide d’un ensemble de données étiquetées. Chaque entrée du jeu de données est associée à une sortie connue, permettre au modèle d’apprendre à prédire les résultats pour de nouvelles entrées. Cette méthode est largement utilisée dans des applications telles que la classification d’images, Reconnaissance vocale et prédiction de tendances, soulignant son importance dans... et sans surveillance.
Enseignement supervisé – Les données étiquetées sont une entrée pour la machine d'apprentissage. Régression, le classement, arbres de décision, etc. sont des méthodes d'apprentissage supervisé.
Exemple d'apprentissage supervisé:
La régression linéaire est celle où il n'y a qu'une variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... dépendant. Équation: y = mx + c, y dépend de x.
Par exemple: l'âge et la circonférence d'un arbre sont les 2 étiquettes en tant que jeu de données d'entrée, la machine doit prédire l'âge d'un arbre avec une circonférence en entrée après avoir connu l'ensemble de données qui a été alimenté. L'âge dépend de la circonférence.
Pourtant, l'apprentissage est surveillé sur la base de balises.
Apprentissage non supervisé – Les données non étiquetées sont envoyées à la machine pour trouver un modèle par elle-même. Le clustering est une méthode d'apprentissage non supervisée qui a des modèles: KMeans, regroupement hiérarchique, DBSCAN, etc.
La représentation visuelle des clusters montre les données dans un format facilement compréhensible, car il regroupe les éléments d'un grand ensemble de données en fonction de leurs similitudes. Cela facilite l'analyse. Cependant, l'apprentissage non supervisé n'est pas toujours précis et est un processus complexe pour la machine, puisque les données ne sont pas étiquetées.
Continuons maintenant avec un exemple de regroupementLe "regroupement" Il s’agit d’un concept qui fait référence à l’organisation d’éléments ou d’individus en groupes ayant des caractéristiques ou des objectifs communs. Ce procédé est utilisé dans diverses disciplines, y compris la psychologie, Éducation et biologie, faciliter l’analyse et la compréhension de comportements ou de phénomènes. Dans le domaine de l’éducation, par exemple, Le regroupement peut améliorer l’interaction et l’apprentissage entre les élèves en encourageant le travail.. utilisant l'ensemble de données des fleurs d'Iris.
Regroupement
Groupes ils sont un groupe des mêmes éléments ou éléments tels qu'une grappe d'étoiles ou une grappe de raisin ou une grappe de filets et ainsi de suite …
Utilisation du clustering dans le monde réel:
Il est utilisé dans les sites de commerce électronique pour former des groupes de clients en fonction de leur profil tel que l'âge, sexe, dépenses, régularité, etc. Il est utile dans le marketing et les ventes, car il aide à regrouper le public cible du produit. Le filtrage du spam dans les e-mails et bien d'autres sont des applications de clustering du monde réel.
Le clustering dans R fait référence à l'assimilation du même type de données dans des groupes ou des clusters pour distinguer un groupe des autres. (collecte du même type de données). Cela peut être représenté sous forme graphique par R. Nous utilisons le modèle KMeans dans ce processus.
Qu'est-ce que l'algorithme K Means?
K Means est un algorithme de clustering qui attribue à plusieurs reprises un groupe parmi les k groupes présents à un point de données en fonction des caractéristiques du point. C'est une méthode de regroupement basée sur les centroïdes.
Le nombre de clusters est décidé, les centres de cluster sont choisis au hasard les plus éloignés les uns des autres, la distance entre chaque point de données et le centre est calculée à l'aide de la distance euclidienne, le point de données est affecté au cluster dont le centre est le plus proche de ce point. Ce processus est répété jusqu'à ce que le centre des groupes ne change pas et que les points de données restent dans le même groupe..
C'est toute la théorie, mais en pratique, R a un package de regroupement qui calcule les étapes ci-dessus.
Paso 1
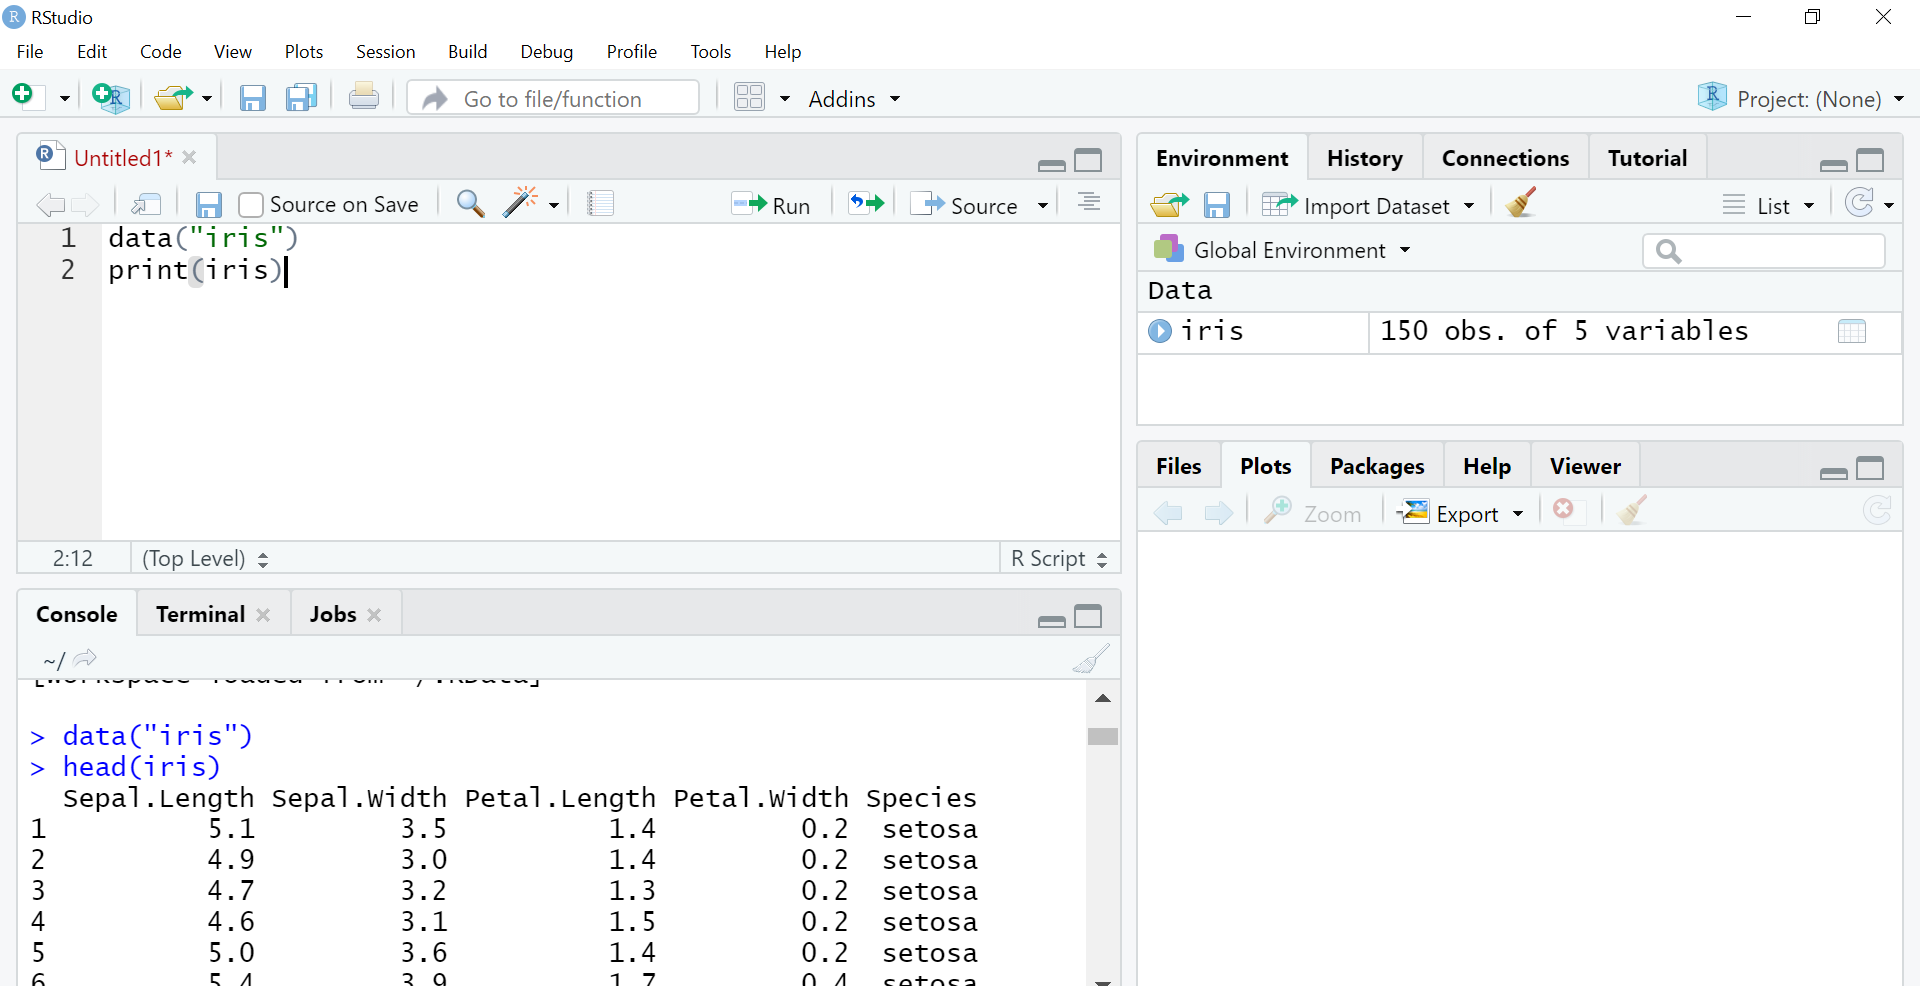
Je vais travailler sur le jeu de données Iris, qui est un ensemble de données intégré dans R utilisant le package Cluster. Possède 5 Colonnes, a savoir: longueur des sépales, largeur des sépales, longueur des pétales, largeur des pétales et espèces. L'iris est une fleur et ici, dans cet ensemble de données, ils sont mentionnés 3 de son espèce Setosa, Versicolor, Verginica. Nous regrouperons les fleurs selon leur espèce. Le code pour charger l'ensemble de données:
Les données("iris")
diriger(iris) #montrera le haut 6 lignes seulement
Paso 2
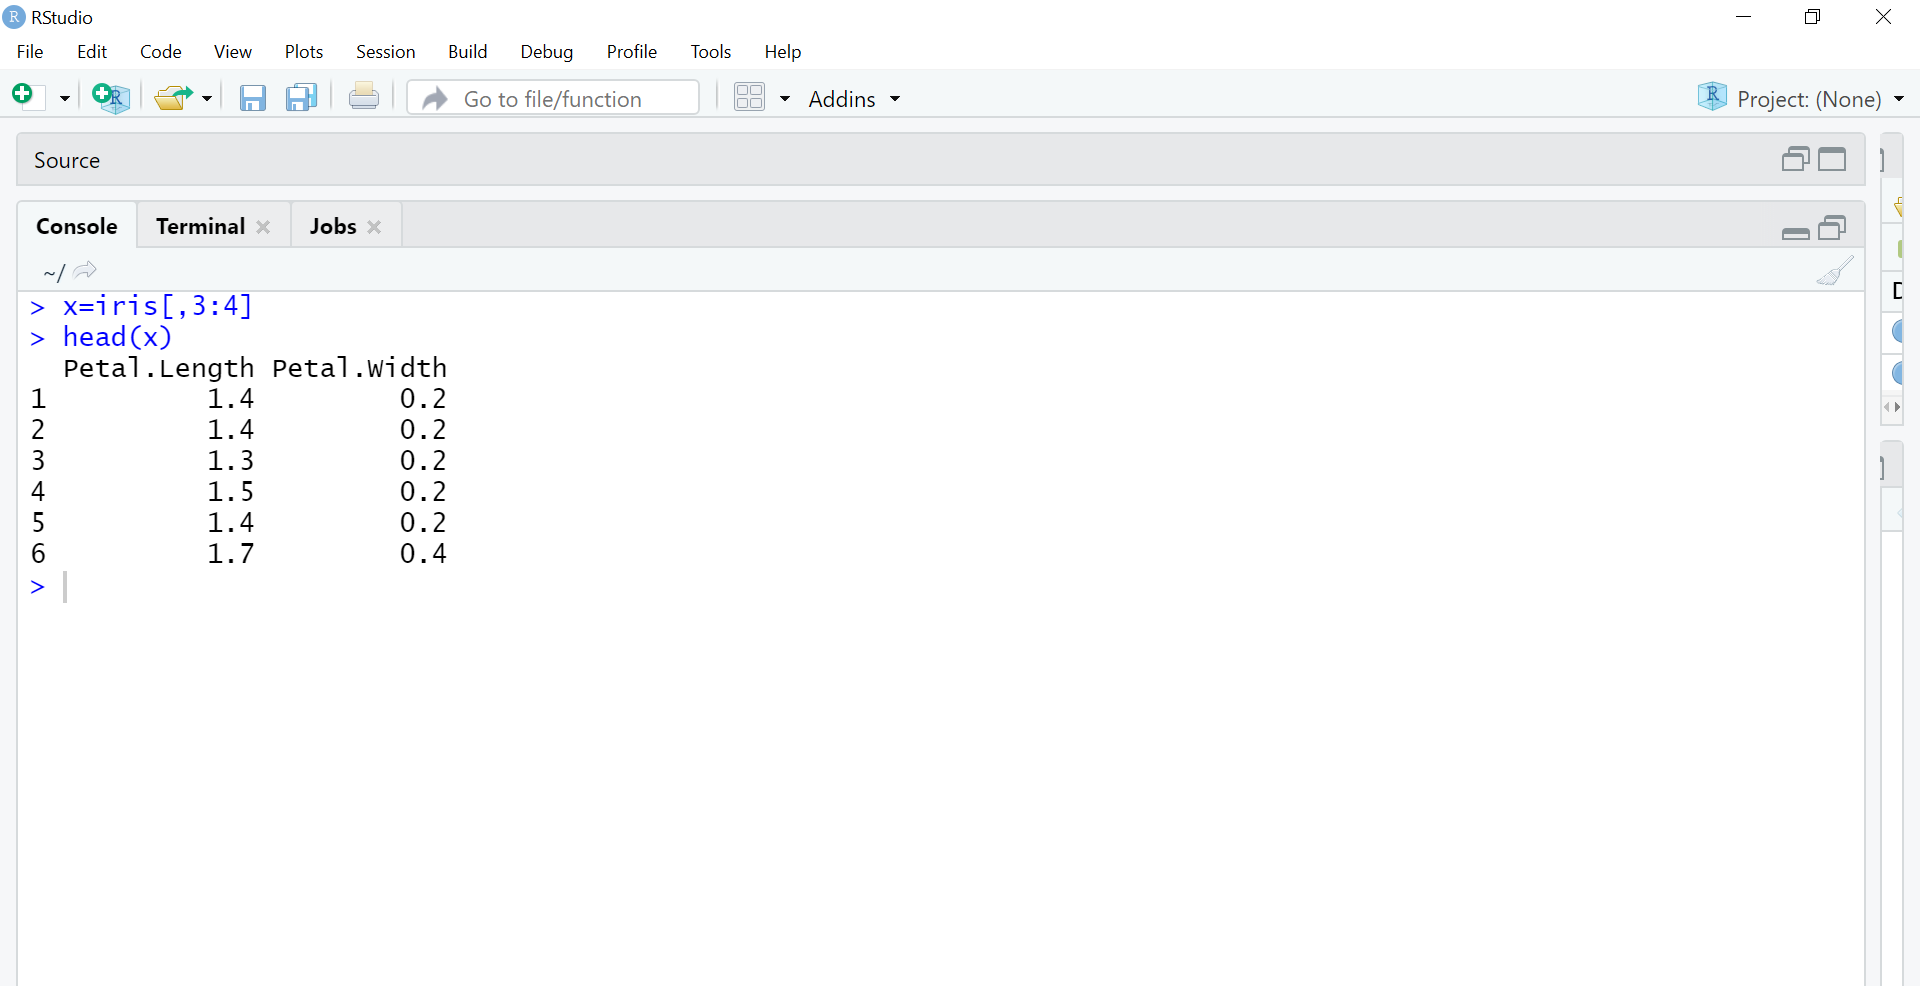
L'étape suivante consiste à séparer les colonnes 3 Oui 4 dans un objet x séparé, puisque nous utilisons la méthode d'apprentissage non supervisé. Nous supprimons les étiquettes pour que la machine utilise l'énorme entrée des colonnes de longueur et de largeur des pétales pour le regroupement sans surveillance.
x = iris[,3:4] #en utilisant uniquement les colonnes de longueur et de largeur des pétales
diriger(X)
Paso 3
L'étape suivante consiste à utiliser l'algorithme K Means. K Means est la méthode que nous utilisons qui a des paramètres (Les données, non. Des clusters aux groupes). Ici nos données sont l'objet x et nous aurons k = 3 groupes, puisqu'il y a 3 espèces dans l'ensemble de données.
Alors lui ‘paquet de cluster il s'appelle. Le clustering dans R se fait à l'aide de ce package intégré qui fera tous les calculs. La fonction Clusplot crée un tracé 2D des clusters.
model=kmeans(X,3)
 une bibliothèque(grappe)
clusplot(X,modèle$cluster)
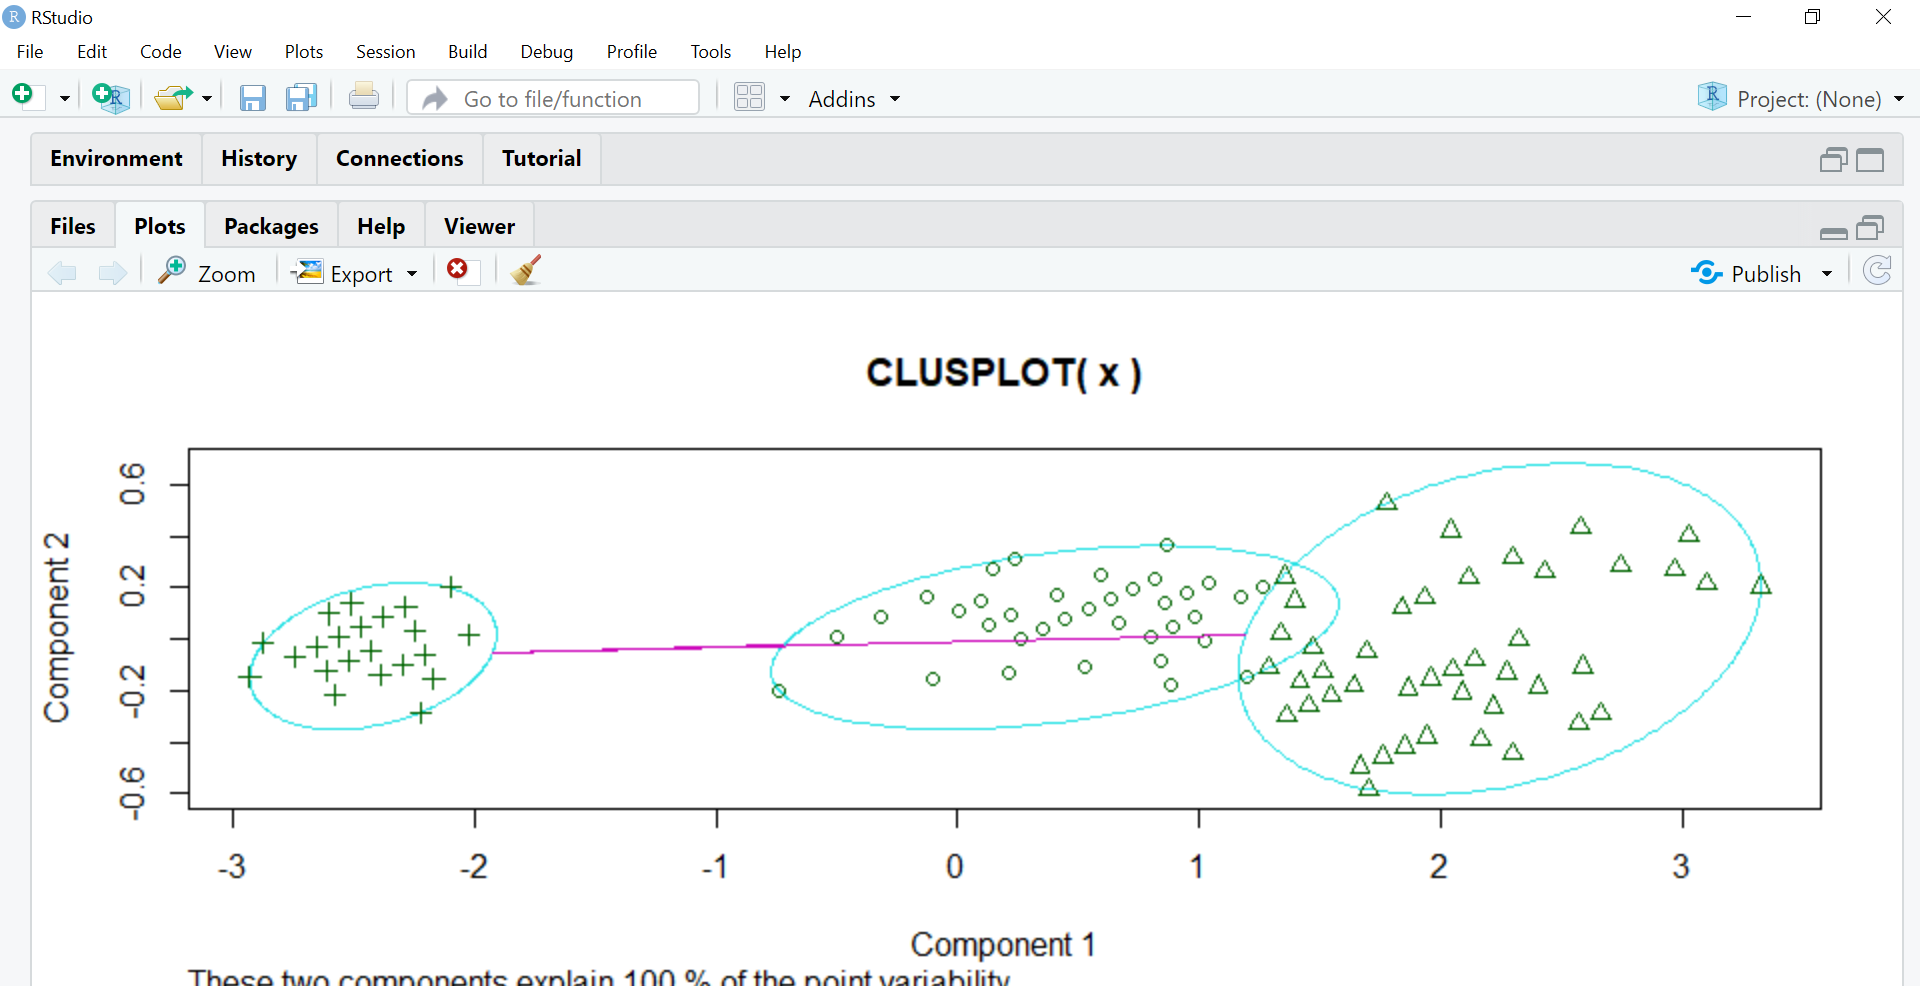
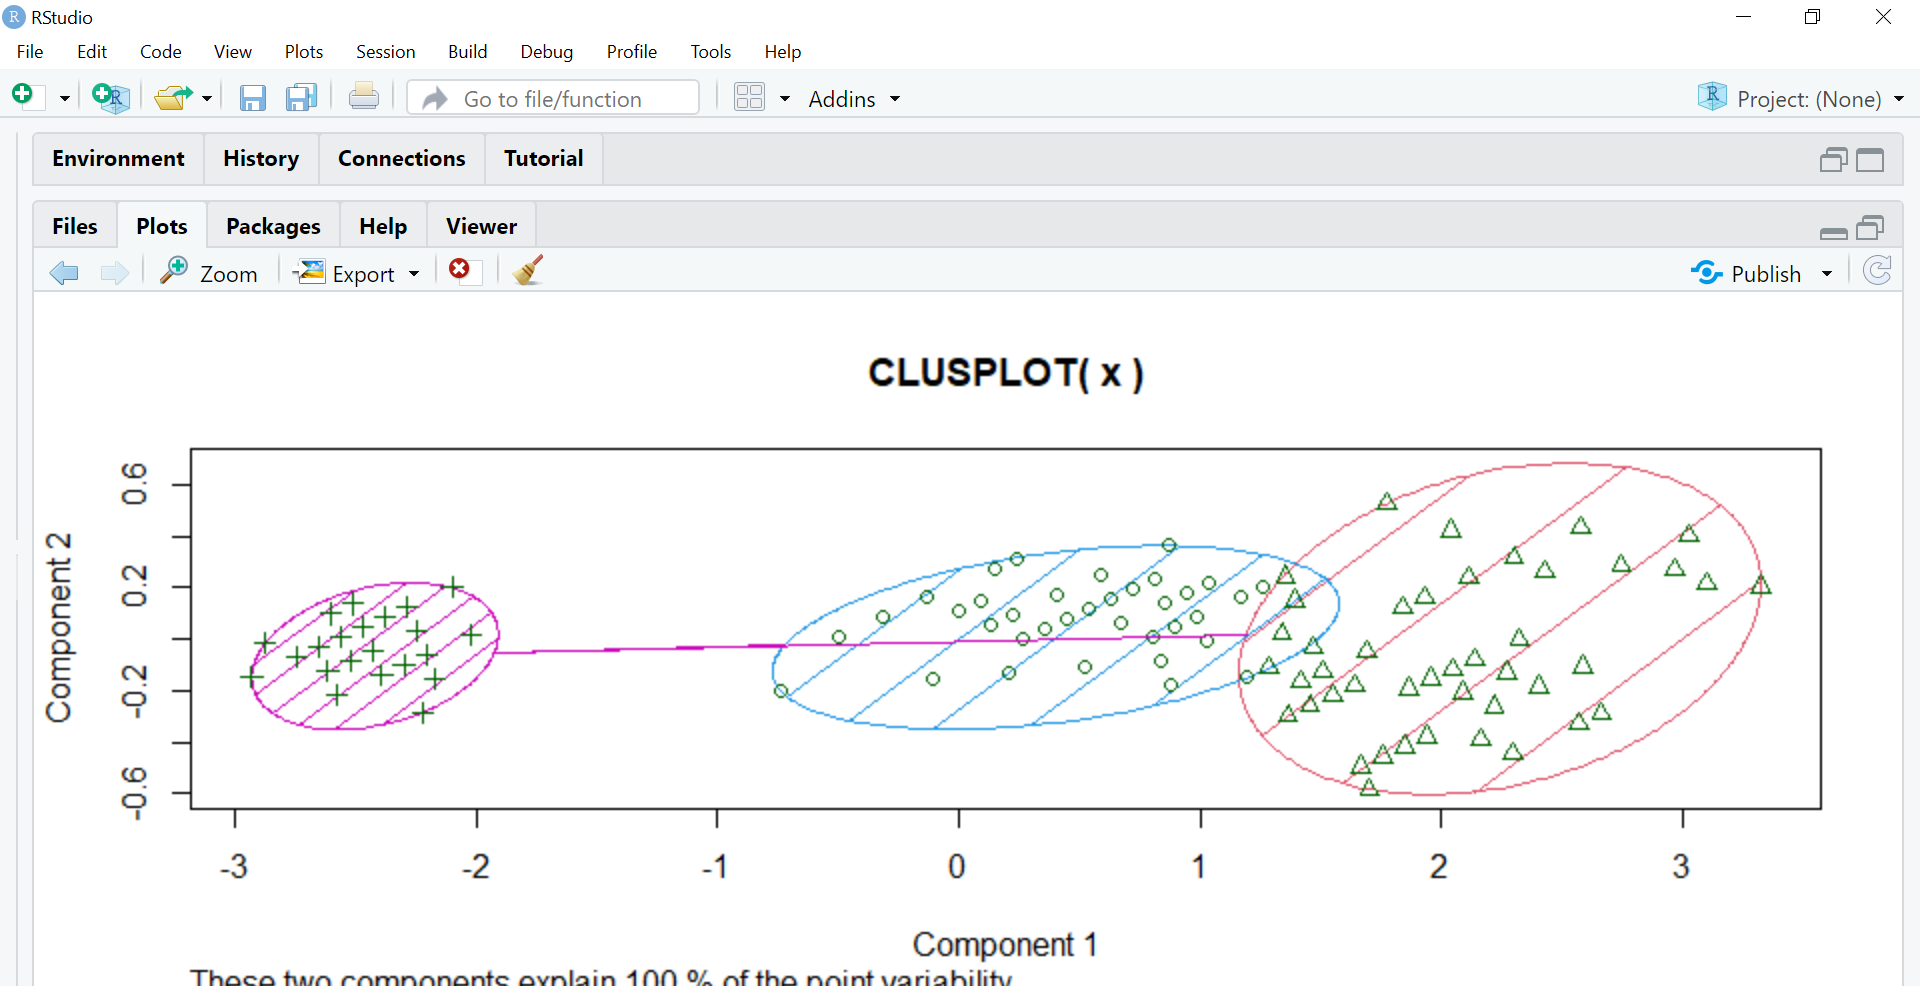
Le composant 1 et le composant 2 vu dans le graphique sont les deux composants de l'ACP (analyse des composants principaux), qui est essentiellement une méthode d'extraction de caractéristiques qui utilise les composants importants et supprime le reste. Réduit la dimensionnalité des données pour faciliter l'application de KMeans. Tout cela est fait par le paquet de grappeUn cluster est un ensemble d’entreprises et d’organisations interconnectées qui opèrent dans le même secteur ou la même zone géographique, et qui collaborent pour améliorer leur compétitivité. Ces regroupements permettent le partage des ressources, Connaissances et technologies, favoriser l’innovation et la croissance économique. Les grappes peuvent couvrir une variété d’industries, De la technologie à l’agriculture, et sont fondamentaux pour le développement régional et la création d’emplois.... un R.
Ces deux composantes expliquent la variabilité de la 100% a la sortie, ce qui signifie que l'objet de données x fourni à PCA était suffisamment précis pour former des groupes clairs à l'aide de KMeans et qu'il y a un chevauchement minimal (insignifiant) entre eux.
Paso 4
L'étape suivante consiste à attribuer différentes couleurs aux groupes et à les ombrer, donc, nous utilisons les paramètres de couleur et d'ombre en les définissant sur T, ce que signifie vrai.
clusplot(X,modèle$cluster,couleur=T,teinte=T)
conclusion
Tout cela résume les bases du clustering dans R. Ici, j'utilise un ensemble de données intégré, mais les ensembles de données importés peuvent également être utilisés pour le clustering. Par exemple: grouper les utilisateurs du site en fonction des éléments favoris, etc. Il est très utile pour faire des comparaisons d'affaires.
Importer des jeux de données dans R:
base de données <- lire.csv("chemin.csv")
Vue(base de données)
attacher(base de données)
Merci d'avoir pris le temps de lire cet article.,N'hésitez pas à commenter ce qui peut être amélioré, puisque l'apprentissage est un processus quotidien.aprèsTout le monde..
RelieravecmoisurLinkedIn:https://www.linkedin.com/in/akansha-bose-149b14164/
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





