
Dans cet article, Nous apprendrons comment gérer plusieurs variables de catégorie à l'aide de la technique d'ingénierie de la fonction One Hot Encoding.
Mais avant de continuer, discutons brièvement de l'ingénierie des fonctions et de One Hot Encoding.
Ingénierie fonctionnelle
Ensuite, L'ingénierie de caractéristiques est le processus d'extraction de caractéristiques à partir de données brutes en utilisant la connaissance du domaine du problème. Ces fonctions peuvent être utilisées pour améliorer les performances des algorithmes d'apprentissage automatique et, si les performances augmentent, fournira la meilleure précision. On peut aussi dire que l'ingénierie fonctionnelle est la même que l'apprentissage automatique appliqué. L'ingénierie des fonctionnalités est l'art le plus important de l'apprentissage automatique qui crée une énorme différence entre un bon modèle et un mauvais modèle. Il s'agit de la troisième étape du cycle de vie de tout projet de science des données.
Le concept de transparence pour les modèles d'apprentissage automatique est quelque peu compliqué, car différents modèles nécessitent souvent des approches différentes pour différents types de données. Tel que:-
- Données continues
- Caractéristiques catégorielles
- Valeurs manquantes
- NormalisationLa normalisation est un processus fondamental dans diverses disciplines, qui vise à établir des normes et des critères uniformes afin d’améliorer la qualité et l’efficacité. Dans des contextes tels que l’ingénierie, Formation et administration, La standardisation facilite la comparaison, Interopérabilité et compréhension mutuelle. Lors de la mise en œuvre des normes, La cohésion est favorisée et les ressources sont optimisées, qui contribue au développement durable et à l’amélioration continue des processus....
- Dates et heure
Mais ici, nous ne discuterons que des caractéristiques catégorielles, les caractéristiques catégorielles sont les caractéristiques dans lesquelles le type de données est un type d'objet. La valeur du point de données dans toute caractéristique catégorielle n'est pas sous forme numérique, mais sous la forme d'un objet.
Il existe de nombreuses techniques pour gérer les variables catégorielles, quelques unes sont:
- Encodage de balise ou encodage ordinal
- Un codage à chaud
- Codage factice
- Encodage des effets
- Encodage binaire
- Codage bâlois
- Encodage de hachage
- Encodage de destination
Ensuite, ici nous gérons les caractéristiques catégorielles par One Hot Encoding, donc, en premier lieu, discutiremos Un codage à chaud.
Un codage à chaud
Nous savons que les variables catégorielles contiennent les valeurs d'étiquette au lieu de valeurs numériques. Le nombre de valeurs possibles est souvent limité à un ensemble fixe. Les variables catégorielles sont souvent appelées nominales. De nombreux algorithmes d'apprentissage automatique ne peuvent pas fonctionner directement sur les données des balises. Exiger que toutes les variables d'entrée et de sortie soient numériques.
Cela signifie que les données catégorielles doivent être converties sous une forme numérique. Si l’icône variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... categorical est une variable de sortie, vous pouvez également vouloir reconvertir les prédictions du modèle sous forme catégorielle pour les présenter ou les utiliser dans une application.
par exemple les données sur le genre se présentent sous la forme de ‘masculin’ Oui ‘Femme’.
Mais si nous utilisons un encodage à chaud, coder et laisser le modèle assumer un ordre naturel entre les catégories peut entraîner des performances médiocres ou des résultats inattendus.
L'encodage à chaud peut être appliqué à la représentation d'entiers. C'est là que la variable codée entière est supprimée et une nouvelle variable binaire est ajoutée pour chaque valeur entière unique.
Par exemple, on code la variable de couleurs,
| Couleur rouge | Couleur bleu |
| 0 | 1 |
| 1 | 0 |
| 0 | 1 |
Maintenant, nous allons commencer notre voyage. Dans la première étape, nous prenons un ensemble de données de prévision des prix des maisons.
Base de données
Ici, nous allons utiliser l'ensemble de données de house_price qui est utilisé pour prédire le prix de la maison en fonction de la taille de la zone.
Si vous souhaitez télécharger l'ensemble de données de prévision des prix de l'immobilier, cliquez sur ici.
Importation de modules
À présent, nous devons importer des modules python importants à utiliser pour l'encodage one-hot
# importer des pandas
importer des pandas au format pd
# importation numpy
importer numpy en tant que np
# importation OneHotEncoder
de sklearn.preprocessing importer OneHotEncoder()
Ici, nous utilisons des pandas qui sont utilisés pour l'analyse des données, NumPyutilisé pour les tableaux à n dimensions, et de sklearn, nous utiliserons un encodeur à chaud de classe 1 important pour l'encodage catégoriel.
Maintenant, nous devons lire ces données en utilisant Python.
Lire l'ensemble de données
Généralement, le jeu de données est au format CSV, et l'ensemble de données que nous utilisons est également au format CSV. Pour lire le fichier CSV nous utiliserons la fonction pandas read_csv (). baisser les yeux:
# lecture de l'ensemble de données
df = pd.read_csv('house_price.csv')
df.head()
production:-
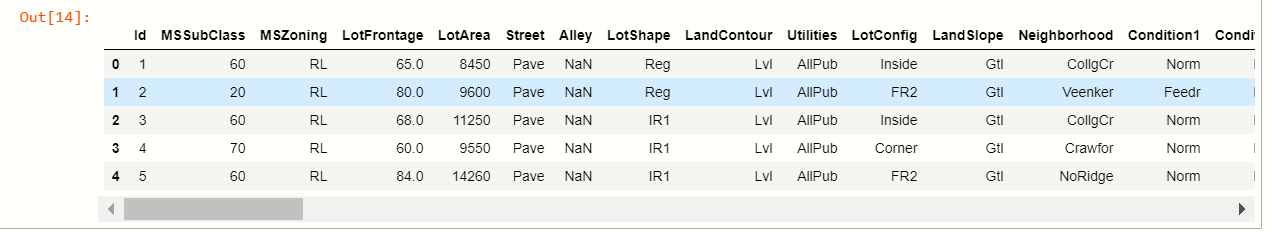
Mais nous n'avons qu'à utiliser des variables catégorielles pour un encodeur actif et nous essaierons uniquement d'expliquer avec des variables catégorielles pour une compréhension facile.
pour partitionner des variables catégorielles à partir de données, nous devons vérifier combien de caractéristiques ont des valeurs catégorielles.
Vérification des valeurs catégorielles
Pour vérifier les valeurs, nous utilisons la fonction pandas select_dtypes qui permet de sélectionner les types de données de la variable.
# vérification des fonctionnalités
chat = df.select_dtypes(inclure="O").clés()
# afficher les variables
chat
production:-
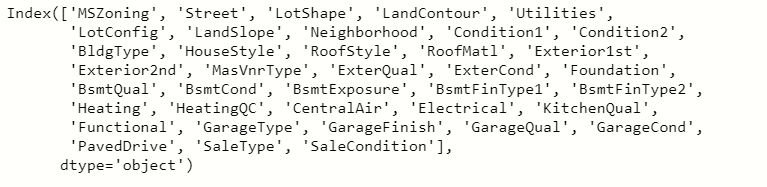
Nous devons maintenant supprimer ces colonnes numériques de l'ensemble de données et nous utiliserons cette variable catégorielle pour notre utilisation. Nous utilisons uniquement 3-4 colonnes catégorielles de l'ensemble de données pour appliquer l'encodage one-hot.
Créer un nouveau bloc de données
À présent, utiliser des variables catégorielles, nous allons créer un nouveau bloc de données à partir des colonnes catégorielles sélectionnées.
# créer un nouveau df
# définir les colonnes que nous utilisons
new_df = pd.read_csv('house_price.csv',usecols =['Neighborhood','Exterior1st','Exterior2nd'])
nouveau_df.head()
production:-
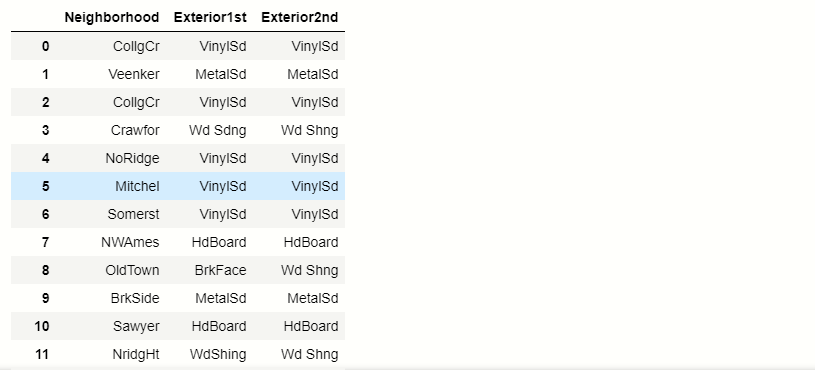
Maintenant, nous devons savoir combien de catégories uniques sont présentes dans chaque colonne catégorielle.
Trouver des valeurs uniques
Pour trouver des valeurs uniques, nous utiliserons la fonction unique des pandas ().
# valeurs uniques dans chaque colonne
pour x dans new_df.columns:
    #impression de valeurs uniques
    imprimer(X ,':', longueur(nouveau_df[X].unique()))
production:-
| Quartier: 25 |
| Extérieur 1er: 15 |
| Extérieur 2e: 16 |
À présent, nous utiliserons notre technique pour appliquer un encodage one-hot sur des variables multi-catégories.
Technique pour les variables multi-catégories
La technique consiste à limiter l'encodage one-hot à 10 les étiquettes les plus fréquentes de la variable. Cela signifie que nous ferions une variable binaire uniquement pour chacun des 10 balises les plus fréquentes, cela équivaut à regrouper toutes les autres balises dans une nouvelle catégorie, qui dans ce cas sera éliminé. A) Oui, les 10 les nouvelles variables muettes indiquent si l'une des 10 les balises les plus fréquentes sont présentes est 1 ou pas alors 0 pour une observation particulière.
Variables les plus fréquentes
Ici, nous sélectionnerons le 20 variables les plus fréquentes.
Supposons que nous prenons une variable catégorielle Quartier.
# trouver le haut 20 catégories
new_df.Neighborhood.value_counts().trier_valeurs(ascendant=Faux).diriger(20)
production:
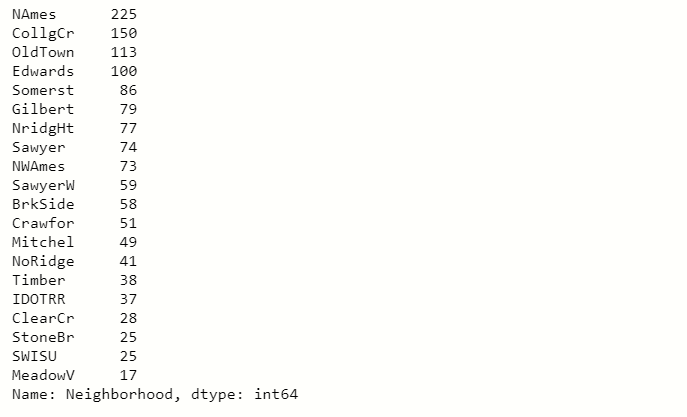
Quand vous voyez dans cette image de sortie, vous remarquerez que le Noms L'étiquette se répète 225 fois dans les colonnes du quartier et on descend ce nombre est décroissant.
Alors on prend le 10 meilleurs résultats principaux et nous convertissons ce meilleur résultat 10 en encodage one-hot et les étiquettes de gauche deviennent zéro.
production:-
Liste des variables catégorielles les plus fréquentes
# faire une liste avec le haut 10 variables
top_10 = [x pour x dans new_df.Neighborhood.value_counts().trier_valeurs(ascendant=Faux).diriger(10).indice]
Top 10
production:-
['Noms',
'CollgCr',
'Vieille ville',
'Edouard',
« Somerst »,
"Gilbert",
« NridgHt »,
'Scieur',
« NWAmes »,
« SawyerW »]
Il y a les 10 les principales étiquettes catégorielles de la colonne Quartier.
Faire du binaire
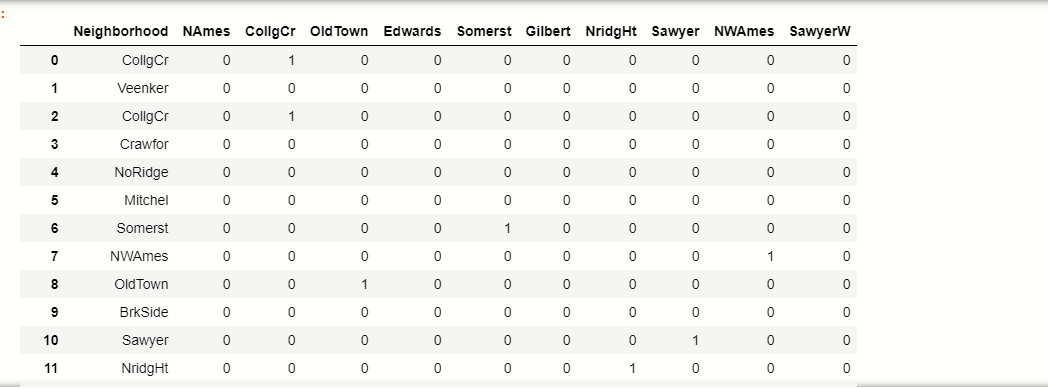
À présent, nous devons faire le 10 variables binaires du top_10 étiquettes:
# faire des étiquettes binaires
pour la balise dans le top_10:
nouveau_df[étiqueter] = np.où (nouveau_df['Quartier']== étiquette, 1,0)
nouveau_df[['Quartier']+ Top 10]
production:-
| Noms | CollgCr | Vieille ville | Edwards | Somerst | Gilbert | NridgHt | Scieur | NWAmes | SawyerW | ||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | CollgCr | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 1 | Veenker | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 2 | CollgCr | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 3 | Crawfor | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 4 | NoRidge | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 5 | Michel | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 6 | Somerst | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 |
| 7 | NWAmes | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 8 | Vieille ville | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 9 | BrkSide | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 10 | Scieur | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 |
| 11 | NridgHt | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 |
Vous pouvez voir comment les balises top_10 sont maintenant converties au format binaire.
Prenons un exemple, voir dans le tableau où 1 indiceLe "Indice" C’est un outil fondamental dans les livres et les documents, qui vous permet de localiser rapidement les informations souhaitées. Généralement, Il est présenté au début d’une œuvre et organise les contenus de manière hiérarchique, y compris les chapitres et les sections. Sa préparation correcte facilite la navigation et améliore la compréhension du matériau, ce qui en fait une ressource incontournable tant pour les étudiants que pour les professionnels dans divers domaines.... Veenker qui n'appartenaient pas à notre tag top_10 categories, il en résultera donc 0 toutes les colonnes.
Nous allons maintenant le faire pour toutes les variables catégorielles que nous avons sélectionnées précédemment.
Toutes les variables sélectionnées dans OneHotEncoding
# pour toutes les variables catégorielles que nous avons sélectionnées
def top_x(df2, variable,top_x_labels):
pour l'étiquette dans top_x_labels:
df2[variable+'_'+label] = np.où(Les données[variable]== étiquette,1,0)
# relire les données
données = pd.read_csv('D://xdatasets/train.csv',usecols = ['Neighborhood','Exterior1st','Exterior2nd'])
#encoder le quartier dans le 10 catégories les plus fréquentes
top_x(Les données,'Neighborhood',Top 10)
# afficher les données
data.head()
Production:-
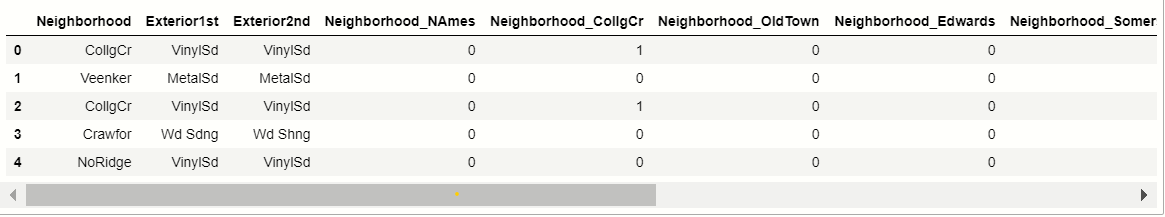
À présent, ici, nous appliquons un encodage à chaud sur toutes les variables multi-catégories.
Nous allons maintenant voir les avantages et les inconvénients de One Hot Encoding pour plusieurs variables.
avantage
- Facile à mettre en œuvre
- Ne nécessite pas beaucoup de temps pour l'exploration variable.
- N'étend pas massivement l'espace des fonctionnalités.
Désavantages
- Il n'ajoute aucune information qui pourrait rendre la variable plus prédictive
- Ne pas enregistrer les informations des variables ignorées.
Remarques finales
Ensuite, le résumé de ceci est que nous apprenons à gérer les variables de plusieurs catégories. Si vous rencontrez ce problème, c'est donc une tâche très difficile. Alors merci d'avoir lu cet article..
Connectez-vous avec moi sur Linkedin: Profil
Lire mes autres articles: https://www.analyticsvidhya.com/blog/author/mayurbadole2407/
Merci
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





