
Ce message a été rendu public dans le cadre de la Blogathon sur la science des données
introduction
Python est un langage de programmation facile à apprendre, ce qui en fait le choix préféré des débutants en science des données, analyse de données et apprentissage automatique. Il possède également une grande communauté d'étudiants en ligne et d'excellentes bibliothèques centrées sur les données..
Avec autant de données générées, il est essentiel que les données que nous utilisons pour les applications de science des données telles que l'apprentissage automatique et la modélisation prédictive soient propres. Mais, Qu'entendons-nous par données propres? Et ce qui gâche les données en premier lieu?
Des données sales signifient simplement de mauvaises données. Duplication d'enregistrements, Des données incomplètes ou obsolètes et une analyse incorrecte peuvent perturber les données. Ces données doivent être nettoyées. Nettoyage des données (ou nettoyage des données) fait référence à la procédure de « nettoyer » ces données sales, identifier les erreurs dans les données puis les rectifier.
Le nettoyage des données est une étape importante dans un projet de machine learning, et nous aborderons quelques techniques de base de nettoyage des données (et Python) dans ce post.
Nettoyage des données en Python
Nous en apprendrons plus sur le nettoyage des données en Python à l'aide d'un exemple de jeu de données. Nous utiliserons le Ensemble de données sur le logement russe et Kaggle.
Nous allons commencer par importer les bibliothèques indispensables.
# importer des bibliothèques
importer des pandas au format pd
importer numpy en tant que np
importer seaborn comme sns
importer matplotlib.pyplot en tant que plt
%matplotlib en ligne
Téléchargez les données, puis lisez-les dans un DataFrame Pandas à l'aide de la fonction read_csv () et en spécifiant le chemin du fichier. Ensuite, utiliser l'attribut de forme pour vérifier le nombre de lignes et de colonnes dans l'ensemble de données. Le code pour cela est le suivant:
df = pd.read_csv('housing_data.csv')
df.forme
L'ensemble de données a 30 471 rangées et 292 Colonnes.
Maintenant, nous allons séparer les colonnes numériques des colonnes catégorielles.
# sélectionner des colonnes numériques
df_numeric = df.select_dtypes(inclure=[np.nombre])
numeric_cols = df_numeric.columns.values
# sélectionner des colonnes non numériques
df_non_numeric = df.select_dtypes(exclure=[np.nombre])
non_numeric_cols = df_non_numeric.columns.values
Nous en avons maintenant terminé avec les étapes préliminaires. Nous pouvons maintenant passer au nettoyage des données. Nous allons commencer par identifier les colonnes qui contiennent des valeurs manquantes et essayer de les corriger.
Valeurs manquantes
Nous allons commencer par calculer le pourcentage de valeurs manquantes dans chaque colonne puis stocker ces informations dans un DataFrame.
# % de valeurs manquantes dans chaque colonne
liste_valeurs = liste()
liste_cols = liste()
pour col dans df.columns:
    pct_missing = np.mean(df[col].est nul())*100
    liste_cols.append(col)
    liste_valeurs.append(pct_manquant)
pct_missing_df = pd.DataFrame()
pct_missing_df['col'] = liste_cols
pct_missing_df['pct_missing'] = liste_valeurs
Le DataFrame pct_missing_df contient désormais le pourcentage de valeurs manquantes dans chaque colonne ainsi que les noms de colonnes.
Nous pouvons également créer une image à partir de ces informations pour une meilleure compréhension en utilisant le code suivant:
pct_missing_df.loc[pct_missing_df.pct_missing > 0].terrain(type='bar', taille de la figue=(12,8))
plt.show()
Le résultat après l'exécution de la ligne de code ci-dessus devrait ressembler à ceci:
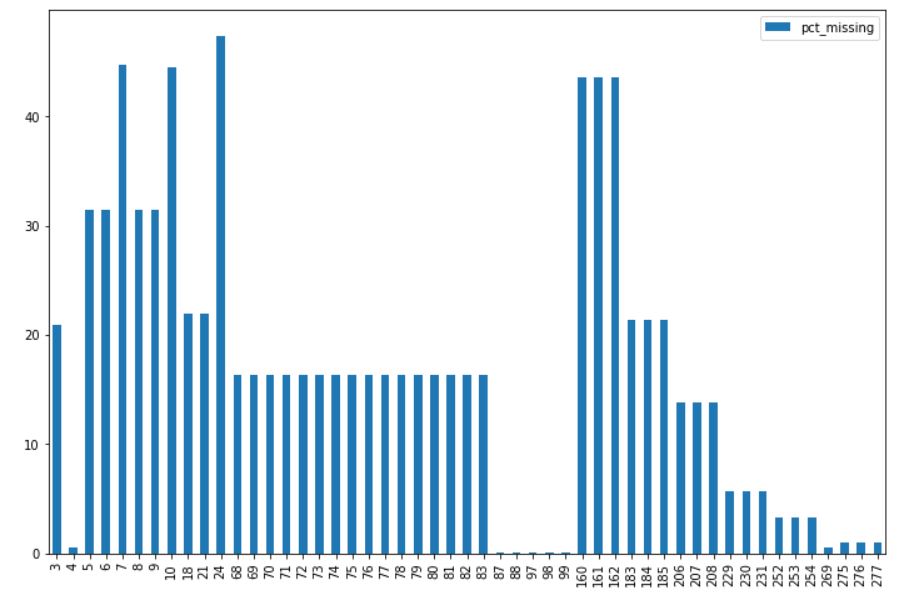
Il est clair que certaines colonnes manquent très peu de valeurs, tandis que d'autres colonnes manquent un pourcentage substantiel de valeurs. Nous allons maintenant corriger ces valeurs manquantes.
Il existe plusieurs façons de corriger ces valeurs manquantes. Certains d'entre eux sont »
Observations d'automne
Une façon pourrait être de rejeter les observations qui contiennent une valeur nulle pour l'une des colonnes. Cela fonctionnera lorsque le pourcentage de valeurs manquantes dans chaque colonne est beaucoup plus faible. Nous éliminerons les observations qui contiennent des valeurs nulles dans les colonnes qui ont moins de 0,5% nul. Ces colonnes seraient metro_min_walk, metro_km_walk, railroad_station_walk_km, railroad_station_walk_min et ID_railroad_station_walk.
less_missing_values_cols_list = liste(pct_missing_df.loc[(pct_missing_df.pct_missing < 0.5) & (pct_missing_df.pct_missing > 0), 'col'].valeurs)
df.dropna(sous-ensemble=less_missing_values_cols_list, inplace=Vrai)
Cela réduira le nombre d'enregistrements dans notre ensemble de données à 30,446 enregistrements.
Supprimer des colonnes (les fonctions)
Une autre façon de traiter les valeurs manquantes dans un ensemble de données serait de supprimer les colonnes ou les fonctionnalités qui ont un pourcentage important de valeurs manquantes.. Ces colonnes ne contiennent pas beaucoup d'informations et peuvent être complètement supprimées de l'ensemble de données. Dans notre cas, éliminons toutes les colonnes qui manquent plus de 40% des valeurs. Ces colonnes seraient build_year, Etat, hospital_beds_raion, cafe_sum_500_min_price_avg, cafe_sum_500_max_price_avg y cafe_avg_price_500.
# suppression des colonnes avec plus de 40% valeurs nulles
_40_pct_missing_cols_list = liste(pct_missing_df.loc[pct_missing_df.pct_missing > 40, 'col'].valeurs)
df.drop(colonnes=_40_pct_missing_cols_list, inplace=Vrai)
Le nombre d'entités dans notre ensemble de données est maintenant 286.
Imputer les valeurs manquantes
Des données sont toujours manquantes dans notre ensemble de données. Nous allons maintenant imputer les valeurs manquantes dans chaque colonne numérique avec la valeur médiane de cette colonne.
df_numeric = df.select_dtypes(inclure=[np.nombre])
numeric_cols = df_numeric.columns.values
pour col dans numeric_cols:
    manquant = df[col].est nul()
    num_missing = np.sum(disparu)
    si nombre_manquant > 0:  # imputer des valeurs uniquement pour les colonnes qui ont des valeurs manquantes
        moyen = df[col].médian() #imputer avec la médiane
        df[col] = df[col].remplir(avec)
Les valeurs manquantes dans les colonnes numériques sont désormais corrigées. Dans le cas des colonnes catégorielles, nous remplacerons les valeurs manquantes par les valeurs de mode de cette colonne.
df_non_numeric = df.select_dtypes(exclure=[np.nombre])
non_numeric_cols = df_non_numeric.columns.values
pour col dans non_numeric_cols:
    manquant = df[col].est nul()
    num_missing = np.sum(disparu)
    si nombre_manquant > 0:  # imputer des valeurs uniquement pour les colonnes qui ont des valeurs manquantes
        mod = df[col].décris()['top'] # imputer avec la valeur la plus fréquente
        df[col] = df[col].remplir(mode)
Toutes les valeurs manquantes dans notre jeu de données ont déjà été traitées. Nous pouvons le vérifier en exécutant le code suivant:
df.isnull().somme().somme()
Si la sortie est nulle, signifie maintenant qu'il n'y a plus de valeurs manquantes dans notre ensemble de données.
De plus, nous pouvons remplacer les valeurs manquantes par une valeur particulière (Quoi -9999 O ‘disparu’) qui indiquera le fait que les données manquaient à cet endroit. Cela peut se substituer à l'imputation de la valeur perdue.
Valeurs atypiques
Une valeur aberrante est une observation inhabituelle qui s'écarte de la plupart des données. Les valeurs aberrantes peuvent affecter considérablement les performances d'un modèle d'apprentissage automatique. Pour cela, identifier les valeurs aberrantes et les traiter est essentiel.
Prenons la colonne ‘life_sq’ exemple. Nous utiliserons d'abord la méthode de description () pour regarder les statistiques descriptives et voir si nous pouvons collecter des informations à partir de celles-ci.
df.life_sq.describe()
La sortie ressemblera à ceci:
compter    30446.000000
moyenne        33.482658
std         46.538609
min          0.000000
25%         22.000000
50%         30.000000
75%         38.000000
max       7478.000000
Nom: life_sq, dtype: float64
De départ, il est clair que quelque chose ne va pas. La valeur maximale semble être anormalement élevée par rapport aux valeurs moyenne et médiane. Faisons une boîte à moustaches de ces données pour avoir une meilleure idée.
df.life_sq.plot(kind='box', taille de la figue=(12, 8))
plt.show()
La sortie ressemblera à ceci:
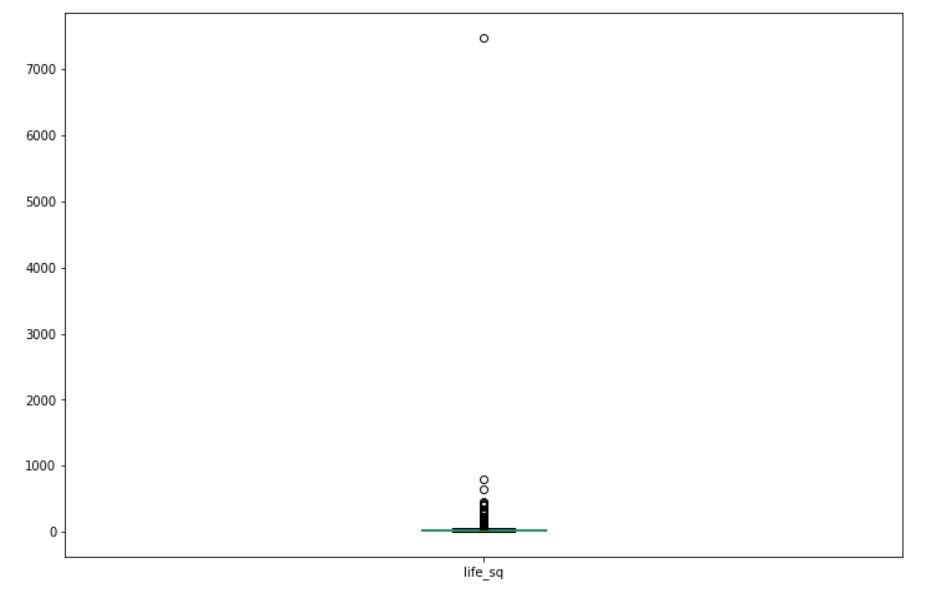
D'après la boîte à moustaches, il est clair que l'observation de la valeur maximale (7478) est une valeur aberrante dans ces données. Statistiques descriptives, Les boîtes à moustachesDiagrammes encadrés, Aussi connu sous le nom de diagrammes en boîte et à moustaches, sont des outils statistiques qui représentent la distribution d’un ensemble de données. Ces diagrammes montrent la médiane, quartiles et valeurs aberrantes, Permettre de visualiser la variabilité et la symétrie des données. Ils sont utiles pour la comparaison entre différents groupes et pour l’analyse exploratoire, faciliter l’identification des tendances et des modèles dans les données.... et les diagrammes de dispersion nous aident à identifier les valeurs aberrantes dans les données.
Nous pouvons traiter les valeurs aberrantes comme nous l'avons fait avec les valeurs manquantes. Nous pouvons supprimer les observations que nous pensons être des valeurs aberrantes, ou nous pouvons remplacer les valeurs aberrantes par des valeurs appropriées, ou nous pouvons faire une sorte de transformation sur les données (en logarithme ou en exponentiel). Dans notre cas, éliminons l'enregistrement où la valeur de ‘life_sq’ il est 7478.
# suppression de la valeur aberrante dans la colonne life_sq
df = df.loc[df.life_sq < 7478]
Enregistrements en double
Parfois, les données peuvent contenir des valeurs en double. Il est essentiel d'effacer les enregistrements en double de votre ensemble de données avant de poursuivre tout projet d'apprentissage automatique.. Dans nos données, puisque la colonne ID est un identifiant unique, nous éliminerons les enregistrements en double en considérant tous sauf la colonne ID.
# suppression des doublons en considérant toutes les colonnes autres que l'ID
cols_other_than_id = liste(df.colonnes)[1:]
df.drop_duplicates(sous-ensemble=cols_other_than_id, inplace=Vrai)
Cela nous aidera à supprimer les enregistrements en double. Lors de l'utilisation de la méthode de forme, vous pouvez vérifier que les enregistrements en double ont bien été supprimés. Le nombre d'observations est maintenant 30,434.
Correction du type de données
Souvent, dans le jeu de données, les valeurs ne sont pas stockées dans le type de données correct. Cela peut créer un barrage routier dans les étapes ultérieures et nous pouvons ne pas obtenir le résultat souhaité ou obtenir des erreurs lors de l'exécution.. Une erreur de type de données courante est celle des dates. Les dates sont souvent analysées comme des objets en Python. Il existe un type de données distinct pour les dates dans Pandas, appelé DateHeure.
Nous allons d'abord vérifier le type de données de la colonne d'horodatage dans nos données.
df.timestamp.dtype
Cela renvoie le type de données ‘objet’. Maintenant, nous savons que l'horodatage n'est pas stocké correctement. Pour résoudre ce problème, convertir la colonne d'horodatage au format DateTime.
# conversion de l'horodatage au format datetime
df['timestamp'] = pd.to_datetime(df.timestamp, format="%A-%m-%d")
Maintenant, nous avons l'horodatage dans le bon format. de la même manière, il peut y avoir des colonnes où les entiers sont stockés en tant qu'objets. Il est essentiel d'identifier ces caractéristiques et de corriger le type de données avant de procéder au machine learning.. Heureusement pour nous, nous n'avons pas de tels problèmes dans notre ensemble de données.
Note de fin
Dans ce billet, Nous avons discuté de quelques manières de base de nettoyer les données en Python avant de commencer notre projet d'apprentissage automatique.. Nous devons identifier et effacer les valeurs manquantes, identifier et traiter les valeurs aberrantes, effacez les enregistrements en double et corrigez le type de données de toutes les colonnes de notre ensemble de données avant de poursuivre notre tâche AA.
L'auteur de cet article est Vishesh Arora. Vous pouvez me joindre à LinkedIn.
Les médias présentés dans cet article sur l'accréditation en langue des signes ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





