Cet article a été publié dans le cadre du Blogathon sur la science des données.
Comprenez le problème du surapprentissage dans les arbres de décision et résolvez-le en réduisant la complexité et le coût minimal à l'aide de Scikit-Learn en Python
L'arbre de décision est l'un des outils les plus intuitifs et les plus efficaces de la boîte à outils d'un data scientist.. Il a une structure arborescente inversée qui était autrefois utilisée uniquement dans l'analyse de décision, mais maintenant c'est aussi un brillant algorithme d'apprentissage automatique, surtout quand on a un problème de tri sur les mains.
Ces arbres de décision sont bien connus pour leur capacité à capturer des modèles dans les données.. Mais, l'excès de quoi que ce soit est nocif, vérité? Les arbres de décision sont tristement célèbres car ils peuvent trop s'accrocher aux données sur lesquelles ils sont formés.
Donc, notre arbre donne des résultats d'implémentation médiocres car il ne peut pas traiter un nouvel ensemble de valeurs.
Mais ne t'inquiètes pas! Comme un mécanicien qualifié, il a des clés de toutes tailles disponibles dans sa boîte à outils, un expert data scientist a également son ensemble de techniques pour faire face à tout type de problème. Et c'est ce que nous allons explorer dans cet article..
Le rôle de la taille dans les arbres de décision
L'élagage est l'une des techniques utilisées pour surmonter notre problème de surapprentissage. Taille, au sens littéral, est une pratique qui implique l'enlèvement sélectif de certaines parties d'un arbre (la plante), comme des branches, pousses ou racines, pour améliorer la structure des arbres et favoriser une croissance saine. C'est exactement ce que fait également la taille avec nos arbres de décision. Cela le rend polyvalent pour qu'il puisse s'adapter si nous lui donnons de nouvelles informations, résolvant ainsi le problème du surapprentissage.
Réduire la taille d'un arbre de décision, lo que puede aumentar ligeramente el error de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines...., mais diminue considérablement l'erreur de test, ce qui le rend plus adaptable.
Élagage d'un coût et d'une complexité minimes est l'un des types d'élagage par arbre de décision.
Cet algorithme est paramétré par α (≥0) connu sous le nom de paramètre de complexité.
Le paramètre de complexité est utilisé pour définir la mesure de la complexité des coûts, Rune(T) d'un arbre donné T: Rune(T) = R (T) + une | T |
où | T | est le nombre de nœuds terminaux dans T et R (T) est traditionnellement défini comme le taux total de mauvaise classification des nœuds terminaux.
Dans sa version 0.22, Scikit-learn a introduit ce paramètre appelé ccp_alpha (Oui! C'est court pour Élagage de la complexité des coûts – Alfa) aux arbres de décision qui peuvent être utilisés pour faire la même chose.
Construire l'arbre de décision en Python
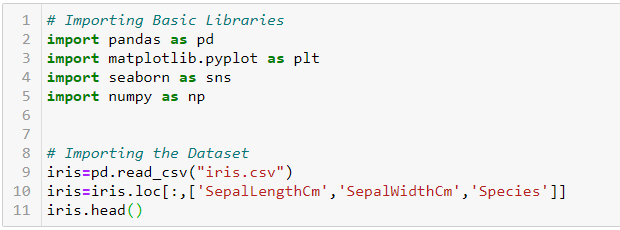
Nous utiliserons l'ensemble de données Iris pour ajuster l'arbre de décision. Vous pouvez télécharger le jeu de données ici.
Premier, importons les bibliothèques de base et l'ensemble de données requis:
L'ensemble de données ressemble à ceci:
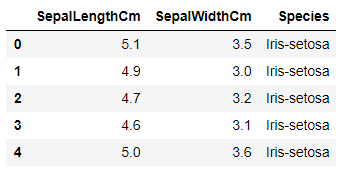
Notre objectif est de prédire l'espèce d'une fleur en fonction de la longueur et de la largeur de son sépale.
Nous allons diviser l'ensemble de données en deux parties: former et tester. Nous faisons cela pour que nous puissions voir comment notre modèle fonctionne également sur des données invisibles. Nous utiliserons le train_test_split fonction de sklearn.model_selection diviser l'ensemble de données.
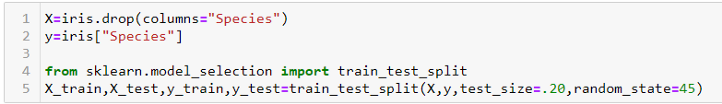
À présent, ajustons un arbre de décision à la partie du train et prédisons à la fois dans le test et dans la formation. nous utiliserons DecisionTreeClassifier de sklearn.tree dans ce but.
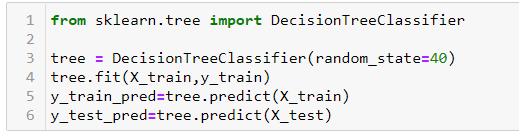
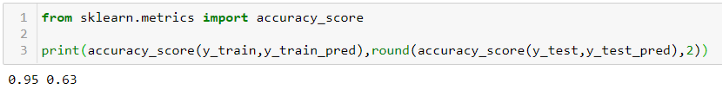
Par défaut, la fonction arbre de décision ne fait pas d'élagage et permet à l'arbre de grandir autant qu'il le peut. On obtient un score de précision de 0,95 Oui 0,63 dans le train et sur l'éprouvette, respectivement, comme il est montré dans ce qui suit. On peut dire que notre modèle est sur-équipé, c'est-à-dire, mémoriser la partie du train, mais cela peut ne pas fonctionner aussi bien dans la partie test.
Arbre de décision dans sklearn, il a une fonction appelée cost_complexity_pruning_path, qui donne les alphas effectifs des sous-arbres lors de la taille ainsi que les impuretés correspondantes. En d'autres termes, nous pouvons utiliser ces valeurs alpha pour élaguer notre arbre de décision:
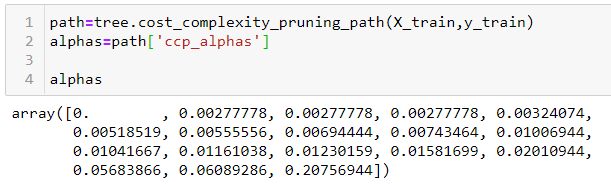
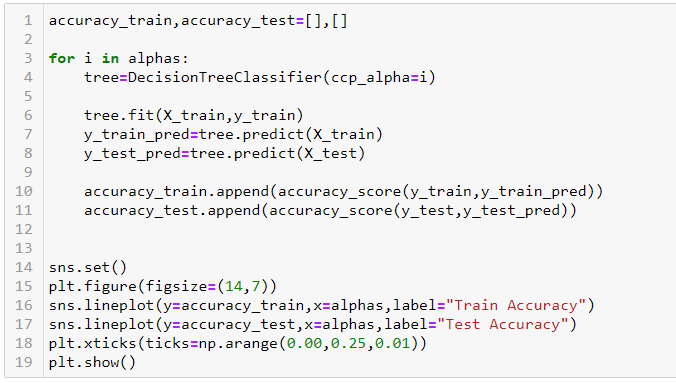
Nous allons définir ces valeurs alpha et les transmettre à ccp_alpha paramètre de notre DecisionTreeClassifier. En boucle dessus alfa quartier général, nous trouverons la précision dans les parties d'entraînement et de test de notre ensemble de données.
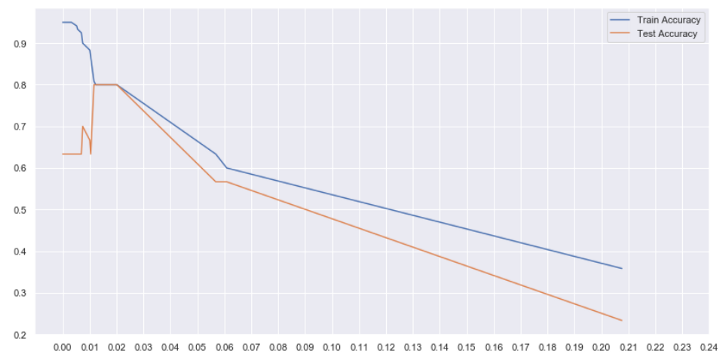
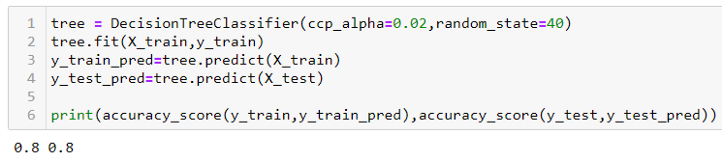
Dans le graphique ci-dessus, on voit qu'entre alpha = 0.01 Oui 0.02, nous obtenons la plus haute précision de test. Bien que la précision de notre train ait diminué à 0,8, notre modèle est maintenant plus généralisé et fonctionnera mieux avec des données invisibles.