
Cet article a été publié dans le cadre de la Blogathon sur la science des données
introduction
Théorie de la décision bayésienne fait référence à l'approche statistique basée sur la quantification des arbitrages entre différentes décisions de classification basée sur le concept de probabilité (Théorème de Bayes) et les coûts associés à la décision.
C'est simplement une technique de classification qui implique l'utilisation du théorème de Bayes qui est utilisé pour trouver les probabilités conditionnelles.
Dans Accréditation des modèles statistiques, nous nous concentrerons sur les propriétés statistiques des motifs qui s'expriment généralement en densités de probabilité (pdf et pmf), et cela attirera l'essentiel de notre attention dans cet article et tentera de développer les arguments de la théorie bayésienne de la décision.
Conditions préalables
VariableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... Aléatoire
Une variable aléatoire est une fonction qui attribue un ensemble réalisable de résultats à certaines valeurs, comme lancer une pièce et obtenir le côté H comme 1 et la queue en T comme 0, où 0 Oui 1 ce sont des variables aléatoires.
Théorème de Bayes
La probabilité conditionnelle de A étant donné B, représenté par P (UNE | B) est la probabilité que A se produise étant donné que B s'est produit.
P (UNE | B) = P (UNE, B) / P (B) O
Lors de l'utilisation de la règle de chaîne, cela peut aussi s'écrire comme:
P (UNE, B) = P (UNE | B) P (B) = P (B | UNE) P (UNE)
P (UNE | B) = P (B | UNE) P (UNE) / P (B) ——- (1)
Où, P (B) = P (B, UNE) + P (B, UNE ‘) = P (B | UNE) P (UNE) + P (B | UNE’) P (UNE ‘)
Ici, L'équation (1) est connu comme Théorème de probabilité de Bayes
Notre objectif est d'explorer chacune des composantes incluses dans ce théorème. Explorons pas à pas:
(une) Antécédent ou état de nature:
- Les probabilités a priori représentent la probabilité que chaque classe se produise.
- Les éléments ci-dessus sont connus avant la procédure de formation.
- L'état de nature est une variable aléatoire P (wje).
- S'il n'y a que deux classes, alors la somme de ce qui précède est P (w1) + P (w2) = 1, si les cours sont exhaustifs.
(b) Probabilités conditionnelles de classe:
- Représente la probabilité de la probabilité qu'une caractéristique x se produise étant donné qu'elle appartient à la classe particulière. Il est désigné par, P (X | UNE) où x est une caractéristique particulière
- C'est la probabilité de la probabilité que la caractéristique x se produise étant donné qu'elle appartient à la classe wje.
- Parfois, il est également connu sous le nom Probabilité.
- C'est la quantité que nous devons examiner lors de l'apprentissage des données. Tout au long de la entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines...., nous avons l'entrée (fonctionnalités) X étiqueté à la classe respective w et nous calculons la probabilité d'occurrence de cet ensemble de caractéristiques étant donné l'étiquette de la classe.
(c) Preuve:
- C'est la probabilité qu'une caractéristique particulière se produise, En d'autres termes P (X).
- Il peut être calculé en utilisant la règle de la chaîne comme, P (X) =dans P (X | wje) P (wje)
- Comment nous avons besoin de la probabilité de probabilité conditionnelle de classe, de plus, les valeurs des preuves sont calculées tout au long de la formation.
(ré) Probabilités postérieures:
- C'est la probabilité que la classe A se produise lorsque certaines caractéristiques se produisent.
- C'est ce que nous avons l'intention de calculer dans l'étape de test dans laquelle nous avons une entrée de test ou des caractéristiques (l'entité donnée) et nous devons trouver la probabilité que le modèle formé puisse prédire des caractéristiques qui appartiennent à la classe particulière wje.
Pour une meilleure compréhension de la théorie ci-dessus, nous considérons un exemple
description du problème
Supposons que nous ayons un énoncé d'un obstacle de classification dans lequel nous devons catégoriser entre l'objet 1 et l'objet 2 avec l'ensemble donné de caractéristiques. X = [X1, X2, …, Xm]T.
Cibler
L'objectif principal de la conception d'un tel classificateur est de suggérer des actions lorsqu'elles sont présentées avec des caractéristiques invisibles., En d'autres termes, un objet pas encore vu, En d'autres termes, pas dans les données d'entraînement.
Dans cet exemple, w désigne l'état de la nature avec w = w1 pour objet-1 Oui w = w2 pour objet-2. Ici, nous devons savoir qu'en fait, l'état de nature est si imprévisible qu'en général on considère que celui décrit de manière probabiliste était variable.
Prieurs
- Généralement, nous supposons qu'il existe une valeur précédente P (w1) que l'objet suivant est l'objet-1 et P (w2) que l'objet suivant est l'objet-2. Si nous n'avons pas d'autre objet comme dans ce problème, alors la somme de ses précédentes est 1, En d'autres termes, ce qui précède est exhaustif.
- Les probabilités a priori reflètent la connaissance a priori de la probabilité que nous obtenions l'objet 1 et l'objet 2. ça dépend du domaine, puisque le précédent peut changer en fonction de la période de l'année à laquelle il est détecté.
Cela semble un peu étrange et lors de l'évaluation de plusieurs objets (comme dans un scénario plus réaliste) rend cette règle de décision stupide puisque nous prenons toujours la même décision en fonction de la majeure précédente même si nous savons que tout autre type d'objectif pourrait également apparaître régi par les probabilités a priori excédentaires (puisque ce qui précède est de nature exhaustive).
Considérez les différents scénarios suivants:
- Et P (??1) >>> P (??2), notre décision en faveur de ω1 sera correct la plupart du temps, nous prédisons.
- Mais si P (??1) = P (??2), moyens probables de notre prédiction pour être correct. En général, la probabilité d'erreur est le minimum de P (??1) yP (??2), et plus tard dans ce post, nous verrons que dans ces conditions aucune autre règle de décision ne peut produire une plus grande probabilité d'être correcte.
Procédure d'extraction de caractéristiques (Extraire la fonctionnalité des images)
Un ensemble de fonctionnalités suggérées Long, largeur, alternatives pour un objetetc.
Dans notre exemple, nous utilisons le largeur x, Ce qui est plus discriminatoire pour piloter la règle de décision de notre classificateur. Les différents objets produiront des lectures différentes de largeur variable et d'une manière générale on voit cette variabilité en termes probabilistes et on considère aussi que x est une variable aléatoire continue dont la distribution dépend du type d'objet wj, et s'exprime par p (X | ??j) (fonction de distribution de probabilité pdf en tant que variable continue) et connue sous le nom de fonction de densité de probabilité conditionnelle de classe. Pour cela,
Le pdf p (X | ??1) est la fonction de densité de probabilité pour la caractéristique x étant donné que l'état de la nature est ω1 et même interprétation pour p (X | w2).
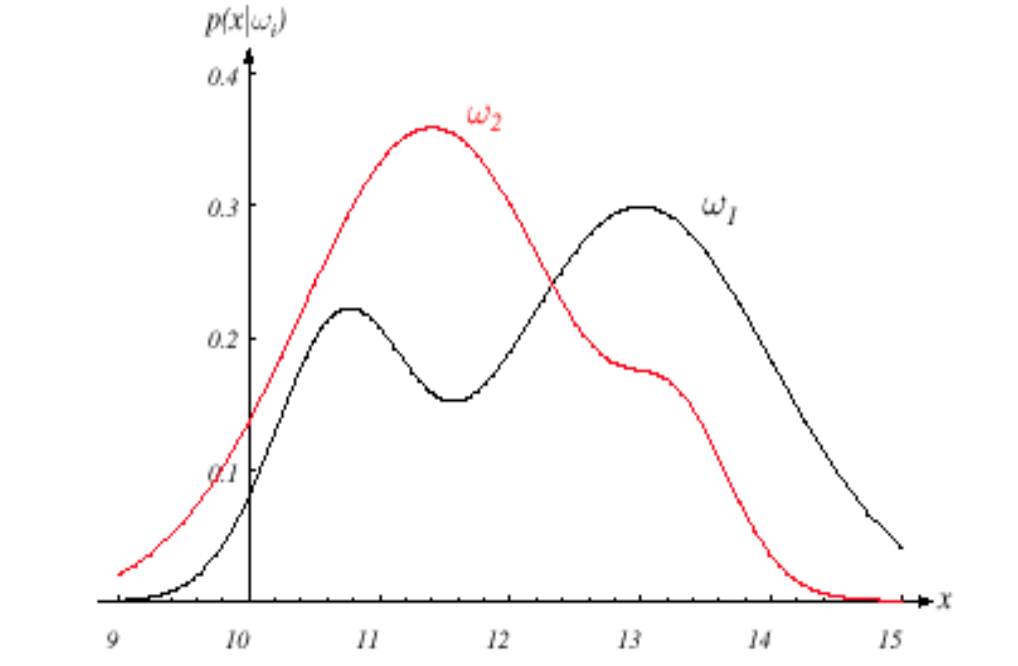
Figure. Image montrant le pdf pour les deux classes
Source de l'image: Google images
Supposons que nous connaissions bien les probabilités a priori P (??j) et les densités conditionnelles p (X | ??j). À présent, on peut arriver à la formule de Bayes pour trouver des probabilités postérieures:
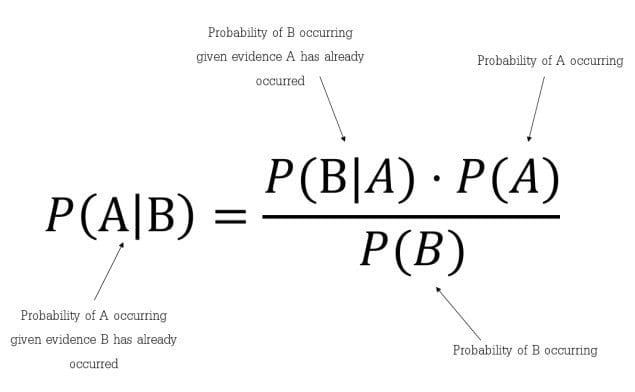
Figure. Formule du théorème de Bayes
Source de l'image: Google images
La formule de Bayes nous donne l'intuition qu'en observant la mesure de x on peut convertir le P (??j) pour plus tard, noté P (??j| X) qui est la probabilité dej puisque la valeur caractéristique x a été mesurée.
p (X | ??j) est connue comme la probabilité dej par rapport à la hache.
Le facteur de preuve, p (X), fonctionne simplement comme un facteur d'échelle garantissant que les probabilités postérieures s'additionnent à un pour toutes les classes.
Règle de décision de Bayes
La règle de décision compte tenu des probabilités postérieures est la suivante
Et P (w1| X)> P (w2| X) nous déciderions que l'objet appartient à la classe w1, ou sinon classe w2.
Probabilité d'erreur
Pour justifier notre décision, on regarde la probabilité d'erreur, tant que nous observons x, avoir,
P (Erreur | X) = P (w1| X) si nous décidons w2, Oui P (w2| X) si nous décidons w1
En quoi elles sont exhaustives et si l'on choisit la nature correcte d'un objet par probabilité P, alors la probabilité restante (1-P) montrera à quel point la décision est probable que ce n'est pas l'objet décidé.
Nous pouvons minimiser la probabilité d'erreur en décidant lequel a un postérieur plus élevé et le reste puisque la probabilité d'erreur sera le minimum faisable. Donc pour finir on obtient
P (Erreur | X) = min [P(??1|X),P(??2|X)]
Et notre règle de décision de Bayes comme,
Elegir1 et P (??1| X)> P (??2| X); sinon décidez2
Ce type de règle de décision met en évidence le rôle des probabilités postérieures. A l'aide du théorème de Bayes, on peut exprimer la règle en termes de probabilités a priori et conditionnelles.
La preuve n'est pas pertinente en ce qui concerne la décision. Comme nous l'avons précédemment commenté, cela fonctionne simplement comme un facteur d'échelle qui indique à quelle fréquence nous allons mesurer la caractéristique avec la valeur x; assure P (??1| X) + P (??2| X) = 1.
Ensuite, en supprimant le facteur d'échelle non requis dans notre règle de décision, nous avons la règle de décision similaire du théorème de Bayes comme,
Elegir1 et P (X | ??1) P (??1)> p (X | ??2) P (??2); sinon décidez2
À présent, considérons 2 cas:
- Cas 1: Si les conditionnels de classe sont égaux, En d'autres termes, p (X | ??1) = p (X | ??2), Nous arrivons alors à notre règle de décision prématurée régie par juste a priori.
- Cas 2: D'autre part, si ce qui précède est le même, En d'autres termes, P (??1) = P (??2) alors la décision est entièrement basée sur des conditionnels de classe p (X | ??j).
Ceci termine notre exemple de formulation !!
Généralisation des idées ci-dessus pour plusieurs classes et caractéristiques
Classement de Bayes: postérieur, vraisemblance, antécédent et preuve
P (wje | X) = P (X | wje) P (wje) / P (X)
Postérieur = Probabilité * Précédent / Preuve
Nous discutons maintenant des cas qui ont plusieurs caractéristiques, ainsi que plusieurs classes,
Laissez plusieurs fonctionnalités être X1, X2, … XNord et plusieurs classes sont w1, w2,… WNord, après:
P (wje | X1,…. XNord) = P (X1,…. , XNord| wje) * P (wje) / P (X1,… XNord)
Où,
Postérieur = P (wje | X1,…. XNord)
Probabilité = P (X1,…. , XNord| wje)
Précédent = P (wje)
Preuve = P (X1,… ,XNord)
Dans les cas des mêmes modèles entrants, nous devrons peut-être utiliser une fonction de coût radicalement différente, qui conduira à des actions absolument différentes. Généralement, différentes tâches de décision peuvent nécessiter des caractéristiques et des limites de performances assez différentes de celles utiles pour notre problème de catégorisation d'origine.
Ensuite, dans les messages suivants, nous discuterons de la Fonction de coût, Analyse de risque, Oui action décisive qui aidera à mieux comprendre la théorie de la décision de Bayes.
Remarques finales
Merci pour la lecture!
Si vous avez aimé cela et que vous voulez en savoir plus, visitez mes autres articles sur la science des données et l'apprentissage automatique en cliquant sur le Relier
N'hésitez pas à me contacter au Linkedin, E-mail.
Tout ce qui n'est pas mentionné ou voulez-vous partager vos pensées? N'hésitez pas à commenter ci-dessous et je vous répondrai.
A propos de l'auteur
Chirag Goyal
Aujourd'hui, Je poursuis mon Bachelor of Technology (B.Tech) en informatique et ingénierie de Institut indien de technologie Jodhpur (IITJ). Je suis très enthousiasmé par l'apprentissage automatique, les l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... et l’intelligence artificielle.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





