
Vue d'ensemble
- Voici une introduction rapide à la création de pipelines de ML avec PySpark
- La capacité à créer ces pipelines d'apprentissage automatique est une compétence indispensable pour tout chercheur de données en herbe.
- Ceci est un article pratique avec une approche de code structuré de PySpark, Alors préparez votre IDE python préféré!
introduction
Prenez un moment pour y réfléchir.: Quelles sont les compétences qu'un aspirant data scientist doit posséder pour obtenir un poste dans l'industrie?
UNE apprentissage automatique Le projet comporte de nombreux composants mobiles qui doivent être réunis avant de pouvoir l'exécuter avec succès. La capacité de savoir comment construire un pipeline de machine learning de bout en bout est un atout précieux. En tant que data scientist (aspirant ou établi), vous devez savoir comment fonctionnent ces pipelines d'apprentissage automatique.
C'est, en peu de mots, la fusion de deux disciplines: science des données et génie logiciel. Ces deux éléments vont de pair pour un data scientist. Il ne s'agit pas seulement de construire des modèles, nous devons avoir les compétences logicielles pour créer des systèmes de niveau entreprise.
Ensuite, dans cet article, nous nous concentrerons sur l'idée de base derrière la construction de ces pipelines d'apprentissage automatique à l'aide de PySpark. Ceci est un article pratique, alors démarrez votre IDE python préféré et c'est parti !!
Noter: C'est la partie 2 de ma série PySpark pour les débutants. Vous pouvez consulter l'article d'introduction ci-dessous:
Table des matières
- Effectuer des opérations de base sur une trame de données Spark
- Lire un fichier CSV
- Définir le schéma
- Explorer les données à l'aide de PySpark
- Vérifier les dimensions des données
- Décrire les données
- Nombre de valeurs manquantes
- Trouver le nombre de valeurs uniques dans une colonne
- Encoder des variables catégorielles à l'aide de PySpark
- Indexation des chaînes
- Un codage à chaud
- Assembleur de vecteurs
- Construire des pipelines de machine learning avec PySpark
- Transformateurs et estimateurs
- Exemples de tuyaux
Effectuer des opérations de base sur une trame de données Spark
Une étape indispensable (et d'abord) dans tout projet de science des données est de comprendre les données avant de construire tout Apprentissage automatique maquette. La plupart des aspirants à la science des données trébuchent ici, ils ne passent tout simplement pas assez de temps à comprendre avec quoi ils travaillent. Il y a une tendance à se précipiter et à construire des modèles, une erreur qui devrait éviter.
Nous suivrons ce principe dans cet article.. Je suivrai une approche structurée à tout moment pour m'assurer que nous ne manquons aucune étape critique.
Premier, prenons un moment pour comprendre chaque variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... avec laquelle nous travaillerons ici. Nous allons utiliser un ensemble de données d'un Match de cricket Inde contre Bangladesh. Voyons les différentes variables que nous avons dans l'ensemble de données:
- Battre: Identification unique de la pâte (entier)
- Batsman_Name: Nom du batteur (Chaîne de caractères)
- quilleur: Identification unique du quilleur (entier)
- Bowler_Name: Nom du lanceur (Chaîne de caractères)
- Commenter: Description de l'événement tel que diffusé (chaîne)
- Détail: Une autre chaîne qui décrit les événements comme des fenêtres et des livraisons supplémentaires (Chaîne)
- Mis à la porte: Identification unique de la pâte si elle est jetée (Chaîne de caractères)
- identifiant: identifiant de file d'attente unique (chaîne)
- Isball: Si la livraison était légale ou non (booléen)
- Isfrontière: Que le frappeur ait atteint une limite ou non (des pistes)
- Iswicket: Que le frappeur ait tiré ou non (des pistes)
- Sur: A propos du nombre (Double)
- Carrières: Il fonctionne sur cette tranche particulière (entier)
- Horodatage: Heure à laquelle les données ont été enregistrées (horodatage)
Alors, commençons, d'accord?
Lire un fichier CSV
Quand on allume Spark, les SparkSession La variable est convenablement disponible sous le nom ‘Étincelle – étincelle‘. Nous pouvons l'utiliser pour lire différents types de fichiers, au format CSV, JSONJSON, o Notation d’objet JavaScript, Il s’agit d’un format d’échange de données léger, facile à lire et à écrire pour les humains, et facile à analyser et à générer pour les machines. Il est couramment utilisé dans les applications Web pour envoyer et recevoir des informations entre un serveur et un client. Sa structure est basée sur des paires clé-valeur, ce qui le rend polyvalent et largement adopté dans le développement de logiciels.., TEXTE, etc. Cela nous permet d'enregistrer les données en tant que trame de données Spark.
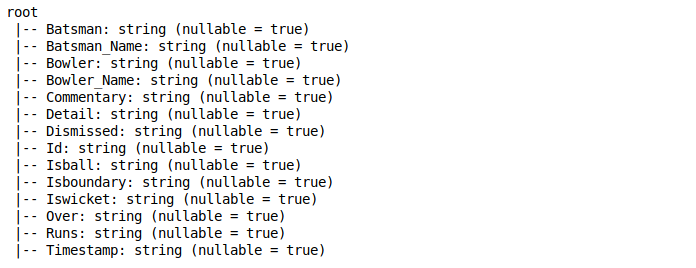
Par défaut, traite le type de données de toutes les colonnes comme une chaîne. Vous pouvez vérifier les types de données en utilisant le printSchéma fonction dans le trame de données:
Définir le schéma
À présent, nous ne voulons pas que toutes les colonnes de notre ensemble de données soient traitées comme des chaînes. Ensuite, Que pouvons-nous y faire?
Nous pouvons définir le schéma personnalisé pour notre bloc de données dans Spark. Pour ca, nous devons créer un objet de TypeStructure qui a une liste de ChampStructure. Et bien sûr, nous devrions définir ChampStructure avec un nom de colonne, le type de données de la colonne et si les valeurs nulles sont autorisées pour la colonne particulière ou non.
Veuillez vous référer à l'extrait de code suivant pour comprendre comment créer ce schéma personnalisé:
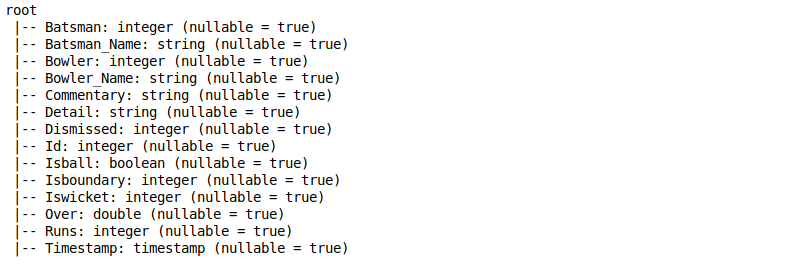
Supprimer des colonnes de données
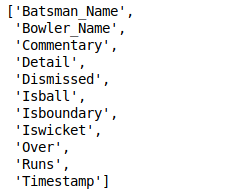
Dans tout projet d'apprentissage automatique, nous avons toujours des colonnes qui ne sont pas nécessaires pour résoudre le problème. Je suis sûr que vous avez déjà été confronté à ce dilemme auparavant, soit dans l'industrie, soit dans un hackathon en ligne.
Dans notre cas, nous pouvons utiliser la fonction drop pour supprimer la colonne des données. Utilisez le astérisque
pipeline d'apprentissage automatique pyspark
Explorer les données à l'aide de PySpark
Vérifier les dimensions des données
Contrairement aux pandas, Les cadres de données Spark n'ont pas la fonction de forme pour vérifier les dimensions des données. À sa place, nous pouvons utiliser le code ci-dessous pour vérifier les dimensions du jeu de données:
Décrire les données Étincelles décris La fonction nous donne la plupart des résultats statistiques comme la moyenne, compter, le minimum, maximum et écart type. Vous pouvez utiliser le résumé
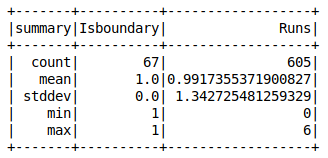
pipeline d'apprentissage automatique pyspark
Nombre de valeurs manquantes
C'est bizarre quand nous obtenons un ensemble de données sans valeurs manquantes. Pouvez-vous vous rappeler la dernière fois que c'est arrivé?
Il est important de vérifier le nombre de valeurs manquantes présentes dans toutes les colonnes. Connaître le nombre nous aide à gérer les valeurs manquantes avant de créer un modèle d'apprentissage automatique avec ces données..
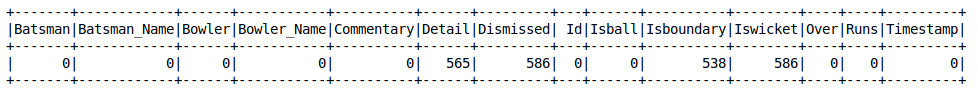
pipeline d'apprentissage automatique pyspark
Nombre de valeurs d'une colonne Contrairement aux pandas, nous n'avons pas le value_counts () fonction dans les dataframes Spark. Vous pouvez utiliser le par groupe
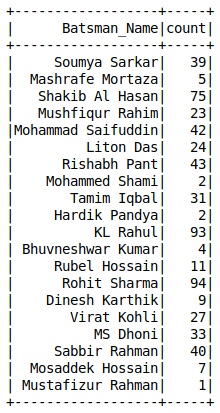
pipeline d'apprentissage automatique pyspark
Encoder des variables catégorielles à l'aide de PySpark
La plupart des algorithmes d'apprentissage automatique n'acceptent les données que sous forme numérique. Donc, il est essentiel de convertir toute variable catégorielle présente dans notre ensemble de données en nombres.
N'oubliez pas que nous ne pouvons pas simplement les supprimer de notre ensemble de données, car ils peuvent contenir des informations utiles. Ce serait un cauchemar de perdre ça juste parce que nous ne voulons pas savoir comment les utiliser !!
Voyons quelques-unes des méthodes pour encoder des variables catégorielles à l'aide de PySpark.
Indexation des chaînes
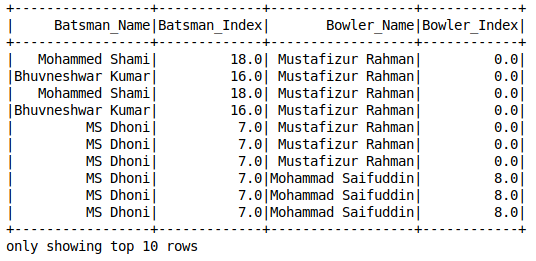
pipeline d'apprentissage automatique pyspark
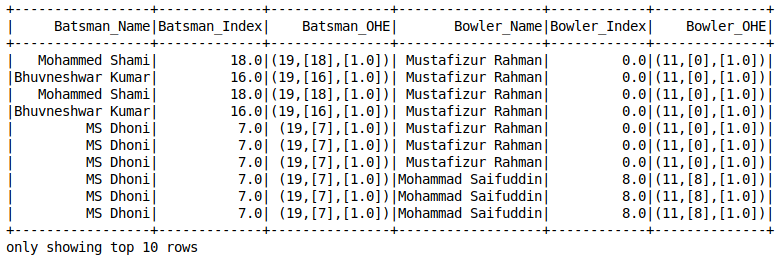
Codage à chaud
Le codage à chaud est un concept que tout scientifique des données devrait connaître. Je lui ai fait confiance à plusieurs reprises face aux valeurs manquantes. C'est une bouée de sauvetage! Voici l'avertissement: Étincelle’s OneHotEncoder
n'encode pas directement la variable catégorielle. Premier, nous devons utiliser String Indexer pour convertir la variable sous forme numérique, puis utiliser OneHotEncoderEstimator
pour encoder plusieurs colonnes de l'ensemble de données.
pipeline d'apprentissage automatique pyspark
Assembleur de vecteurs
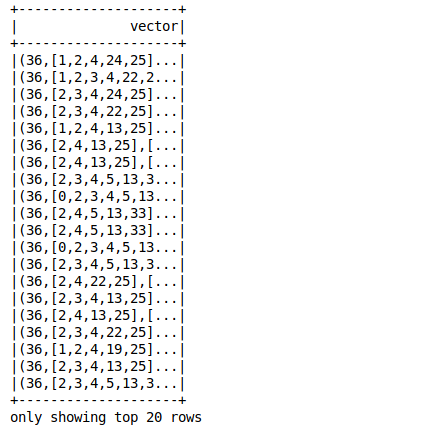
Un assembleur vectoriel combine une liste donnée de colonnes en une seule colonne vectorielle.
Ceci est généralement utilisé à la fin des étapes d'exploration et de prétraitement des données. À ce stade, nous travaillons généralement avec des fonctionnalités brutes ou transformées qui peuvent être utilisées pour entraîner notre modèle. Vector Assembler les convertit en une seule colonne de fonctionnalités pour former le modèle d'apprentissage automatique
pipeline d'apprentissage automatique pyspark
Construire des pipelines de machine learning avec PySpark
Un projet de machine learning implique généralement des étapes telles que le prétraitement des données, extraction de caractéristiques, ajustement du modèle et évaluation des résultats. Nous devons effectuer de nombreuses transformations sur les données en séquence. Comme vous pouvez l'imaginer, les suivre peut devenir une tâche fastidieuse.
C'est là qu'interviennent les pipelines d'apprentissage automatique..
Un pipelinePipeline est un terme utilisé dans divers contextes, principalement dans la technologie et la gestion de projets. Il fait référence à un ensemble de processus ou d'étapes permettant un flux de travail continu depuis la conception d'une idée jusqu'à sa mise en œuvre finale. Dans le domaine du développement de logiciels, par exemple, un pipeline peut inclure la programmation, les tests et le déploiement, garantissant ainsi une plus grande efficacité et qualité dans les.... nous permet de maintenir le flux de données de toutes les transformations pertinentes nécessaires pour atteindre le résultat final. Nous devons définir les étapes du pipeline qui agissent comme une chaîne de commande pour que Spark s'exécute. Ici,
chaque étape est un transformateur ou un estimateurLe "Estimateur" est un outil statistique utilisé pour déduire les caractéristiques d’une population à partir d’un échantillon. Il s’appuie sur des méthodes mathématiques pour fournir des estimations précises et fiables. Il existe différents types d’estimateurs, tels que l’impartialité et la cohérence, qui sont choisis en fonction du contexte et de l’objectif de l’étude. Son utilisation correcte est essentielle dans la recherche scientifique, enquêtes et analyses de données.....
Transformateurs et estimateurs Comme le nom le suggère, Transformateurs
convertir une trame de données en une autre en mettant à jour les valeurs actuelles d'une colonne particulière (comment convertir des colonnes catégorielles en numérique) ou en le mappant à d'autres valeurs à l'aide d'une logique définie. Un estimateur implémente le pour se adapter à() méthode dans un bloc de données et produit un modèle. Par exemple, Régression logistique est un estimateur qui forme un modèle de classification lorsque nous appelons le pour se adapter à()
méthode.
Comprenons cela à l'aide de quelques exemples.
Exemples de tuyaux
pipelines d'apprentissage automatique pyspark
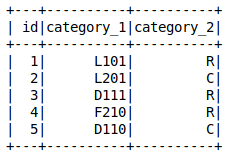
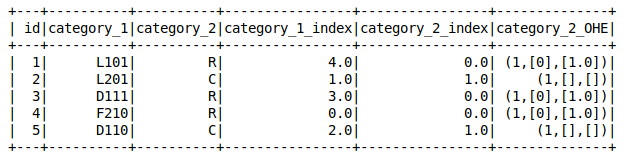
- Nous avons créé le bloc de données. Supposons que nous devons transformer les données dans l'ordre suivant: étape 1: Label Encode o String Index la columna
- Catégorie 1 étape_2: Label Encode o String Index la columna
- catégorie_2 étape_3: One-Hot Encode la colonne indexée
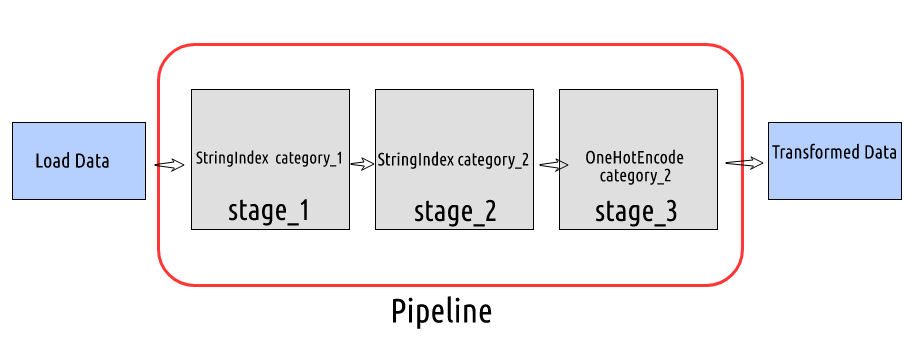
pipelines d'apprentissage automatique pyspark A chaque étape, nous allons passer le nom de la colonne d'entrée et de sortie et configurer le pipeline en passant les étapes définies dans la liste des Pipeline
objet.
pipelines d'apprentissage automatique pyspark
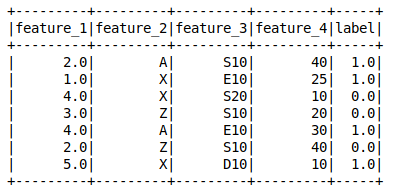
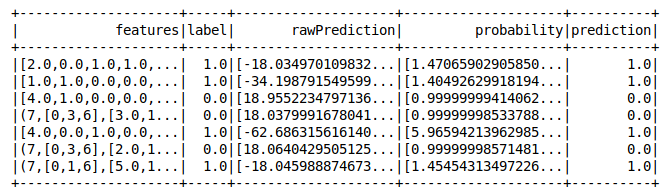
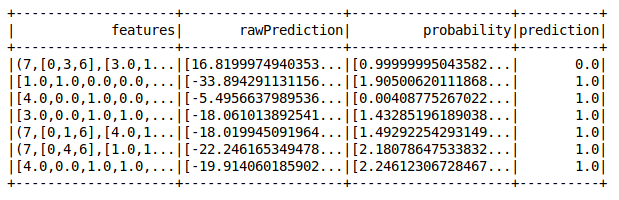
À présent, Prenons un exemple plus complexe de configuration d'un pipeline. Ici, nous allons transformer les données et construire un modèle de régression logistique.
pipelines d'apprentissage automatique pyspark
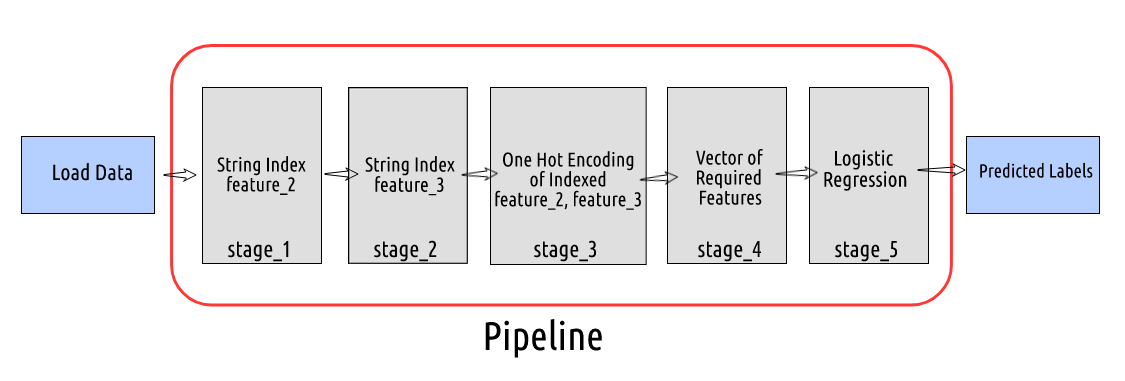
- À présent, supposons que ce soit l'ordre de notre canalisation: étape 1: Label Encode o String Index la columna
- fonctionnalité_2 étape_2: Label Encode o String Index la columna
- feature_3 étape_3: One Hot Encoder la colonne indexée de fonctionnalité_2 Oui
- feature_3
- étape_4: Créer un vecteur de toutes les caractéristiques nécessaires pour former un modèle de régression logistique
pipelines d'apprentissage automatique pyspark
pipelines d'apprentissage automatique pyspark
pipelines d'apprentissage automatique pyspark
Parfait!
Remarques finales
Il s'agissait d'un article court mais intuitif sur la façon de créer des pipelines d'apprentissage automatique à l'aide de PySpark. Je vais le répéter encore parce que c'est tellement important: vous devez savoir comment fonctionnent ces tuyaux. C'est une grande partie de votre rôle en tant que data scientist..
Avez-vous déjà travaillé sur un projet de machine learning de bout en bout? Ou avez-vous fait partie d'une équipe qui a construit ces tuyaux dans un environnement industriel? Connectons-nous dans la section des commentaires ci-dessous et discutons.
Rendez-vous dans le prochain article sur cette série PySpark pour les débutants. Bon apprentissage!
En rapport





