
Cet article a été publié dans le cadre du Blogathon sur la science des données.
introduction
« Cela fait partie du stage d'éditeur de contenu »
« Chaque fois que je vais au cinéma, c'est magique, peu importe ce que c'est ». – Steven Spielberg
Tout le monde aime les films, quel que soit votre âge, sexe, course, couleur ou situation géographique. Tous, en quelque sorte, nous sommes connectés les uns aux autres à travers ce médium incroyable. Cependant, le plus intéressant est le fait que unique nos choix et combinaisons sont en termes de préférences de films. Certaines personnes aiment les films de genre, soit du suspense, romance ou science-fiction, tandis que d'autres se concentrent sur les principaux acteurs et réalisateurs. Quand on prend tout ça en compte, il est incroyablement difficile de généraliser un film et de dire que tout le monde l'aimerait. Mais avec tout cela dit, Des films similaires sont toujours appréciés par une partie spécifique de la société.
C'est donc ici que nous, en tant que data scientists, nous entrons en jeu et extrayons le jus de tous modèles de comportement non seulement du public mais aussi des films eux-mêmes. Ensuite, sans plus de préambules, passons directement aux bases d'un système de recommandation.
Qu'est-ce qu'un système de recommandation?
Il suffit de mettre un Système de recommandation est un programme de filtrage dont l'objectif principal est de prédire la « qualification » ouais « préférence » d'un utilisateur à un élément ou un élément spécifique du domaine. Dans notre cas, cet élément spécifique au domaine est un film, donc, l'objectif principal de notre système de recommandation est de filtrer et de prédire uniquement les films qu'un utilisateur préférerait étant donné certaines données sur l'utilisateur lui-même.
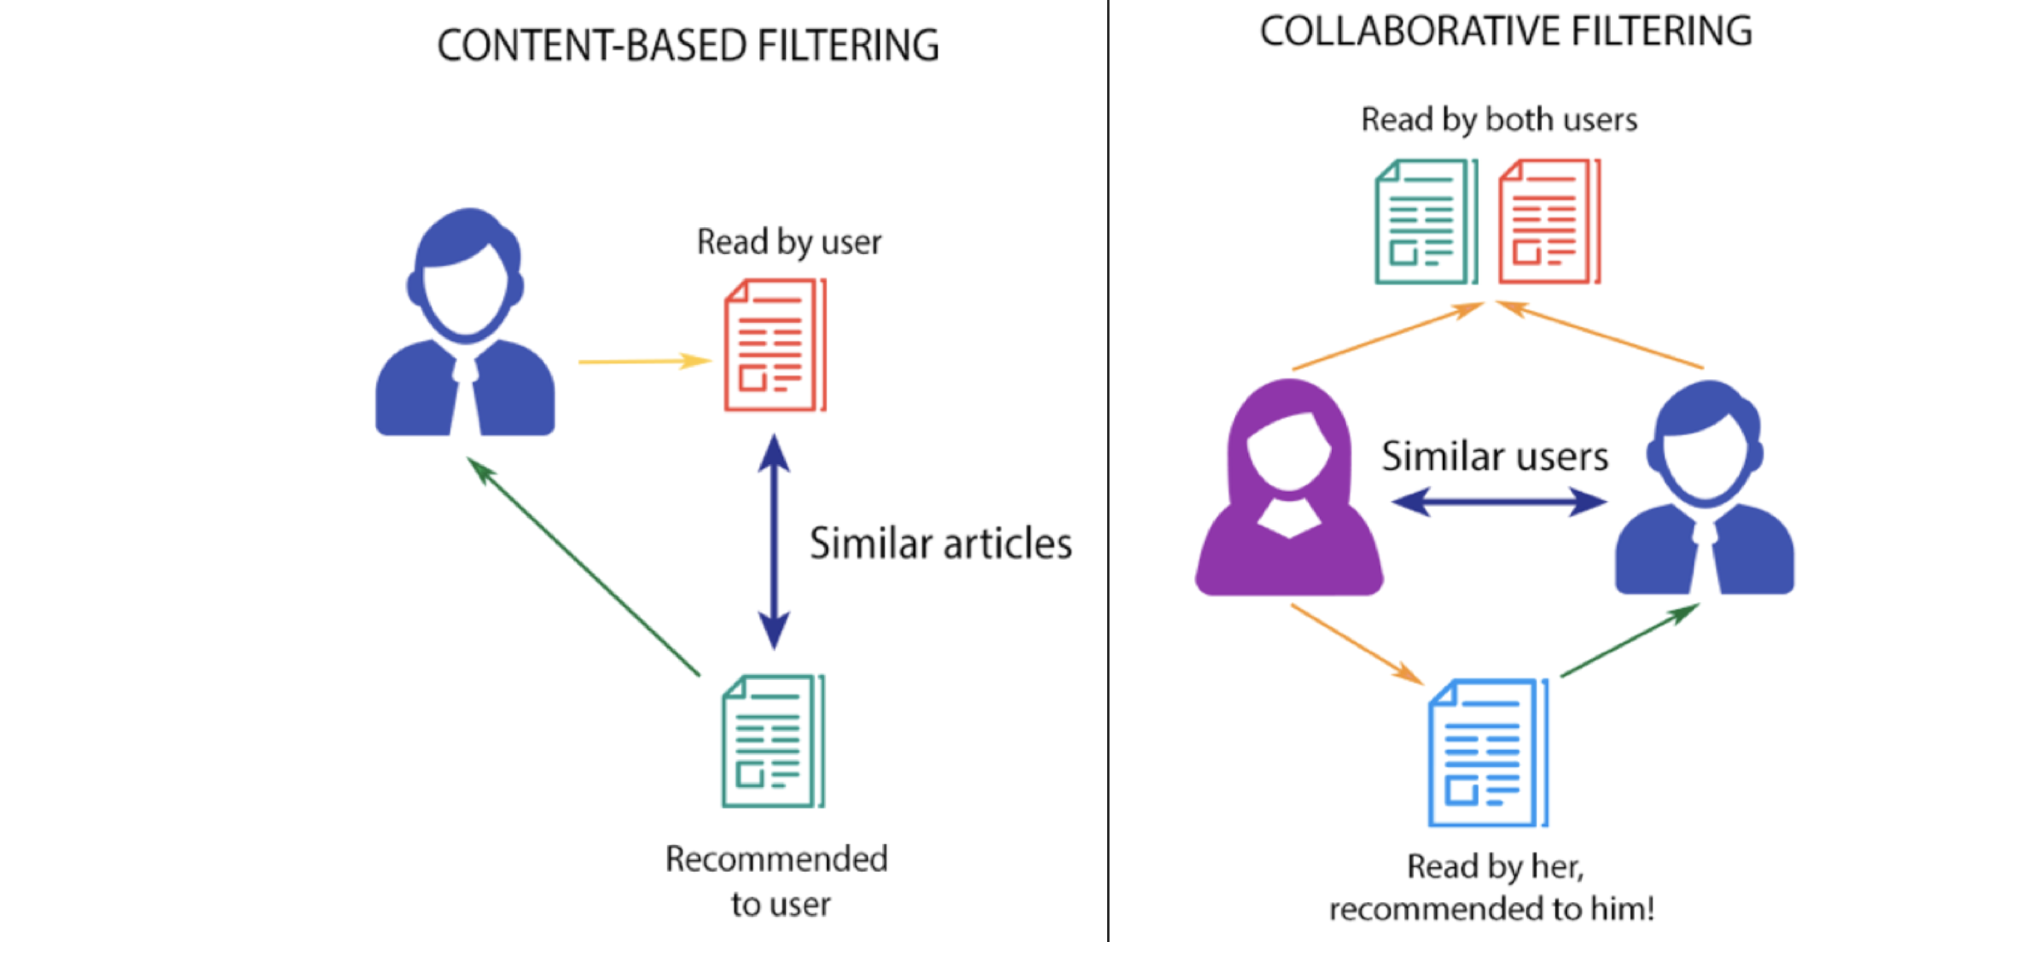
-
filtrage basé sur le contenu
Cette stratégie de filtrage est basée sur les données fournies sur les articles. L'algorithme recommande des produits qui sont similaire qui a aimé un utilisateur dans le dernier. Cette similitude (similitude généralement cosinus) est calculé à partir des données dont nous disposons sur les éléments, ainsi que les préférences passées de l'utilisateur.
Par exemple, si a un usuario le gustan películas como ‘The Prestige’ entonces podemos recomendarle las películas de ‘Christian Bale’ o películas del género ‘Thriller’ o tal vez incluso películas dirigidas por ‘Christopher Nolan’. Le système de recommandation vérifie les préférences passées de l'utilisateur et trouve le film « Le prestige », luego intenta encontrar películas similares a la que utiliza la información disponible en la base de donnéesUne base de données est un ensemble organisé d’informations qui vous permet de stocker, Gérez et récupérez efficacement les données. Utilisé dans diverses applications, Des systèmes d’entreprise aux plateformes en ligne, Les bases de données peuvent être relationnelles ou non relationnelles. Une bonne conception est essentielle pour optimiser les performances et garantir l’intégrité de l’information, facilitant ainsi la prise de décision éclairée dans différents contextes...., en tant qu'acteurs principaux, le directeur, le genre du film, la maison de fabrication, etc y, sur la base de ces informations, Recherchez des films comme « Le Prestige ».
Désavantages
- Différents produits ne rapportent pas grand-chose exposition à l'utilisateur.
- Les entreprises ne peuvent pas être développées car l'utilisateur n'essaie pas différents types de produits.
-
Filtrage collaboratif
Cette stratégie de filtrage est basée sur la combinaison du comportement de l'utilisateur et sur sa comparaison et son contraste avec Autres utilisateurs comportement dans la base de données. L'histoire de tous les utilisateurs joue un rôle important dans cet algorithme. La principale différence entre le filtrage basé sur le contenu et le filtrage collaboratif est que dans ce dernier, les interaction de tous les utilisateurs avec les articles influence l'algorithme de recommandation, tandis que pour le filtrage basé sur le contenu uniquement données de l'utilisateur intéressé est pris en compte.
Il existe plusieurs façons de mettre en œuvre le filtrage collaboratif, mais le concept principal à comprendre est que dans le filtrage collaboratif plusieurs Les données utilisateur influencent le résultat de la recommandation. et cela ne dépend pas de une seule donnée utilisateur modeler.
Il y a 2 types d'algorithmes de filtrage collaboratif:
-
Filtrage collaboratif basé sur les utilisateurs
L'idée de base ici est de trouver des utilisateurs qui ont modèles de préférence précédents similaires como ha tenido el usuario ‘UNE’ y luego recomendarle elementos que le gusten a aquellos usuarios similares que ‘UNE’ pas encore trouvé. Ceci est accompli en faisant un tableau d'articles que chaque utilisateur a évalué, vu, J'aime ou cliqué selon la tâche à accomplir, puis calculer le score de similarité entre les utilisateurs et enfin recommander des éléments que l'utilisateur en question ne connaît pas, mais cela aux utilisateurs similaires à lui / ils l'aiment bien.
Par exemple, si al usuario ‘UNE’ le gustan ‘Batman Begins’, ‘Justice League’ Oui ‘The Avengers’ mientras que al usuario ‘B’ le gustan ‘Batman Begins’, ‘Justice League’ Oui ‘Thor’, donc ils ont des intérêts similaires car on sait que ces films appartiennent au genre super-héros. Donc, existe una alta probabilidad de que al usuario ‘UNE’ le guste ‘Thor’ y al usuario ‘B’ le gusten Los Vengadores ‘.
Désavantages
- Les gens sont volubile c'est-à-dire, votre goût change de temps en temps et comme cet algorithme est basé sur la similitude de l'utilisateur, peut détecter des modèles de similitude initiaux entre 2 les utilisateurs qui, après un certain temps, peuvent avoir des préférences complètement différentes.
- Il y a beaucoup de plus d'utilisateurs que d'éléments donc, il est très difficile de maintenir des matrices aussi grandes et, donc, ils doivent être recalculés très régulièrement.
- Cet algorithme est très sensible à attaques de shillings où de faux profils d'utilisateurs constitués de modèles de préférences faussés sont utilisés pour manipuler des décisions clés.
-
Filtrage collaboratif basé sur des éléments
Le concept dans ce cas est rechercher des films similaires au lieu d'utilisateurs similaires y luego recomendar películas similares a las que ‘UNE’ a eu dans vos préférences passées. Ceci est fait en trouvant chaque paire d'éléments qui ont été évalués / visa / ils m'aiment / cliqué par le même utilisateur, puis mesurer la similitude de ceux évalués / visa / aimé / cliqué sur tous les utilisateurs qui ont évalué / ils ont vu / je les aimais / ils ont cliqué sur les deux, et enfin les recommander sur la base des scores de similarité.
Ici, par exemple, Nous prenons 2 films ‘UNE’ Oui ‘B’ et nous vérifions vos notes de tous les utilisateurs qui ont noté les deux films et en fonction de la similitude de ces notes, et sur la base de cette similitude de notation par les utilisateurs qui ont noté les deux, nous trouvons des films similaires. Ensuite, si los usuarios más comunes han calificado ‘UNE’ Oui ‘B’ de manera similar y es muy probable que ‘UNE’ Oui ‘B’ sont similaires, donc, si a alguien ha visto y le ha gustado ‘UNE’, se le debería recomendar ‘B’ et vice versa.
Avantages par rapport au filtrage collaboratif basé sur les utilisateurs
- Contrairement au goût des gens, les films ne changent pas.
- Il y a généralement beaucoup moins d'articles que de personnes, donc, il est plus facile de maintenir et de calculer les matrices.
- Les attaques en shilling sont beaucoup plus difficiles car les articles ne peuvent pas être contrefaits.
-
Commençons à coder notre propre système de recommandation de films.
Dans cette implémentation, lorsque l'utilisateur recherche un film, nous recommanderons le 10 meilleurs films similaires utilisant notre système de recommandation de films. Nous utiliserons filtrage collaboratif basé sur des éléments algorithme pour notre but. L'ensemble de données utilisé dans cette démonstration est le movielens-petit ensemble de données.
Mettez les données au travail
Premier, nous devons importer des bibliothèques que nous utiliserons dans notre système de recommandation de films. En outre, nous allons importer le jeu de données en ajoutant le chemin du CSV enregistrements.
importer pandas en pd
importer numpy en tant que np
à partir de scipy.sparse importer csr_matrix
de sklearn.neighbors importer NearestNeighbors
importer matplotlib.pyplot en tant que plt
importer seaborn comme sns
films = pd.read_csv("../input/movie-lens-small-latest-dataset/movies.csv")
notes = pd.read_csv("../input/movie-lens-small-latest-dataset/ratings.csv")
Maintenant que nous avons ajouté les données, Regardons les fichiers en utilisant le dataframe.head () commande pour imprimer le premier 5 lignes de jeu de données.
Jetons un coup d'œil à l'ensemble de données du film:
films.head()
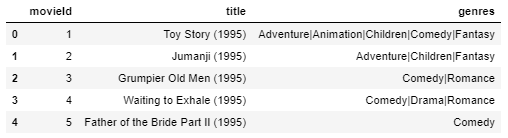
L'ensemble de données de film a
- ID de film: une fois la recommandation faite, nous obtenons une liste de tous les movieIds similaires et obtenons le titre de chaque film à partir de cet ensemble de données.
- genres – Qu'est que c'est non requis pour cette approche de filtrage.
cotes.head()
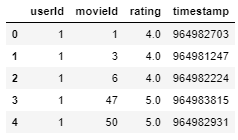
L'ensemble de données d'évaluation a
- identifiant d'utilisateur: unique pour chaque utilisateur.
- ID de film: avec cette fonction, nous prenons le titre du film de l'ensemble de données du film.
- évaluation – Notes attribuées par chaque utilisateur à tous les films utilisant ce, nous allons prédire la 10 meilleurs films similaires.
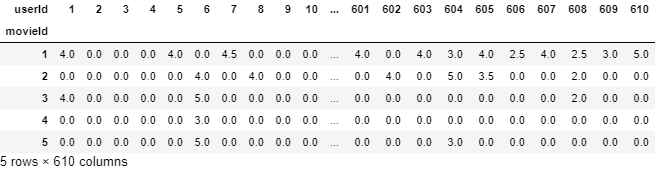
Ici, nous pouvons voir cet userId 1 possède Vu ID de film 1 Oui 3 et les deux ont marqué avec 4.0, mais il a Non classé ID de film 2 Tout à fait. Cette interprétation est plus difficile à extraire de cette trame de données. Donc, pour rendre les choses plus faciles à comprendre et à utiliser, nous allons créer un nouveau bloc de données où chaque colonne représenterait chaque ID utilisateur unique et chaque ligne représenterait chaque ID de film unique.
jeu_de_données final = notes.pivot(index='movieId',colonnes="identifiant d'utilisateur",valeurs="évaluation")
final_dataset.head()
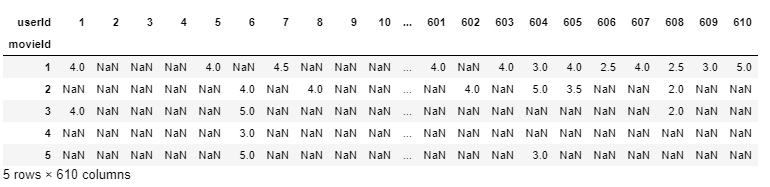
À présent, il est beaucoup plus facile à interpréter que userId 1 Id de film noté 1 & 3 4.0 mais pas noté movieId 3,4,5 Tout à fait (donc, sont représentés par NaN) Oui, donc, vos données d'évaluation sont manquantes.
Réparons cela et imputer NaN con 0 pour rendre les choses compréhensibles pour l'algorithme et aussi rendre les données plus rassurantes pour l'œil.
final_dataset.fillna(0,inplace=Vrai)
final_dataset.head()
Supprimer le bruit des données
Dans le monde réel, les notes sont très rare et les points de données sont collectés principalement à partir de très films populaires et utilisateurs très engagés. Nous ne voulons pas de films qui ont été notés par un petit nombre d'utilisateurs car il est pas crédible suffisant. De la même manière, les utilisateurs qui ont évalué seulement une poignée de films il ne faut pas non plus en tenir compte.
Ensuite, avec tout cela pris en compte et quelques expériences d'essais et d'erreurs, nous allons réduire le bruit en ajoutant des filtres pour le jeu de données final.
- Pour noter un film, un minimum de 10 les utilisateurs auraient dû voter pour un film.
- Pour évaluer un utilisateur, un minimum de 50 les films auraient dû voter pour l'utilisateur.
Visualisons à quoi ressemblent ces filtres
Ajout du nombre d'utilisateurs qui ont voté et du nombre de films qui ont été votés.
no_user_voted = notes.groupby('movieId')['rating'].agglutiné('count')
no_movies_voted = notes.groupby('userId')['rating'].agglutiné('count')
Visualisons le nombre d'utilisateurs qui ont voté avec notre seuil de 10.
F,ax = plt.subplots(1,1,taille de la figue=(16,4))
# notes['rating'].terrain(kind='hist')
plt.scatter(no_user_voted.index,no_user_voted,couleur="vert de mer moyen")
plt.axhline(y = 10, couleur ="r")
plt.xlabel('MovieId')
plt.ylabel('Non. of users voted')
plt.show()
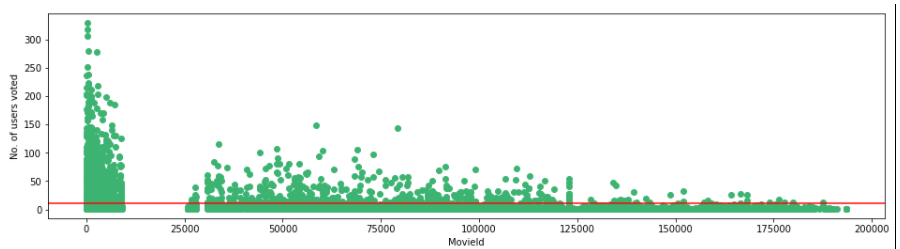
Apporter les modifications nécessaires selon le seuil établi.
final_dataset = final_dataset.loc[no_user_voted[no_user_voted > 10].indice,:]
Visualisons le nombre de votes de chaque utilisateur avec notre seuil de 50.
F,ax = plt.subplots(1,1,taille de la figue=(16,4))
plt.scatter(no_movies_voted.index,no_movies_voted,couleur="vert de mer moyen")
plt.axhline(y = 50, couleur ="r")
plt.xlabel('UserId')
plt.ylabel('Non. of votes by user')
plt.show()
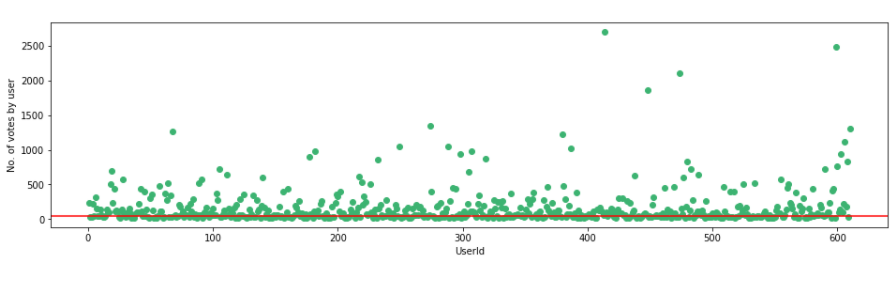
Réaliser les modifications nécessaires selon le seuil établi.
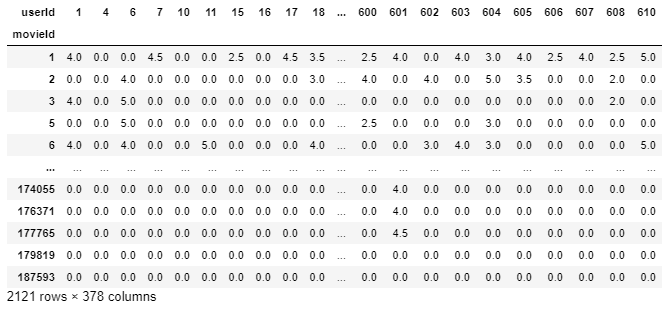
final_dataset=final_dataset.loc[:,no_movies_voted[no_movies_voted > 50].indice]
ensemble_de_données_final
Éliminer la pénurie
Notre final_dataset a des dimensions de 2121 * 378 où la plupart des valeurs sont rares. Nous n'utilisons qu'un petit ensemble de données, mais pour l'ensemble de données d'objectif de grand film d'origine qui a plus de 100000 fonctionnalités, notre système peut manquer de ressources de calcul lorsqu'il est alimenté au modèle. Pour réduire la dispersion, nous utilisons la fonction csr_matrix de la bibliothèque scipy.
Je vais donner un exemple de comment ça marche:
échantillon = np.tableau([[0,0,3,0,0],[4,0,0,0,2],[0,0,0,0,1]])
parcimonie = 1.0 - ( np.count_nonzero(échantillon) / flotter(taille de l'échantillon) )
imprimer(parcimonie)
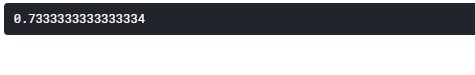
csr_sample = csr_matrix(échantillon)
imprimer(csr_sample)
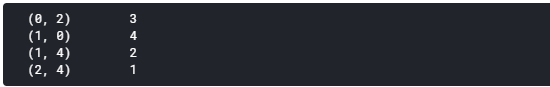
Comme tu peux le voir, no hay un valor escaso en csr_sample y los valores se asignan como indiceLe "Indice" C’est un outil fondamental dans les livres et les documents, qui vous permet de localiser rapidement les informations souhaitées. Généralement, Il est présenté au début d’une œuvre et organise les contenus de manière hiérarchique, y compris les chapitres et les sections. Sa préparation correcte facilite la navigation et améliore la compréhension du matériau, ce qui en fait une ressource incontournable tant pour les étudiants que pour les professionnels dans divers domaines.... de filas y columnas. pour la rangée 0 et la deuxième colonne, la valeur est 3.
Application de la méthode csr_matrix à l'ensemble de données:
csr_data = csr_matrice(final_dataset.values)
final_dataset.reset_index(inplace=Vrai)
Modéliser le système de recommandation de films
Nous utiliserons l'algorithme KNN pour calculer la similarité avec distance en cosinus métrique qui est très rapide et plus préférable que coefficient de Pearson.
knn = Voisins les plus proches(métrique="cosinus", algorithm='brute', n_voisins=20, n_emplois=-1)
knn.fit(csr_data)
Faire la fonction de recommandation
Le principe de fonctionnement est très simple. On vérifie d'abord si l'entrée du nom du film est dans la base de données et si c'est le cas, nous utilisons notre système de recommandation pour trouver des films similaires et les trier en fonction de leur distance de similarité et générer uniquement le Haut 10 films avec leurs distances par rapport au film d'entrée.
def get_movie_recommendation(nom_film):
    n_movies_to_recomend = 10
    movie_list = films[films['title'].str.contient(nom_film)]
    si len(liste_films):
        movie_idx= movie_list.iloc[0]['movieId']
        movie_idx = final_dataset[ensemble_de_données_final['movieId'] == movie_idx].indice[0]
        distances , indices = knn.kneighbors(csr_data[movie_idx],n_neighbours=n_movies_to_recomend+1)
        rec_movie_indices = trié(liste(Zip *: français(indices.squeeze().lister(),distances.serrer().lister())),clé=lambda x: X[1])[:0:-1]
        recommander_cadre = []
        pour val dans rec_movie_indices:
            movie_idx = final_dataset.iloc[val[0]]['movieId']
            idx = films[films['movieId'] == movie_idx].indice
            recommander_cadre.append({'Title':films.iloc[idx]['title'].valeurs[0],'Distance':val[1]})
        df = pd.DataFrame(recommander_cadre,index=plage(1,n_movies_to_recomend+1))
        retour df
    autre:
        revenir "Aucun film trouvé. Veuillez vérifier votre saisie"
Finalement, nous recommanderons quelques films!
get_movie_recommendation('Iron Man')
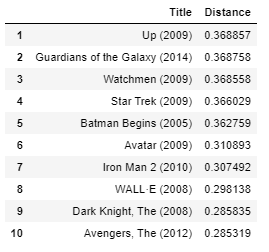
Personnellement, Je pense que les résultats sont plutôt bons. Tous les films en haut sont super-héros ou animation des films idéaux pour les enfants comme le film d'entrée « Homme de fer ».
Essayons un autre:
get_movie_recommendation('Memento')
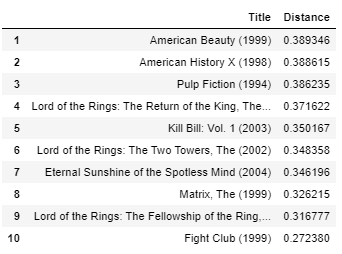
Tous les meilleurs films 10 fils sérieux et consciencieux des films comme "Memento" lui-même, donc je pense que le résultat, dans ce cas, c'est bien aussi.
Notre modèle fonctionne très bien: un système de recommandation de films basé sur le comportement de l'utilisateur. Donc, nous concluons ici notre filtrage collaboratif. Vous pouvez obtenir le bloc-notes de déploiement complet ici.





