
Cet article a été publié dans le cadre du Blogathon sur la science des données.
Vue d'ensemble
- Chaque composant de base et fondamental requis pour l'analyse des sentiments.
- J'ai utilisé une approche simple pour expliquer toutes les bases, afin que même un lecteur débutant puisse acquérir une compréhension complète de tous les concepts.
- Les sujets: Prétraitement de texte, Corpus de vocabulaire, Extraction de caractéristiques (Représentation creuse et dictionnaire des fréquences), Modèle de régression logistique pour l'analyse des sentiments.
L'analyse des sentiments est une technique d'apprentissage automatique supervisée utilisée pour analyser et prédire la polarité des sentiments dans un texte (soit positif soit négatif).
Il est souvent utilisé par les entreprises et les entreprises pour comprendre l'expérience de leurs utilisateurs, émotions, réponses, etc. afin qu'ils puissent améliorer la qualité et la flexibilité de leurs produits et services.
À présent, approfondissons la compréhension de la façon dont les ingénieurs en apprentissage automatique utilisent cette technique d'analyse des sentiments pour examiner les sentiments de divers textes.
Rassembler des données
" PLUS DE DONNÉES, MIEUX! «
Il y a tellement de sources de données ouvertes qui peuvent être utilisées pour former des modèles de ML, c'est donc un choix personnel de collecter des données vous-même ou d'utiliser des ensembles de données ouvertes pour entraîner notre algorithme.
Les ensembles de données textuels sont généralement distribués comme JSONJSON, o Notation d’objet JavaScript, Il s’agit d’un format d’échange de données léger, facile à lire et à écrire pour les humains, et facile à analyser et à générer pour les machines. Il est couramment utilisé dans les applications Web pour envoyer et recevoir des informations entre un serveur et un client. Sa structure est basée sur des paires clé-valeur, ce qui le rend polyvalent et largement adopté dans le développement de logiciels.. o CSV formats, donc pour les utiliser, on peut récupérer les données dans une liste python ou dans un dictionnaire / objet de bloc de données.
Les données doivent être divisées dans le train, ensembles de validation et de test d'une manière commune de 60% 20% 20% O 70% 15% 15%.
L'ensemble de données Twitter populaire peut être téléchargé à partir de ici.
Pipeline
Chaque tâche d'apprentissage automatique doit avoir un PipelinePipeline est un terme utilisé dans divers contextes, principalement dans la technologie et la gestion de projets. Il fait référence à un ensemble de processus ou d'étapes permettant un flux de travail continu depuis la conception d'une idée jusqu'à sa mise en œuvre finale. Dans le domaine du développement de logiciels, par exemple, un pipeline peut inclure la programmation, les tests et le déploiement, garantissant ainsi une plus grande efficacité et qualité dans les..... Les pipelines sont utilisés pour diviser vos workflows d'apprentissage automatique en parties modulaires indépendantes, réutilisables qui peuvent ensuite être regroupés pour améliorer continuellement la précision du modèle et obtenir un algorithme efficace.
Nous suivrons une structure de pipeline de base pour notre problème, afin qu'un lecteur puisse facilement comprendre chaque partie du pipeline utilisé dans notre flux de travail. Notre pipeline comprendra les étapes suivantes:
- Pré-traitement du texte et construction du vocabulaire: Élimination des textes indésirables (mots vides), ponctuation, URL, identifiants, etc. qui n'ont aucune valeur sentimentale. Et puis ajouter des mots uniques prétraités à un vocabulaire.
- Extraction de caractéristiques: Itérer à travers chaque exemple de données pour extraire des caractéristiques à l'aide d'un dictionnaire de fréquences et enfin créer un tableau de caractéristiques.
- Modèle de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines....: Nous utiliserons ensuite notre matrice de caractéristiques pour entraîner un modèle de régression logistique à utiliser ce modèle pour prédire les sentiments..
- Modèle de test: Utilisation de notre modèle entraîné pour obtenir les prédictions à partir de données que vous n'avez jamais vues.
Pré-traitement des données
C'est une étape importante dans notre portefeuille de projets. Le prétraitement de texte peut être utilisé pour supprimer des mots et des scores des données textuelles qui n'ont aucune valeur sentimentale, car le prétraitement de texte peut considérablement améliorer notre temps de formation, puisque la taille de nos données sera réduite et se limitera à des mots ayant une certaine valeur sentimentale. Le prétraitement comprend la manipulation de
-
Pour les mots
Des mots qui n'ont aucune valeur / poids sémantique ou sentimental dans une phrase. par exemple: Oui, il est, les, toi, etc.
Comment les traiter? Nous allons créer une liste qui inclut tous les mots vides possibles comme
['nous-mêmes', 'la sienne', 'entre', 'toi-même', 'mais', 'de nouveau', 'là', 'À propos', 'une fois que', 'pendant', 'dehors', 'très', 'ayant', 'avec', 'elles ou ils', 'posséder', 'un', 'être', 'certains', 'pour', 'faire', 'son', 'les vôtres', 'tel', 'dans', 'de', 'plus', 'lui-même', 'autre', 'désactivé', 'est', 's', 'un m', 'ou', 'qui', 'comme', 'de', 'lui', 'chaque', 'les', 'eux-mêmes', 'jusqu'à', 'au dessous de', 'sommes', 'nous', 'ces', 'ton', 'le sien', 'par', 'enfiler', 'ni', 'moi', 'étaient', 'sa', 'Suite', 'lui-même', 'cette', 'vers le bas', 'devrait', 'notre', 'leur', 'tandis que', 'dessus', 'les deux', 'en haut', 'à', 'les notres', 'avais', 'elle', 'tous', 'non', 'lorsque', 'à', 'tout', 'avant', 'eux', 'même', 'et', 'été', 'ont', 'dans', 'volonté', 'au', 'Est-ce que', 'vous-mêmes', 'alors', 'cette', 'car', 'Quel', 'plus de', 'Pourquoi', 'donc', 'pouvez', 'fait', 'ne pas', 'maintenant', 'sous', 'il', 'tu', 'se', 'a', 'seulement', 'où', 'trop', 'seul', 'moi même', 'lequel', 'celles', 'je', 'après', 'quelque', 'qui', 't', 'étant', 'si', 'les leurs', 'ma', 'contre', 'une', 'par', 'Faire', 'ce', 'comment', 'plus loin', 'était', 'ici', 'que']
Nous allons maintenant parcourir chaque exemple de nos données et supprimer chaque mot de nos données présent dans la liste des mots vides..
-
Notes
Les signes de ponctuation sont des symboles que nous utilisons pour souligner notre texte. par exemple:! , @, #, $, etc.
Comment les traiter? Nous les traiterons de la même manière que nous avons traité les mots vides, nous en créerons une liste et traiterons chaque exemple avec cette liste.
-
URL et identifiants
Les URL sont les liens qui commencent par la déclaration du protocole Http, par exemple. ‘https: //….’ et les identifiants sont utilisés pour mentionner des personnes sur les réseaux sociaux, par exemple. ‘@Nom d'utilisateur’ les deux partagent une signification sentimentale nulle.
Comment les traiter? Traitez-les en créant une fonction ‘process_handles_urls ()’ qui prendra les données de notre ensemble d'entraînement et supprimera les mots qui commencent par ‘https: //’ O ‘@’ de chaque exemple.
-
Dérivé
La dérivation est un processus de réduction d'un mot à sa racine de base. Par exemple, ‘tourner’ est un mot racine de tour, tourner, tourner, etc. Puisque le mot racine offre la même valeur sentimentale pour tous ses mots suffixés, nous pouvons réduire chaque mot à sa racine de base, ce qui peut réduire la taille de notre vocabulaire et le temps de formation. aussi bien que.
Comment les traiter? Traitez-les en créant une fonction ‘do_stemming ()’ qui prendra les données et dérivera les mots de chaque exemple.
-
Boîtier inférieur
Nous devons utiliser des majuscules et des minuscules similaires pour chaque mot dans les données afin de représenter ‘Mot’, ‘WORD’, ‘mot’ il ne devrait y avoir qu'un seul cas à suivre, c'est-à-dire, minuscule, cela peut également aider à réduire la taille du vocabulaire et à éliminer la répétition de mots.
Comment les traiter? itérer à travers chaque exemple, utiliser la méthode .lower () pour convertir chaque morceau de texte en minuscules.
Corpus de vocabulaire
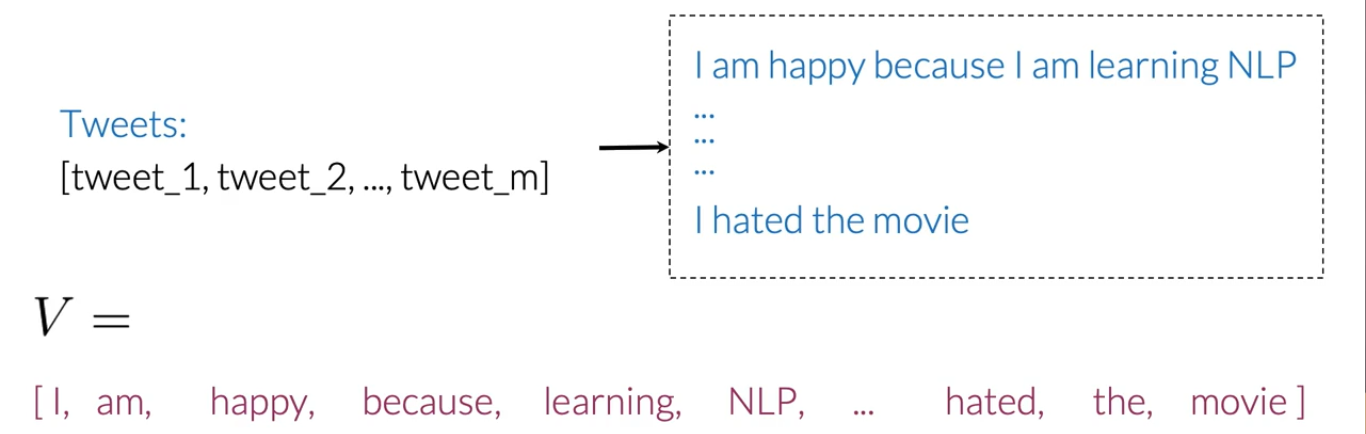
Après prétraitement des données, il est temps de créer un vocabulaire qui stocke chaque mot unique et attribue une valeur numérique à chaque mot différent (cela s'appelle aussi la tokenisation).
Nous utiliserons ce dictionnaire de vocabulaire pour l'extraction de caractéristiques.
Extraction de caractéristiques
L'un des problèmes, lorsque vous travaillez avec le traitement du langage, est que les algorithmes d'apprentissage automatique ne peuvent pas fonctionner directement sur du texte brut. Ensuite, nous avons besoin de techniques d'extraction de caractéristiques pour convertir le texte en un tableau (vecteur) caractéristiques numériques.
Prenons quelques exemples de tweets positifs et négatifs:
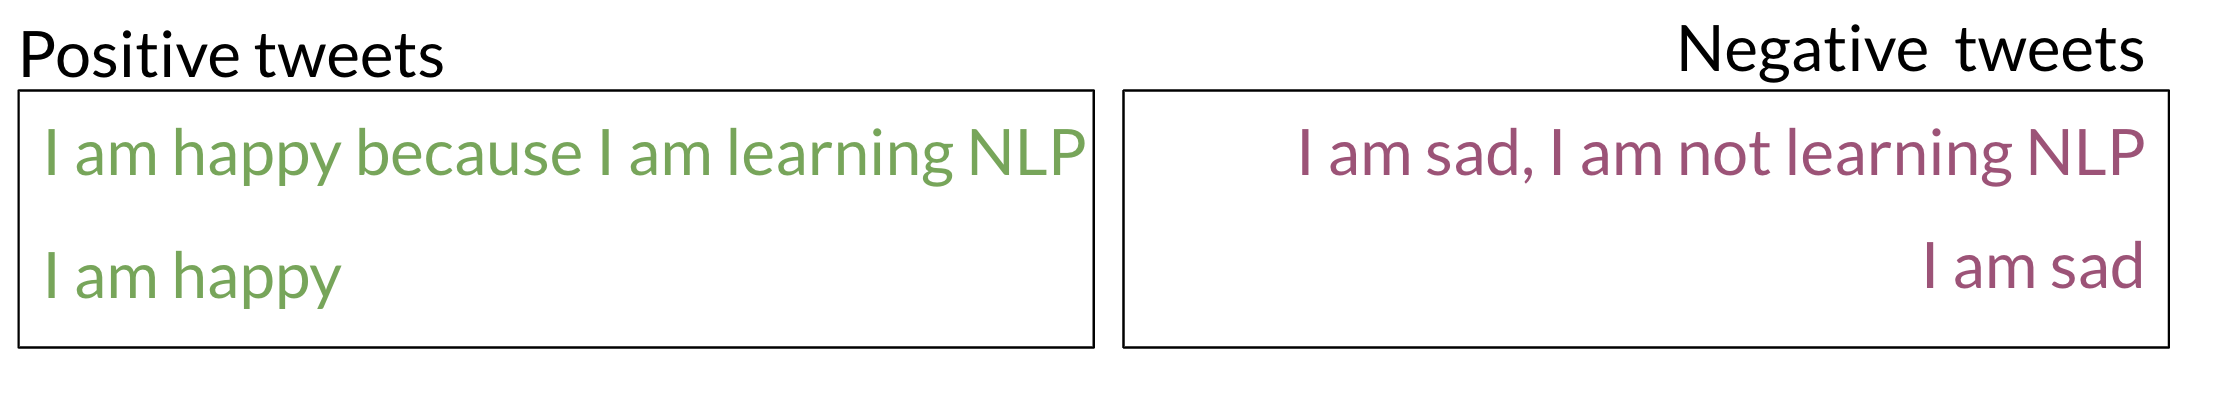
REMARQUE: L'exemple ci-dessus n'est pas traité, donc nous allons le traiter d'abord avant de passer aux étapes suivantes.
Mauvaise représentation
C'est une approche naïve d'extraire des caractéristiques d'un texte. Selon la représentation clairsemée, nous pouvons créer un éventail de fonctionnalités en itérant à travers des données complètes, et pour chaque mot, dans l'exemple de texte, nous attribuerons 1 à la position de ce mot dans la liste de vocabulaire et pour les mots qui n'apparaissent pas, NOUS ‘ je vais attribuer 0. Ensuite, notre matrice de caractéristiques aura des lignes = nombre total de phrases dans nos données et colonnes = nombre total de mots dans le vocabulaire.

Désavantages:
- Super moment de formation
- Grand temps de prédiction
Dictionnaire des fréquences
Un dictionnaire de fréquences garde une trace des fréquences positives et négatives de chaque mot dans nos données.

Fréquence positive: Les Nombre de fois qu'un mot apparaît dans les phrases avec un sentiment positif.
Fréquence négative: Les Nombre de fois qu'un mot apparaît dans les phrases avec un sentiment négatif.
Extraction de caractéristiques avec dictionnaire de fréquences:
Utilisation du dictionnaire de fréquences pour l'extraction de caractéristiques, on peut réduire les dimensions de chaque ligne qui représente chaque phrase d'une matrice de caractéristiques (c'est-à-dire, égal au nombre de mots du vocabulaire en cas de sous-représentation) en trois dimensions.
Les caractéristiques des données d'un texte sont extraites avec le dictionnaire de caractéristiques à l'aide des formules suivantes:

Le processus ressemble presque à:
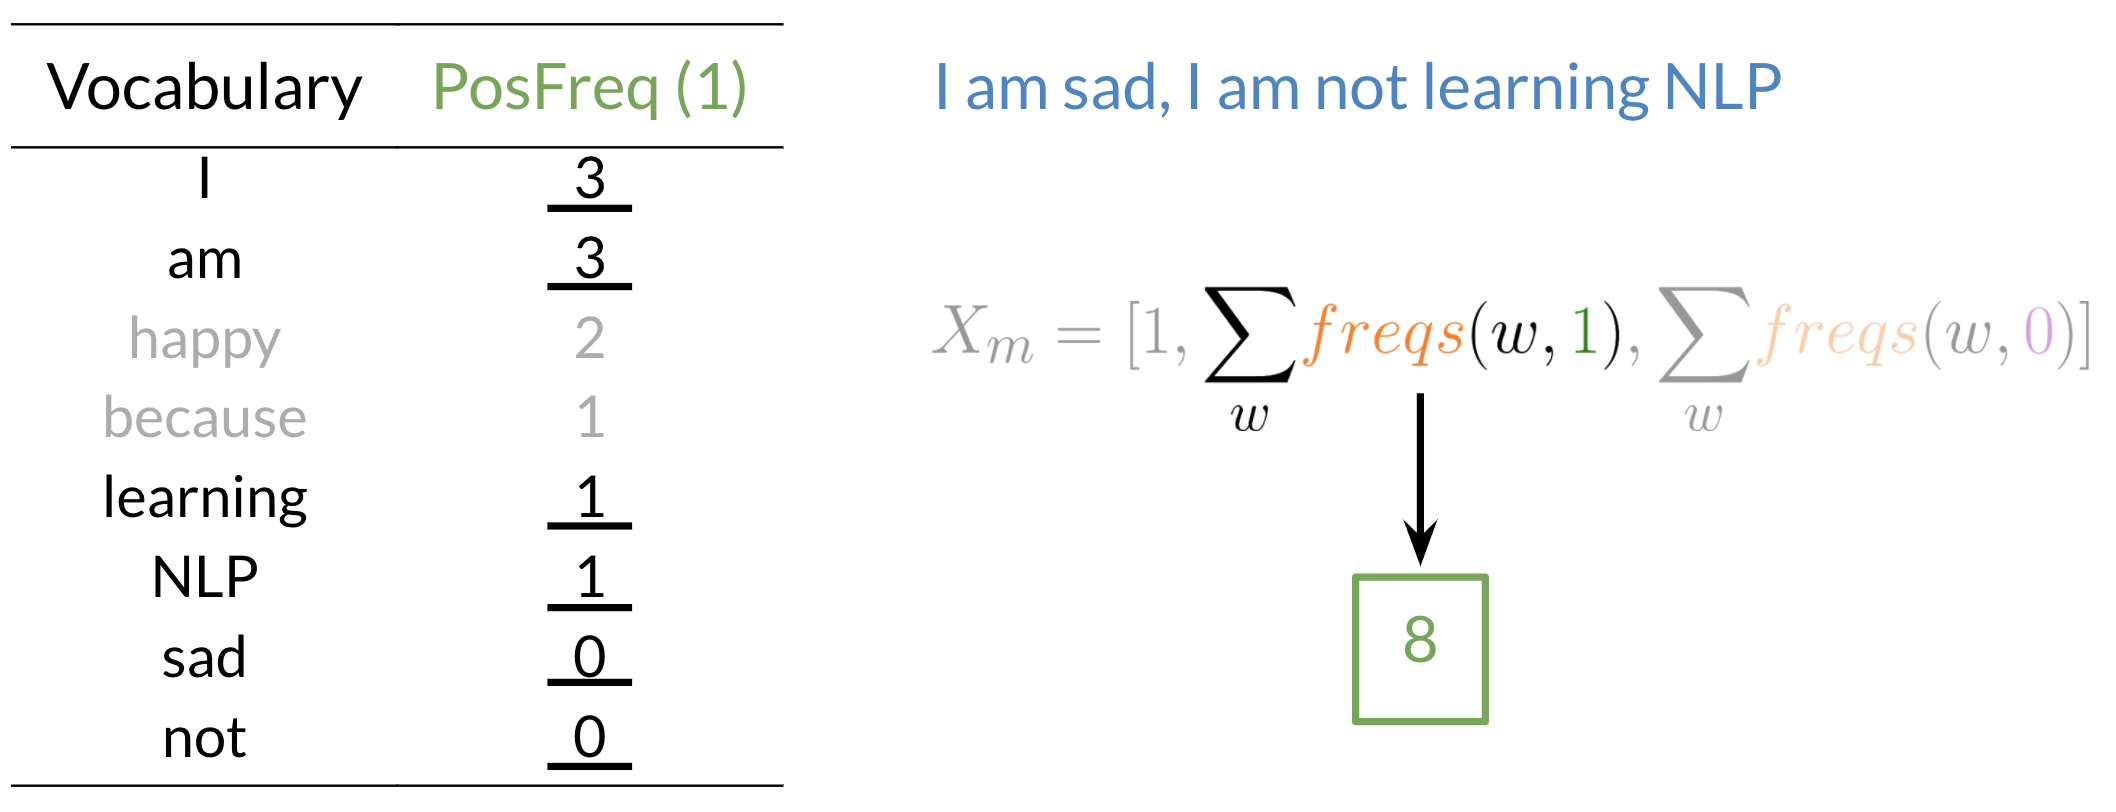
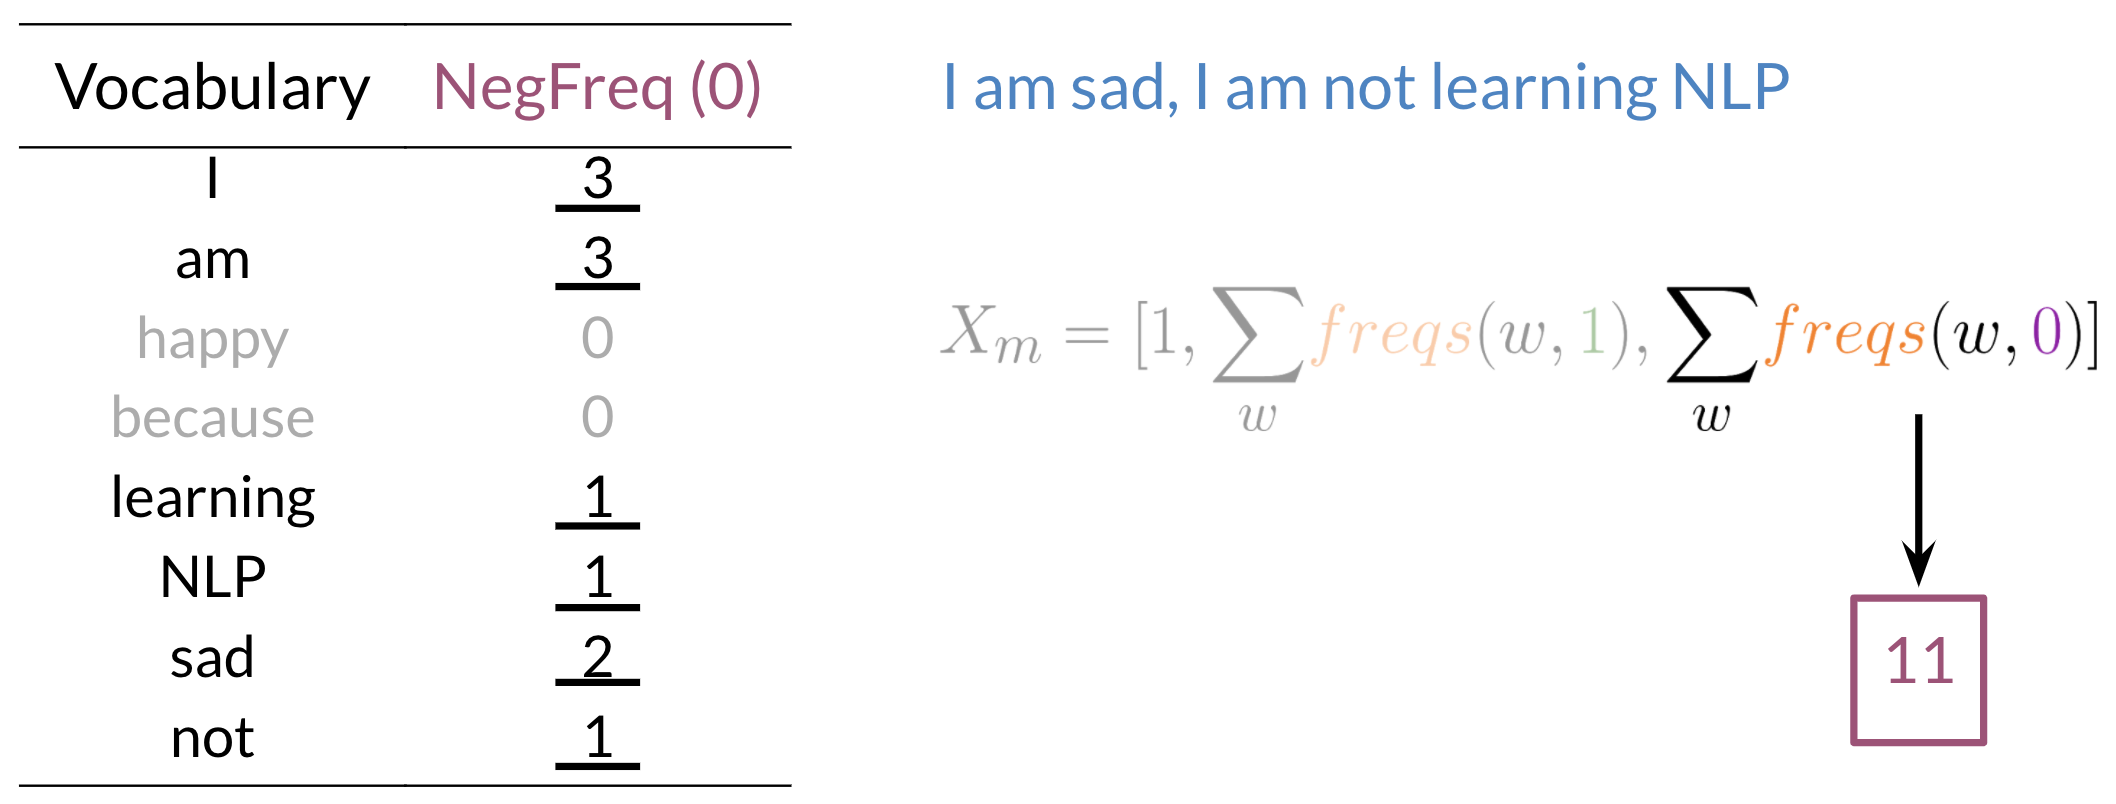
Nous avons maintenant un vecteur de caractéristiques en trois dimensions pour notre tweet qui ressemble à ceci:
Xm = [1,8,11]
Maintenant, nous allons parcourir chaque exemple pour extraire les caractéristiques de chaque exemple, puis nous utiliserons ces caractéristiques pour créer la matrice de caractéristiques que nous pouvons utiliser pour la formation.. À la fin, nous avons un éventail de caractéristiques comme:

Régression logistique pour l'analyse des sentiments
La régression logistique modélise les probabilités de problèmes de classification avec deux résultats possibles. C'est une extension du modèle de régression linéaire pour les problèmes de classification.
Utilisations de la régression logistique une fonction sigmoïde pour mapper la sortie de notre fonction linéaire (??TX) Entrez 0 Oui 1 avec un certain seuil (généralement 0.5) faire la différence entre deux classes, donc si h> 0.5 c'est une classe positive, et si h <0.5 c'est une classe négative. (Expliquer la régression logistique complète dépasse le cadre de cet article.)

Modèle d'analyse des sentiments d'entraînement
La formation de notre modèle suivra les étapes suivantes:
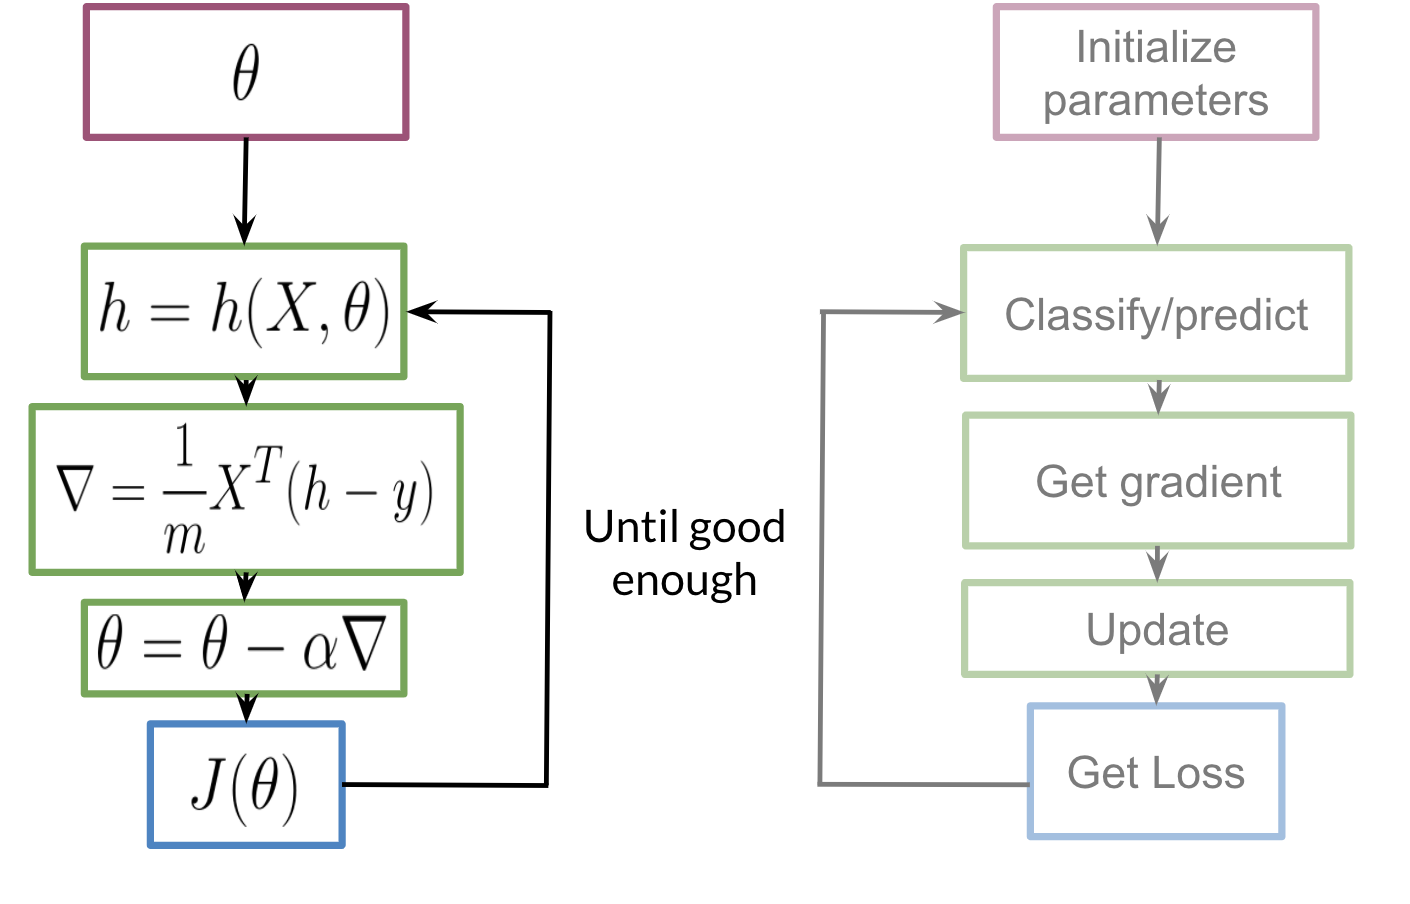
Nous initialisons notre paramètre θ, que nous pouvons utiliser dans notre sigmoïde, puis nous calculons le penteLe gradient est un terme utilisé dans divers domaines, comme les mathématiques et l’informatique, pour décrire une variation continue de valeurs. En mathématiques, fait référence au taux de variation d’une fonction, pendant la conception graphique, S’applique à la transition de couleur. Ce concept est essentiel pour comprendre des phénomènes tels que l’optimisation dans les algorithmes et la représentation visuelle des données, permettant une meilleure interprétation et analyse dans... que nous utiliserons pour mettre à jour θ et ensuite calculons le coût. Nous continuerons à répéter les étapes jusqu'à ce que le coût soit minimisé / converger.
Tester notre modèle
Pour tester notre modèle, nous utiliserons notre ensemble de validation et suivrons les étapes suivantes:
- Diviser les données dans X_validation (texte) et Y_validation (sentiment).
- Utiliser l'extraction de caractéristiques pour X_validation pour transformer des textes en caractéristiques numériques.
- Trouver le vecteur h (= sigmoïde (??TX)) pour chaque texte du jeu de validation.
- Attribuez une fonction pour obtenir les classes réelles tout en comparant à un seuil.
- Trouvez la précision de nos prédictions.

résumé
Je suis content que tu sois arrivé jusqu'ici! Si vous êtes débutant en traitement automatique du langage naturel, J'espère pouvoir vous donner une idée de la façon dont les choses fonctionnent sous le capot et vous permettre de couvrir des sujets plus complexes et avancés et, si vous êtes un professionnel, J'espère que j'ai pu rafraîchir vos bases.
Le traitement du langage naturel est un vaste domaine de l'intelligence artificielle, ses applications sont utilisées dans divers paradigmes, comme les chatbots, analyse des sentiments, traduction automatique, correction automatique, etc. Il existe plusieurs plateformes et articles e-learning, travaux, etc. distribution gratuite qui peut être utile pour faire avancer le voyage.
Les références: Spécialisation Traitement automatique du langage naturel





