
introduction:
L'une des étapes les plus importantes dans le cadre du prétraitement des données est la détection et le traitement des valeurs aberrantes, car ils peuvent affecter négativement l’analyse statistique et le processus de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... d’un algorithme d’apprentissage automatique, résultant en une précision moindre.
1. Que sont les valeurs aberrantes? ??
Nous avons tous entendu parler de l’idiome ‘étrange, ce qui signifie quelque chose d'inhabituel par rapport aux autres dans un groupe.
de la même manière, une valeur aberrante est une observation dans un ensemble de données donné qui est loin du reste des observations. Cela signifie qu'une valeur aberrante est beaucoup plus grande ou plus petite que les valeurs restantes de l'ensemble..
2. Pourquoi se produisent-ils?
Une valeur aberrante peut survenir en raison de la variabilité des données, ou en raison d'une erreur expérimentale / erreur humaine.
Peut indiquer une erreur expérimentale ou une grande asymétrie dans les données (forte distribution de colle).
3. Qui affectent?
Dans les statistiques, nous avons trois mesures de tendance centrale: Médias, MédianLa médiane est une mesure statistique qui représente la valeur centrale d’un ensemble de données ordonnées. Pour le calculer, Les données sont organisées de la plus basse à la plus élevée et le numéro au milieu est identifié. S’il y a un nombre pair d’observations, La moyenne des deux valeurs fondamentales est calculée. Cet indicateur est particulièrement utile dans les distributions asymétriques, puisqu’il n’est pas affecté par les valeurs extrêmes.... & Mode. Aidez-nous à décrire les données.
La moyenne est la mesure précise pour décrire les données lorsque nous n'avons pas de valeurs aberrantes présentes..
La médiane est utilisée s'il y a une valeur aberrante dans l'ensemble de données.
Le mode est utilisé s'il y a une valeur aberrante ET qu'environ la moitié ou plus des données sont égales.
La « médias » est la seule mesure de la tendance centrale qui est affectée par les valeurs aberrantes, qui à son tour affecte l'écart type.
Exemple:
Considérons un petit ensemble de données, échantillon = [15, 101, 18, 7, 13, 16, 11, 21, 5, 15, 10, 9]. En le regardant, On peut rapidement dire que ‘101’ est une valeur aberrante qui est beaucoup plus grande que les autres valeurs.
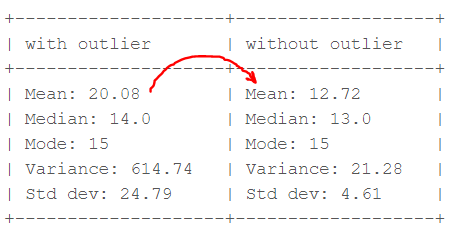
A partir des calculs ci-dessus, on peut clairement dire que la Moyenne est plus affectée que la Médiane.
4. Détection de valeurs atypiques
Si notre ensemble de données est petit, nous pouvons détecter la valeur aberrante simplement en regardant l'ensemble de données. Mais, Et si nous avons un grand ensemble de données, comment nous identifions les valeurs aberrantes? Nous devons utiliser des techniques de visualisation et des mathématiques.
Voici quelques-unes des techniques pour détecter les valeurs aberrantes.
- Boîtes à moustachesDiagrammes encadrés, Aussi connu sous le nom de diagrammes en boîte et à moustaches, sont des outils statistiques qui représentent la distribution d’un ensemble de données. Ces diagrammes montrent la médiane, quartiles et valeurs aberrantes, Permettre de visualiser la variabilité et la symétrie des données. Ils sont utiles pour la comparaison entre différents groupes et pour l’analyse exploratoire, faciliter l’identification des tendances et des modèles dans les données....
- Score Z
- Intervalle entre les quantiles (IQR)
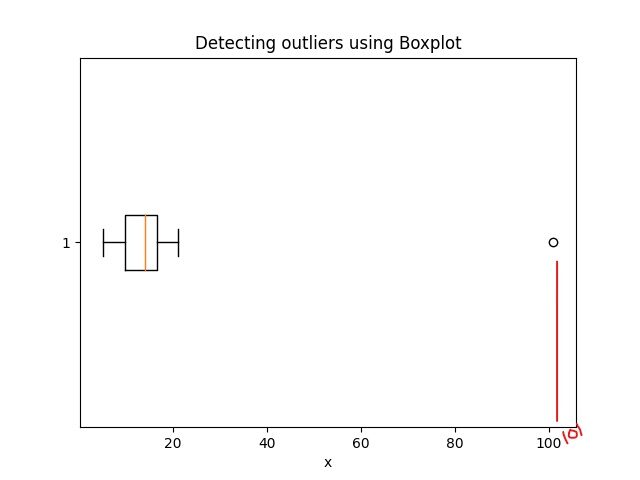
4.1 Détection de valeurs atypiques à l'aide de Boxplot:
Le code Python pour la boîte à moustaches est:
importer matplotlib.pyplot en tant que plt
plt.boxplot(échantillon, vert=Faux)
plt.titre("Détecter les valeurs aberrantes à l'aide de Boxplot")
plt.xlabel(Échantillon)
4.2 Détection des valeurs aberrantes à l'aide des scores Z
Critères: tout point de données dont le score Z se situe en dehors du 3e écart type est une valeur aberrante.
Pas:
- parcourir tous les points de données et calculer le score Z à l'aide de la formule (Xi-moyen) / std.
- définir une valeur seuil de 3 et marquer les points de données dont la valeur absolue du score Z est supérieure au seuil comme valeurs aberrantes.
importer numpy en tant que np
valeurs aberrantes = []
def detect_outliers_zscore(Les données):
    trois = 3
    moyenne = np.moyenne(Les données)
    std = par exemple std(Les données)
    # imprimer(moyenne, std)
    pour i dans les données:
        z_score = (je veux dire)/std
        si (np.abs(z_score) > trois):
            valeurs aberrantes.append(je)
    renvoyer les valeurs aberrantes# Code du pilote
sample_outliers = detect_outliers_zscore(échantillon)
imprimer("Valeurs aberrantes de la méthode des scores Z: ", sample_outliers)
Les résultats du code ci-dessus: Valeurs aberrantes de la méthode du Z-score: [101]
4.3 Détection des valeurs aberrantes à l'aide de la plage entre les quantiles (IQR)
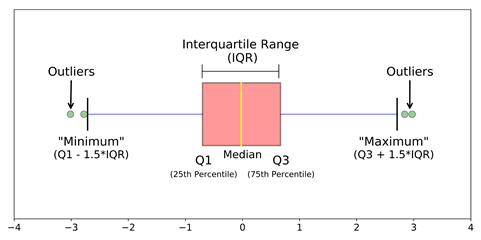
Critères: les points de données trouvés 1,5 fois l'IQR au-dessus de Q3 et en dessous de Q1 sont des valeurs aberrantes.
Pas:
- Trier l'ensemble de données par ordre croissant
- calculer les premier et troisième quartiles (T1, T3)
- calculer IQR = Q3-Q1
- calculer la limite inférieure = (Q1–1.5 * IQR), limite supérieure = (T3 + 1.5 * IQR)
- parcourir les valeurs de l'ensemble de données et vérifier celles qui tombent en dessous de la limite inférieure et au-dessus de la limite supérieure et les marquer comme valeurs aberrantes
Code Python:
valeurs aberrantes = []
def detect_outliers_iqr(Les données):
    données = triées(Les données)
    q1 = np.centile(Les données, 25)
    q3 = np.centile(Les données, 75)
    # imprimer(q1, q3)
    IQR = q3-q1
    lwr_bound = q1-(1.5*IQR)
    upr_bound = q3+(1.5*IQR)
    # imprimer(lwr_bound, upr_bound)
    pour i dans les données:
        si (je<lwr_bound ou je>upr_bound):
            valeurs aberrantes.append(je)
    renvoyer les valeurs aberrantes# Code du pilote
sample_outliers = detect_outliers_iqr(échantillon)
imprimer("Valeurs aberrantes de la méthode IQR: ", sample_outliers)
Les résultats du code ci-dessus: Valeurs aberrantes de la méthode IQR: [101]
5. Traitement des valeurs aberrantes
Jusqu'à présent, nous avons appris la détection des valeurs aberrantes. La question principale est que faisons-nous avec les valeurs aberrantes?
Voici quelques méthodes pour gérer les valeurs aberrantes.
- Garniture / supprimer les valeurs aberrantes
- Enduits et chaussées à base de quantiles
- Imputation moyenne / médian
5.1 Découper / Suppression des valeurs aberrantes
Dans cette technique, nous supprimons les valeurs aberrantes de l'ensemble de données. Bien que ce ne soit pas une bonne pratique à suivre.
Code Python pour supprimer la valeur aberrante et copier le reste des éléments dans un autre tableau.
# Garniture
pour i dans sample_outliers:
    a = np.supprimer(échantillon, np.où(échantillon==i))
imprimer(une)
# imprimer(longueur(échantillon), longueur(une))
L’aberration ‘101’ est supprimé et le reste des points de données est copié dans un autre tableau ‘une’.
5.2 Revêtements et chaussées à base de quantiles
Dans cette technique, la valeur aberrante est limitée à une certaine valeur au-dessus de la valeur centile 90 ou est réduit d'un facteur inférieur à la valeur centile 10.
Code Python:
# Informatique 10e, 90e centiles et remplacement des valeurs aberrantes
dixième_pourcentile = np.centile(échantillon, 10)
quatre-vingt-dixième_pourcentile = np.pourcentile(échantillon, 90)
# imprimer(dixième_pourcentile, quatre-vingt-dixième_pourcentile)b = np.où(échantillon<dixième_pourcentile, dixième_pourcentile, échantillon)
b = np.où(b>quatre-vingt-dixième_pourcentile, quatre-vingt-dixième_pourcentile, b)
# imprimer("Échantillon:", échantillon)
imprimer("Nouveau tableau:",b)
Les résultats du code ci-dessus: Nouvelle matrice: [15, 20.7, 18, 7.2, 13, 16, 11, 20.7, 7.2, 15, 10, 9]
Points de données inférieurs au centile 10 sont remplacés par la valeur centile 10 et des points de données supérieurs au centile 90 sont remplacés par la valeur centile 90.
5.3 imputation moyenne / médian
Comme la valeur moyenne est fortement influencée par les valeurs aberrantes, il est recommandé de remplacer les valeurs aberrantes par la valeur médiane.
Code Python:
médiane = np.médiane(échantillon)# Remplacer par la médiane
pour i dans sample_outliers:
    c = np.où(échantillon==i, 14, échantillon)
imprimer("Échantillon: ", échantillon)
imprimer("Nouveau tableau: ",c)
# imprimer(x.dtype)
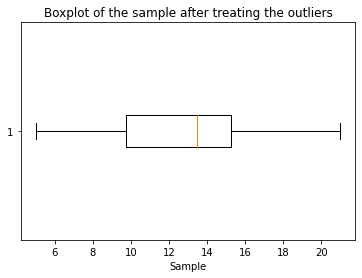
Affichage des données après traitement de la valeur aberrante
plt.boxplot(c, vert=Faux)
plt.titre("Boxplot de l'échantillon après traitement des valeurs aberrantes")
plt.xlabel("Échantillon")
résumé:
Dans ce blog, Nous avons découvert une phase importante du prétraitement des données qui est la gestion des valeurs aberrantes. Nous connaissons maintenant différentes méthodes pour détecter et traiter les valeurs aberrantes.
Les références:
Score Z pour la détection des valeurs aberrantes
IQR pour la détection de valeurs atypiques
Référentiel GitHub pour consulter le notebook Jupyter
J'espère que ce blog vous aidera à comprendre le concept des valeurs aberrantes. S'il vous plait, votez pour si vous l'aimez. Bon apprentissage !! 😊
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





