
Vue d'ensemble
- Guide étape par étape pour développer les compétences indispensables pour devenir un data scientist
- Fonctionnalités telles que MOOC, Chaînes YouTube, pages de blog, sites Web de la communauté de la science des données pour acquérir diverses compétences
- Sites Web de la communauté de la science des données comme Kaggle, Données pilotées, Analytics Vidhya pour une expérience pratique avec des ensembles de données et
d'autres techniques d'apprentissage automatique utiles
Qu'est-ce que la science des données?
La science des données concerne « Utiliser diverses techniques, algorithmes pour analyser de grandes quantités d'ensembles de données (à la fois structuré et non structuré), pour extraire des informations utiles sur les données, les appliquer ainsi dans plusieurs domaines commerciaux ».
Pourquoi y a-t-il une demande de data scientists?
Données est généré jour après jour à un rythme massif et de traiter des ensembles de données aussi volumineux, les grandes entreprises recherchent de bons data scientists pour extraire des informations précieuses de ces ensembles de données et les utiliser pour diverses stratégies, modèles et plans d'affaires.
Table des matières
- Apprendre Python
- Apprendre les statistiques
- Collecte de données
- Nettoyage des données
- Connaissance de l'EDA (l'analyse exploratoire des données)
- Aprendizaje automático y l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé...
- Plus d'informations sur la mise en œuvre du modèle ML
- Tests du monde réel
- Explorer et pratiquer des ensembles de données dans Kaggle, Analytique Vidhya
- Curiosité analytiqueL’analytique fait référence au processus de collecte, Mesurer et analyser les données pour obtenir des informations précieuses qui facilitent la prise de décision. Dans divers domaines, Comme les affaires, Santé et sport, L’analytique peut identifier des modèles et des tendances, Optimiser les processus et améliorer les résultats. L’utilisation d’outils et de techniques statistiques de pointe est essentielle pour transformer les données en connaissances applicables et stratégiques....
- Compétences non techniques
1. Apprendre Python
La première et principale étape vers la science des données devrait être un langage de programmation (c'est-à-dire, Python). Python est le langage de codage le plus courant, utilisé par la plupart des data scientists, en raison de sa simplicité, polyvalence et étant pré-équipé de puissantes bibliothèques (comme NumPy, SciPy et les pandas) utile dans l'analyse des données et d'autres aspects des sciences des données. Python est un langage open source et prend en charge diverses bibliothèques.
Ressource:
MOOC: Cours Python Udacity, Cours Python Coursera
Chaîne Youtube: Krish Naik, Bases du code
Blogues: Analytique Vidhya, Pépites de KD
2. Apprendre les statistiques
Et La science des données est un langage, alors les statistiques sont essentiellement de la grammaire. Les statistiques sont essentiellement la méthode d'analyse et d'interprétation de grands ensembles de données. Lorsqu'il s'agit d'analyse de données et de collecte d'informations, les statistiques sont aussi remarquables que l'air pour nous. Les statistiques nous aident à comprendre les détails cachés des grands ensembles de données
Ressource:
MOOC: Cours de statistiques de Coursera
Chaîne Youtube: Krish Naik, Bases du code
Blogues: Analytique Vidhya, Pépites de KD
3. Collecte de données
C'est l'une des étapes clés et importantes dans le domaine de la science des données.. Cette compétence implique la connaissance de divers outils pour importer des données des deux systèmes locaux., sous forme de fichiers CSV, et extraire des données de sites Web, à l'aide de belle bibliothèque python soupe. La mise au rebut peut également être basée sur une API. La collecte de données peut être gérée avec une connaissance du langage de requête ou des pipelines ETL en Python
Ressource:
MOOC: Collecter des données Coursera avec Python
4. Nettoyage des données
C'est l'étape que vous passez le plus de temps en tant que data scientist. Le nettoyage des données consiste à obtenir les données, adapté au travail et à l'analyse, en supprimant les valeurs indésirables, valeurs manquantes, valeurs catégorielles, valeurs aberrantes et enregistrements soumis de manière incorrecte, de la forme brute des données.. Le nettoyage des données est très important car les données du monde réel sont par nature désordonnées et pour y parvenir à l'aide de diverses bibliothèques Python (Pandas et NumPy) est vraiment important pour un chercheur de données en herbe.
Ressource:
Blog: Blog sur le nettoyage des données Python
5. Connaissance de l'EDA (l'analyse exploratoire des données)
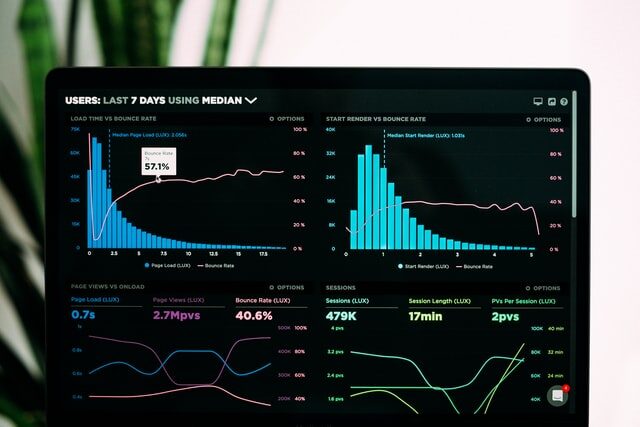
AED (l'analyse exploratoire des données) est l'aspect le plus important dans le vaste domaine de la science des données. Comprend l'analyse de diverses données, variables, divers modèles de données, tendances et en extraire des informations utiles à l'aide de diverses méthodes graphiques et statistiques. EDA identifie plusieurs modèles que l'algorithme d'apprentissage automatique pourrait ne pas identifier. Comprend toutes les manipulations, analyse et visualisation des données.
Ressource:
Communautés de la science des données: Kaggle, Vidhya Analytics
Blog: EDA dans l'ensemble de données d'iris
Chaîne Youtube: Vidéos EDA dans Krish Naik, Bases du code
MOOC: Cours Coursera sur l'EDA, statistiques, probabilité
6. Apprentissage automatique et apprentissage profond
L'apprentissage automatique est la principale compétence requise pour être un scientifique des données. L'apprentissage automatique est utilisé pour construire divers modèles prédictifs, modèles de classification, etc., et grandes entreprises, les entreprises, l'utiliser pour optimiser leur planification en fonction des prédictions. Par exemple, prévision du prix de la voiture
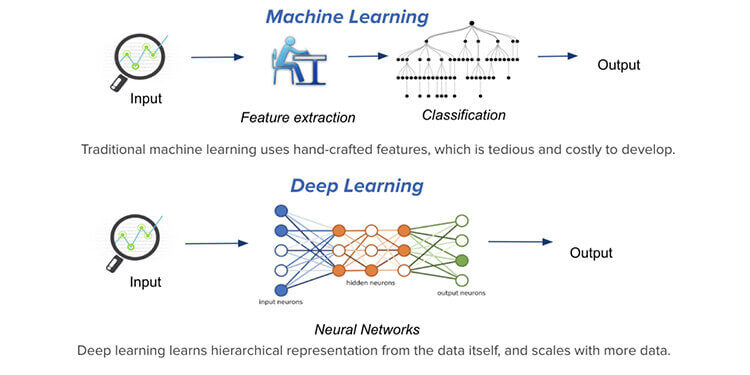
L'apprentissage en profondeur, d'un autre côté, est une version avancée de Machine Learning qui implémente l'utilisation de Neural Network, un cadre qui combine plusieurs algorithmes d'apprentissage automatique pour résoudre diverses tâches, pour former des données. Varias redes neuronales son una récurrence neuronale rougeRéseaux de neurones récurrents (RNN) sont un type d’architecture de réseau neuronal conçu pour traiter des flux de données. Contrairement aux réseaux de neurones traditionnels, Les RNN utilisent des connexions internes qui permettent de mémoriser les informations des entrées précédentes. Cela les rend particulièrement utiles dans des tâches telles que le traitement du langage naturel, Traduction automatique et analyse de séries chronologiques, où le contexte et la séquence sont au cœur de la... (RNN) o una convolucional neuronal rougeRéseaux de neurones convolutifs (CNN) sont un type d’architecture de réseau neuronal conçu spécialement pour le traitement de données avec une structure en grille, comme images. Ils utilisent des couches de convolution pour extraire des caractéristiques hiérarchiques, Ce qui les rend particulièrement efficaces dans les tâches de reconnaissance et de classification des formes. Grâce à sa capacité à apprendre à partir de grands volumes de données, Les CNN ont révolutionné des domaines tels que la vision par ordinateur.. (CNN), etc.
Par exemple: la reconnaissance faciale
Moyens:
Communautés de la science des données: Kaggle, Vidhya Analytics
Blog: Analytique Vidhya, Pépites de KD
Chaîne Youtube: vidéos dans Krish Naik, Bases du code
MOOC: Apprentissage automatique du curso de coursera, Spécialisation Coursera Deep Learning
7. Apprenez à implémenter le modèle ML
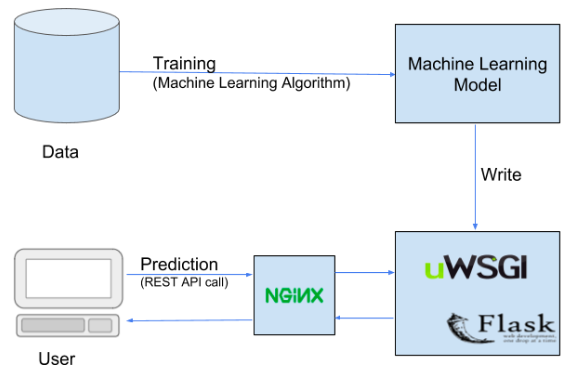
Le déploiement consiste essentiellement à mettre votre modèle d'apprentissage automatique à la disposition des utilisateurs finaux.. Ceci est réalisé en intégrant le modèle avec divers environnements de production existants., mettant ainsi en œuvre l'utilisation pratique du modèle ML pour diverses solutions commerciales.
Il existe de nombreux services pour implémenter votre modèle de ML comme Flask, Pythonpartout, MLOps, Microsoft Azure, Google Cloud, Héroku, etc.
Moyens:
Chaîne Youtube: Vidéos de mise en œuvre des AA sur Krish Naik, Bases du code
Blogues: Analytique Vidhya, Pépites de KD
8. Tests du monde réel
Les tests et la validation du modèle d'apprentissage automatique doivent être effectués après la mise en œuvre pour vérifier son efficacité et son exactitude.. Les tests sont une étape importante de la science des données pour contrôler l'efficience et l'efficacité du modèle de ML.
Il existe plusieurs types de tests comme A / B, Tests AAB, etc.
9. Explorer et pratiquer des ensembles de données dans Kaggle, Analytique Vidhya
Les plus grandes communautés de science des données au monde comme Kaggle, Analytics Vidhya est très utile pour entrer en contact avec divers ensembles de données et, donc, peut être utilisé pour pratiquer diverses techniques d'analyse de données, algorithmes d'apprentissage automatique. Les concours organisés dans ces communautés sont également utiles pour améliorer les compétences en science des données., nous aider à atteindre notre objectif de devenir plus rapidement compétents en science des données..
10. Curiosité analytique
Le domaine de la science des données est un domaine qui évolue à un rythme plus rapide., donc, nécessite une curiosité innée pour explorer davantage le domaine, mise à jour et apprentissage réguliers de diverses compétences et techniques.
C'est la compétence principale qui nous aidera toujours à maintenir, mettre à jour de nouvelles compétences et de nouveaux concepts, nous évitant ainsi de prendre du retard sur plusieurs avancées technologiques en science des données.
11. Compétences non techniques
Non technique comprend le travail d'équipe, compétences en communication, Gestion des tâches, compréhension des affaires, etc
Travail en équipe joue un rôle important dans la livraison du résultat aux entreprises, entreprises où nous travaillons en tant que data scientists.
Compétences en communication nous permettent d'exprimer nos idées techniques, concepts à divers fonctionnaires / autorités non techniques du Cabinet.
Tâche La gestion implique une planification et une gestion appropriées pour la livraison de la solution.
Entente / le sens des affaires o la compréhension de l'industrie dans laquelle nous travaillons est très importante pour diverses analyses et solutions efficaces aux problèmes de ces industries.





