
Qu'est-ce que l'encodage One-Hot? Quand devriez-vous utiliser l'encodage One-Hot au lieu de l'encodage des balises?
Ce sont des questions typiques d'entretien en science des données auxquelles tout scientifique en herbe devrait connaître la réponse.. Après tout, Vous devrez souvent choisir entre les deux dans un projet de science des données !!
Les machines comprennent les chiffres, pas de texte. Nous devons convertir chaque catégorie de texte en nombres pour que la machine les traite à l'aide d'équations mathématiques. Vous êtes-vous déjà demandé comment nous pouvons faire cela? Quelles sont les différentes manières?
C'est là que l'encodage des balises et l'encodage à chaud entrent en jeu.. Nous allons discuter des deux dans cet article et comprendre la différence entre eux..
Noter: Commencer votre parcours d'apprentissage automatique? Je recommande de prendre notre complet et populaire Cours d'apprentissage automatique appliqué!
Table des matières
- Qu'est-ce que le codage catégoriel?
- Différentes approches du codage catégoriel
- Encodage des étiquettes
- Codage à chaud
- Quand utiliser l'encodage des balises par rapport à l'encodage à chaud?
Qu'est-ce que le codage catégoriel?
Comme d'habitude, tout ensemble de données structurées comprend plusieurs colonnes, une combinaison de variables numériques et catégorielles. Une machine ne peut comprendre que les nombres. Je ne comprends pas le texte. C'est aussi essentiellement le cas avec les algorithmes d'apprentissage automatique..
C'est principalement la raison pour laquelle nous devons convertir les colonnes catégorielles en colonnes numériques pour qu'un algorithme d'apprentissage automatique puisse les comprendre.. Ce processus est appelé codage catégoriel.
Le codage catégoriel est un processus de conversion de catégories en nombres.
Dans la section suivante, Je vais aborder différentes manières de gérer les variables catégorielles.
Différentes approches du codage catégoriel
Ensuite, Comment devons-nous gérer les variables catégorielles? Il s'avère qu'il existe plusieurs façons de gérer les variables catégorielles. Dans cet article, Je vais discuter des deux techniques les plus utilisées:
- Encodage des étiquettes
- Codage à chaud
À présent, voyons les en détail.
Encodage des étiquettes
Encodage des étiquettes est une technique de codage populaire pour la gestion des variables catégorielles. Dans cette technique, chaque balise se voit attribuer un entier unique par ordre alphabétique.
Voyons comment implémenter l'encodage des balises en Python à l'aide de la bibliothèque scikit-learn et comprenons également les défis liés à l'encodage des balises.
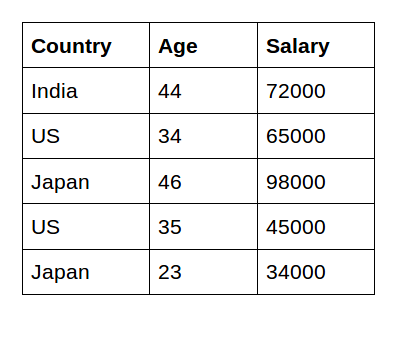
Commençons par importer les bibliothèques et l'ensemble de données nécessaires:
Production:
Comprendre les types de données des fonctions:
Production:
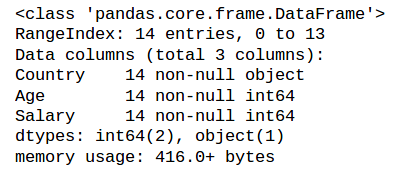
Comme vous pouvez le voir ici, la première colonne, Pays, est la caractéristique catégorique puisqu'elle est représentée par le type de données d'objet et le reste sont des caractéristiques numériques, puisqu'ils sont représentés par int64.
À présent, implémentons l'encodage des balises en python:
Production:
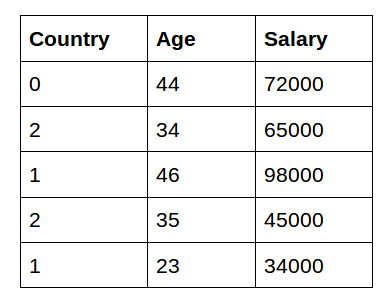
Comme vous pouvez le voir ici, l'encodage des balises utilise l'ordre alphabétique. Donc, L'Inde a été codée avec 0, EE. UU. Avec 2 et le Japon avec 1.
Défis avec le codage des balises
Dans le scénario ci-dessus, les noms des pays n'ont pas d'ordre ou de rang. Mais, lorsque l'encodage des balises est terminé, les noms des pays sont classés selon les alphabets. À cause de, il y a une très forte probabilité que le modèle capture la relation entre des pays comme l'Inde <Japon <EE. UU.
C'est quelque chose dont nous ne voulons pas !! Ensuite, Comment surmonter cet obstacle? Voici le concept de Codage à chaud.
Codage à chaud
L'encodage à chaud est une autre technique populaire pour traiter les variables catégorielles. Il suffit de créer des caractéristiques supplémentaires en fonction du nombre de valeurs uniques dans la caractéristique catégorielle. Chaque valeur unique dans la catégorie sera ajoutée en tant que caractéristique.
L'encodage à chaud est le processus de création de variables factices.
Dans cette technique de codage, chaque catégorie est représentée comme un vecteur unique. Voyons comment implémenter l'encodage one-hot en Python:
Production:
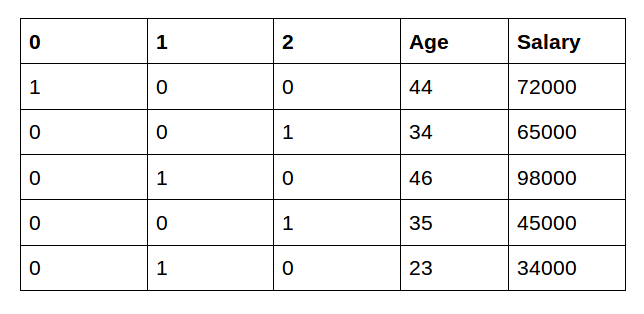
Comme vous pouvez le voir ici, Ajouter à 3 de nouvelles fonctions car le pays contient 3 valeurs uniques: Inde, Japon et États-Unis. UU. Dans cette technique, nous avons résolu le problème de classification puisque chaque catégorie est représentée par un vecteur binaire.
Pouvez-vous voir des inconvénients avec cette approche? Pensez-y avant de lire la suite.
Les défis du codage One-Hot: prendre au piège variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... fictif
L'encodage à chaud entraîne un piège de variable factice, puisque le résultat d'une variable peut être facilement prédit à l'aide des variables restantes.
Le piège à variables muettes est un scénario dans lequel les variables sont fortement corrélées les unes aux autres.
Le piège à variable fictive conduit au problème connu sous le nom de multicolinéarité. La multicolinéarité se produit lorsqu'il existe une dépendance entre des caractéristiques indépendantes. La multicolinéarité est un problème sérieux dans les modèles d'apprentissage automatique comme la régression linéaire et la régression logistique.
Donc, surmonter le problème de la multicolinéarité, l'une des variables muettes doit être supprimée. Ici, je vais pratiquement démontrer comment le problème de multicolinéarité est introduit après avoir fait un encodage à chaud.
L'un des moyens courants de vérifier la multicolinéarité est le facteur d'inflation de la variance (VIF):
- VIF = 1, très moins de multicolinéarité
- VIF <5, multicolinéarité modérée
- VIF> 5, extrême multicolinéarité (c'est ce qu'il faut éviter)
Calculer les scores VIF:
Production:
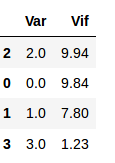
A la sortie, nous pouvons voir que les variables factices créées à l'aide d'un codage à chaud ont VIF ci-dessus 5. Nous avons un problème de multicolinéarité.
À présent, laissons tomber l'une des variables muettes pour résoudre le problème de multicolinéarité:
Production:
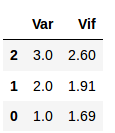
Wow! VIF a diminué. Nous avons résolu le problème de la multicolinéarité. À présent, l'ensemble de données est prêt à construire le modèle.
Je vous recommande de lire Aller plus loin dans l'analyse de régression avec des hypothèses, des graphiques et des solutions pour comprendre les hypothèses de régression linéaire.
Nous avons vu deux techniques différentes: Label et One-Hot Encoding pour gérer les variables catégorielles. Dans la section suivante, Je vais parler du moment où préférer l'encodage des balises à l'encodage One-Hot.
Quand utiliser l'encodage des balises par rapport à l'encodage à chaud
Cette question dépend généralement de votre jeu de données et du modèle que vous souhaitez appliquer. Mais reste, quelques points à considérer avant de choisir la bonne technique de codage pour votre modèle:
Nous appliquons l'encodage One-Hot lorsque:
- La caractéristique catégorique est pas ordinal (comme les pays ci-dessus)
- Le nombre de caractéristiques catégorielles est moindre, afin que l'encodage à chaud puisse être appliqué efficacement
Nous appliquons l'encodage des balises lorsque:
- La caractéristique catégorique est ordinal (comme Jr. kg, Sr. kg, école primaire, enseignement secondaire)
- Le nombre de catégories est assez important car l'encodage à chaud peut entraîner une consommation de mémoire élevée.
Remarques finales
Tel que cité par Jeff Hawkins:
"La clé de l'intelligence artificielle a toujours été la représentation".
La représentation a été la clé pour les développeurs et de temps en temps, de nouvelles techniques émergent pour mieux représenter les données et améliorer la précision et l'apprentissage de notre modèle..
Je vous encourage à suivre le cours suivant pour devenir un expert en apprentissage automatique:





