
Spark est un moteur d'analyse de données qui est principalement utilisé pour une grande quantité de traitement de données. Il nous permet de répartir les données et les opérations de calcul sur plusieurs clusters pour comprendre une augmentation significative des performances.
Aujourd'hui, Spark est préféré par les scientifiques des données en raison de ses divers avantages par rapport aux autres outils de traitement de données. Al usar Spark, le coût de la collecte, le stockage et le transfert de données diminuent. Quand on travaille sur un problème de la vie réelle, nous sommes susceptibles d'avoir de grandes quantités de données à traiter. Donc, les différents moteurs distribués comme Hadoop, Étincelle, etc. deviennent les principaux outils au sein de l'écosystème de la science des données.
PySpark
PySpark est un outil d'analyse de données créé par Apache SparkApache Spark est un moteur de traitement de données open source qui permet l'analyse de grands volumes d'informations de manière rapide et efficace. Sa conception est basée sur la mémoire, ce qui optimise les performances par rapport à d'autres outils de traitement par lots. Spark est largement utilisé dans les applications de big data, apprentissage automatique et analyse en temps réel, grâce à sa facilité d'utilisation et.... la Communauté pour utiliser Python avec Spark. Il nous permet de travailler avec RDD (Ensemble de données distribué résilient)RDD (Ensemble de données distribué résilient) est une abstraction fondamentale dans Apache Spark qui permet le traitement efficace de grands volumes de données. Elle se caractérise par sa capacité à tolérer les pannes, permettant la récupération des données perdues en reconstruisant les partitions. Les RDD sont immuables, ce qui facilite la parallélisation des opérations et améliore les performances dans le calcul distribué. Son utilisation est essentielle pour l'analyse de données... et DataFrames en Python. PySpark possède de nombreuses fonctionnalités qui en font un framework incroyable et lorsqu'il s'agit de traiter de grandes quantités de données, PySpark nous offre un traitement rapide et en temps réel, la flexibilité, informatique en mémoire et diverses autres fonctionnalités. C'est une bibliothèque Python pour utiliser Spark qui combine la simplicité du langage Python avec l'efficacité de Spark.
Bloc de données Pyspark
Un DataFrame est une collection distribuée de données dans des lignes sous des colonnes nommées. En termes simples, nous pouvons dire que c'est la même chose qu'une table dans une base de donnéesUne base de données est un ensemble organisé d’informations qui vous permet de stocker, Gérez et récupérez efficacement les données. Utilisé dans diverses applications, Des systèmes d’entreprise aux plateformes en ligne, Les bases de données peuvent être relationnelles ou non relationnelles. Une bonne conception est essentielle pour optimiser les performances et garantir l’intégrité de l’information, facilitant ainsi la prise de décision éclairée dans différents contextes.... relationnelle ou une feuille Excel avec des en-têtes de colonne. Les DataFrames sont principalement conçus pour traiter une collection à grande échelle de données structurées ou semi-structurées.
Dans cet article, nous discuterons de la 10 Fonctions PySpark les plus utiles et essentielles pour effectuer une analyse efficace des données structurées.
Nous utilisons Google Colab comme IDE pour cette analyse de données.
Nous devons d'abord installer PySpark sur Google Colab. Après cela, nous allons importer le module pyspark.sql et créer une SparkSession qui sera un point d'entrée de l'API Spark SQL.
#installer pyspark
!pip installer pyspark
#importation de pyspark
importer pyspark

#importation d'étincelles
à partir de pyspark.sql importer SparkSession

#créer un objet Sparksession et fournir appName
spark=SparkSession.builder.appName("pysparkdf").obtenirOuCréer()
Cet objet SparkSession interagira avec les fonctions et méthodes Spark SQL. À présent, créons un Spark DataFrame en lisant un fichier CSV. Nous utiliserons un jeu de données simple, c'est-à-dire Valeur nutritive de 80 produits céréaliers disponible chez Kaggle.
#créer une trame de données à l'aide d'un objet spark en lisant un fichier csv
df = étincelle.lire.option("entête", "vrai").csv("/contenu/céréales.csv")
#montrer df créé en haut 10 Lignes
df.show(10)
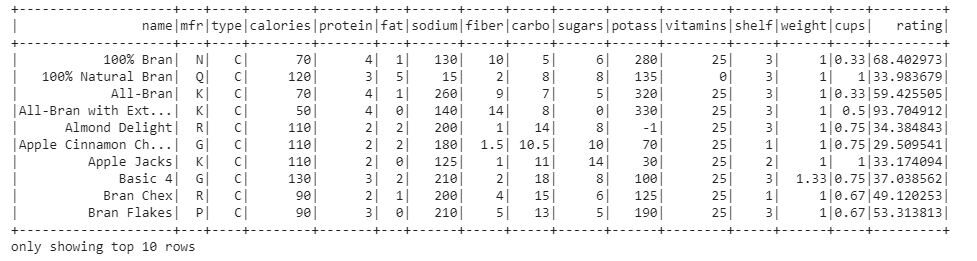
C'est la base de données que nous utilisons pour l'analyse des données. À présent, imprimons le schéma du DataFrame pour en savoir plus sur l'ensemble de données.
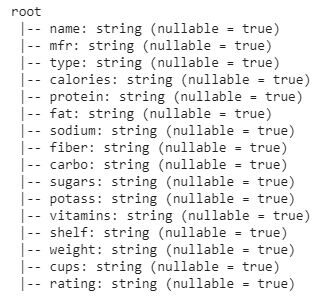
Le DataFrame se compose de 16 fonctions ou colonnes. Chaque colonne contient des valeurs de type chaîne.
Commençons par les fonctions:
- Veuillez sélectionner(): La fonction select nous aide à afficher un sous-ensemble de colonnes sélectionnées de l'ensemble du bloc de données, nous avons juste besoin de passer les noms de colonnes souhaités. Imprimons trois colonnes quelconques du dataframe en utilisant sélectionnerLa commande "SÉLECTIONNER" est fondamental en SQL, utilisé pour interroger et récupérer des données d'une base de données. Permet de spécifier des colonnes et des tables, en filtrant les résultats avec des clauses telles que "OÙ" et en triant avec "COMMANDÉ PAR". Sa polyvalence en fait un outil essentiel pour la manipulation et l'analyse des données, facilitant l'obtention d'informations spécifiques de manière efficace.... ().
df.select('name', 'mfr', 'rating').spectacle(10)
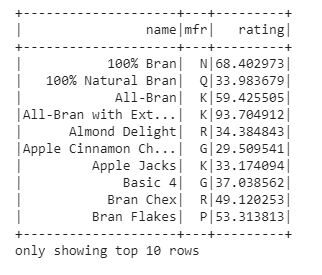
A la sortie, nous avons obtenu le sous-ensemble du bloc de données avec trois colonnes de nom, fabricant, évaluation.
- avecColonne (): La fonction withColumn permet de manipuler une colonne ou de créer une nouvelle colonne avec la colonne existante. C'est une fonction de transformation, nous pouvons également changer le type de données de n'importe quelle colonne existante.
Dans le schéma DataFrame, nous avons vu que toutes les colonnes sont de type string. Modifions le type de données de la colonne de calories en un nombre entier.
df.withColumn("Calories",df['calories'].jeter("Entier")).printSchéma()
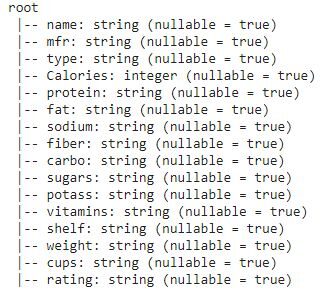
Dans le schéma, nous pouvons voir que la colonne Calorie Data Type est remplacée par le type entier.
- par groupe(): La fonction groupBy est utilisée pour collecter les données en groupes dans DataFrame et nous permet d'effectuer des fonctions d'agrégation sur les données regroupées. Il s'agit d'une opération d'analyse de données très courante similaire à la clause groupBy dans SQL.
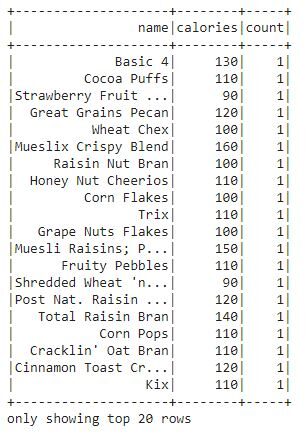
Découvrons le nombre de chaque céréale présente dans l'ensemble de données.
df.groupBy("Nom", "calories").compter().spectacle()
- commandé par (): La fonction orderBy est utilisée pour trier l'ensemble du bloc de données en fonction de la colonne particulière du bloc de données. Trier les lignes du bloc de données en fonction des valeurs de colonne. Par défaut, est trié par ordre croissant.
Analysons le bloc de données en fonction de la colonne de protéines de l'ensemble de données.
df.orderBy("protéine").spectacle()
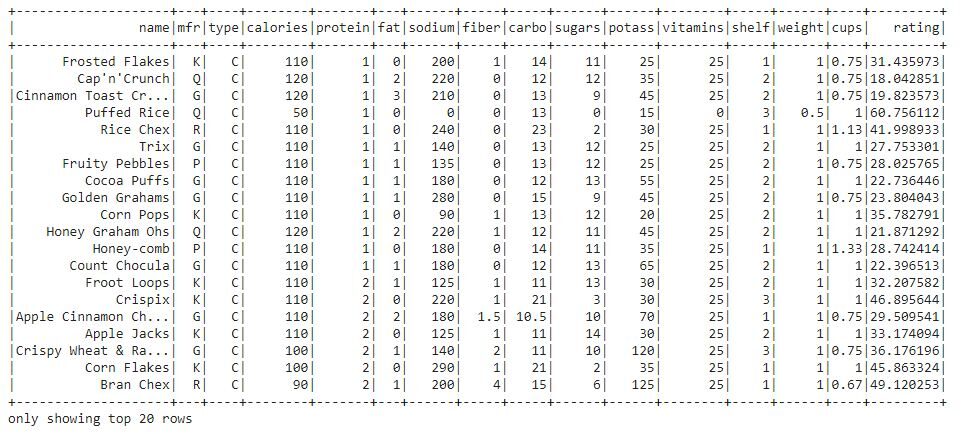
Nous pouvons voir que l'ensemble du bloc de données est ordonné en fonction de la colonne de protéines.
- briser(): La scission () utilisé pour diviser une colonne de chaîne de trame de données en plusieurs colonnes. Cette fonction est appliquée au bloc de données à l'aide de withColumn () et sélectionnez ().
La colonne du nom du bloc de données contient des valeurs dans deux mots de chaîne. Divisons la colonne name en deux colonnes à partir de l'espace entre deux chaînes.
fropm pyspark.sql.functions importation fractionnée
df1 = df.avecColonne('Name1', diviser(df['name'], " ").obtenir l'article(0))
        .avecColonne('Name2', diviser(df['name'], " ").obtenir l'article(1))
df1.select("Nom", "Nom1", "Nom2").spectacle()
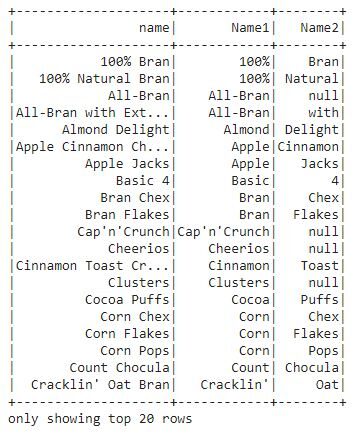
Dans cette sortie, on peut voir que la colonne name est divisée en colonnes.
- illuminé(): La fonction allumée est utilisée pour ajouter une nouvelle colonne au bloc de données qui contient des littéraux ou une valeur constante.
Ajoutons une colonne « montant de l'apport » qui contient une valeur constante pour chacune des céréales ainsi que le nom de la céréale respective.
de pyspark.sql.functions import allumé
df2 = df.select(col("Nom"),allumé("75 gm").alias("quantité d'admission"))
df2.show()
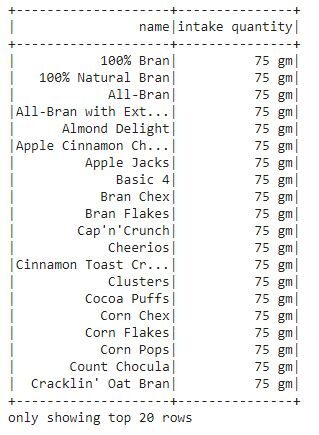
A la sortie, On peut voir qu'une nouvelle colonne "quantité ingérée" est créée qui contient la quantité ingérée de chaque céréale.
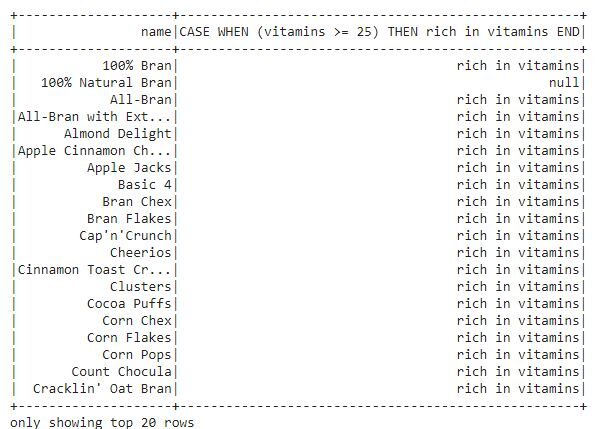
- lorsque(): Le moment où la fonction est utilisée pour afficher la sortie en fonction de la condition particulière. Évaluez la condition fournie puis renvoyez les valeurs en conséquence. C'est une fonction SQL que PySpark prend en charge pour vérifier plusieurs conditions dans une séquence et renvoyer la valeur. Cette fonction fonctionne de la même manière que les instructions if-then-else et switch.
Regardons les céréales riches en vitamines.
de pyspark.sql.functions importer quand
df.select("Nom", lorsque(df.vitamines >= "25", "riche en vitamines")).spectacle()
- filtre(): La fonction de filtre est utilisée pour filtrer les données dans les lignes en fonction de valeurs de colonne particulières. Par exemple, nous pouvons filtrer les céréales qui ont des calories égales à 100.
à partir du filtre d'importation pyspark.sql.functions
df.filtre(df.calories == "100").spectacle()
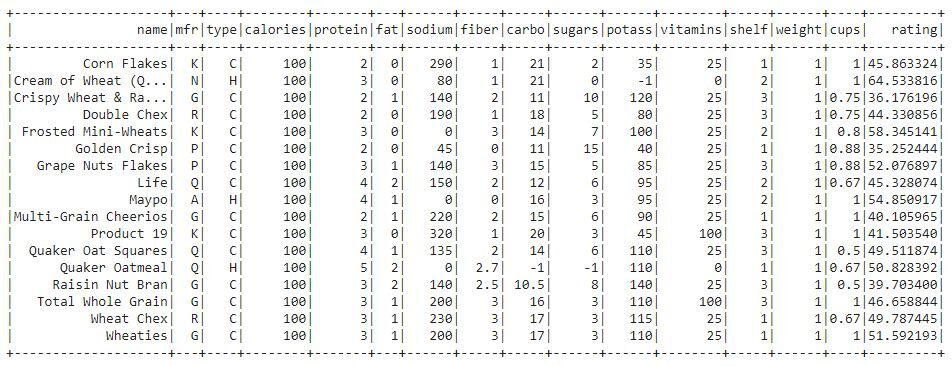
Dans cette sortie, on voit que les données sont filtrées selon les céréales qui ont 100 calories.
- estNull () / est non nulle (): Ces deux fonctions permettent de savoir s'il y a des valeurs nulles présentes dans le DataFrame. C'est la fonction la plus essentielle pour le traitement des données. C'est le principal outil utilisé pour le nettoyage des données.
Voyons s'il y a des valeurs nulles présentes dans l'ensemble de données.
#est non nulle()
à partir de l'importation de pyspark.sql.functions *
#filtrer les données par valeurs nulles
df.filtre(df.name.isNotNull()).spectacle()
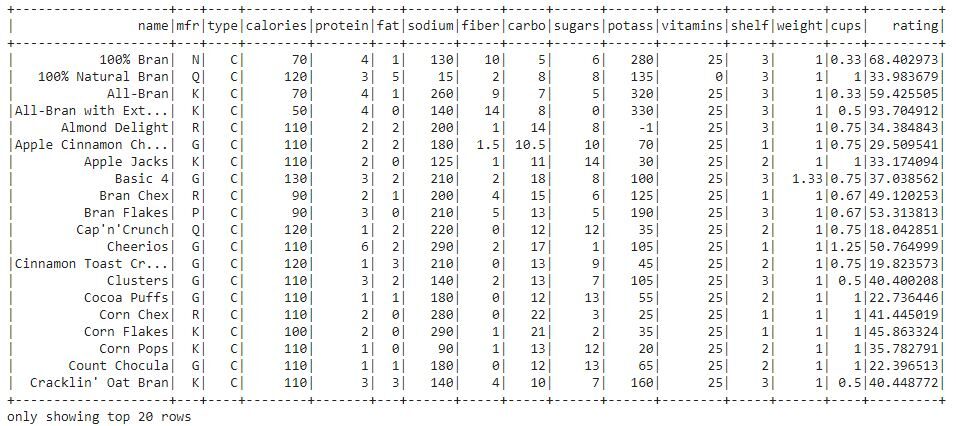
Il n'y a pas de valeurs nulles présentes dans cet ensemble de données. Donc, l'ensemble du bloc de données est affiché.
c'est nul():
df.filtre(df.nom.isNull()).spectacle()
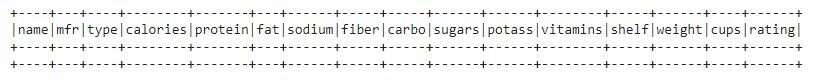
Encore, pas de valeurs nulles. Donc, un bloc de données vide s'affiche.
Dans ce blog, nous avons discuté de la 9 des fonctions plus utiles pour un traitement efficace des données. Ces fonctions PySpark sont la combinaison des langages Python et SQL.
Merci pour la lecture. S'il vous plaît laissez-moi savoir s'il y a des commentaires ou des commentaires.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





