
Cet article a été publié dans le cadre du Blogathon sur la science des données
introduction
Les données sont partout dans le monde des données d'aujourd'hui et nous ne pouvons en bénéficier que si nous pouvons extraire des informations des données. La visualisation des données est l'aspect le plus attrayant de l'analyse des données car elle nous permet d'interagir avec les données. C'est cette technique magique pour transmettre des informations à de grands groupes de personnes d'un seul coup d'œil et créer des histoires intéressantes à partir de données.. Pandas est l'un des outils d'analyse de données les plus populaires et les plus utilisés en Python. Il dispose également d'une fonction de traçage intégrée pour les échantillons. Cependant, lorsqu'il s'agit de visualisation interactive, Les utilisateurs de Python qui n'ont pas de compétences en ingénierie frontale peuvent avoir des problèmes, comme beaucoup de bibliothèques, comme D3, chart.js, nécessitant des connaissances JavaScript. Plotly et Twins sont utiles à ce stade.
Lorsqu'il y a une grande quantité de données et que les entreprises ont des difficultés à en extraire des informations critiques, la visualisation des données joue un rôle important dans la prise de décisions commerciales critiques.
Plotly est une bibliothèque graphique construite sur d3.js qui peut être utilisée directement avec les trames de données Pandas grâce à une autre bibliothèque appelée Cufflinks.
Nous allons vous montrer comment utiliser les graphiques interactifs Plotly avec les blocs de données Pandas dans ce didacticiel rapide.. Pour garder les choses simples, nous utiliserons Jupyter Notebook (installé à l'aide d'Anaconda Distribution avec Python) et le célèbre jeu de données Titanic.
Visualisation des données en Python
Après avoir terminé le nettoyage et la manipulation des données, la prochaine étape du processus d'analyse des données consiste à extraire des informations et des conclusions significatives à partir des données, ce qui peut être réalisé par des graphiques et des tableaux. Python a plusieurs bibliothèques qui peuvent être utilisées à cette fin. Comme d'habitude, on ne nous apprend que les deux bibliothèques matplotlib et seaborn. Ces bibliothèques incluent des outils pour créer des graphiques en courbes, camemberts, diagramme à barres, boîtes à moustachesDiagrammes encadrés, Aussi connu sous le nom de diagrammes en boîte et à moustaches, sont des outils statistiques qui représentent la distribution d’un ensemble de données. Ces diagrammes montrent la médiane, quartiles et valeurs aberrantes, Permettre de visualiser la variabilité et la symétrie des données. Ils sont utiles pour la comparaison entre différents groupes et pour l’analyse exploratoire, faciliter l’identification des tendances et des modèles dans les données.... et une variété d’autres diagrammes. Vous vous demandez probablement pourquoi nous avons besoin d'autres bibliothèques pour la visualisation des données si nous avons déjà matplotlib et seaborn. Quand j'ai entendu parler pour la première fois de l'intrigue et des jumeaux, j'avais la meme question en tete.
comploter
La version la plus récente de Plotly était 5.1.0, tandis que celui avec des jumeaux était 0.17.5. Parce que les anciennes versions des boutons de manchette ne sont pas compatibles avec les nouvelles versions de traçage, il est indispensable de mettre à jour les deux packages en même temps ou de trouver des versions compatibles. Dans Anaconda Prompt, exécutez les commandes suivantes pour installer plotly (o fr Le terminal lui-même utilise le système d'exploitation ou Ubuntu)
Plotly est une bibliothèque graphique et open source qui permet un traçage interactif. Python, R, MATLAB, Arduino et REST, entre autres, font partie des langages de programmation supportés par la bibliothèque.
Cufflink est une bibliothèque Python qui connecte plotly et pandas, nous permettant de tracer des graphiques directement sur des blocs de données. C'est essentiellement un plugin.
Les graphiques sont interactifs, ce qui nous permet de faire défiler au-dessus des valeurs, zoomer et dézoomer sur les graphiques et identifier les valeurs aberrantes dans l'ensemble de données. Les lettres Matplotlib et Seaborn, d'un autre côté, ils sont statiques; nous ne pouvons pas zoomer ou dézoomer l'image, et toutes les valeurs du tableau ne sont pas détaillées. La caractéristique la plus importante de Plotly est qu'il nous permet de créer des graphiques Web dynamiques directement à partir de Python, ce qui n'est pas possible avec matplotlib. Nous pouvons également faire des graphiques interactifs et des animations à partir de données géographiques, scientifiques, statistiques et finances en utilisant plotly.
Installer sur pc « terrain « Oui « jumeaux« utiliser un environnement anaconda
conda install -c plotly plotly
conda install -c conda-forge boutons de manchette-py
o en utilisant pip
pip install plotly --upgrade
pip installer des boutons de manchette -- mise à niveau
Chargement des bibliothèques
Bibliothèques de pandas, Plotly et Cufflinks se chargeront en premier. Parce que plotly est une plateforme en ligne, Nécessite un identifiant de connexion sessionLa "Session" C’est un concept clé dans le domaine de la psychologie et de la thérapie. Fait référence à une rencontre programmée entre un thérapeute et un client, où les pensées sont explorées, Émotions et comportements. La durée et la fréquence de ces séances peuvent varier, et son objectif principal est de faciliter la croissance personnelle et la résolution de problèmes. L’efficacité des séances dépend de la relation entre le thérapeute et le thérapeute.. Pour une utilisation en ligne. Nous utiliserons le mode hors ligne dans cet article, ce qui est suffisant pour Jupyter Notebook.
#importer des pandas
importer des pandas au format pd
#import de plotly et de boutons de manchette en mode hors ligne
importer des boutons de manchette comme cf
importer plotly.offline
cf.go_offline()
cf.set_config_file(hors ligne=Faux, world_readable=Vrai)
Chargement de l'ensemble de données
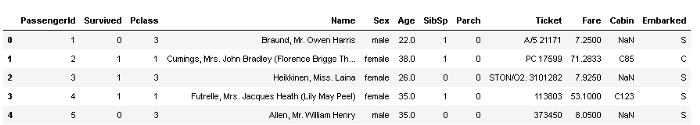
Nous avons mentionné que nous utiliserons l'ensemble de données Titanic, que pouvez-vous obtenir de cela kaggle_link. Seul le fichier train.csv sera utilisé.
df=pd.read_csv("train.csv")
df.head()
Histogramme
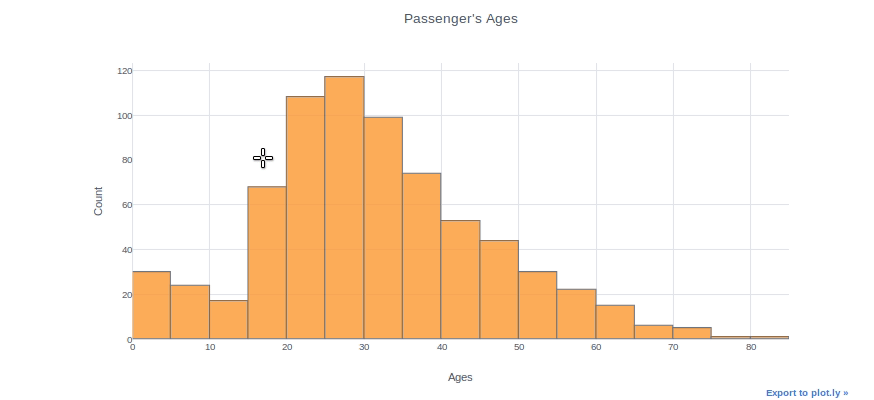
Les histogrammesLes histogrammes sont des représentations graphiques qui montrent la distribution d’un ensemble de données. Ils sont construits en divisant la plage de valeurs en intervalles, O "Bacs", et compter la quantité de données tombées dans chaque intervalle. Cette visualisation vous permet d’identifier des modèles, Tendances et variabilité des données, faciliter l’analyse statistique et la prise de décision éclairée dans diverses disciplines.... Peut être utilisé pour inspecter les distributions d’une entité, comme caractéristique « Âge » dans ce cas. Nous utilisons simplement le (trame de données["nom de colonne"]) pour sélectionner une colonne puis ajouter la fonction iplot. Exemple, nous pouvons spécifier la taille du conteneur, le thème, le titre et les noms des axes. Avec la commande « aider (df.iplot) », Vous pouvez voir tous les paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... du paramètre iplot.
df["Âge"].intriguer(genre ="histogramme", bacs=20, thème="blanche", titre="Âges des passagers",xTitre="Âge", yTitre ="Compter")
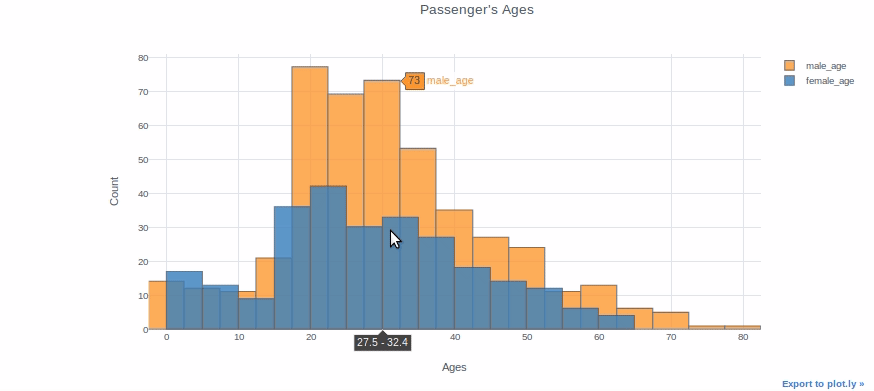
Vous pouvez tracer deux distributions différentes sous forme de deux colonnes différentes si vous souhaitez les comparer. Par exemple, nous tracerons les âges des passagers hommes et femmes sur la même parcelle.
df["male_age"]=df[df["Sexe"]=="Masculin"]["Âge"]
df["age_femelle"]=df[df["Sexe"]=="femelle"]["Âge"]df[["male_age","age_femelle"]].intriguer(genre ="histogramme", bacs=20, thème="blanche", titre="Âges des passagers",
         xTitre="Âge", yTitre ="Compter")
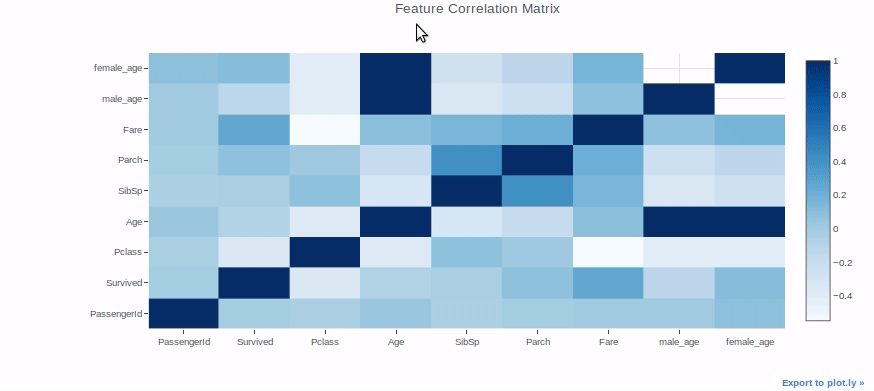
Carte de chaleurUn "carte de chaleur" est une représentation graphique qui utilise des couleurs pour montrer la densité des données dans une zone spécifique. Couramment utilisé dans l’analyse de données, Etudes marketing et comportementales, Ce type de visualisation vous permet d’identifier rapidement les modèles et les tendances. Par des variations chromatiques, Les cartes thermiques facilitent l’interprétation de grands volumes d’informations, aider à prendre des décisions éclairées....
Les cartes thermiques peuvent être utilisées à diverses fins, mais nous les utiliserons pour vérifier la corrélation entre les caractéristiques d'un ensemble de données à titre d'exemple.
Box plot
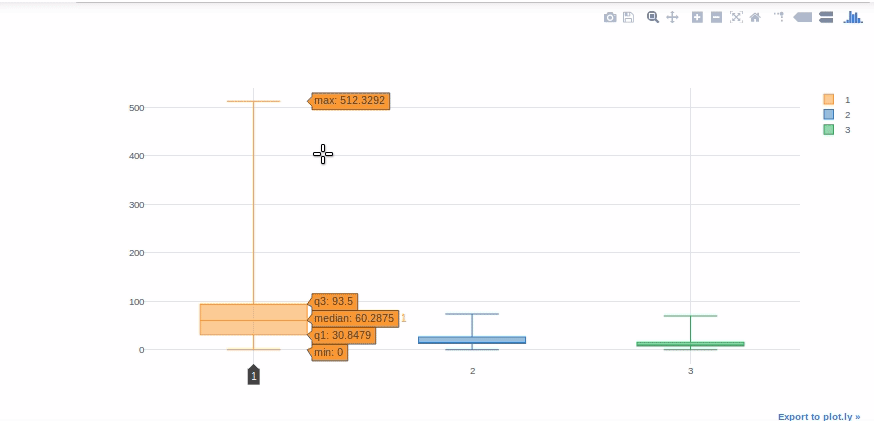
Les boîtes à moustaches sont extrêmement utiles pour interpréter rapidement l'asymétrie des données, valeurs aberrantes et plages de quartiles. Nous allons maintenant utiliser une boîte à moustaches pour montrer la distribution de « Taux » pour chaque classe de Titanic.
#nous obtiendrons l'aide des tableaux croisés dynamiques pour obtenir les valeurs des tarifs dans différentes colonnes pour chaque classe.
df[['Pclass', Tarif]].pivot(colonnes="Classe P", valeurs="Tarif").intriguer(kind='box')
Nuage de pointsUn nuage de points est une représentation visuelle qui montre la relation entre deux variables numériques à l’aide de points sur un plan cartésien. Chaque axe représente une variable, et l’emplacement de chaque point indique sa valeur par rapport aux deux. Ce type de graphique est utile pour identifier des modèles, Corrélations et tendances dans les données, faciliter l’analyse et l’interprétation des relations quantitatives....
Les nuages de points sont couramment utilisés pour visualiser la relation entre deux variables numériques. Pour les variables « Taux » Oui « Âge », nous utiliserons des diagrammes de dispersion. "Catégories" nous permet d'afficher les variables d'une caractéristique sélectionnée dans différentes couleurs (sexe des passagers dans ce cas).
df.iplot(genre ="dispersion", thème="blanche",x="Âge",y ="Tarif",
            catégories="Sexe")
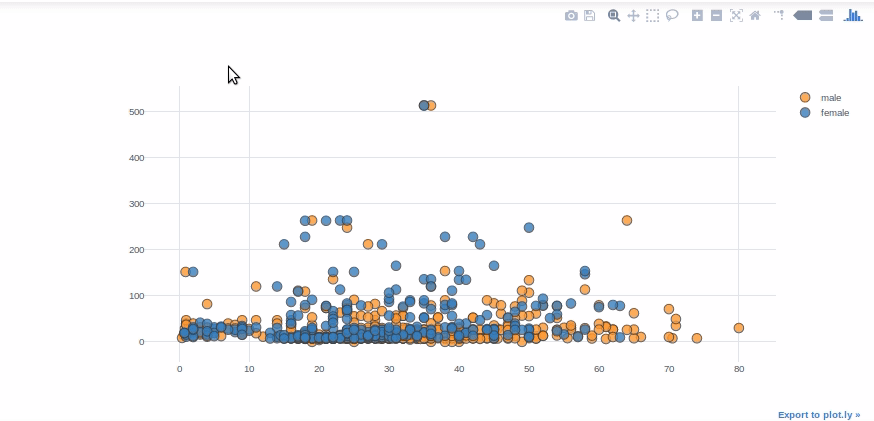
un petit rappel: le paramètre « catégories » doit être une chaîne ou une colonne de type float64. Par exemple, dans l'exemple du graphique à bulles, devrait convertir la colonne « Survécu » de type entier dans float64 ou string.
Graphique à bulles
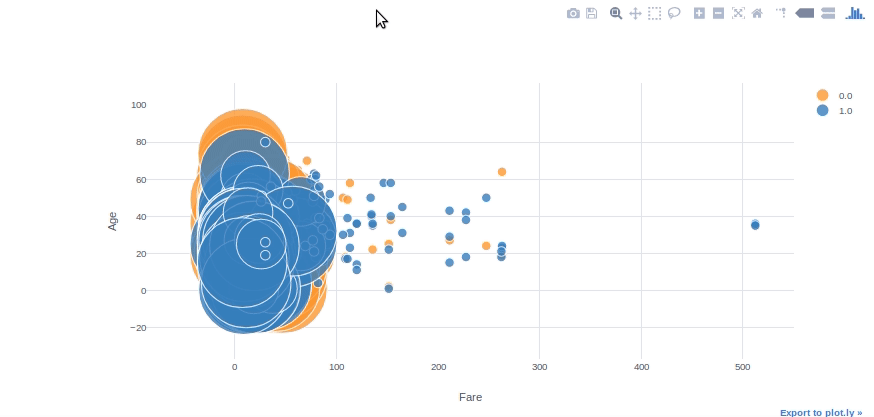
Nous pouvons utiliser des graphiques à bulles pour voir plusieurs relations variables en même temps. Avec les paramètres de « catégories » Oui « Taille » dans le graphique, nous pouvons facilement ajuster les sous-catégories de couleur et de taille. Avec le paramètre « texte », nous pouvons également spécifier la colonne de texte flottant.
#conversion de la colonne Survived en float64 pour pouvoir l'utiliser dans plotly
df[['Survécu']] = df[['Survécu']].astype(float64, copier=Faux)df.iplot(type='bulle', x="Tarif",y ="Âge",catégories="Survécu", taille ="Classe P", texte="Nom", xTitre="Tarif", yTitre ="Âge")
Graphique à barresLe graphique à barres est une représentation visuelle des données qui utilise des barres rectangulaires pour montrer des comparaisons entre différentes catégories. Chaque barre représente une valeur et sa longueur est proportionnelle à celle-ci. Ce type de graphique est utile pour visualiser et analyser les tendances, faciliter l’interprétation des informations quantitatives. Il est largement utilisé dans diverses disciplines, tels que les statistiques, Marketing et recherche, En raison de sa simplicité et de son efficacité....
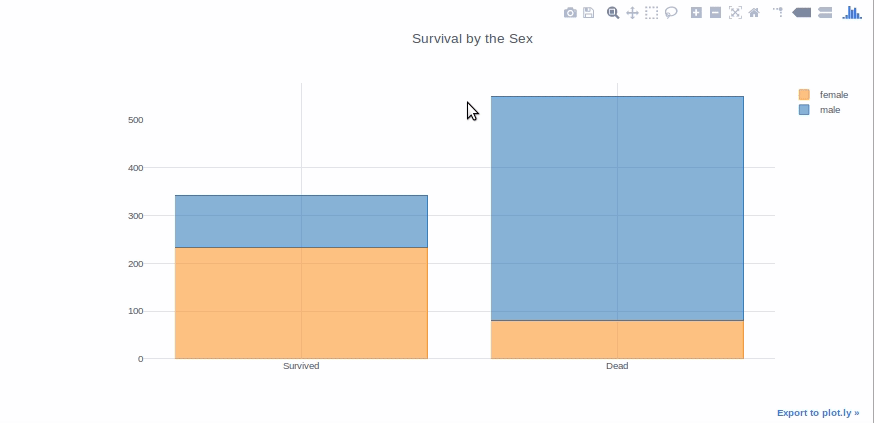
Les graphiques à barres sont utiles pour présenter les données de différents groupes qui sont comparés les uns aux autres. En outre, peut être utilisé empilé pour montrer différents effets variables. Nous allons faire un graphique à barres pour montrer le nombre de passagers survivants par sexe.
survécu_sexe = df[df['Survécu']==1]['Sexe'].value_counts()
sexe_mort = df[df['Survécu']==0]['Sexe'].value_counts()
df1 = pd.DataFrame([survit_sexe,sexe_mort])
df1.index = ['Survécu',Décédé]
df1.iplot(type='bar',mode bar ="empiler", titre="Survie par le sexe")
J'ai essayé de tout expliquer le plus simplement possible. J'espère qu'il est plus facile pour les nouveaux arrivants de comprendre l'intrigue.
Plotly fournit également des graphiques scientifiques, Graphiques 3D, cartes et animations. Vous pouvez visiter la documentation de plotly ici pour plus de détails.
Jetez un œil à l'EDA – Analyse exploratoire des données avec Python Pandas et SQL CLIQUEZ POUR LIRE
Note de fin
Merci pour la lecture!
J'espère que vous avez apprécié l'article et augmenté vos connaissances.
N'hésitez pas à me contacter sur Courrier électronique
Tout ce qui n'est pas mentionné ou voulez-vous partager vos pensées? N'hésitez pas à commenter ci-dessous et je vous répondrai.
A propos de l'auteur
Hardikkumar M. Dhaduk
Analyste de données | Spécialiste en analyse de données numériques | Étudiant en science des données
Connectez-vous avec moi sur Linkedin
Connectez-vous avec moi sur Github
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





