
Vue d'ensemble
- Apprendre le web scraping en Python à l'aide de la bibliothèque BeautifulSoup
- Le Web Scraping est une technique utile pour convertir des données non structurées sur le Web en données structurées
- BeautifulSoup est une bibliothèque efficace disponible en Python pour effectuer des scratchs Web autres que urllib
- Une connaissance de base des balises HTML et HTML est nécessaire pour faire du web scraping en Python
introduction
Le besoin et l'importance d'extraire des données du Web deviennent de plus en plus évidents.. Toutes les quelques semaines, Je suis dans une situation où nous devons extraire des données du Web pour construire un modèle d'apprentissage automatique.
Par exemple, la semaine dernière, nous pensions créer un indiceLe "Indice" C’est un outil fondamental dans les livres et les documents, qui vous permet de localiser rapidement les informations souhaitées. Généralement, Il est présenté au début d’une œuvre et organise les contenus de manière hiérarchique, y compris les chapitres et les sections. Sa préparation correcte facilite la navigation et améliore la compréhension du matériau, ce qui en fait une ressource incontournable tant pour les étudiants que pour les professionnels dans divers domaines.... de démangeaison et de sentiment sur plusieurs cours de science des données disponible sur internet. Cela ne nécessiterait pas seulement de trouver de nouveaux cours !, mais aussi rechercher sur le Web vos avis, puis les résumer en quelques métriques!
C'est l'un des problèmes / des produits dont l'efficacité dépend davantage du web scraping et de l'extraction d'informations (collecte de données) laquelle des techniques utilisées pour résumer les données.
Noter: Nous avons également créé un cours gratuit pour cet article: Introduction au web scraping avec Python. Ce format structuré vous aidera à mieux apprendre.
Façons d'extraire des informations du Web
Il existe plusieurs façons d'extraire des informations du Web. Utilisation de APIs étant probablement le meilleur moyen d'extraire des données d'un site Web. Presque tous les grands sites Web comme Twitter, Facebook, Google, Twitter, StackOverflow fournit des API pour accéder à vos données de manière plus structurée. Si vous pouvez obtenir ce dont vous avez besoin via une API, est presque toujours l'approche préférée au grattage Web. En effet, si vous accédez aux données structurées du fournisseur, Pourquoi voudriez-vous créer un moteur pour extraire les mêmes informations?
Malheureusement, tous les sites Web ne fournissent pas d'API. Certains le font parce qu'ils ne veulent pas que les lecteurs extraient beaucoup d'informations de manière structurée, tandis que d'autres ne fournissent pas d'API en raison d'un manque de connaissances techniques. Que faites-vous dans ces cas? Bon, nous devons gratter le site Web pour obtenir les informations.
Il peut y avoir d'autres moyens comme les flux RSS, mais son utilisation est limitée et, donc, Je ne les inclurai pas dans la discussion ici.
Qu'est-ce que le grattage Web?
Le grattage Web est une technique logicielle informatique permettant d'extraire des informations de sites Web.. Cette technique est principalement axée sur la transformation de données non structurées (Format HTML) sur le web en données structurées (base de donnéesUne base de données est un ensemble organisé d’informations qui vous permet de stocker, Gérez et récupérez efficacement les données. Utilisé dans diverses applications, Des systèmes d’entreprise aux plateformes en ligne, Les bases de données peuvent être relationnelles ou non relationnelles. Une bonne conception est essentielle pour optimiser les performances et garantir l’intégrité de l’information, facilitant ainsi la prise de décision éclairée dans différents contextes.... ou feuille de calcul).
Vous pouvez effectuer le grattage Web de différentes manières, y compris l'utilisation de Google Docs dans presque tous les langages de programmation. Je me tournerais vers Python pour sa facilité et son écosystème riche. Il a une bibliothèque connue sous le nom de ‘BelleSoupe’ ce qui aide dans cette tâche. Dans cet article, je vais vous montrer le moyen le plus simple d'apprendre le web scraping en utilisant la programmation python.
Pour ceux d'entre vous qui ont besoin d'un moyen sans programmation pour extraire des informations de pages Web, ils peuvent aussi regarder import.io . Fournit une interface guidée par GUI pour effectuer toutes les opérations de grattage Web de base. Les pirates peuvent continuer à lire cet article !!
Bibliothèques nécessaires pour le web scraping
Comme nous le savons, Piton est un langage de programmation open source. Vous pouvez trouver de nombreuses bibliothèques pour exécuter une fonction. Donc, vous devez trouver la meilleure bibliothèque à utiliser. Je préfère Belle soupe (Bibliothèque Python), car il est facile et intuitif de travailler dessus. Précisément, je vais utiliser deux modules python pour gratter les données:
- URLlib2: C'est un module Python qui peut être utilisé pour rechercher des URL. Définir des fonctions et des classes pour aider avec les actions d'URL (authentification de base et sommaire, redirige, biscuits, etc.). Pour plus de détails, voir le page de documentation. Noter: urllib2 est le nom de la bibliothèque incluse dans Python 2. À sa place, vous pouvez utiliser la bibliothèque urllib.request incluse avec python 3. La bibliothèque urllib.request fonctionne de la même manière que urllib.request fonctionne en Python 2. Parce que c'est déjà inclus pas besoin d'installer.
- BelleSoupe: C'est un outil incroyable pour extraire des informations d'une page Web. Vous pouvez l'utiliser pour extraire des tables, listes, paragraphe et vous pouvez également mettre des filtres pour extraire des informations des pages Web. Dans cet article, nous utiliserons la dernière version de BeautifulSoup 4. Vous pouvez vous référer aux instructions d'installation dans votre page de documentation.
BeautifulSoup ne recherche pas le site Web pour nous. Pour cela, J'utilise urllib2 en combinaison avec la bibliothèque BeautifulSoup.
Piton a plusieurs autres options pour le grattage HTML en plus de BeatifulSoup. en voici d'autres:
Des concepts basiques: se familiariser avec HTML (Étiquettes)
Pendant que nous faisons le web robuste, nous nous occupons des balises html. Donc, il faut bien les comprendre. Si vous connaissez déjà les bases du HTML, vous pouvez sauter cette section. Voici la syntaxe de base du HTML: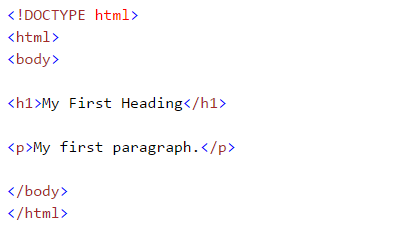 Cette syntaxe a plusieurs balises qui sont détaillées ci-dessous:
- : Les documents HTML doivent commencer par une déclaration de type
- Le document HTML est contenu entre Oui
- La partie visible du document HTML se situe entre Oui
- Les en-têtes HTML sont définis avec le
à Étiquettes - Les paragraphes HTML sont définis avec le étiqueter
D'autres balises HTML utiles sont:
- Les liens HTML sont définis avec le étiqueter, « <une href =« Http://www.test.com »>Ceci est un lien pour test.com</une> "
- Les tableaux HTML sont définis avec
, rang comme
et les lignes sont divisées en données comme 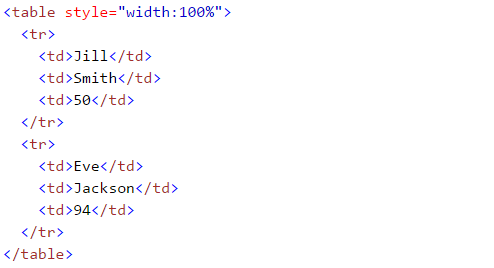
- La liste HTML commence par
- (désordonné) Oui
- Importez les bibliothèques requises:
- (soigné). Chaque élément de la liste commence par
Si vous êtes nouveau sur ces balises HTML, je te conseille aussi de vérifier Tutoriel HTML de W3schools. Cela vous donnera une compréhension claire des balises HTML.
Racler une page Web avec BeautifulSoup
Ici, J'extrait des données d'un page Wikipédia. Notre objectif ultime est d'extraire une liste des capitales des États et des syndicats territoriaux en Inde. Et quelques détails de base comme l'établissement, l'ancienne capitale et d'autres forment cette page wikipédia. Apprenons en faisant ce projet étape par étape:
#importer la bibliothèque utilisée pour interroger un site Web
import urllib2 #si vous utilisez la version python3+, importer urllib.request
#préciser l'url
wiki = "https://en.wikipedia.org/wiki/List_of_state_and_union_territory_capitals_in_India"
#Query the website and return the html to the variable 'page'
page = urllib2.urlopen(wiki) #pour python 3 utiliser urllib.request.urlopen(wiki)
#importer les fonctions Beautiful soup pour analyser les données renvoyées par le site Web de bs4 import BeautifulSoup
#Analyser le HTML dans la variable 'page', et conservez-le au format Beautiful Soup
soupe = BelleSoupe(page)
- Utiliser la fonction « embellir » pour voir la structure imbriquée de la page HTML
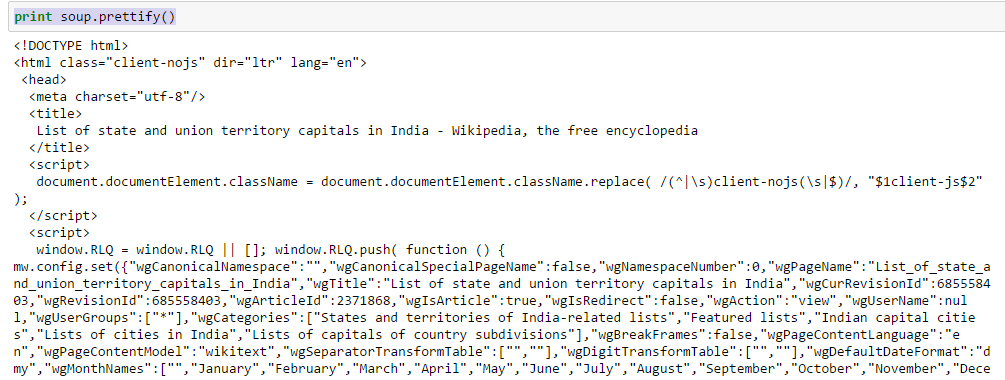 Dessus, vous pouvez voir cette structure de balises HTML. Cela vous aidera à découvrir les différentes balises disponibles et comment vous pouvez jouer avec elles pour extraire des informations.
- Travailler avec des balises HTML
- soupe. : Renvoie le contenu entre les balises d'ouverture et de fermeture, y compris l'étiquette.
Dans[30]:soupe.titre
Dehors[30]:<Titre>Liste des capitales des États et des territoires de l'Union en Inde - Wikipédia, l'encyclopédie libre</Titre>
- soupe. .chaîne de caractères: Chaîne de retour dans la balise donnée
Dans [38]:soupe.Titre.chaîne de caractères
Dehors[38]:u'Liste des capitales des États et territoires de l'Union en Inde' - Wikipédia, l'encyclopédie libre'
- Trouver tous les liens dans les balises de la page :: Nous savons que, nous pouvons taguer un lien en utilisant la balise « « . Ensuite, nous devrions aller avec l'option soupe. une et doit renvoyer les liens disponibles sur le site. Nous allons le faire.
Dans [40]:soupe.une
Dehors[40]:<un identifiant ="Haut"></une>
Dessus, Vous pouvez voir que nous n'avons qu'un seul moyen de sortir. À présent, pour extraire tous les liens à l'intérieur , nous utiliserons « Trouver tout().
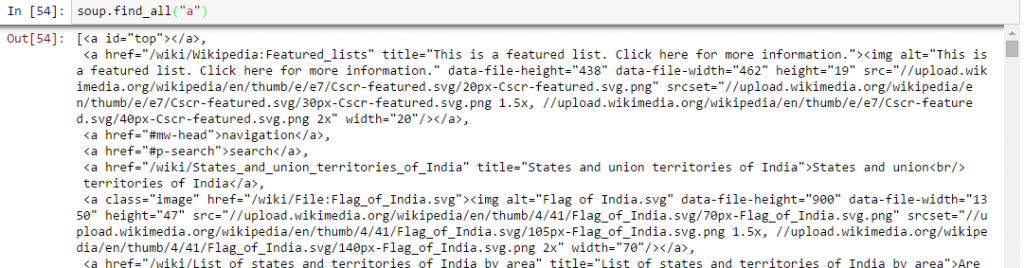
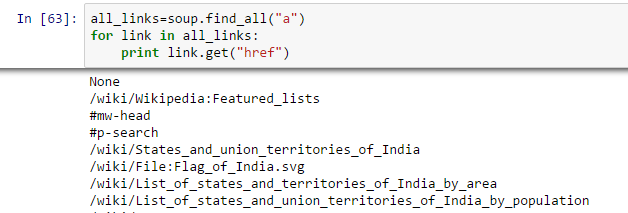
Dessus, afficher tous les liens, y compris les titres, liens et autres informations. À présent, pour n'afficher que les liens, nous devons itérer sur chaque balise a puis renvoyer le lien en utilisant l'attribut « href » avec avoir.
- Trouvez la bonne table: Comment nous cherchons un tableau pour extraire des informations sur les capitales des États, nous devons d'abord identifier la bonne table. Écrivons la commande pour extraire des informations à l'intérieur de tous mesa Étiquettes.
all_tables=soupe.find_all('table')À présent, pour identifier la bonne table, on utilisera l'attribut « classe » du tableau et nous l'utiliserons pour filtrer le bon tableau. Dans Chrome, vous pouvez vérifier le nom de la classe en cliquant avec le bouton droit sur le tableau requis de la page Web -> Inspecter l'élément -> Copiez le nom de la classe OU accédez à la sortie de la commande ci-dessus et recherchez le nom de la classe dans la table de droite.
table_droite=soupe.trouver('table', class_='wikitable sortable plainrowheaders') table_droite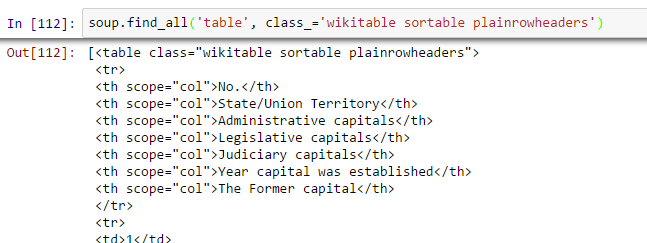 Dessus, nous sommes en mesure d'identifier la bonne table.
- Extraire les informations dans DataFrame: Ici, nous devons parcourir chaque ligne (tr) puis affecter chaque élément de tr (td) à une variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... et l'ajouter à une liste. Regardons d'abord la structure HTML du tableau (Je n'extrairai pas d'informations pour l'en-tête du tableau
) 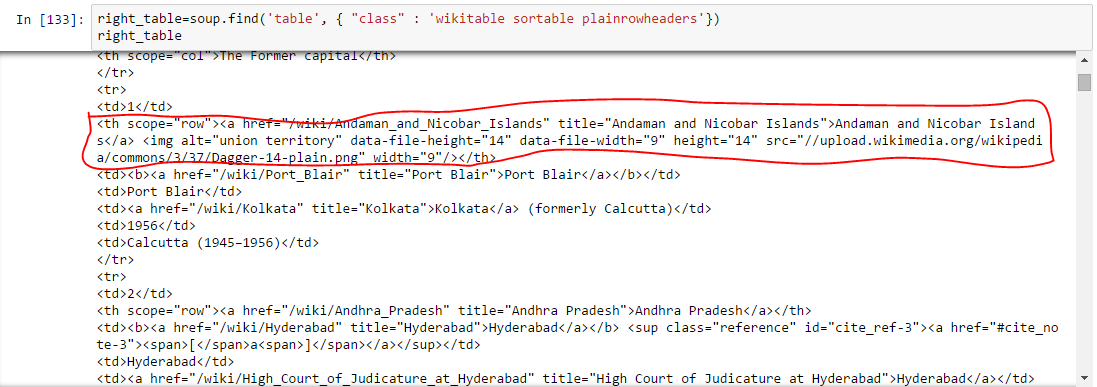 Dessus, vous remarquerez peut-être que le deuxième élément de
est à l'intérieur de l'étiquette , non , donc il faut s'en occuper. À présent, pour accéder à la valeur de chaque élément, nous utiliserons l'option « chercher (texte = vrai) » avec chaque élément. Voyons le code: #Générer des listes A=[] B=[] C=[] D=[] E=[] F=[] G=[] pour la ligne dans right_table.findAll("tr"): cellules = ligne.findAll('td') états=ligne.findAll('th') #Pour stocker les données de la deuxième colonne si len(cellules)==6: #Extraire uniquement le corps du tableau sans titre A.append(cellules[0].trouve(texte=Vrai)) B.append(États[0].trouve(texte=Vrai)) C.append(cellules[1].trouve(texte=Vrai)) D.append(cellules[2].trouve(texte=Vrai)) E.append(cellules[3].trouve(texte=Vrai)) F.append(cellules[4].trouve(texte=Vrai)) G.append(cellules[5].trouve(texte=Vrai))#importer des pandas pour convertir la liste en bloc de données importer des pandas au format pd df=pd.DataFrame(UNE,colonnes=['Nombre']) df['État/UT']=B df['Capital_Admin']=C df['Capital_Législative']=D df['Capital_Judiciaire']= E df['Année_Capitale']=F df['Ancienne_Capitale']=G df
Finalement, nous avons des données dans le bloc de données:
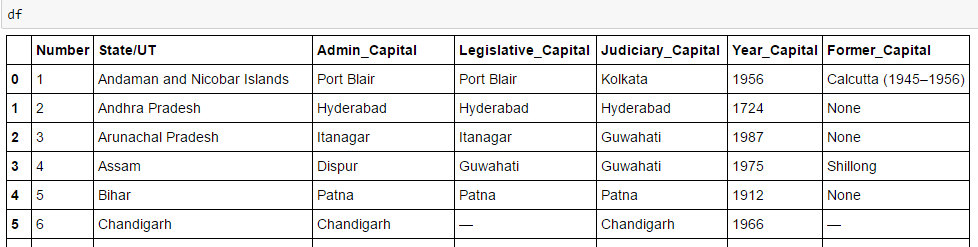
De la même manière, vous pouvez effectuer d'autres types de grattage Web en utilisant « Belle soupe". Cela réduira vos efforts manuels pour collecter les données des pages Web.. Vous pouvez également regarder les autres attributs comme .parent, .Contenu, .descendants y .next_sibling, .prev_sibling et divers attributs pour naviguer en utilisant le nom de la balise. Ceux-ci vous aideront à supprimer efficacement les pages Web.Mais, Pourquoi ne puis-je pas utiliser regex?
À présent, si vous connaissez les expressions régulières, vous pensez peut-être que vous pouvez écrire du code à l'aide de regex qui peut faire la même chose pour vous. J'avais certainement cette question. Dans mon expérience avec BeautifulSoup et regex faire la même chose, J'ai découvert:
- Le code écrit dans BeautifulSoup est généralement plus robuste que le code écrit avec des expressions régulières. Les codes écrits avec des expressions régulières doivent être modifiés avec toute modification des pages. Même BeautifulSoup en a besoin dans certains cas, c'est juste que BeautifulSoup est relativement mieux.
- Les expressions régulières sont beaucoup plus rapides que BeautifulSoup, généralement par un facteur de 100 donner le même résultat.
Donc, cela se résume à la vitesse par rapport à la robustesse du code et il n'y a pas de gagnant universel ici. Si les informations que vous recherchez peuvent être extraites avec de simples déclarations regex, vous devez aller de l'avant et les utiliser. Pour presque tous les travaux complexes, Je recommande généralement BeautifulSoup plus que regex.
Note finale
Dans cet article, nous analysons les méthodes de grattage Web qu'ils utilisent « BelleSoupe » Oui « urllib2 » et Python. Nous avons également étudié les bases du HTML et effectué un grattage Web étape par étape tout en résolvant un défi.. Je vous recommande de pratiquer cela et de l'utiliser pour collecter des données à partir de pages Web.
Trouvez-vous utile cet article? Partagez vos opinions / pensées dans la section des commentaires ci-dessous.
Noter: Nous avons également créé un cours gratuit pour cet article: Introduction au web scraping avec Python. Ce format structuré vous aidera à mieux apprendre.
Si vous aimez ce que vous venez de lire et souhaitez continuer à apprendre sur l'analyse, abonnez-vous à nos e-mails, Suivez-nous sur Twitter ou comme le nôtre page le Facebook.
En rapport




- La liste HTML commence par

