
[*]
Cet article a été publié dans le cadre du Blogathon sur la science des données
introduction
conditions météorologiques. Ce sont des données d'une taille et d'une complexité si grandes qu'aucun des outils traditionnels de gestion des données ne pourra les stocker ou les traiter efficacement.
Le Big Data est un domaine qui traite des façons d'enquêter, analyser et extraire des informations de manière cohérente à partir d'une grande quantité de données structurées ou non structurées.
Python possède plusieurs fonctions intégrées pour prendre en charge le traitement des données, qu'elles soient de petite ou de très grande taille. Ces fonctions prennent en charge le traitement des données non structurées et non conventionnelles. C'est la raison pour laquelle les data scientists et les entreprises de Big Data préfèrent choisir Python pour le traitement des données, ya que se considera uno de los requisitos más importantes en Big Data.
También existen otras tecnologías que pueden procesar Big Data de manera más eficiente que Python. Son Hadoop y Spark.
Hadoop
Hadoop es la mejor solución para almacenar y procesar Big Data porque Hadoop almacena archivos enormes en forma de système de fichiers distribuéUn système de fichiers distribué (DFS) permet le stockage et l'accès aux données sur plusieurs serveurs, facilitant la gestion de grands volumes d'informations. Ce type de système améliore la disponibilité et la redondance, car les fichiers sont répliqués à différents endroits, ce qui réduit le risque de perte de données. En outre, permet aux utilisateurs d'accéder aux fichiers depuis différentes plateformes et appareils, favorisant la collaboration et.... (HDFSHDFS, o Système de fichiers distribués Hadoop, Il s’agit d’une infrastructure clé pour stocker de gros volumes de données. Conçu pour fonctionner sur du matériel commun, HDFS permet la distribution des données sur plusieurs nœuds, Garantir une disponibilité élevée et une tolérance aux pannes. Son architecture est basée sur un modèle maître-esclave, où un nœud maître gère le système et les nœuds esclaves stockent les données, faciliter le traitement efficace de l’information..) Hadoop sin especificar ningún esquema.
C'est très évolutif, ya que se puede agregar cualquier número de nodos para mejorar el rendimiento. Dans Hadoop, los datos están altamente disponibles si también se produce algún fallo de hardware.
Étincelle – étincelle
Spark también es una buena opción para procesar una gran cantidad de conjuntos de datos estructurados o no estructurados, ya que los datos se almacenan en clústeres. Spark concevra de stocker la plus grande quantité de données possible en mémoire afin qu'elles débordent sur le disque. Il stockera une partie de l'ensemble de données en mémoire et, donc, le reste des données sur le disque.
Le premier choix de langage du Data Scientist moderne est Python et à la fois Hadoop et Spark fournissent des API Python qui offrent un traitement Big Data et permettent également un accès facile aux plateformes Big Data.
Source de l'image: par moi
Besoin de Python dans le Big Data
1. Open source:
Python est un langage de programmation open source développé sous une licence open source approuvée par l'OSI, ce qui le rend librement utilisable et distribuable, même pour un usage commercial.
Python est un langage interprété de haut niveau et à usage général. Il n'est pas nécessaire de le compiler pour l'exécuter. Un programme appelé interpréteur exécute du code Python sur presque tous les types de systèmes. Cela implique qu'un développeur peut modifier le code et voir rapidement les résultats.
2. Facile à apprendre:
Python est très facile à apprendre, tout comme la langue anglaise. Sa syntaxe et son code sont faciles et lisibles même pour les débutants. Python a de nombreuses applications comme le développement d'applications web, science des données, apprentissage automatique, etc.
Python nous permet d'écrire des programmes avec moins de lignes de code que la plupart des autres langages de programmation. La popularité de Python augmente rapidement en raison de sa simplicité.
3. Bibliothèques de traitement de données:
Lorsqu'il s'agit de traitement de données, Python a un
rico conjunto de herramientas con una amplia gama de beneficios. Como es un lenguaje de código abierto, es fácil de aprender y también mejora continuamente. Python consiste en una lista de varias bibliotecas útiles para el procesamiento de datos y también integradas con otros lenguajes (comme Java), así como con estructuras existentes. Python es más rico en bibliotecas que mejoran aún más su funcionalidad.
4. Compatibilidad con Hadoop y Spark:
El marco de Hadoop está escrito en lenguaje Java; cependant, los programas de Hadoop se pueden codificar en lenguaje Python o C ++. Podemos escribir programas como MapReduce en lenguaje Python, aunque no es el requisito para traducir el código a archivos jar de Java.
Spark proporciona una API de Python llamada PySpark lanzada por la comunidad de Apache Spark para admitir Python con Spark. Usando PySpark, uno simplemente integrará y trabajará con RDD dentro del lenguaje de programación Python también.
Spark viene con un shell de Python interactivo llamado PySpark shell. Este shell de PySpark es responsable del enlace entre la API de Python y el núcleo de chispa y de inicializar el contexto de chispa. PySpark también se puede iniciar directamente desde la línea de comando dando algunas instrucciones para uso interactivo.
5. Velocidad y eficiencia:
Python es un lenguaje de programación de alto nivel poderoso y eficiente. Ya sea para desarrollar una aplicación o trabajar para resolver cualquier problema comercial a través de la ciencia de datos, Python lo tiene cubierto todos estos límites. Python fonctionne toujours bien pour optimiser la productivité et l'efficacité des développeurs.
Nous pouvons créer rapidement un programme qui peut résoudre un problème commercial et répondre à un besoin pratique. Cependant,
Il est possible que les solutions n'atteignent pas la performance optimisée de Python tout en étant développées rapidement.
6. Scalable et flexible:
Python est le langage le plus populaire pour le ML / IA en raison de sa commodité. La flexibilité de Python permet également d'instrumenter le code Python pour former l'évolutivité du ML / L'IA possiblement sans nécessiter une expérience approfondie du système distribué et de nombreux changements de code invasifs. Donc, les utilisateurs de ML / L'IA obtient les avantages de l'évolutivité à travers tout le cluster avec un effort minimal.
Composants de Hadoop:
Il y a principalement deux composants de Hadoop:
- HDFS (Système de fichiers distribué Hadoop)
- Petite carte
Système de fichiers distribué Hadoop
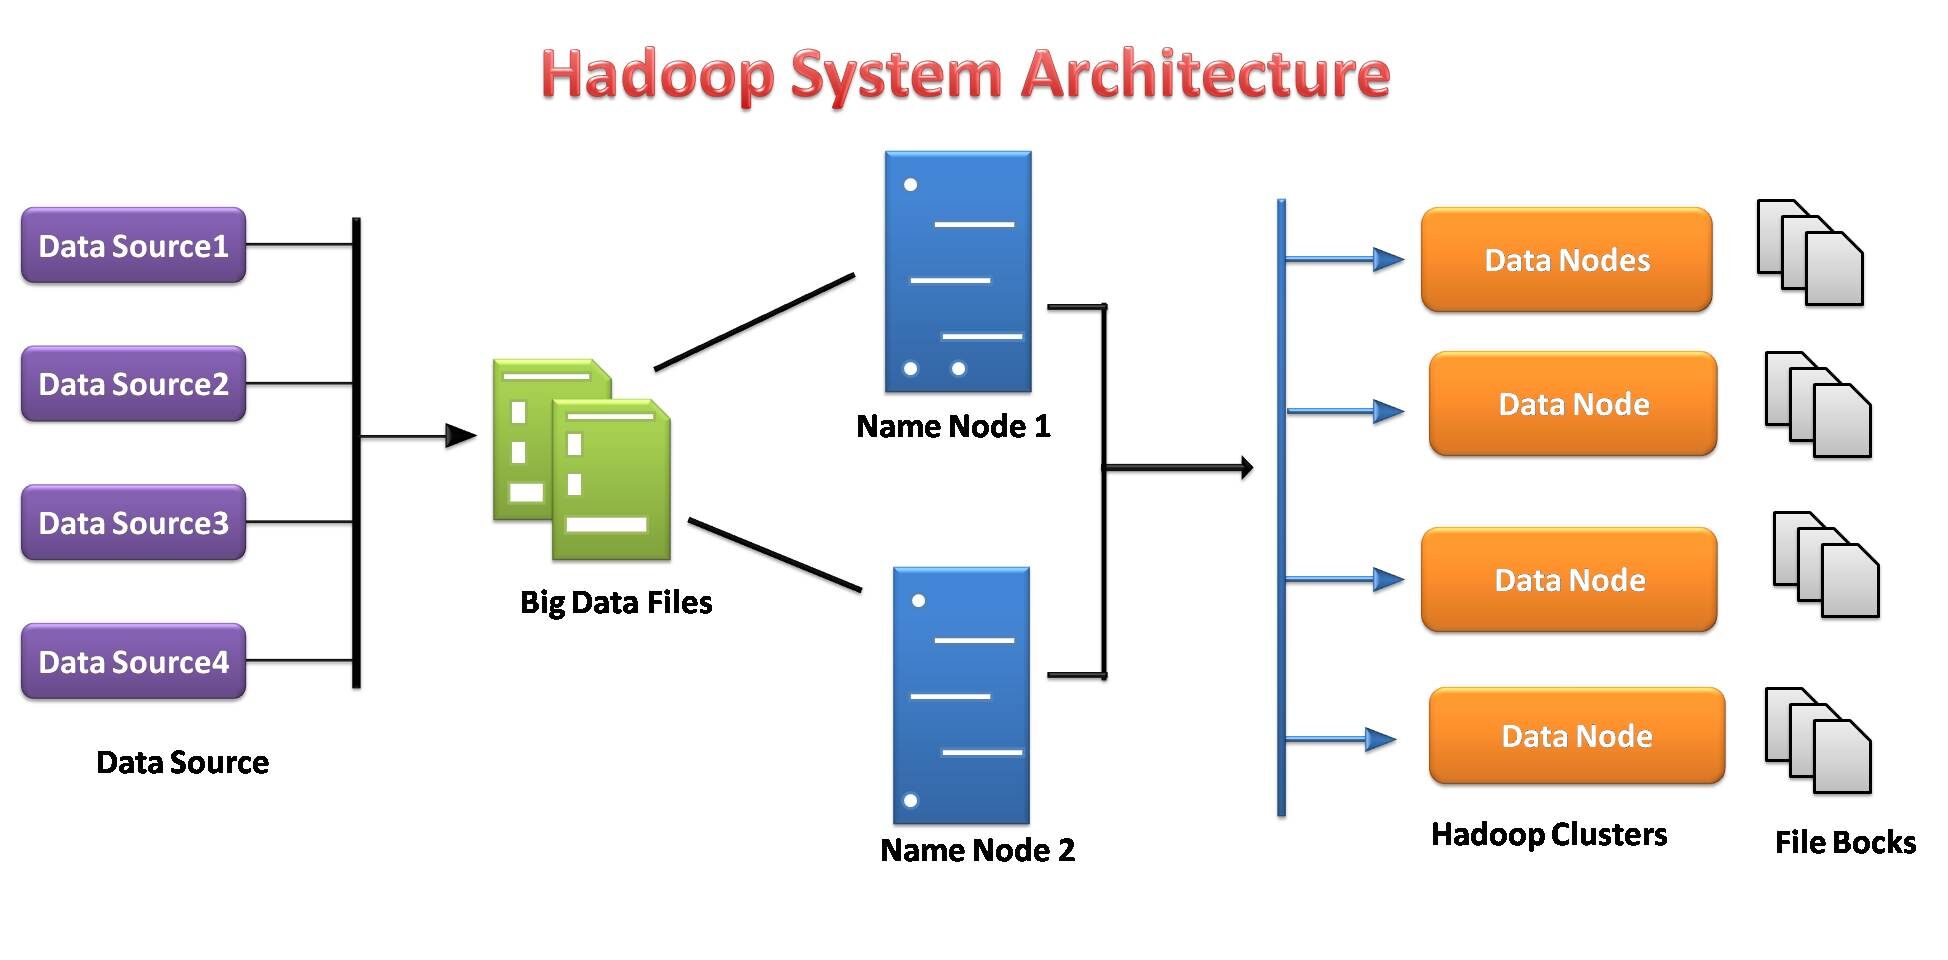
Le système de fichiers Hadoop a été développé sur la base du modèle de système de fichiers distribué. Fonctionne avec du matériel basique. Contrairement aux différents systèmes distribués, HDFS est extrêmement tolérant aux pannes et est conçu avec du matériel économique.
HDFS peut stocker une grande quantité de données et offre également un accès plus facile à ces données. Pour stocker une quantité aussi grande de données, les fichiers sont stockés sur plusieurs systèmes. Ces fichiers sont stockés de manière redondante pour protéger le système contre de potentielles pertes de données en cas de panne. En outre, HDFS offre des applications pour le traitement parallèle.
- Il est responsable du stockage des données dans un grappeUn cluster est un ensemble d’entreprises et d’organisations interconnectées qui opèrent dans le même secteur ou la même zone géographique, et qui collaborent pour améliorer leur compétitivité. Ces regroupements permettent le partage des ressources, Connaissances et technologies, favoriser l’innovation et la croissance économique. Les grappes peuvent couvrir une variété d’industries, De la technologie à l’agriculture, et sont fondamentaux pour le développement régional et la création d’emplois.... comme le stockage et le traitement distribués.
- Les serveurs de données du nœudNodo est une plateforme digitale qui facilite la mise en relation entre les professionnels et les entreprises à la recherche de talents. Grâce à un système intuitif, Permet aux utilisateurs de créer des profils, Partager des expériences et accéder à des opportunités d’emploi. L’accent mis sur la collaboration et le réseautage fait de Nodo un outil précieux pour ceux qui souhaitent élargir leur réseau professionnel et trouver des projets qui correspondent à leurs compétences et à leurs objectifs.... le serveur de nom et le nœud de connaissance permettent aux utilisateurs de vérifier simplement l'état du cluster.
- Chaque bloc est répliqué plusieurs fois par défaut 3 fois. Les répliques sont stockées sur des nœuds complètement différents.
- Hadoop Streaming agit comme un pont entre votre code Python et, donc, le HDFS basé sur Java, et vous permet d'accéder facilement aux clusters Hadoop et d'exécuter des tâches de CarteRéduireMapReduce est un modèle de programmation conçu pour traiter et générer efficacement de grands ensembles de données. Propulsé par Google, Cette approche décompose le travail en tâches plus petites, qui sont répartis entre plusieurs nœuds d’un cluster. Chaque nœud traite sa partie, puis les résultats sont combinés. Cette méthode vous permet de faire évoluer les applications et de gérer d’énormes volumes d’informations, fondamental dans le monde du Big Data.....
- HDFS fournit des autorisations et une authentification des fichiers.
Source de l'image: par moi
Installation de Hadoop sur Google Colab
Hadoop est un cadre de traitement des données basé sur la programmation Java. Installons la configuration de Hadoop étape par étape sur Google Colab. Il y a deux manières, la première chose est que nous devons installer Java sur nos machines et la deuxième est que nous installons Java sur Google Colab, donc il n'est pas nécessaire d'installer Java sur nos machines. Comme nous utilisons Google Colab, nous choisissons la deuxième façon d'installer Hadoop:
# Installer Java
!apt-get install openjdk-8-jdk-headless -qq > /dev/null
#create java home variable
import os
os.environ["JAVA_HOME"] = "/usr/lib/jvm/java-8-openjdk-amd64"
os.environ["SPARK_HOME"] = "/content/spark-3.0.0-bin-hadoop3.2"
Paso 1: installer Hadoop
#télécharger Hadoop
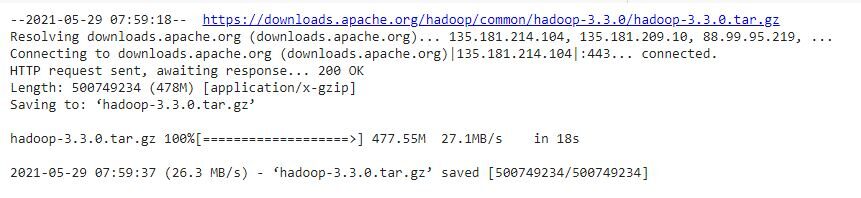
!wget https://downloads.apache.org/hadoop/common/hadoop-3.3.0/hadoop-3.3.0.tar.gz
#nous utiliserons la commande tar avec l'option -x pour extraire, -z pour décompresser,
#-v pour une sortie détaillée, et -f pour spécifier que nous extrayons à partir d'un fichier
!tar -xzvf hadoop-3.3.0.tar.gz
#copying the hadoop file to user/local
!cp -r hadoop-3.3.0/ /usr/local/
Paso 2: configurar la variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... de inicio de Java
#finding  the default Java path
!readlink -f /usr/bin/java | sed "s:bin/java::"
Paso 3: Ejecuta Hadoop
#Running Hadoop
!/usr/local/hadoop-3.3.0/bin/hadoop
!mkdir ~/input
!cp /usr/local/hadoop-3.3.0/etc/hadoop/*.xml ~/input
!/usr/local/hadoop-3.3.0/bin/hadoop jar /usr/local/hadoop-3.3.0/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.0.jar grep ~/input ~/grep_example 'allowed[.]*'
À présent, Google Colab está listo para implementar HDFS.
Petite carte
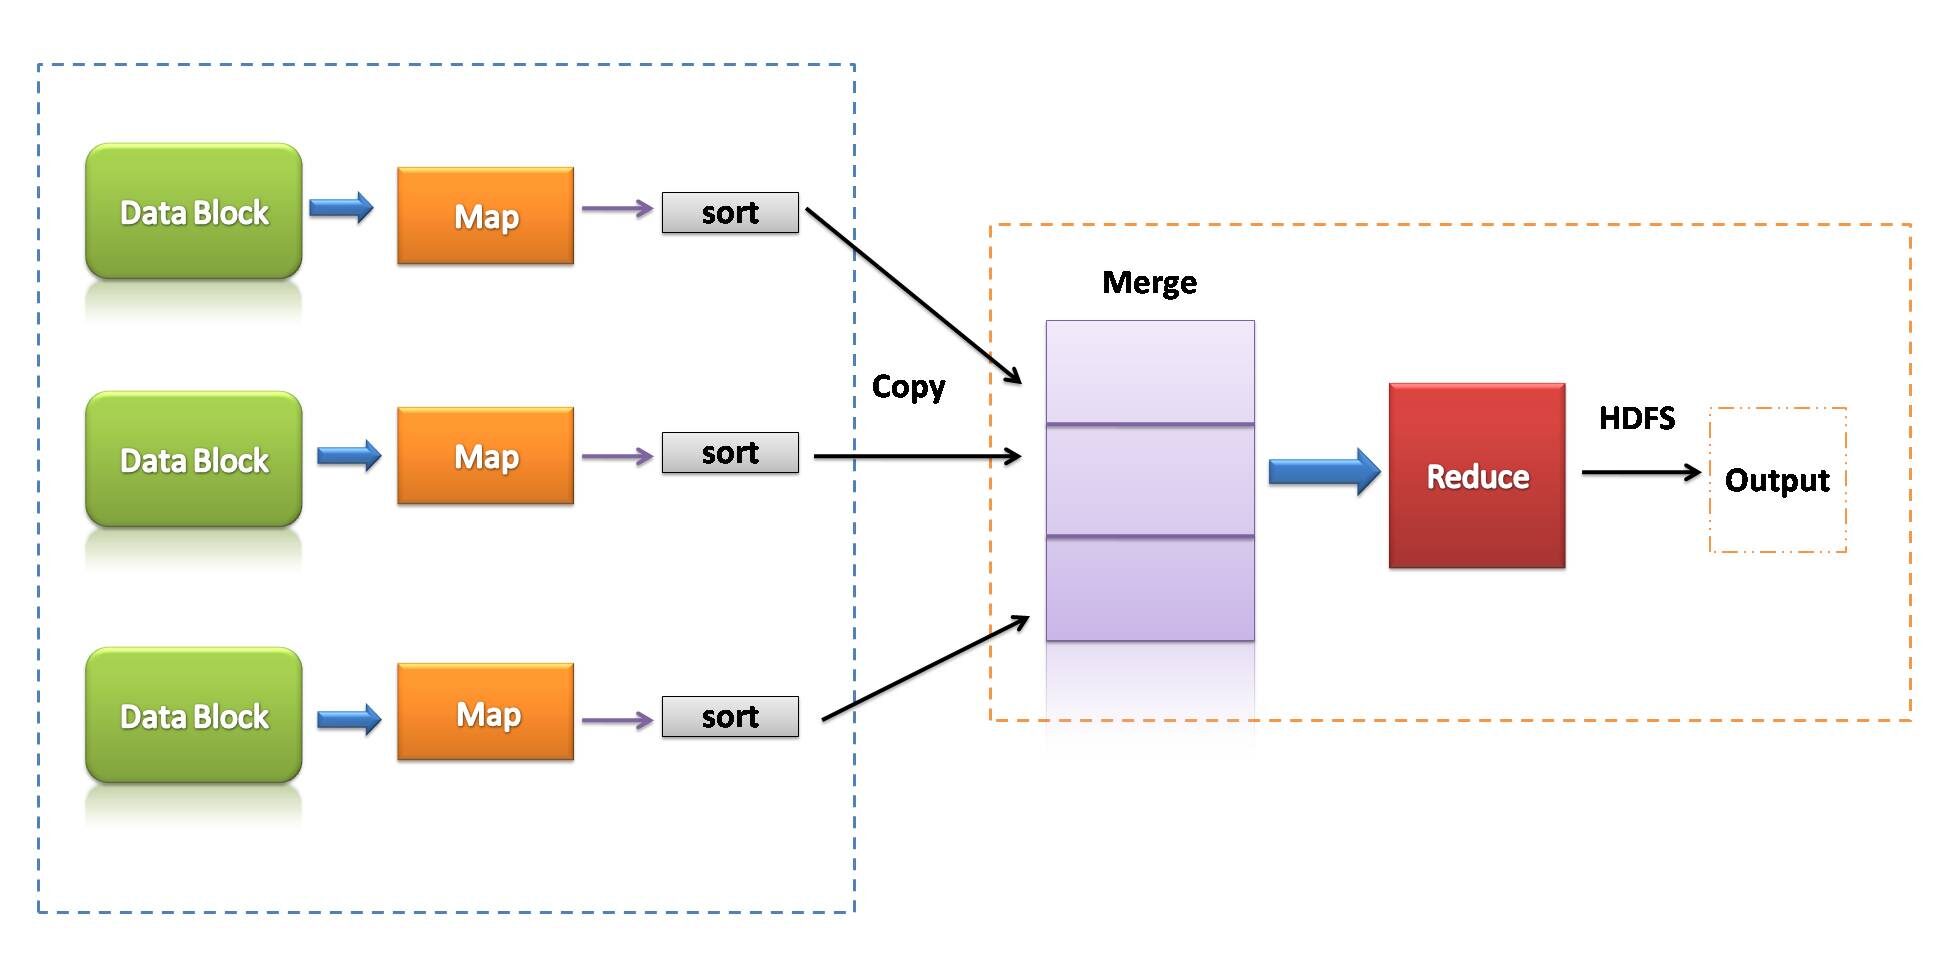
MapReduce es un modelo de programación que se asocia con la implementación del procesamiento y la generación de grandes conjuntos de datos con la ayuda de reglas algorítmicas distribuidas en paralelo en un clúster.
Un programa MapReduce consiste en un procedimiento de mapa, que realiza filtrado y clasificación, y una técnica de reducción, que realiza una operación de esquema.
Source de l'image: par moi
- MapReduce podría ser un marco de procesamiento de datos para procesar datos en el clúster.
- Dos fases consecutivas: mapear y reducir.
- Cada tarea de mapa opera en partes separadas de datos.
- Después del mapa, el reductor trabaja con los datos generados por el asignador en los nodos de datos distribuidos.
- MapReduce usó E / S de disco para realizar operaciones con datos.
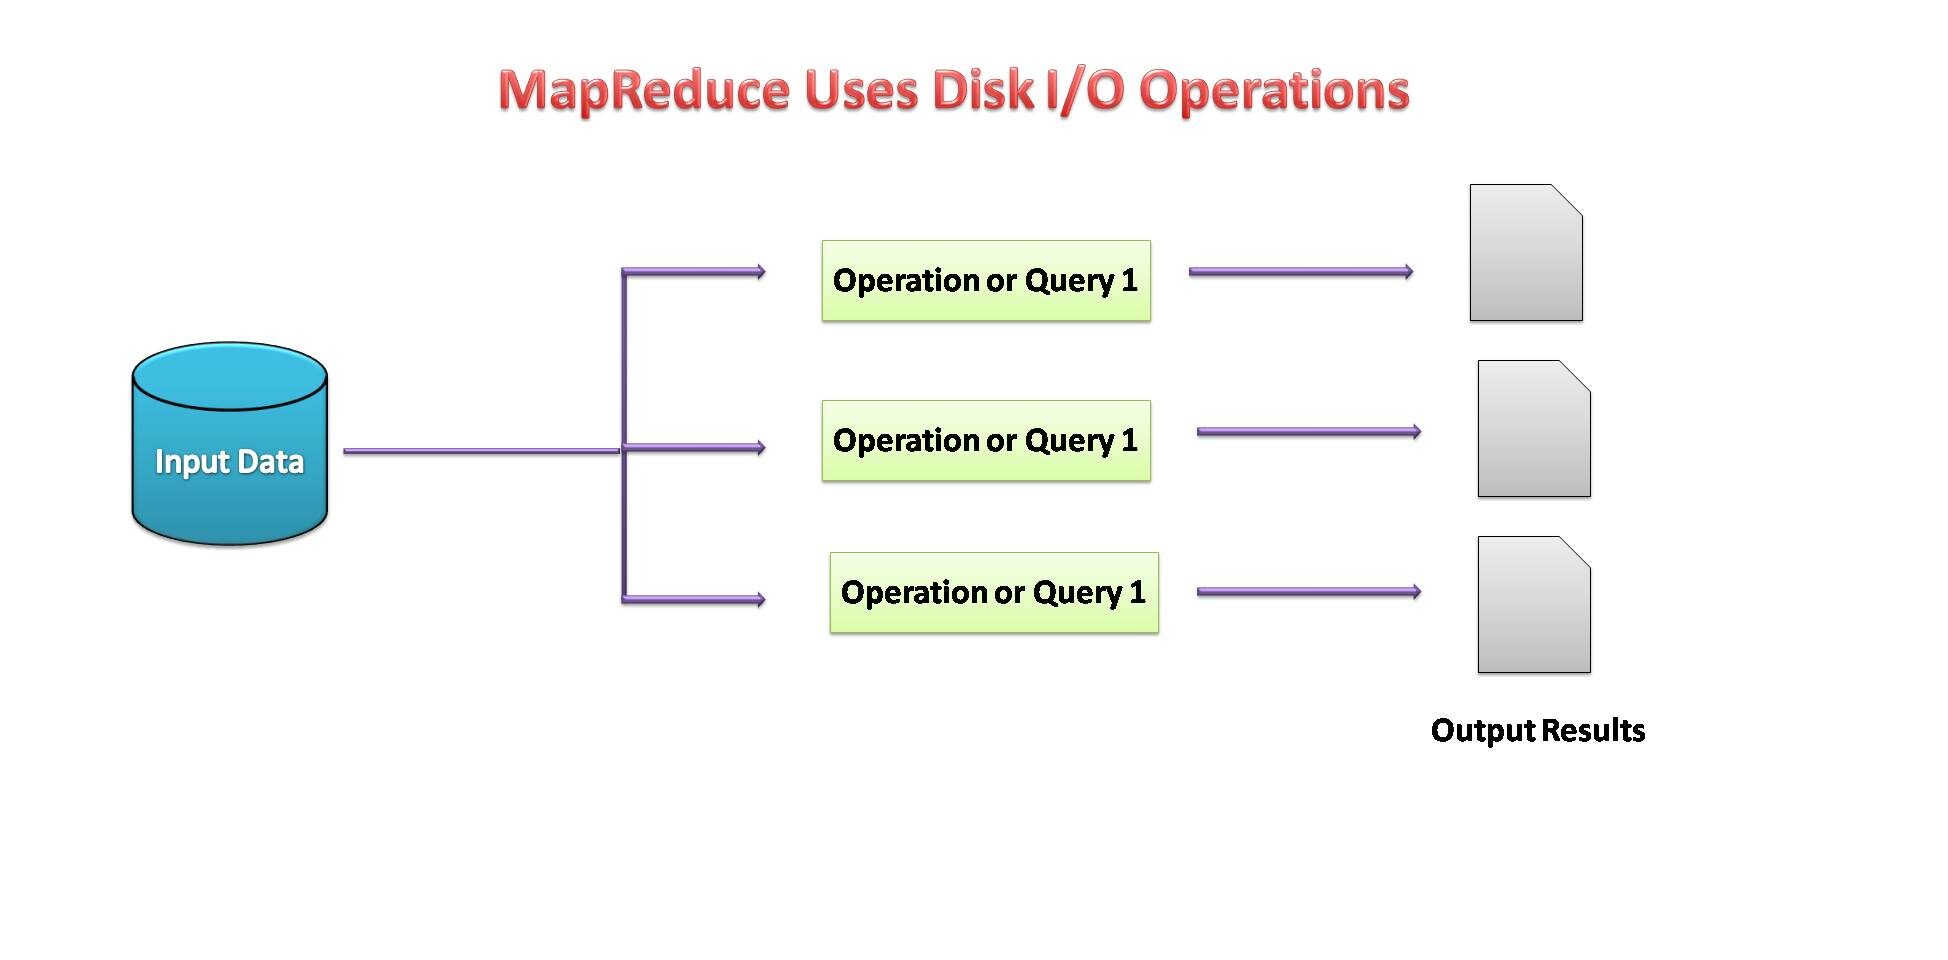
Source de l'image: par moi
Apache SparkApache Spark est un moteur de traitement de données open source qui permet l'analyse de grands volumes d'informations de manière rapide et efficace. Sa conception est basée sur la mémoire, ce qui optimise les performances par rapport à d'autres outils de traitement par lots. Spark est largement utilisé dans les applications de big data, apprentissage automatique et analyse en temps réel, grâce à sa facilité d'utilisation et....
Apache Spark est un moteur d'analyse de données open source pour le traitement à grande échelle de données structurées ou non structurées. Pour travailler avec Python, y compris les fonctionnalités de Spark, la communauté Apache Spark avait lancé un outil appelé PySpark.
L'API Spark Python (PySpark) révèle le modèle de programmation Spark à Python. Usando PySpark, nous pouvons travailler avec des RDD dans le langage de programmation Python. Ceci est attribuable à une bibliothèque connue sous le nom de Py4j qui peut permettre cela.
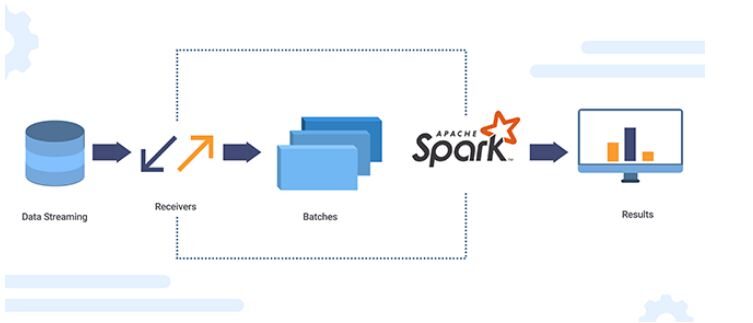
Source de l'image: XanonStack
Jeux de données distribués résilients (RDD)
Les concepts sur les jeux de données distribués résilients (RDD) fils:
- L'approche principale de la programmation Spark est RDD.
- Spark est extrêmement tolérant aux pannes. Il possède des collections d'objets distribués dans un cluster qui peuvent fonctionner en parallèle.
- Al usar Spark, il peut se rétablir automatiquement d'une panne de machine.
- Nous pouvons créer un RDD en copiant les éléments d'une collection existante ou en faisant référence à un ensemble de données stocké à l'extérieur.
- Il existe deux types d'opérations effectuées par les RDD: transformations et actions.
- L'opération de transformation utilise un ensemble de données existant pour en créer un nouveau. Exemple: mapper, filtre, unir.
- Les actions sont effectuées sur l'ensemble de données et renvoient la valeur au programme du contrôleur. Exemple: réduire, raconter, rassembler, sauvegarder.
Si la disponibilité de la mémoire semble insuffisante, les données sont écrites sur un disque comme MapReduce.
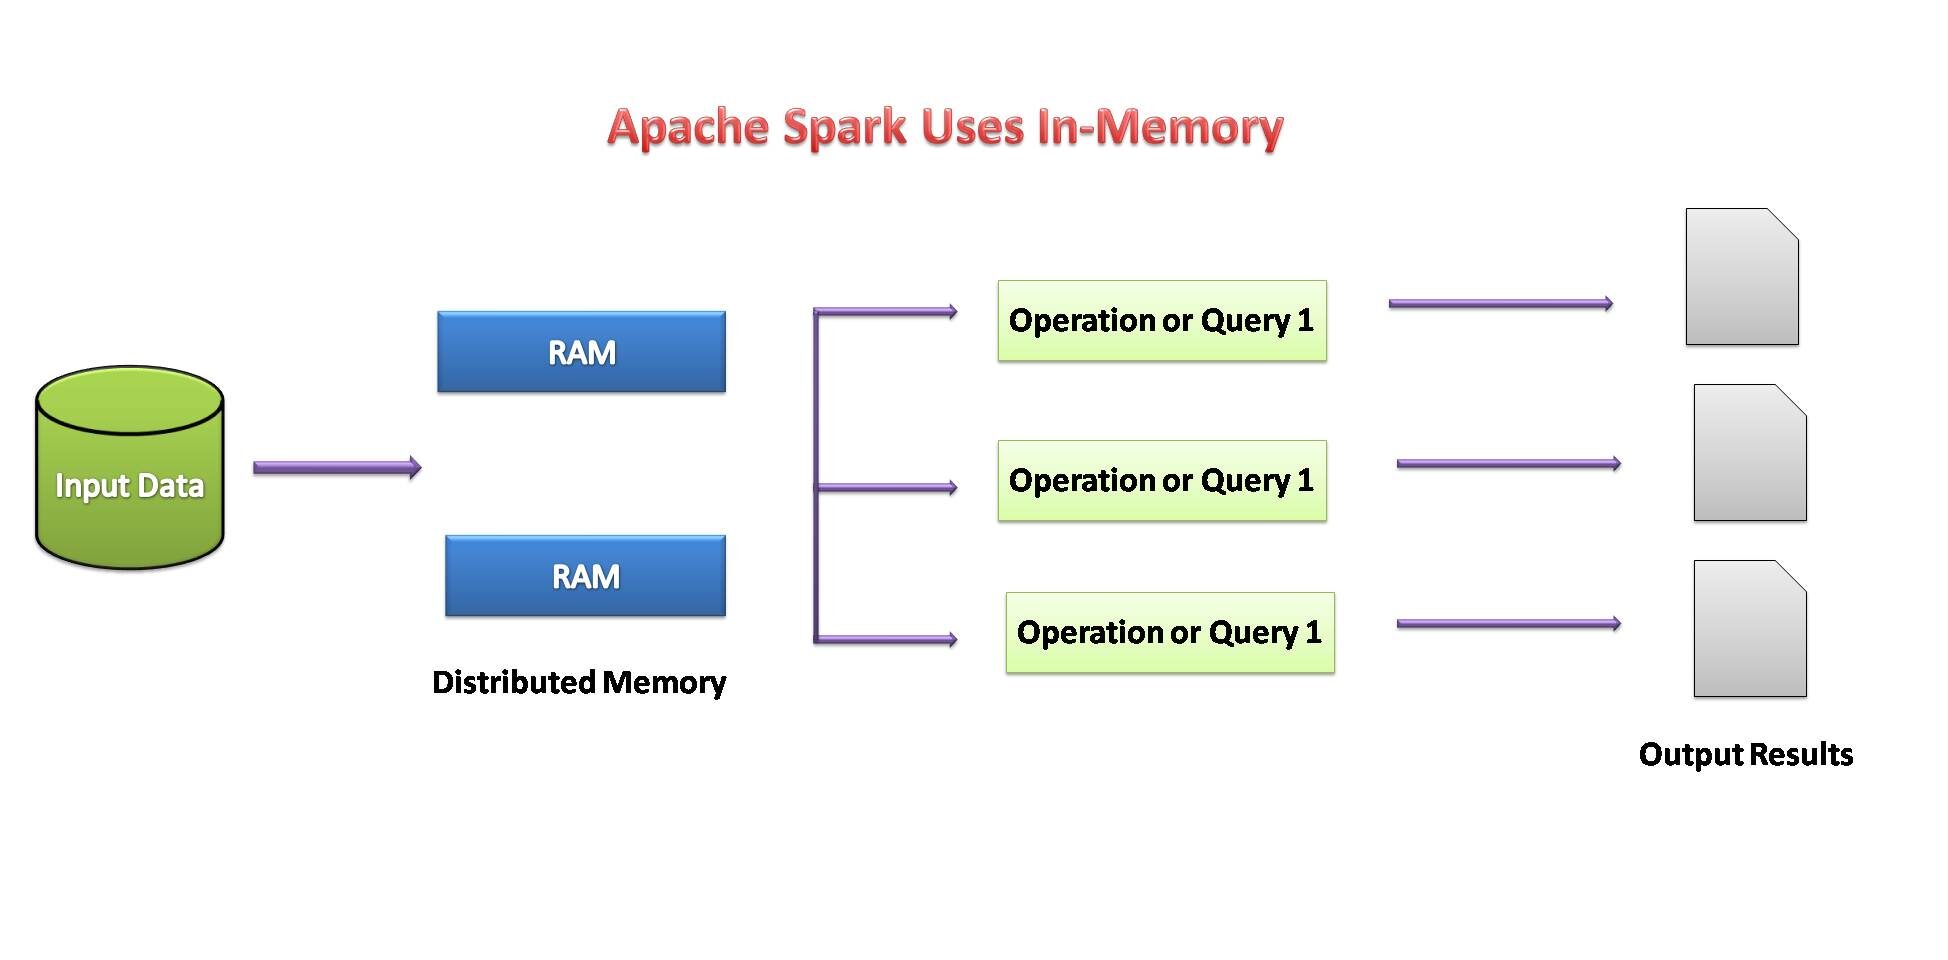
Source de l'image: par moi
Installation de Spark sur Google Colab:
Spark est un cadre de traitement de données efficace. podemos instalarlo fácilmente en el colab de Google.
# Installer Java
!apt-get install openjdk-8-jdk-headless -qq > /dev/null
#Install spark (change the version number if needed)
!wget -q https://archive.apache.org/dist/spark/spark-3.0.0/spark-3.0.0-bin-hadoop3.2.tgz
#Unzip the spark file to the current folder
!tar xf spark-3.0.0-bin-hadoop3.2.tgz
#Définissez votre dossier spark dans votre chemin d'environnement système.
importer le système d'exploitation
os.environ["JAVA_HOME"] = "/usr/lib/jvm/java-8-openjdk-amd64"
os.environ["SPARK_HOME"] = "/content/spark-3.0.0-bin-hadoop3.2"
#Installez findspark en utilisant pip
!pip install -q findspark
#Spark pour Python (pyspark)
!pip installer pyspark
#importing pyspark
import pyspark
#importing sparksessio
from pyspark.sql import SparkSession
#creating a sparksession object and providing appName
spark=SparkSession.builder.appName("local[*]").obtenirOuCréer()
#printing the version of spark
print("Version d'Apache Spark: ", spark.version)

À présent, Google Colab est prêt à déployer Spark en Python.
Avantages d'Apache Spark:
- Spark est de 10 une 100 fois plus rapide que Hadoop MapReduce lorsqu'il s'agit de traitement de données.
- A sImplémente un cadre de traitement de données et des API interactives pour Python qui aident à accélérer le développement d'applications.
- En outre, c'est plus efficace car il dispose de multiples outils pour les opérations analytiques complexes.
- Il peut s'intégrer facilement avec l'infrastructure Hadoop existante.
conclusion:
Dans ce blog, nous étudions comment Python peut également devenir un outil bon et efficace pour le traitement du Big Data. Nous pouvons intégrer tous les outils de Big Data avec Python, ce qui rend le traitement des données plus facile et rapide. Python est devenu une option appropriée non seulement pour la science des données mais aussi pour le traitement du Big Data.
Merci pour la lecture. S'il vous plaît laissez-moi savoir s'il y a des commentaires ou des commentaires.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





