
Vue d'ensemble
- Qu'est-ce que K signifie Clustering?
- Implémentation de K signifie Clustering
- WCSS et méthode du coude pour trouver le nombre de clusters
- Implémentation Python du clustering K Means
K signifie est l'un des algorithmes d'apprentissage automatique non supervisé les plus populaires utilisés pour résoudre les problèmes de classification. K signifie que les données non étiquetées sont séparées en plusieurs groupes, appelés clusters, basé sur des caractéristiques similaires, modèles communs.
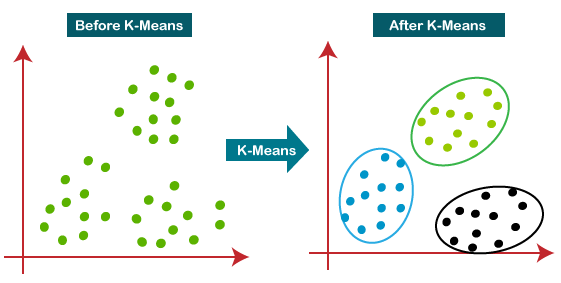
Table des matières
- Qu'est-ce que le regroupement?
- Que signifie l'algorithme K?
- Implémentation schématique du clustering KMeans
- Choisissez le bon nombre de clusters
- Implémentation Python
1. Qu'est-ce que le regroupement?
Supposons que nous ayons un nombre N d'ensembles de données multivariées non étiquetées de divers animaux tels que les chiens, gatos, des oiseaux, etc. La technique pour séparer les ensembles de données en plusieurs groupes, basé sur des caractéristiques et des caractéristiques similaires, ça s'appelle le regroupement..
Les groupes qui se forment sont appelés clusters. La technique de clustering est utilisée dans plusieurs domaines, comme la reconnaissance d'images, filtrage anti-spam
Le regroupement en clusters est utilisé dans l'algorithme de Apprentissage non superviséL’apprentissage non supervisé est une technique d’apprentissage automatique qui permet aux modèles d’identifier des modèles et des structures dans des données sans étiquettes prédéfinies. Grâce à des algorithmes tels que les k-moyennes et l’analyse en composantes principales, Cette approche est utilisée dans une variété d’applications, comme la segmentation de la clientèle, Détection d’anomalies et compression de données. Sa capacité à révéler des informations cachées en fait un outil précieux dans le... en apprentissage automatique comme les données multivariées peuvent être séparées en plusieurs groupes, sans aucun superviseur, basé sur un modèle commun caché dans les ensembles de données.
2. Que signifie l'algorithme K?
L'algorithme Kmeans est un algorithme itératif qui divise un groupe de n ensembles de données en k sous-groupes / clusters basés sur la similarité et leur distance moyenne par rapport au centre de gravité de ce sous-groupe / formé en particulier..
K, voici le nombre prédéfini de clusters que l'algorithme va former. Si K = 3, signifie que le nombre de clusters qui seront formés à partir de l'ensemble de données est 3
Étapes de l'algorithme K moyen
Le fonctionnement de l'algorithme K-Means est expliqué dans les étapes suivantes:
Paso 1: Sélectionnez la valeur de K pour décider du nombre de clusters à former.
Paso 2: Sélectionnez K points aléatoires qui agiront comme centroïde.
Paso 3: Mapper chaque point de données, en fonction de sa distance par rapport à des points choisis au hasard (centre de gravité), au centroïde le plus proche / close qui formeront les groupes prédéfinis.
Paso 4: placer un nouveau centroïde de chaque groupe.
Paso 5: Répéter l'étape 3, qui réaffecte chaque point de données au nouveau centroïde le plus proche de chaque groupe.
Paso 6: En cas de réaffectation, aller à l'étape 4; au contraire, aller à l'étape 7.
Paso 7: FINIR
3. Implémentation schématique de K signifie clustering
PASO 1:Choisissons le nombre k de clusters, c'est-à-dire, K = 2, pour séparer l'ensemble de données et les placer dans différents clusters respectifs. Nous en choisirons quelques 2 points aléatoires qui agiront comme centroïdes pour former le groupe.
PASO 2: Nous allons maintenant assigner chaque point de données à un Diagramme de dispersionLe nuage de points est un outil graphique utilisé en statistiques pour visualiser la relation entre deux variables. Il se compose d’un ensemble de points dans un plan cartésien, où chaque point représente une paire de valeurs correspondant aux variables analysées. Ce type de graphique vous permet d’identifier des modèles, Tendances et corrélations possibles, faciliter l’interprétation des données et la prise de décision sur la base des informations visuelles présentées.... basé sur sa distance par rapport au point K ou au centroïde le plus proche. Cela se fera en traçant un médianLa médiane est une mesure statistique qui représente la valeur centrale d’un ensemble de données ordonnées. Pour le calculer, Les données sont organisées de la plus basse à la plus élevée et le numéro au milieu est identifié. S’il y a un nombre pair d’observations, La moyenne des deux valeurs fondamentales est calculée. Cet indicateur est particulièrement utile dans les distributions asymétriques, puisqu’il n’est pas affecté par les valeurs extrêmes.... entre les deux centroïdes. Considérez l'image suivante:
PASO 3: les points à gauche de la ligne sont proches du centre de gravité bleu et les points à droite de la ligne sont proches du centre de gravité jaune. Celui de gauche forme un groupe avec un centre de gravité bleu et celui de droite avec un centre de gravité jaune..
PASO 4:répéter le processus en choisissant un nouveau centre de gravité. Pour choisir les nouveaux centroïdes, on va trouver le nouveau centre de gravité de ces centroïdes, indiqué ci-dessous:
PASO 5: Ensuite, nous allons réaffecter chaque point de données au nouveau centroïde. Nous allons répéter le même processus précédent (en utilisant une ligne médiane). Le point de données jaune sur le côté bleu de la ligne médiane sera inclus dans le groupe bleu
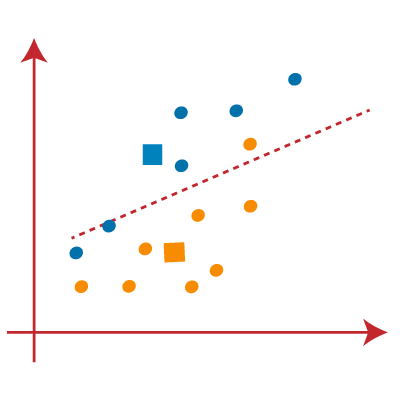
PASO 6: Comme la réaffectation a été faite, nous allons répéter l'étape précédente de recherche de nouveaux centroïdes.
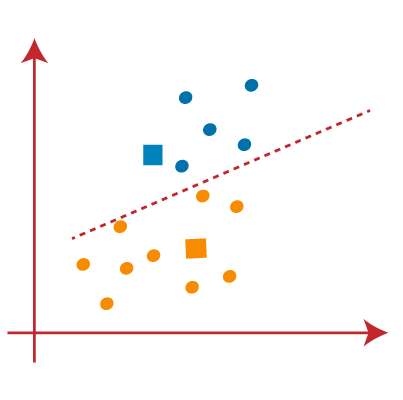
PASO 7: Nous allons répéter le processus précédent pour trouver le centre de gravité des centroïdes, comme il est montré dans ce qui suit.
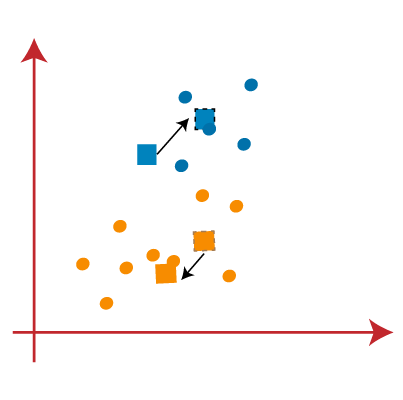
PASO 8: Après avoir trouvé les nouveaux centroïdes, nous allons à nouveau tracer la ligne médiane et réaffecter les points de données, comme dans les étapes précédentes.
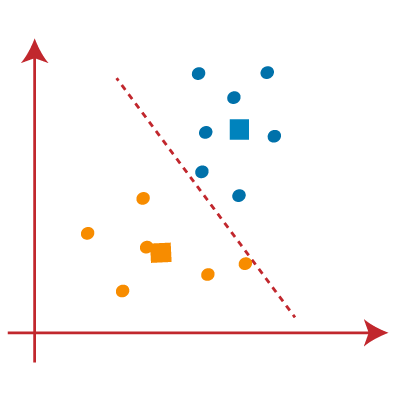
PASO 9: Finalement, nous allons séparer les points en fonction de la ligne médiane, de sorte que deux groupes soient formés et qu'aucun point différent ne soit inclus dans un seul groupe.
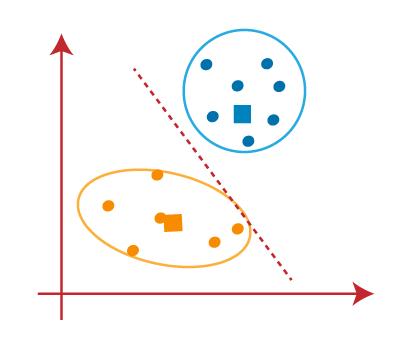
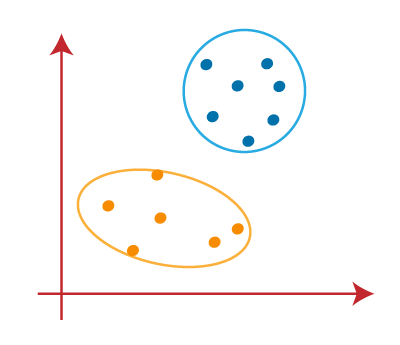
Le dernier groupe qui se forme est le suivant
4. Choisissez le bon nombre de clusters
Le nombre de clusters que nous choisissons pour l'algorithme ne doit pas être aléatoire. Chaque cluster est formé en calculant et en comparant les distances moyennes de chaque point de données au sein d'un cluster à partir de son centroïde.
Nous pouvons choisir le nombre correct de clusters à l'aide de la méthode de la somme des carrés intra-clusters dans le grappeUn cluster est un ensemble d’entreprises et d’organisations interconnectées qui opèrent dans le même secteur ou la même zone géographique, et qui collaborent pour améliorer leur compétitivité. Ces regroupements permettent le partage des ressources, Connaissances et technologies, favoriser l’innovation et la croissance économique. Les grappes peuvent couvrir une variété d’industries, De la technologie à l’agriculture, et sont fondamentaux pour le développement régional et la création d’emplois.... (WCSS).
WCSS Représente la somme des carrés des distances des points de données dans chaque groupe à partir de son centroïde.
L'idée principale est de minimiser la distance entre les points de données et le centroïde des clusters. Le processus est itéré jusqu'à atteindre une valeur minimale pour la somme des distances.
Pour trouver la valeur optimale des clusters, méthode du coude suivre les étapes ci-dessous:
1 Exécutez le regroupementLe "regroupement" Il s’agit d’un concept qui fait référence à l’organisation d’éléments ou d’individus en groupes ayant des caractéristiques ou des objectifs communs. Ce procédé est utilisé dans diverses disciplines, y compris la psychologie, Éducation et biologie, faciliter l’analyse et la compréhension de comportements ou de phénomènes. Dans le domaine de l’éducation, par exemple, Le regroupement peut améliorer l’interaction et l’apprentissage entre les élèves en encourageant le travail.. de K-moyennes sur un ensemble de données donné pour différentes valeurs de K (qui vont de 1 Al 10).
2 Pour chaque valeur de K, calcule la valeur WCSS.
3 Tracer un graphique / courbe entre les valeurs WCSS et le nombre respectif de clusters K.
4 Le point aigu de courbure ou un point (qui ressemble à une articulation du coude) du cadre comme un bras, sera considéré comme le meilleur / valeur K optimale
5. Implémentation Python
Importer les bibliothèques pertinentes
importer numpy en tant que np
importer des pandas au format pd
importer statsmodels.api en tant que sm
importer matplotlib.pyplot en tant que plt
importer seaborn comme sns
sns.set()
à partir de sklearn.cluster importer KMeans
Chargement des données
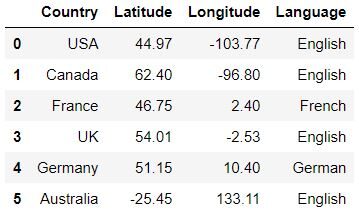
données = pd.read_csv('Countryclusters.csv')
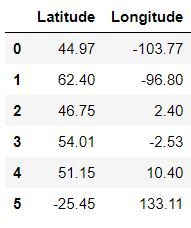
Les données
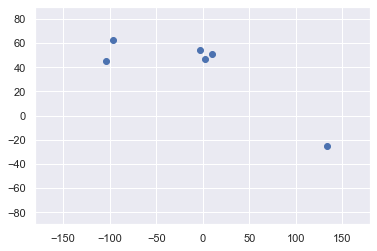
Représenter graphiquement les données
plt.scatter(Les données['Longitude'],Les données['Latitude'])
plt.xlim(-180,180)
plt.ylim(-90,90)
plt.show()
Sélectionnez la fonction
 x = données.iloc[:,1:3] # 1t pour les lignes et second pour les colonnes
X
Regroupement
kmeans = KMeans(3)
signifie.fit(X)
Regroupement des résultats
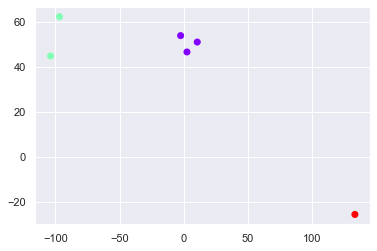
clusters_identifiés = kmeans.fit_predict(X)
clusters_identifiés
déployer([1, 1, 0, 0, 0, 2])
data_with_clusters = data.copy()
data_with_clusters['Clusters'] = clusters_identifiés
plt.scatter(data_with_clusters['Longitude'],data_with_clusters['Latitude'],c=data_with_clusters['Clusters'],cmap='rainbow')
Essayez une autre méthode (trouver dans. Des groupes à sélectionner)
WCSS et méthode du coude
wcss=[]
pour moi à portée(1,7):
kmeans = KMeans(je)
kmeans.fit(X)
wcss_iter = kmeans.inertia_
wcss.append(wcss_iter)

nombre_clusters = plage(1,7)
plt.plot(nombre_clusters,wcss)
plt.titre('Le titre du coude')
plt.xlabel('Nombre de clusters')
plt.ylabel('WCSS')
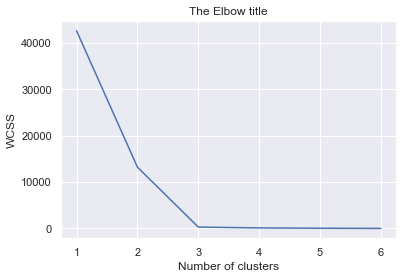
nous pouvons choisir 3 bien sûr. conglomérats, cette méthode montre quel est le bon nombre de clusters.
Sur ce je termine ce blog.
Bonjour à tous, Namaste
Je m'appelle Pranshu Sharma et je suis un passionné de science des données
Merci beaucoup d'avoir pris votre temps précieux pour lire ce blog.. N'hésitez pas à signaler toute erreur (après tout, je suis apprenti) et fournir les commentaires correspondants ou laisser un commentaire.
Dhanyvaad !!
Retour d'information:
Courrier électronique: [email protégé]
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





