
introduction
Python est l'un des langages les plus appréciés dans le monde de la science des données et de l'apprentissage automatique. Il est facile à apprendre et offre de nombreuses bibliothèques et packages et dispose d'une bonne communauté de développeurs. Les bibliothèques et packages Python sont un ensemble de modules qui nous facilitent la vie. Il y a plus de 137,000 bibliothèques Python et 198,826 packages Python conçus pour faciliter l'expérience de programmation quotidienne des ingénieurs. Ces bibliothèques et packages sont prévus pour une variété d'applications avancées.
En tant qu'enthousiaste de la science des données, j'ai vu des personnes qui parlent toujours de certaines bibliothèques célèbres comme pandas pour la manipulation de données et NumPy, pour la visualisation des données matplotlib, marin, plotly et bien d'autres, pour modéliser scikit-learn, TensorFlow, etc. Dans cet article, je ne vais pas couvrir ces bibliothèques car il existe déjà des tonnes de blogs disponibles, consultez mon article sur les bibliothèques Python les plus utilisées ici. Mais dans cet article, je vais couvrir quelques perles cachées de bibliothèques Python qui sont inconnues dans le monde de la science des données. Voici quelques bibliothèques importantes que vous pouvez consulter sur 2021.
Ces bibliothèques incluent des fonctionnalités comme gérer les valeurs manquantes de manière organisée, gérer les emojis, convertir les nombres en ints et floats, outils d'intelligence de visualisation, modélisation de séries temporelles et bien plus encore. Couvre un large éventail de sujets, du traitement du langage naturel à la visualisation des données et aux séries temporelles. Alors commençons.
Table des matières
- Missingo
- Emot
- Bamboolib
- ppscore
- AutoViz
- Numérateur
- PyFlux
- Texte Flash
Missingo
Les ensembles de données du monde réel contiennent généralement de nombreuses valeurs manquantes et nulles. Cela peut être dû à un certain nombre de raisons, comme la fuite de données, les données ne sont pas disponibles, etc. Parfois, il est très irritant de traiter ce type de données désordonnées. Ces données désordonnées nécessitent une attention particulière avant de les introduire dans les algorithmes d'apprentissage automatique, car ces algorithmes ne gèrent pas les valeurs manquantes.
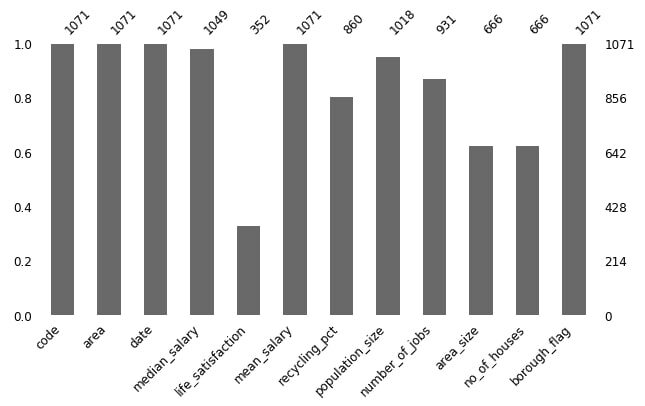
Nous avons besoin d'une meilleure approche pour gérer ces valeurs manquantes. Voici la magie de la bibliothèque Python appelée disparu. Elle nous aide à traiterles valeurs manquantes grâce aux visualisations de données d'une manière beaucoup meilleure. Ceci est basé sur matplotlib. A partir d'avril 2021, il y a quatre types de graphiques pour comprendre la répartition des données manquantes, a savoir, les graphique à barresLe graphique à barres est une représentation visuelle des données qui utilise des barres rectangulaires pour montrer des comparaisons entre différentes catégories. Chaque barre représente une valeur et sa longueur est proportionnelle à celle-ci. Ce type de graphique est utile pour visualiser et analyser les tendances, faciliter l’interprétation des informations quantitatives. Il est largement utilisé dans diverses disciplines, tels que les statistiques, Marketing et recherche, En raison de sa simplicité et de son efficacité..... carte de chaleurUn "carte de chaleur" est une représentation graphique qui utilise des couleurs pour montrer la densité des données dans une zone spécifique. Couramment utilisé dans l’analyse de données, Etudes marketing et comportementales, Ce type de visualisation vous permet d’identifier rapidement les modèles et les tendances. Par des variations chromatiques, Les cartes thermiques facilitent l’interprétation de grands volumes d’informations, aider à prendre des décisions éclairées...., matrice et dendrogramme. Alors commençons.
Installation
pip install missingo
Importation de la bibliothèque
import missingo as msns
Dans le graphique à barres ci-dessous, vous pouvez voir le nombre de valeurs manquantes dans chaque colonne:
Pour plus d'informations, consulter la documentation officielle: Relier
Emot
Les émojis sont très courants dans les conversations. Lorsqu'il s'agit de tâches de traitement du langage naturel, il est très fastidieux de traiter les émojis. Voici une bibliothèque très utile pour se débarrasser des émoticônes dans les données textuelles. C'est une célèbre bibliothèque Python qui est très utile lorsque nous devons gérer les emojis et les émoticônes. Fonctionne bien avec Python 2 et Python 3. Prend une chaîne comme entrée et renvoie une liste de dictionnaires. Alors commençons.
Installation
pip install emot
Importation de la bibliothèque
import emot
Code
import emot
text = "J'aime Python 👨 :-)"
emot.emoji(texte)
[{'value': '👨', 'mean': ':homme:', 'location': [14, 14], 'flag': Vrai}]
emot.emoticons(texte)
{'value': [':-)'], 'location': [[16, 19]], 'mean': ['Sourire visage heureux'], 'flag': Vrai}
Pour plus d'informations, consulter la documentation officielle: Relier
Bamboolib
Analyser et visualiser l'information est l'interaction la plus significative et celle qui demande le plus de temps. Nous devons consacrer beaucoup de temps à rechercher de manière claire quel est le problème ici et ce qu'il essaie de dire. Nous utilisons différents types de bibliothèques Python pour visualiser les exemples et les anomalies dans le jeu de données afin de nous familiariser avec celui-ci.
Bamboolib est GUI pour pandas DataFrames qui permet à quiconque de travailler avec Python dans Jupyter Notebook ou JupyterLab. Bamboolib est une bibliothèque profondément intelligente et très utile pour examiner, imaginer et contrôler l'information.
En réalité, même une personne sans connaissances en programmation peut l'utiliser pour extraire des fragments de connaissances à partir des informations, car aucune expérience en codage n'est nécessaire. Bamboolib n'est pas open source, ce qui implique que vous devez acheter Bamboolib pour l'utiliser, mais il offre un formulaire d'essai gratuit de 14 jours afin que vous puissiez l'explorer complètement et percevoir comment il peut être très précieux pour vous.
Installation
pip install bamboolib
Importation de la bibliothèque
import bamboolib
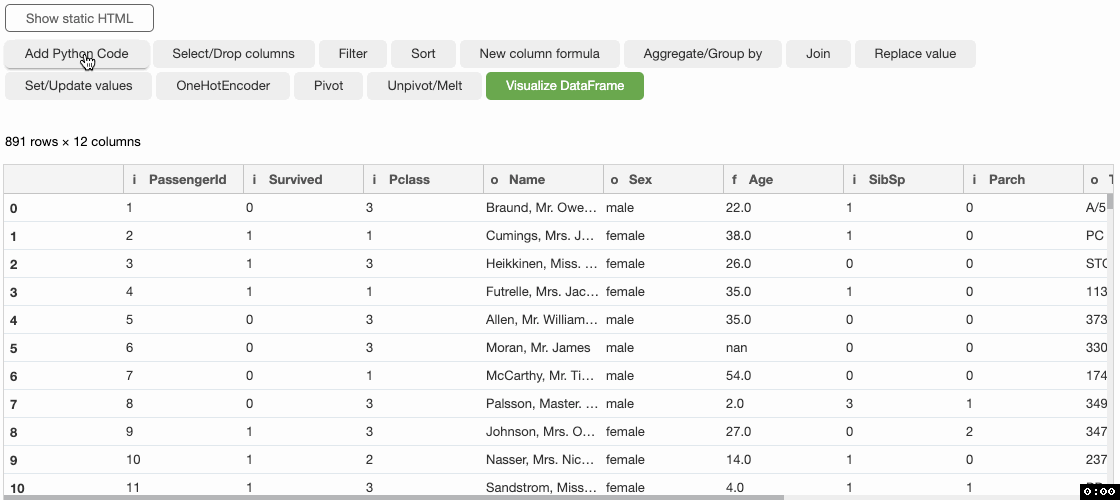
Pour plus d'informations, consulter la documentation officielle: Relier
Ppscore
Le score complet de ppscore est le Predictive Power Score. Cette bibliothèque Python a été créée par les développeurs de Bamboolib. Le Predictive Power Score est une alternative à la matrice de corrélation. Ce score est asymétrique et peut détecter les relations linéaires ou non linéaires entre deux colonnes dans notre jeu de données. Así que comencemos con esta biblioteca.
Installation
pip install ppscore
Importation de la bibliothèque
import ppscore
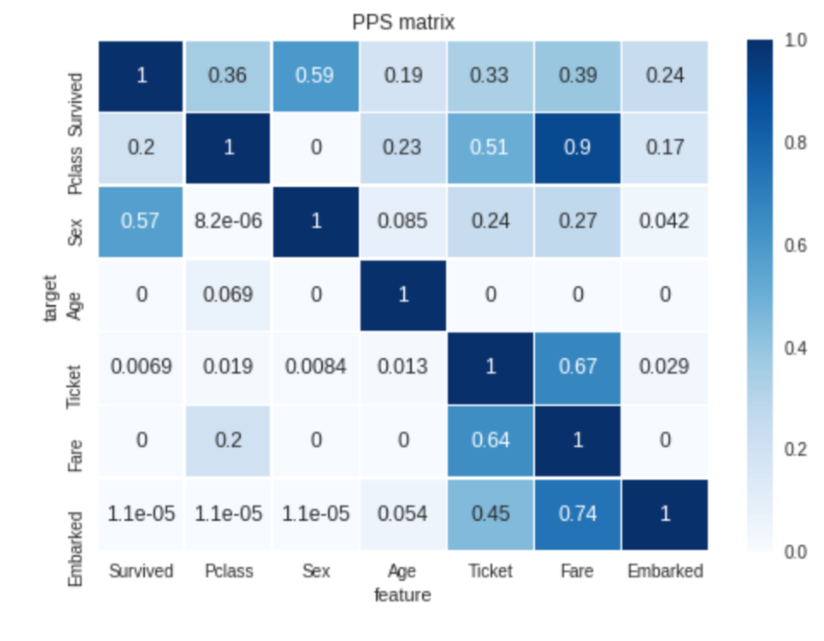
Pour plus d'informations, consulter la documentation officielle: Relier
AutoViz
Es la biblioteca de Python más subestimada que se ha utilizado à realizar análisis de datos exploratorios. Esta biblioteca visualiza automáticamente cualquier tipo de conjunto de datos, incluidos también grandes conjuntos de datos. Hermosa Las visualizaciones se pueden dibujar con un solo código.. Solo debes proporcionar tu archivo de datos (SMS, JSONJSON, o Notation d’objet JavaScript, Il s’agit d’un format d’échange de données léger, facile à lire et à écrire pour les humains, et facile à analyser et à générer pour les machines. Il est couramment utilisé dans les applications Web pour envoyer et recevoir des informations entre un serveur et un client. Sa structure est basée sur des paires clé-valeur, ce qui le rend polyvalent et largement adopté dans le développement de logiciels.. o CSV) y automáticamente lo visualizará. Simplemente cargue sus datos y AutoViz le proporcionará automáticamente los gráficos correctos que le ayudarán a obtener información en cuestión de segundos. Alors commençons.
Installation
pip installer autoviz
Importation de la bibliothèque
import autoviz
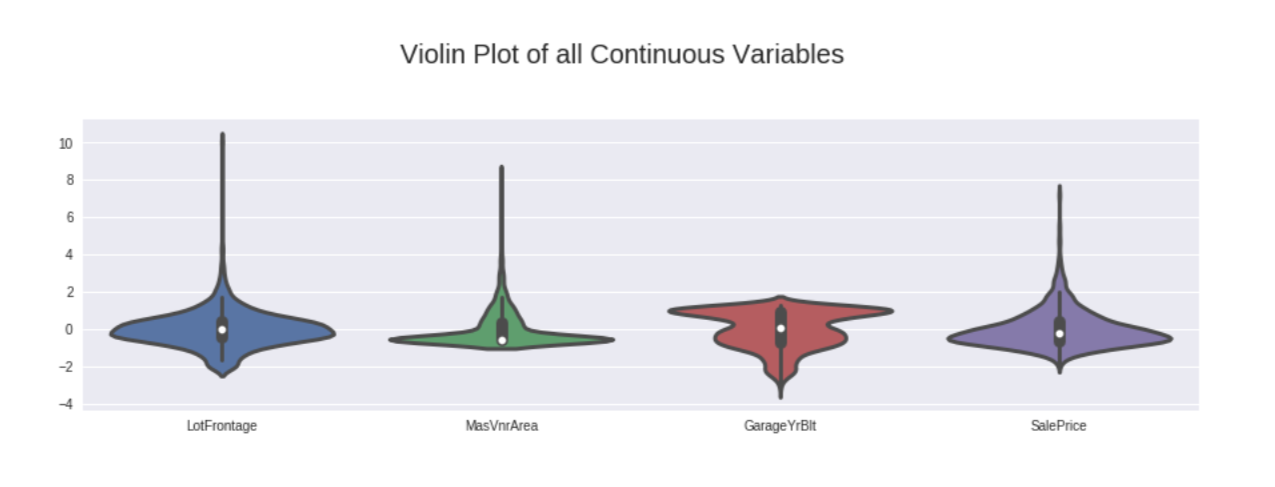
Pour plus d'informations, consulter la documentation officielle: Relier
Numérateur
Es un módulo de Python muy interesante para el procesamiento de texto. Ce convertit les nombres du langage naturel en flottants et en entiers. Ceci est un module très utile dans les tâches de traitement du langage naturel. À
Exemple, si convertit ‘quarante-deux’ dans 42, ‘un milliard et un’ dans 1000000001
etc. Alors, commençons.
Installation
pip install numerizer
Importation de la bibliothèque
from numerizer import numerize
Code
numerize(‘forty-two’)
'42'
numerize('one billion and one')
'1000000001'
Pour plus d'informations, consulter la documentation officielle: Relier
PyFlux
La recherche sur les séries chronologiques est possiblement le problème le plus fréquemment rencontré dans le domaine de l'apprentissage automatique. PyFlux est une bibliothèque open source en Python qui fonctionne de manière claire pour travailler sur des problèmes de séries chronologiques. La bibliothèque dispose d'un excellent ensemble de modèles de séries temporelles actuels qui incluent, mais ne se limitent pas aux modèles ARIMA, GARCH et VAR. Donc, PyFlux offre une approche probabiliste pour traiter la visualisation de la série temporelle. Alors commençons.
Installation
pip install pyflux
Importation de la bibliothèque
import pyflux
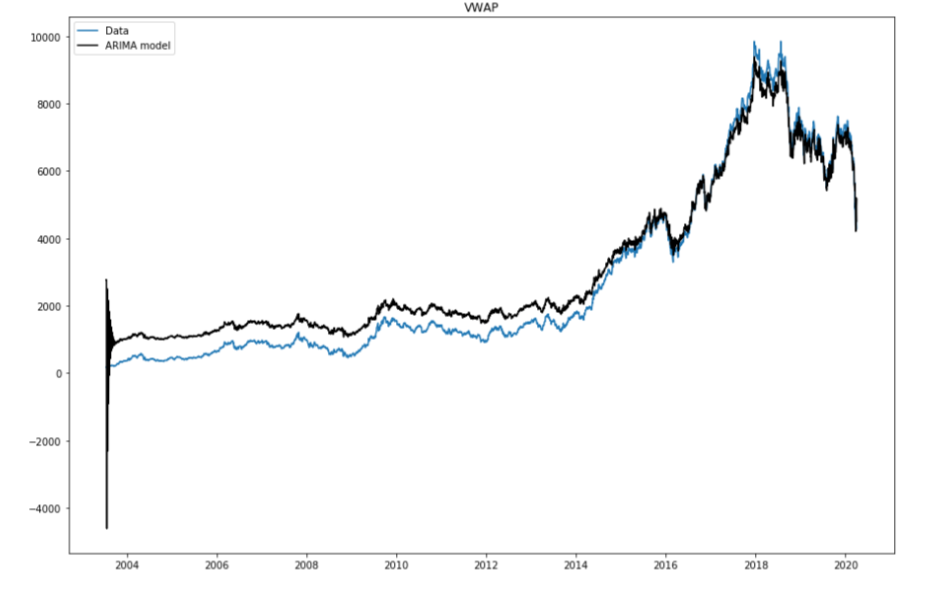
Pour plus d'informations, consulter la documentation officielle: Relier
FlashText
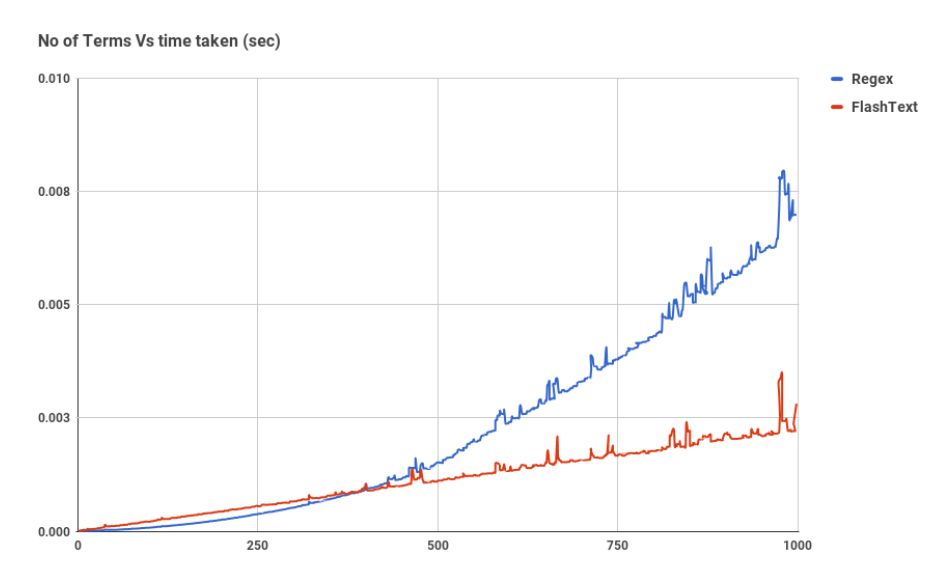
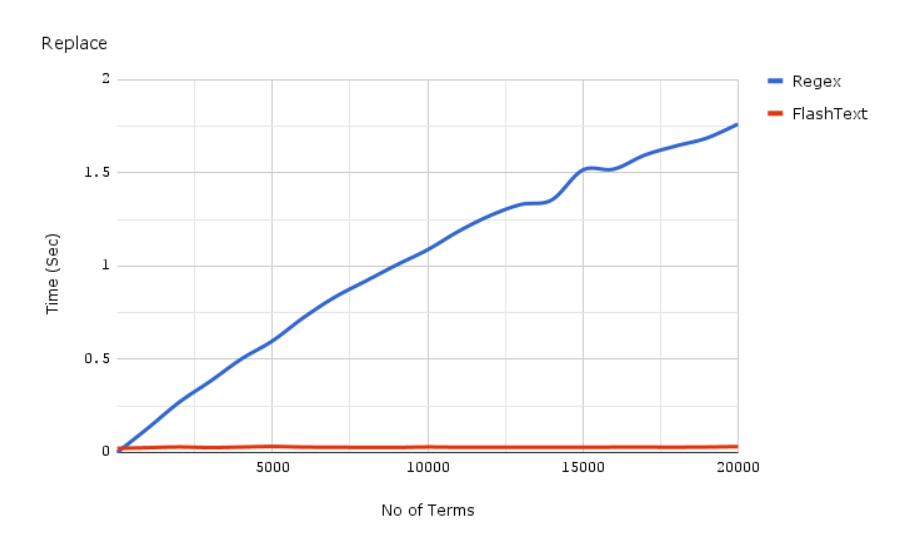
FlashText est une bibliothèque Python conçue explicitement chercher et remplacer des mots dans une chaîne. Actuellement, le fonctionnement de FlashText est qu'il nécessite un mot ou un résumé de mots et une chaîne. Les mots que FlashText appelle mots-clés sont examinés ou remplacés dans la chaîne.
Voyons des informations sur le fonctionnement de FlashText. Au moment où les mots-clés sont passés à FlashText pour rechercher ou remplacer, ils sont stockés sous la forme d'une structure de données Trie efficace pour les récupérations. Alors commençons.
Installation
pip install flashtext
Importation de la bibliothèque
import flashtext
Recherche:
Remplacement:
Pour plus d'informations, consulter la documentation officielle: Relier
Note finale
Vous pouvez consulter mes articles ici: Des articles
Merci d'avoir lu cet article et de votre patience.. Laissez-moi dans la section commentaire sur les commentaires. Partagez cet article, cela me donnera la motivation d'écrire plus de blogs pour la communauté de la science des données.
Identification de l'e-mail: gakshay1210@ gmail.com
Suivez-moi sur LinkedIn: LinkedIn
Los medios que se muestran en este artículo sobre los paquetes de Python no son propiedad de DataPeaker y se utilizan a discreción del autor.





