
introduction
Soy un gran admirador de R, Ce n’est pas un secret.. Je lui fais confiance depuis que j’ai appris les statistiques à l’université.. En réalité, R sigue siendo mi lenguaje preferido para proyectos de aprendizaje automático.
Tres cosas me atrajeron principalmente a R:
- La sintaxis fácil de entender y usar
- La increíble herramienta RStudio
- Paquetes R!
R ofrece una gran cantidad de paquetes para realizar tareas de aprendizaje automático, comprenant ‘dépliant’ para la manipulación de datos, ‘ggplot2’ pour la visualisation des données, ‘caret’ para la construcción de modelos ML, etc.
Incluso hay paquetes R para funciones específicas, que incluyen puntuación de riesgo crediticio, extracción de datos de sitios web, économétrie, etc. Hay una razón por la que R es querido entre los estadísticos de todo el mundo: la gran cantidad de paquetes R disponibles hace la vida mucho más fácil.
Dans cet article, Je vais vous montrer huit packages R qui sont passés inaperçus parmi les scientifiques des données, mais qui sont incroyablement utiles pour effectuer des tâches spécifiques d'apprentissage automatique. Pour commencer, J'ai inclus un exemple avec le code de chaque package.
crème, Votre amour pour R est sur le point de connaître une nouvelle révolution!
Les packages R que nous couvrirons dans cet article
J'ai largement divisé ces packages R en trois catégories:
- Visualisation de données
- Apprentissage automatique
- Autres packages R divers
- Bono: Encore plus de packages R!
Visualisation de données

R est un outil incroyable pour visualiser les données. La facilité avec laquelle nous pouvons générer toutes sortes de graphiques avec seulement une ou deux lignes de code? Vraiment un gain de temps.
R offre apparemment d'innombrables façons de visualiser vos données. Même lorsque j'utilise Python pour une tâche spécifique, je reviens à R pour explorer et visualiser mes données. Je suis sûr que la plupart des utilisateurs de R ressentent la même chose!
Voyons quelques packages R incroyables mais moins connus pour effectuer une analyse de données exploratoire.
C'est mon package de référence pour effectuer une analyse de données exploratoire. De la visualisation de la structure des données aux graphiques QQ, et même à la création de rapports pour votre ensemble de données, ce package fait tout.
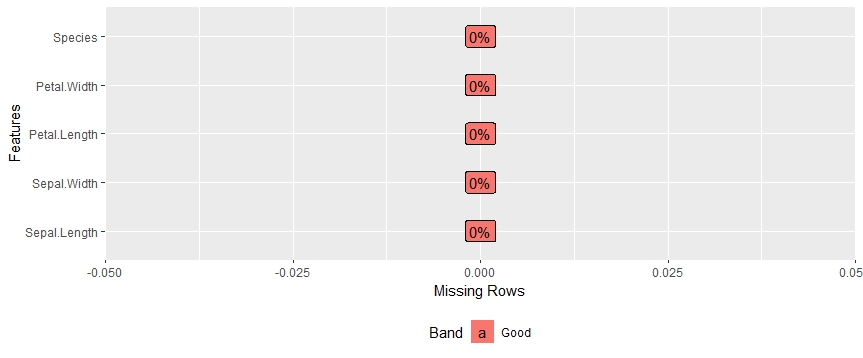
Voyons ce que DataExplorer peut faire avec un exemple. Supposons que nous ayons stocké nos données dans le Les données variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes..... À présent, nous voulons connaître le pourcentage de valeurs manquantes dans chaque caractéristique présente. C'est extrêmement utile lorsque nous travaillons avec des ensembles de données massifs et que calculer la somme des valeurs manquantes peut prendre beaucoup de temps.
Vous pouvez installer DataExplorer en utilisant le code suivant:
install.paquets("DataExplorer")
Voyons maintenant ce que DataExplorer peut faire pour nous:
une bibliothèque(DataExplorer)
Les données(iris)
intrigue_manquante(iris)
Nous obtenons un graphique vraiment intuitif pour les valeurs manquantes:
L'un de mes aspects préférés de DataExplorer est le rapport complet que nous pouvons générer en utilisant une seule ligne de code:
Creer un rapport(iris)
Voici les différents types de facteurs que nous obtenons dans ce rapport:

Vous pouvez accéder au rapport complet via ce lien. Un package TRÈS utile.
Que diriez-vous d'un plugin de ‘glisser-déposer’ pour générer des graphiques dans R? C’est juste – esquiver c'est un package qui vous permet de continuer à créer des graphiques sans avoir à les coder.
Esquisse est basé sur le package ggplot2. Cela signifie que vous pouvez explorer vos données de manière interactive dans l'environnement esquisse en générant des graphiques ggplot2.
Utilisez le code suivant pour installer et charger esquiver sur votre machine:
# From CRAN
install.packages("esquisse")

#Load the package in R
library(esquisse)

esquisse::esquisser() #helps in launching the add-in
Vous pouvez également lancer le complément esquisse via le menu RStudio. Voici à quoi ressemble l'interface utilisateur d'esquisse:
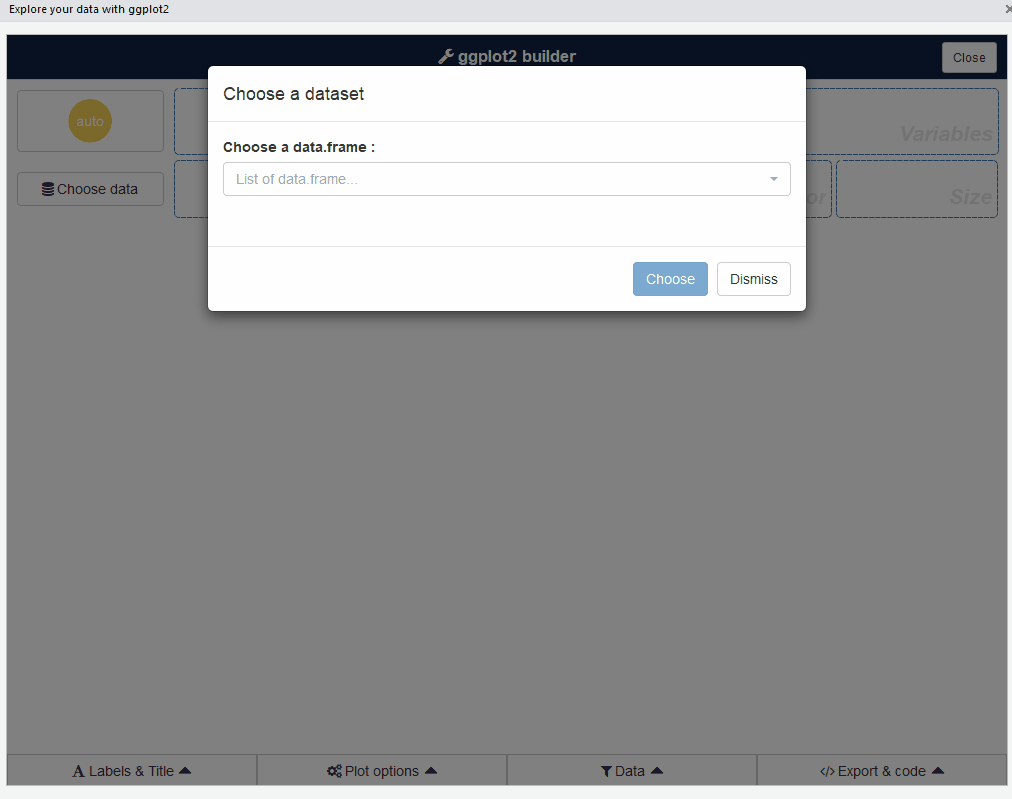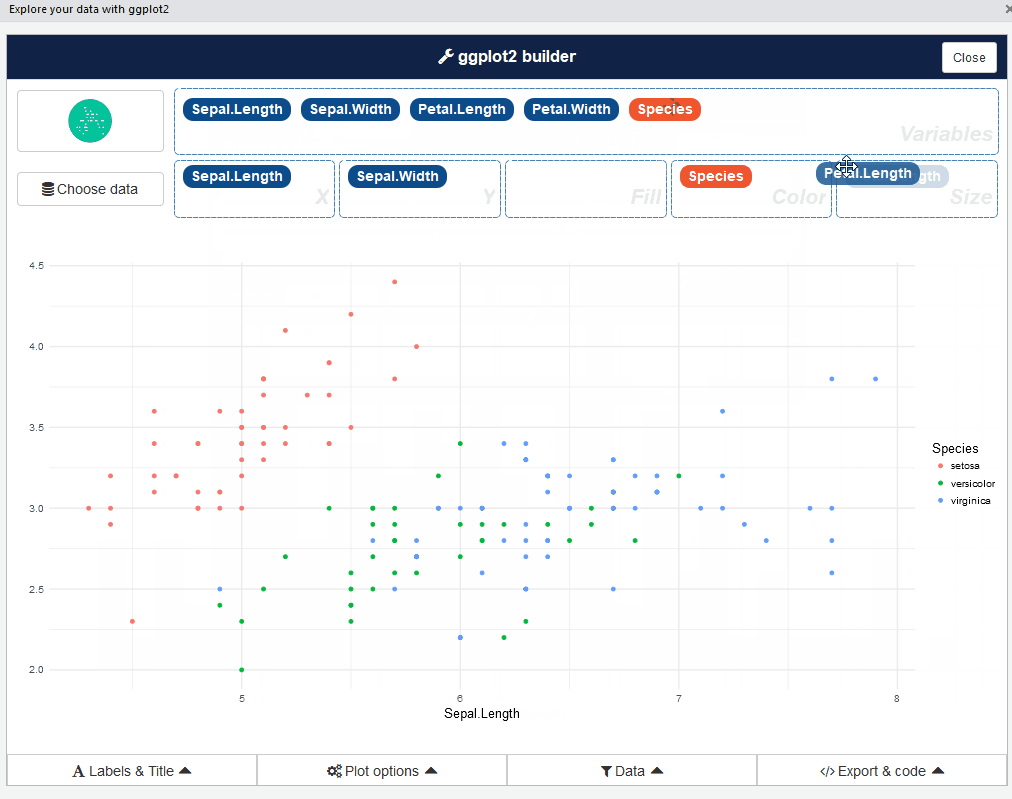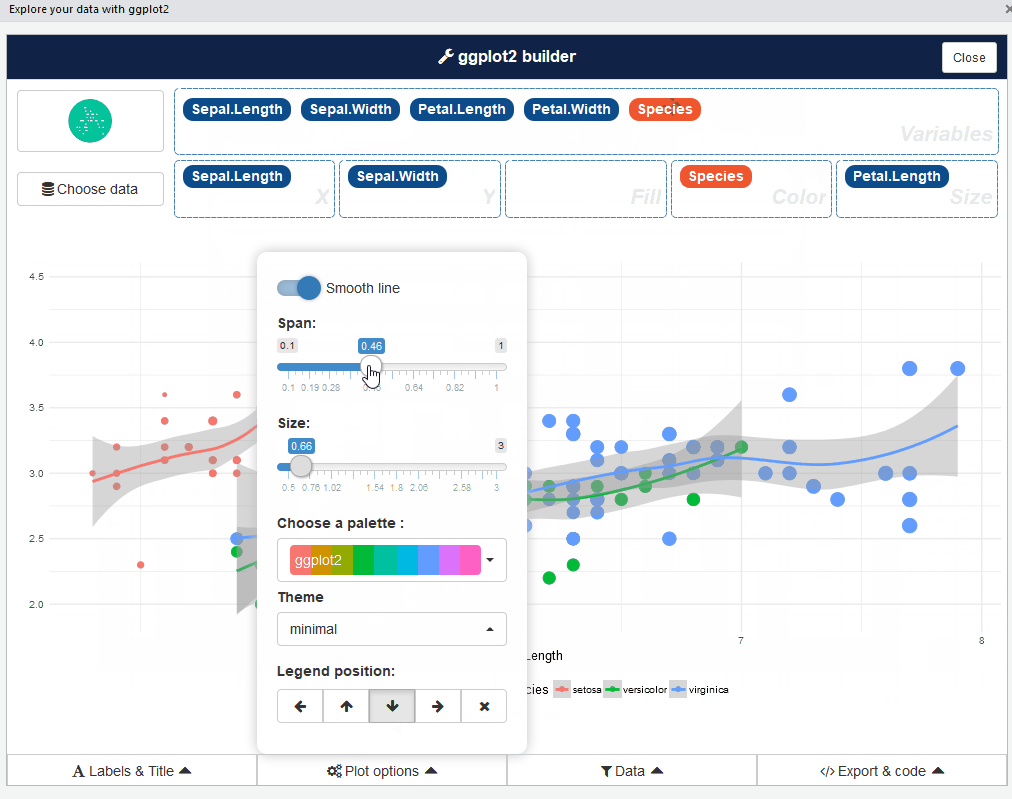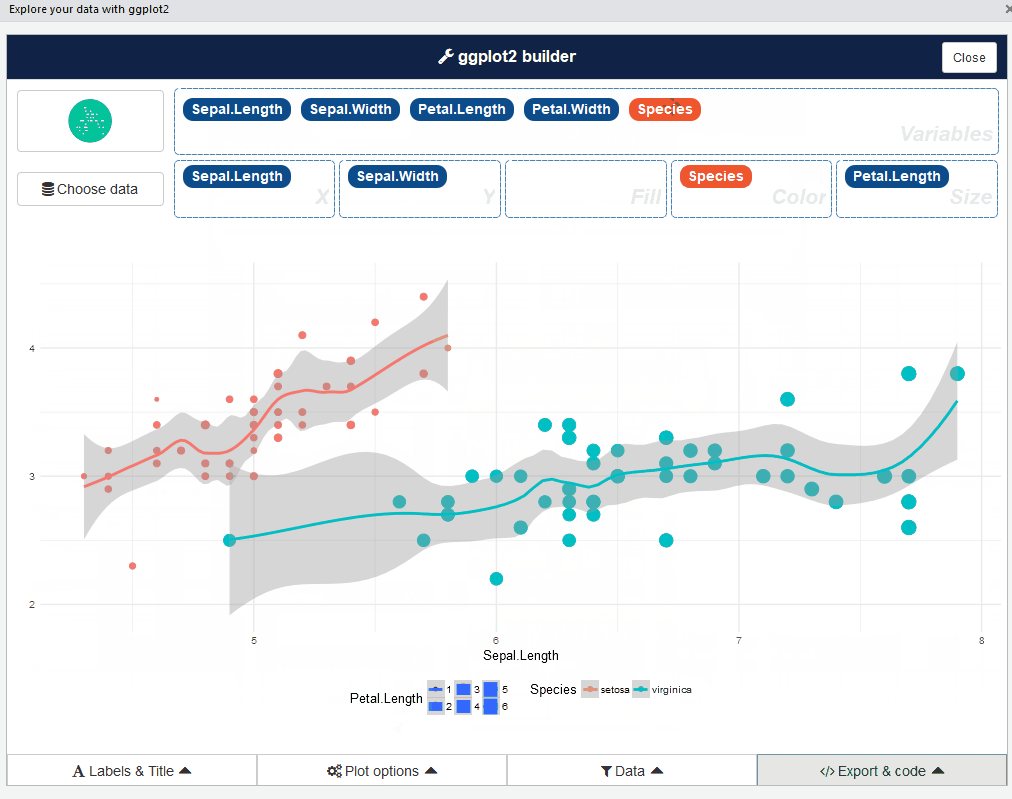
Assez bien, vérité? Allez-y et essayez différents types de graphiques: c'est une expérience révélatrice.
Apprentissage automatique

Ah, construire des modèles d'apprentissage automatique dans R. Le saint graal que nous, les scientifiques des données, poursuivons lorsque nous entreprenons de nouveaux projets d'apprentissage automatique. Il est possible que vous ayez utilisé le package ‘caret’ para construir modelos antes.
À présent, Laissez-moi vous présenter quelques packages R qui peuvent changer la façon dont vous abordez le processus de construction de modèles.
Une des principales raisons pour lesquelles Python a devancé R est grâce à ses bibliothèques centrées sur l'apprentissage automatique (comme scikit-learn). Pendant très longtemps, R manquait de cette compétence. Bien sûr, vous pourriez utiliser différents packages pour effectuer différentes tâches en apprentissage automatique, mais il n'y avait pas un seul package capable de tout faire. Nous devions appeler trois bibliothèques différentes pour construire trois modèles différents.
Pas idéal.
Puis est arrivé le package MLR. C'est un package incroyable qui nous permet de réaliser toutes sortes de tâches en apprentissage automatique. MLR inclut tous les algorithmes populaires d'apprentissage automatique que nous utilisons dans nos projets.
Recomiendo encarecidamente leer el siguiente artículo para profundizar en MLR:
Veamos cómo instalar MLR y construir un modelo de bosque aleatorio en el conjunto de datos de iris:
install.paquets("mlr")
une bibliothèque(mlr)

# Load the dataset
data(iris)
# create task
task = makeClassifTask(id = ”iris”, iris, target = ”Species”)

# create learner
learner = makeLearner(”classif.randomForest”)

# build model and evaluate
holdout(learner, tâche)

# measure accuracy
holdout(learner, tâche, measures = acc)
Production:
Resample Result
Task: iris
Learner: classif.randomForest
Aggr perf: acc.test.mean=0.9200000          # 92% précision - not bad!
Durée: 0.0239332
Un problema común con las diferentes funciones disponibles en R (que hacen lo mismo) es que pueden tener diferentes interfaces y argumentos. Tomemos el algoritmo de bosque aleatorio, par exemple. El código que usaría en el forêt aléatoire paquete y el signo de intercalación le paquet est différent, vérité?
Comme MLR, panais élimine le problème de faire référence à plusieurs packages pour un certain algorithme d'apprentissage automatique. Imite avec succès le package scikit-learn de Python en R.
Voyons l'exemple simple suivant pour vous donner une idée de la façon dont panais il fonctionne pour un problème de régression linéaire:
install.paquets("parsnip")
une bibliothèque(parsnip)

#Load the dataset
data(mtcars)

#Build a linear regression model
fit <- linear_reg("régression") %>%
set_engine("lm") %>%
ajuster(mpg~.,data=mtcars)
fit #extrait les valeurs des coefficients
Production:
parsnip model object
Call:
Statistiques::lm(formule = formule, données = données)

Coefficients:
(Intercepter)          cyl         disp           hp         drat           wt         qsec
   12.30337     -0.11144      0.01334     -0.02148      0.78711     -3.71530      0.82104
         vs           am         gear         carb
    0.31776      2.52023      0.65541     -0.19942
Ranger est un de mes packages R préférés. J'utilise régulièrement les forêts aléatoires pour créer des modèles de référence, surtout lorsque je participe à des hackathons de science des données.
Voici une question: combien de fois avez-vous trouvé un calcul de forêt aléatoire lent pour de grands ensembles de données dans R? Cela se produit trop souvent sur ma vieille machine.
Des packages comme le symbole de l'accent circonflexe, les forêts aléatoires et rf prennent beaucoup de temps pour calculer les résultats. Le package ‘Ranger’ accélère notre processus de construction de modèles pour l'algorithme de forêt aléatoire. Il vous aide à créer rapidement un grand nombre d'arbres en moins de temps.
Codifions un modèle de forêt aléatoire en utilisant Ranger:
install.paquets("ranger")

#Load the Ranger package
require(ranger)
ranger(Species ~ ., data = iris,num.trees=100,mtry=3)


train.idx <- échantillon(maintenant(iris), 2/3 * maintenant(iris))
iris.train <- iris[train.idx, ]
iris.test <- iris[-train.idx, ]
rg.iris <- ranger(Species ~ ., data = iris.train)
pred.iris <- prédire(rg.iris, data = iris.test)

#Build a confusion matrix
table(iris.test$Species, pred.iris$predictions)
Production:
             setosa versicolor virginica
  setosa         16          0         0
  versicolor      0         16         2
  virginique       0          0        16
Une performance assez impressionnante. Vous devriez essayer Ranger sur des ensembles de données plus complexes et voir à quel point ses calculs deviennent plus rapides.
Épuisé en exécutant votre modèle de régression linéaire sur différentes parties des données et en calculant les métriques d'évaluation pour chaque modèle? Les ronronnement le paquet vient à votre secours.
Vous pouvez également créer des modèles linéaires généralisés (glm) pour différentes parties des données et calculer les valeurs p pour chaque caractéristique sous forme de liste. Les avantages de ronronnement sont infinis!
Voyons un exemple pour comprendre son fonctionnement. Construiremos un modelo de regresión lineal aquí y subconjuntaremos los valores de R-cuadrado:
#D'abord, read in the data mtcars
data(mtcars)

mtcars %>%
   diviser(.$cylindre) %>% #selecting cylinder to create three sets of data using the cyl values
   map(~ lm(mpg ~ wt, données = .)) %>%
   carte(sommaire) %>%
   map_dbl("r.squared")
Production
    4         6         8
0.5086326 0.4645102 0.4229655
Ensuite, ¿observaste? Este ejemplo usa ronronnement para resolver un problema bastante realista:
- Dividir un marco de datos en pedazos
- Ajusta un modelo a cada pieza
- Calcular el resumen
- Finalement, extrae los valores de R-cuadrado
Nos ahorra mucho tiempo, vérité? En lugar de ejecutar tres modelos diferentes y tres comandos para crear un subconjunto del valor R cuadrado, solo usamos una línea de código.
Utilitaires: Otros paquetes R impresionantes
Veamos algunos otros paquetes que no necesariamente caen bajo el paraguas del ‘apprentissage automatique’. Los he encontrado útiles en términos de trabajar con R en general.
L'analyse des sentiments est l'une des applications les plus populaires de l'apprentissage automatique. C'est une réalité incontournable dans le monde numérique actuel. Et Twitter est un objectif principal pour extraire des tweets et créer des modèles afin de comprendre et prédire le sentiment.
À présent, il existe certains packages R pour extraire / gratter des Tweets et réaliser des analyses d'opinion. Le package ‘rtweet’ fait la même chose. Ensuite, en quoi diffère-t-il des autres packages existants?
‘rtweet’ il vous aide également à vérifier les tendances des tweets directement depuis R. Impressionnant!
# installer rtweet depuis CRAN
install.paquets("rtweet")

# charger le package rtweet
une bibliothèque(rtweet)
Tous les utilisateurs doivent être autorisés à interagir avec l'API de Twitter. Pour obtenir l'autorisation, suivez les instructions ci-dessous:
1.Créez une application Twitter
2. Créez et enregistrez votre jeton d'accès
Pour obtenir une procédure détaillée étape par étape afin d'obtenir l'authentification Twitter, suivez ce lien ici.
Vous pouvez rechercher des tweets avec certains hashtags simplement en utilisant la ligne de code mentionnée ci-dessous. Essayons de rechercher tous les tweets avec le hashtag #avengers puisque Infinity War est prêt à être lancé.
#1000 tweets avec le hashtag avengers

tweets <- search_tweets(
  "#avengers", m = 1000, include_rts = FALSE)
Vous pouvez même accéder aux identifiants utilisateur des personnes qui suivent une certaine page. Voyons un exemple:
## obtenir les identifiants des utilisateurs des comptes suivant marvel

marvel_flw <- get_followers("marvel", m = 20000)
Vous pouvez faire bien plus avec ce package. Essayez-le et n'oubliez pas de mettre à jour la communauté si vous trouvez quelque chose d'intéressant.
Aimez-vous coder en R et Python, mais voulez continuer avec RStudio? Reticulate est la solution! Le package résout ce problème important en fournissant une interface Python dans R. Vous pouvez facilement utiliser les principales bibliothèques Python comme numpy, pandas et matplotlib dans R!
Vous pouvez également transférer facilement vos données et vos progrès de Python vers R et de R vers Python avec une seule ligne de code. N'est-ce pas incroyable? Consultez le bloc de code ci-dessous pour voir à quel point il est facile d'exécuter Python dans R.
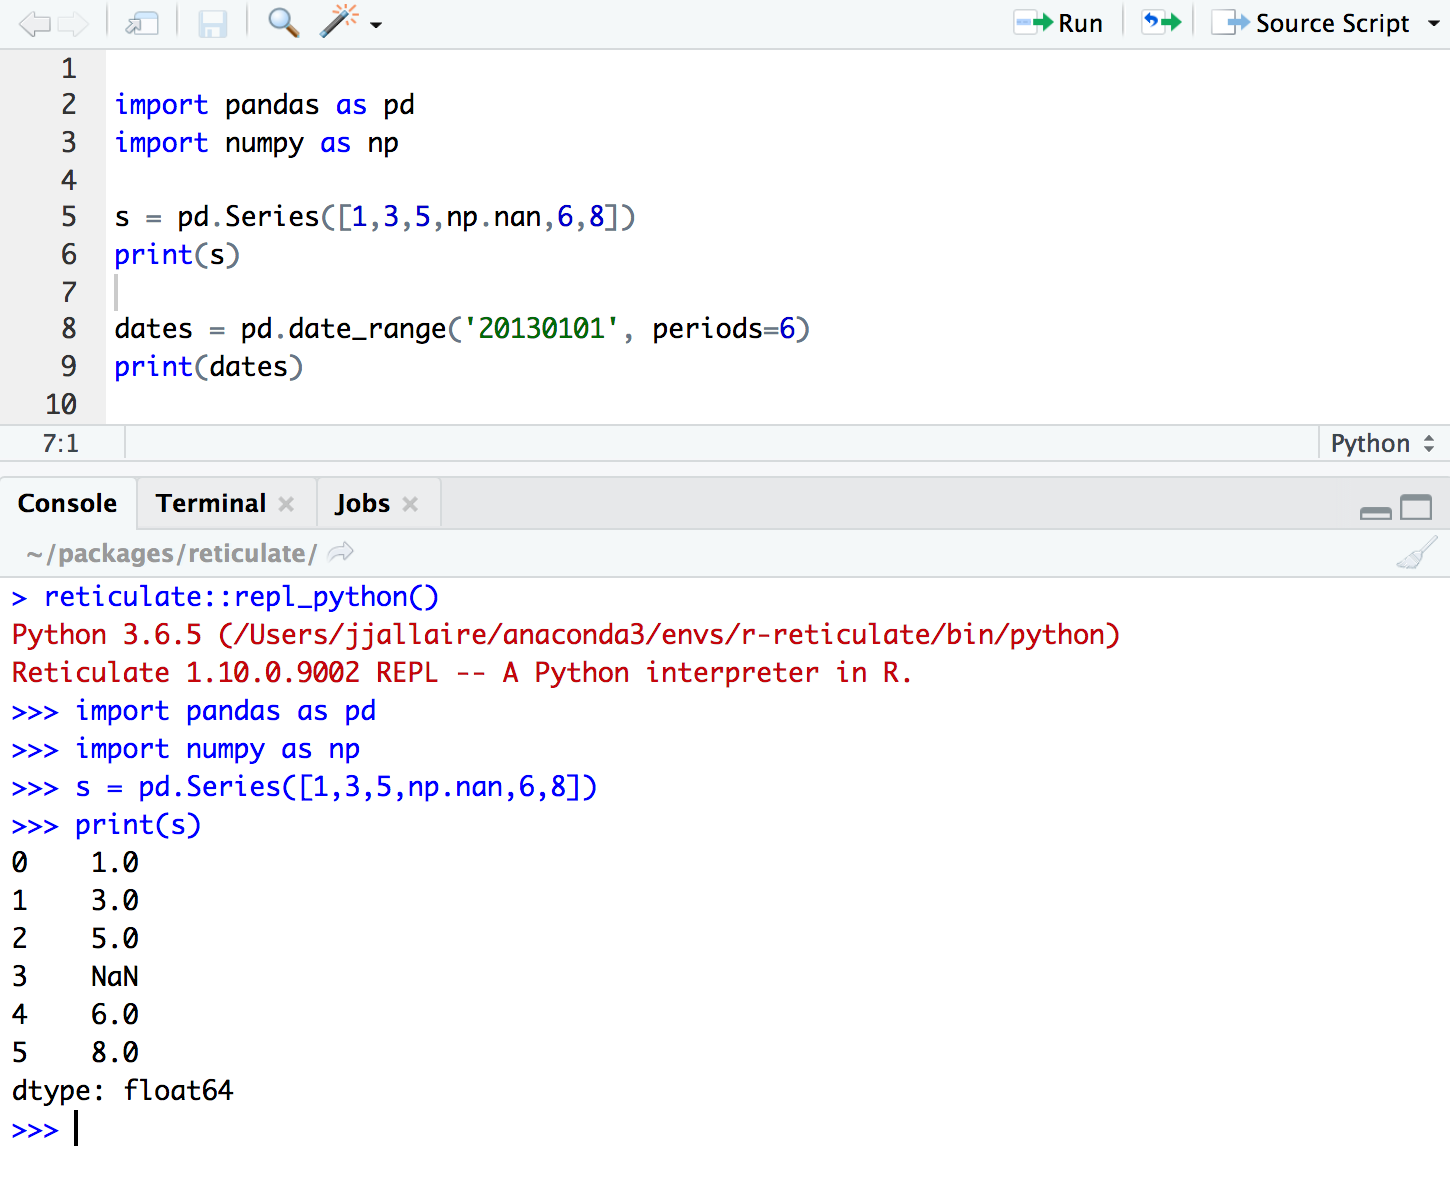
Avant de continuer avec l'installation directe de reticulate dans R, vous devrez d'abord installer TensorFlow et Keras.
install.paquets("tensorflow")
install.paquets("dur")

une bibliothèque(tensorflow)
une bibliothèque(dur)
installer_keras()
install.paquets("reticulate")
une bibliothèque(reticulate)
¡Et vous êtes prêt à partir! Exécutez les commandes que j'ai fournies précédemment dans la capture d'écran et testez vos projets de science des données de manière similaire.
AVANT
Voici deux autres packages utilitaires R pour tous vos passionnés de programmation!
Mettre à jour vos packages R individuellement? Cela peut être une tâche fastidieuse, surtout lorsqu'il y a plusieurs packages en jeu.
Le package ‘InstallR’ vous permet de mettre à jour R et tous vos packages en utilisant une seule commande! Au lieu de vérifier la dernière version de chaque package, nous pouvons utiliser InstallR pour mettre à jour tous les packages en une seule fois.
# installation/chargement du package:
si(!Exige(installr)) {
install.paquets("installr"); Exige(installr)} #charge / installer+charger installr

# utilisation du package:
updateR() # cela va démarrer le processus de mise à jour de votre installation R.
# Il vérifiera les versions plus récentes, et si l'un est disponible, vous guidera à travers les décisions que vous devrez prendre
Quel package utilisez-vous pour installer des bibliothèques depuis GitHub? La plupart d'entre nous comptons sur le package ‘outils de développement’ pendant longtemps. Il semblait être la seule façon. Mais il y avait un avertissement: Nous devions nous rappeler le nom du développeur pour installer un paquet:
Avec le paquet ‘githubinstall’, le nom du développeur n'est plus nécessaire.
install.paquets("githubinstall")

#Install any GitHub package by supplying the name
githubinstall("NomDuPaquet")

#githubinstall("AnomalyDetection")
Remarques finales
Ce n'est en aucun cas une liste exhaustive. Il existe de nombreux autres paquets R qui ont des fonctions utiles, mais la plupart les ont ignorés.
Connaissez-vous un package que j'aurais manqué dans cet article? Ou avez-vous utilisé l'un de ceux mentionnés ci-dessus pour votre projet? J'adorerais avoir de vos nouvelles! Connectez-vous avec moi dans la section des commentaires ci-dessous et parlons de R!





